Embodied AI Paper List
Paper Reading 之后,重走 EAI。
前言#
具身智能这一新兴领域发展迅速,汇聚了来自 LLM / VLM / GenAI 等一系列领域的训练技巧与模型架构,在数据匮乏与路线纷争的情况下可以说是百家争鸣,各种技术路线层出不穷,大量方法涌现。然而大多数的方法重复且无趣,或者神似 CV 时代的 A+B 之作。本文尝试大海捞针,从浩如烟海的论文中找到那些代表领域发展脉络的论文,并使用简单的语言表述论文之间的差异,便于读者了解领域发展,并索引且精读自己感兴趣的方向。
需要注意的是,一切的现代深度学习都在研究一个共同课题,即如何使用 Scalable 的范式在海量的数据中进行大规模训练。
VLA 模型#
作为一切的开始以及具身智能中最核心的概念,VLA 显然是具身智能操作1相关内容中最重要的章节。
此处的 VLA 我们按照更加泛化的定义表述,即指的是那些接受 Vision 以及 Language 输入,并且输出包含 Action 的模型,并且往往具有一定的参数量而非非常小的模型。通常我们认为它们会经过一定程度上的预训练,无论是基于以前的 LLM 或者 VLM 的先验知识,还是另一条路线基于 World Model 的预训练产物,以及未来可能会存在的开源的原生 VLA 模型。
VLM-VLA#
所谓 VLM-VLA,也就是我们常讲的狭义上的 VLA 模型,往往是基于一个经过预训练的 VLM 或者 LLM(后面统一暂时称为 VLM)作为 backbone 进行设计,并且在 Robot Data 上进行后训练(或者称之为机器人预训练,在后文中类似的描述将交替出现)的模型。
VLM-VLA 的主要动机在于试图 Leverage VLM 本身的世界知识,尝试通过在 VLM 的预训练之后进行后训练,来引导 VLM 的能力从而实现 VLA 模型的泛化;与此同时,VLM-VLA 由于基于 VLM 进行训练,往往具备小型 VLM 具备的参数量(0.5B ~ 7B 较为常见),从而使得 VLA 在更大规模的数据上训练不至于陷入欠拟合,并且具有较好的 data capacity。
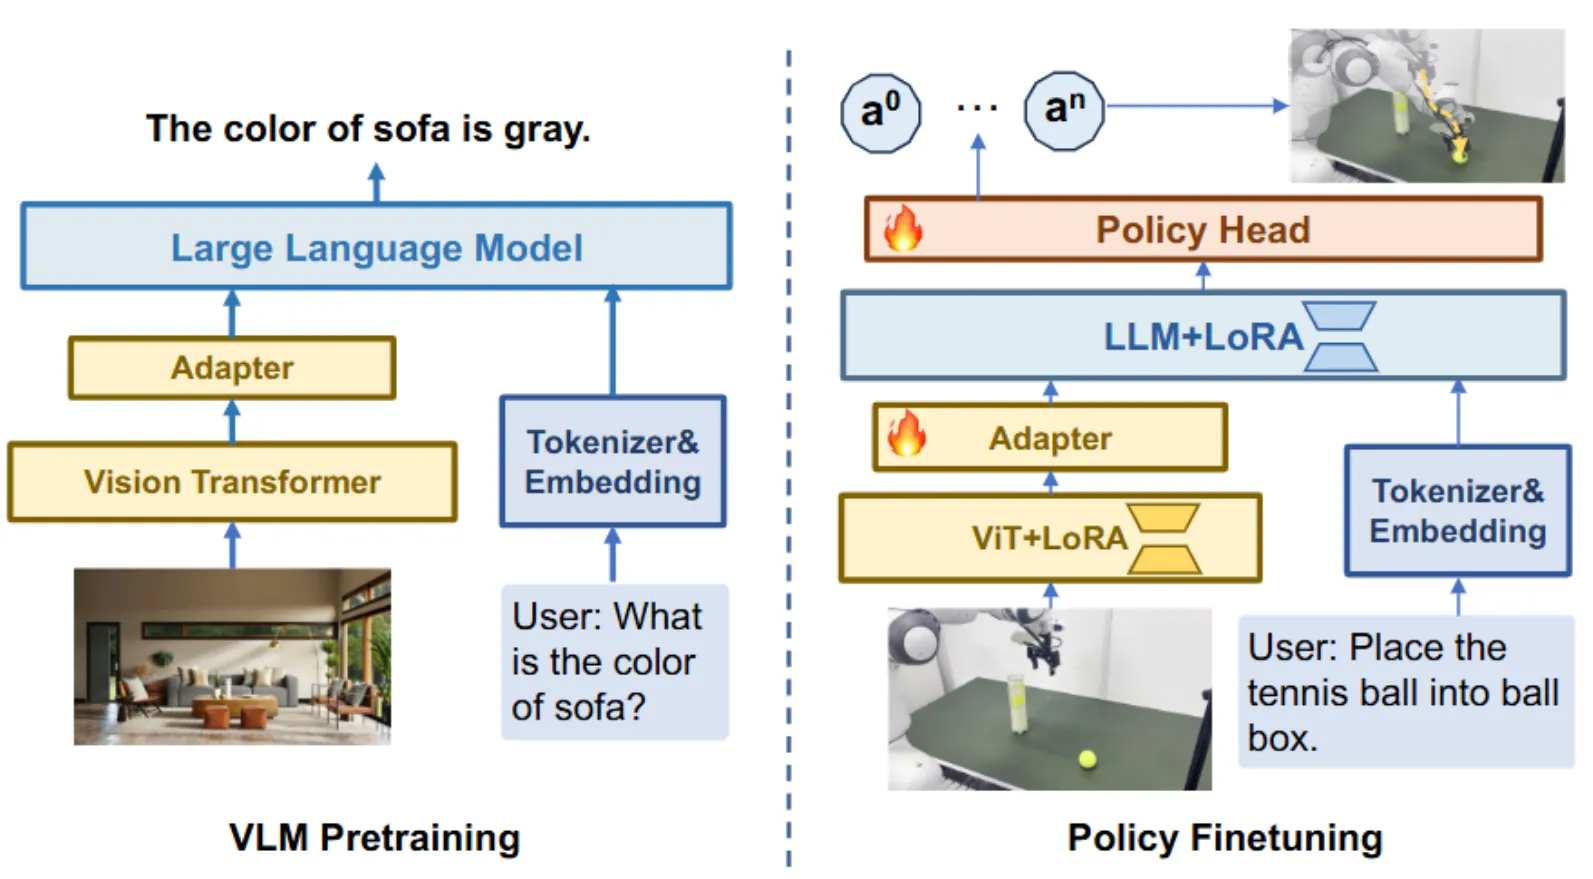
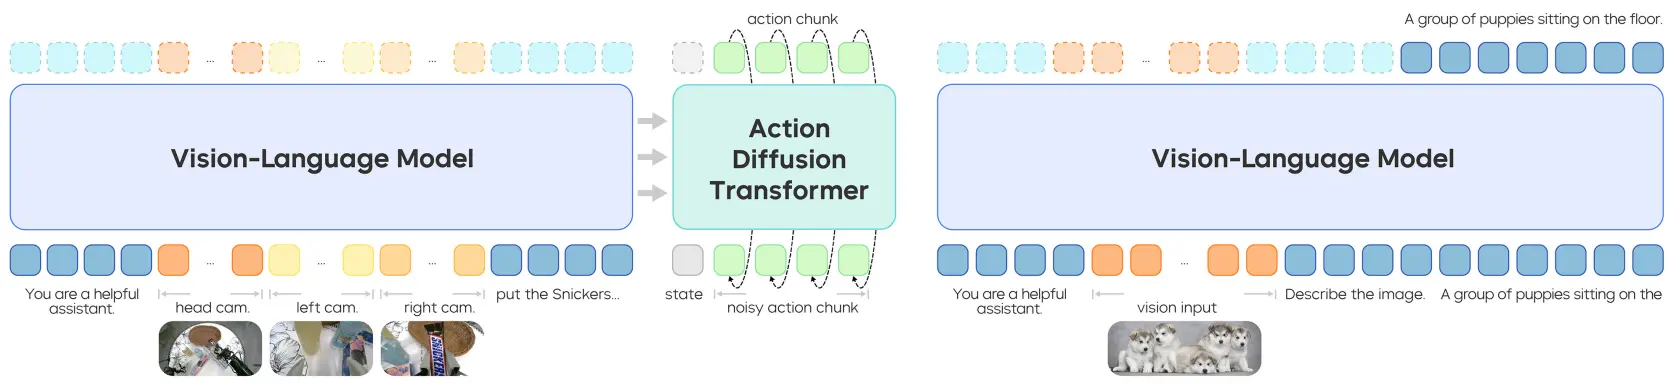
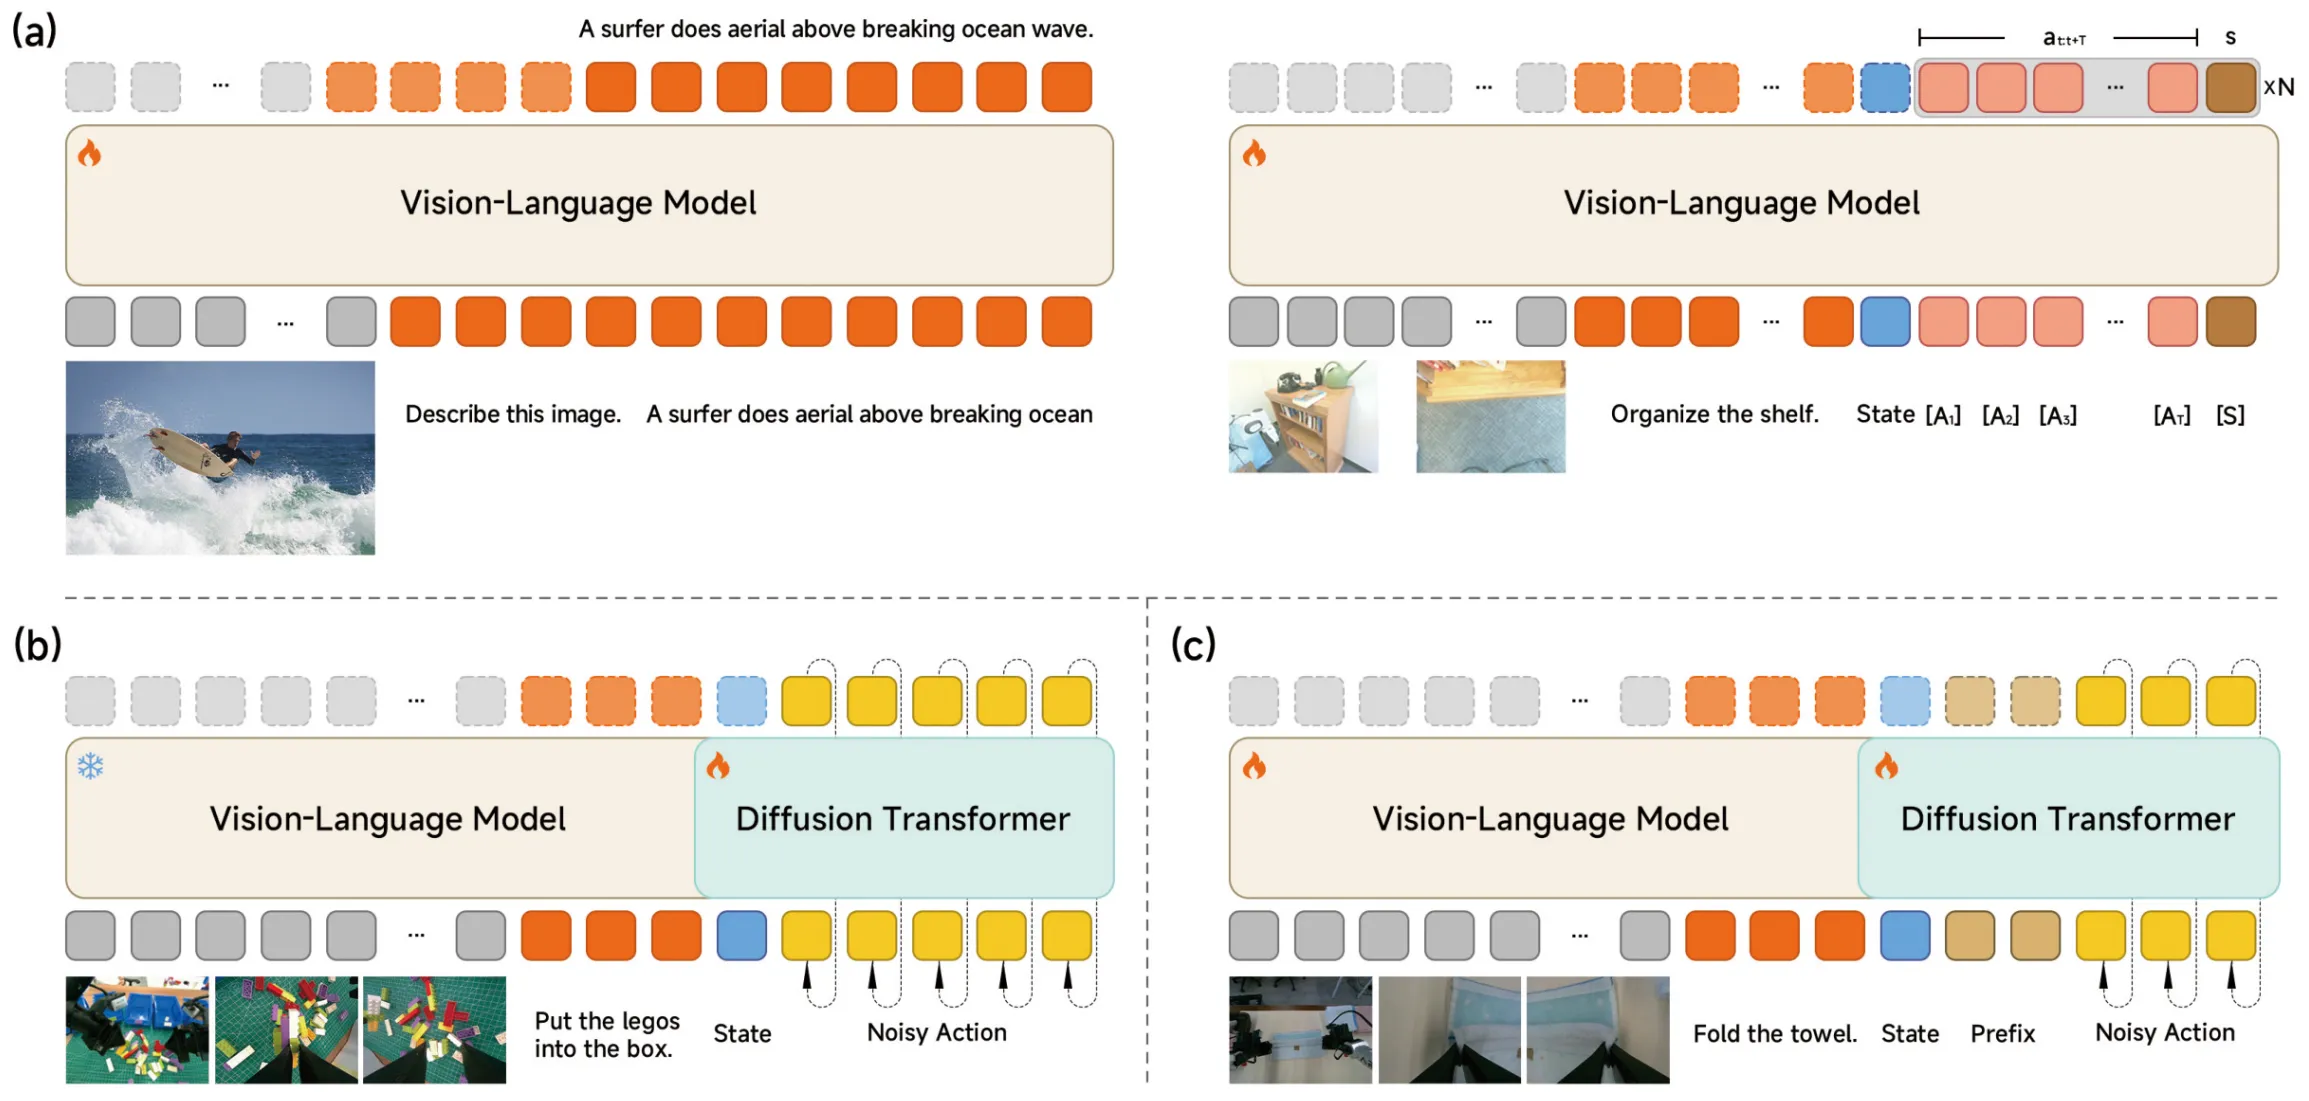
RT-2 以及 OpenVLA 是比较经典的早期 VLA 模型,都是使用预训练的 VLM 作为 Backbone,对于动作进行分箱处理,作为 Token 使用,并且直接以 Next Token Prediction 的方式进行训练。
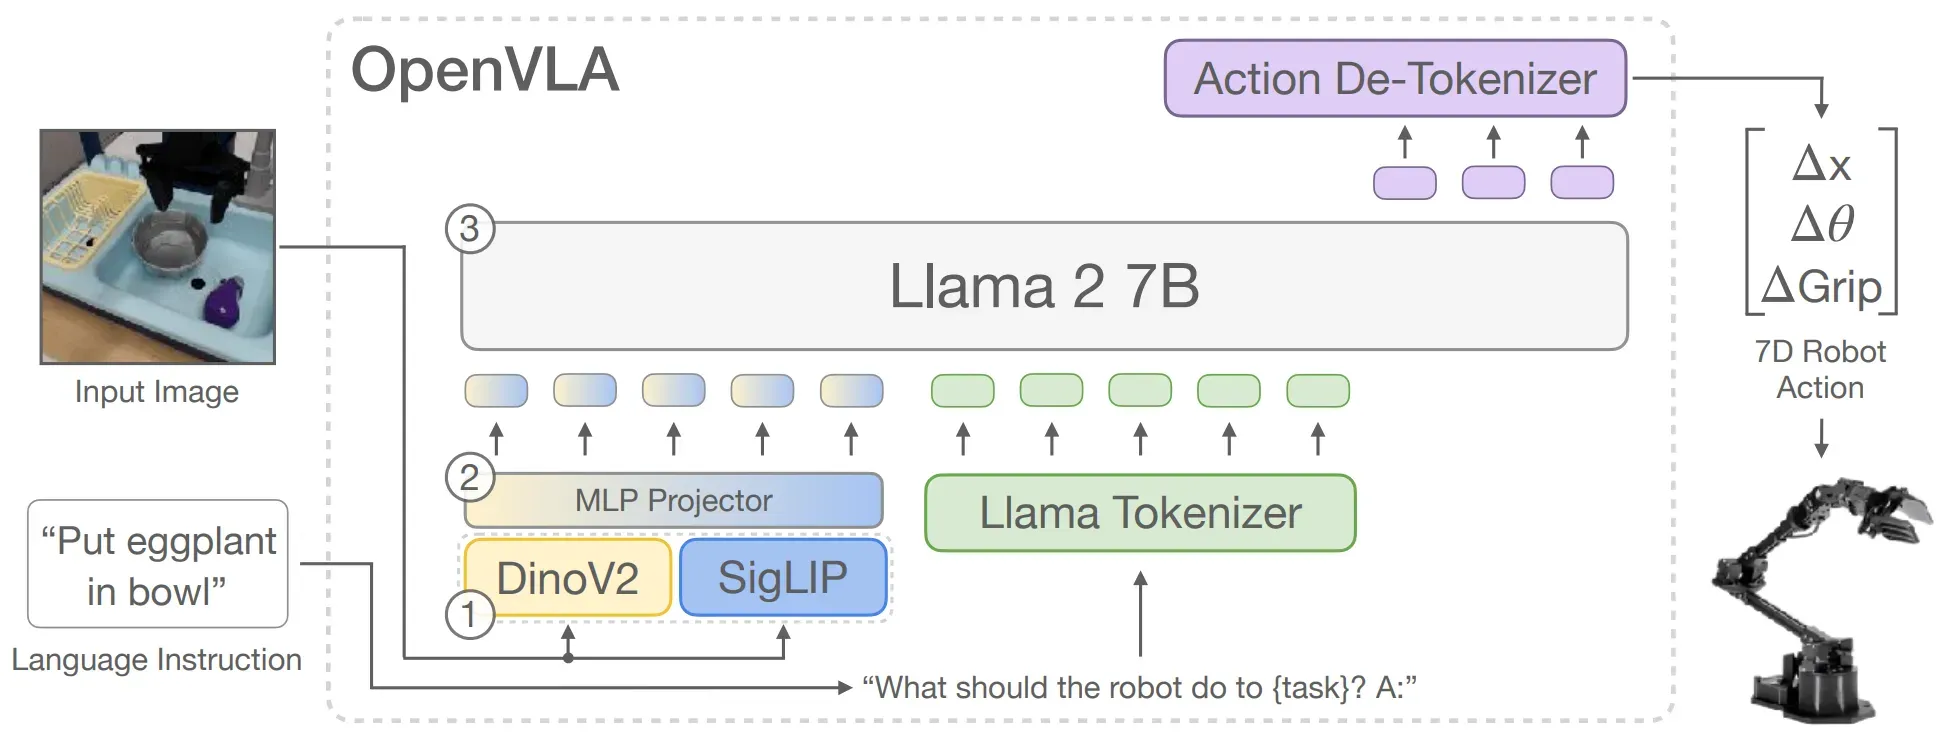
在此之后一系列的工作沿着不同的方向进行探索,而正如我们之前提及的现代人工智能的主线,它们或多或少都围绕其展开。
VLA 范式#
尽管上文已经给出了 VLM-VLA 的常见定义,但是如何真正将 VLM 给予 Action 相关的监督,则往往对于模型结构的设计以及训练的范式具有一定的设计。当下常见的方式是为 VLM 添加一个 Action Head(或者称之为 Actor),尺寸上从 MLP 到 DiT 再到更大规模的 MMDiT 不等,从而可以使用直接的监督或者 Flow Matching Loss 来训练整个 VLA 模型。在这里我们用 VLA 范式代指使用不同的模型设计构建的 VLA 模型,但是他们均保持简洁,并不建立在进一步的雕花之上。
谈到 VLA 范式, 显然是继上文 OpenVLA 这一范式之后的又一经典。 除了本身的预训练效果取得了不错的成果,论证了预训练的模型可以获得更好的性能(在 VLA 领域中,暂时不存在完全意义上所谓的 Zero-shot 能力,但是预训练往往可以帮助模型在下游任务后训练时获得更好的性能),并且在后续作为了经典的 Baseline。同时, 一次性引入了多个在后续被广泛使用的 Setting,当然,这些内容一开始的出处在这里不作考证,包括使用 MoT 进行 LLM 以及 Actor 的交互(见 Bagel),使用 Flow Matching Loss 训练 Actor 以及使用 zero-padding 来进行跨本体的混合训练。
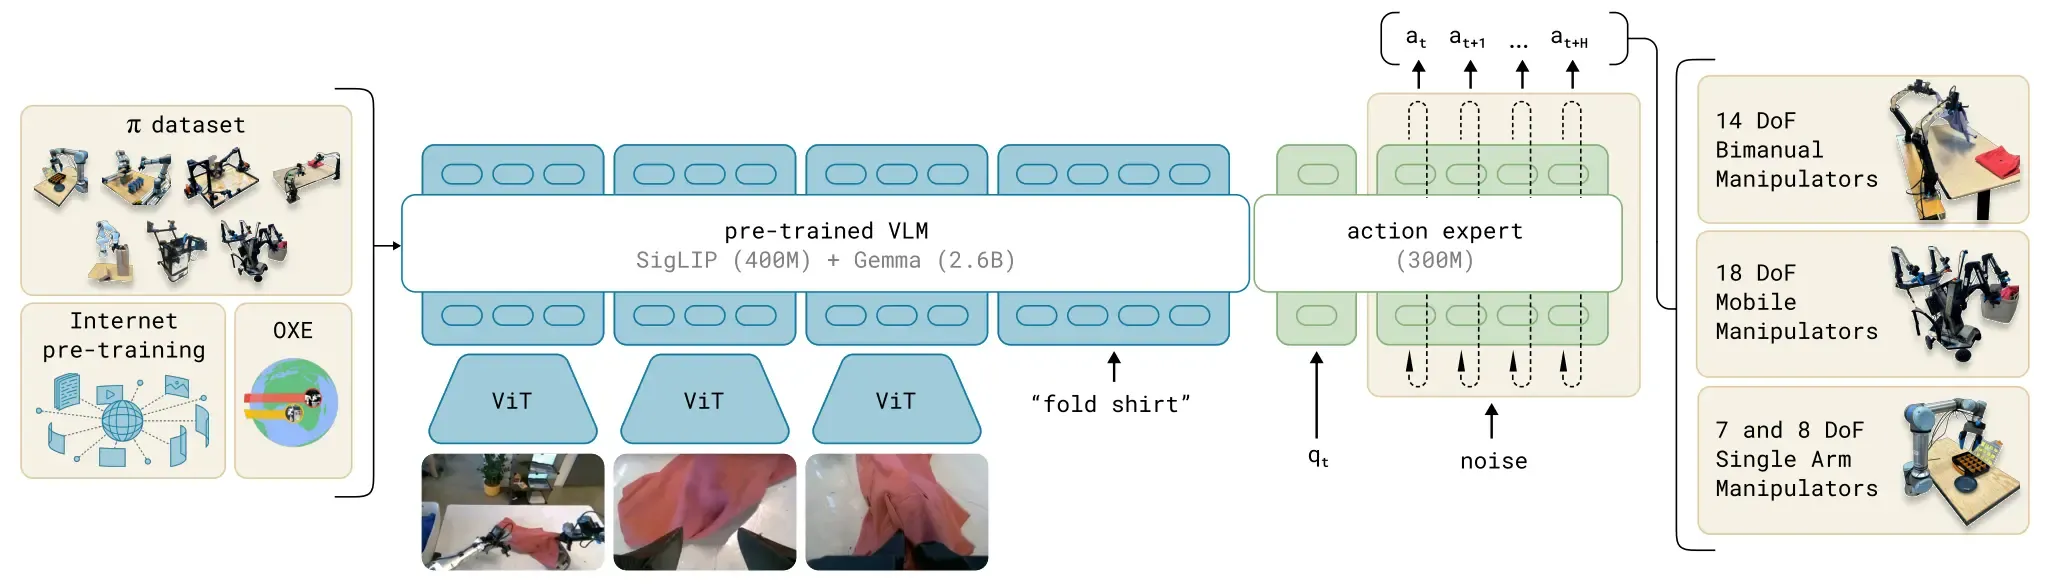
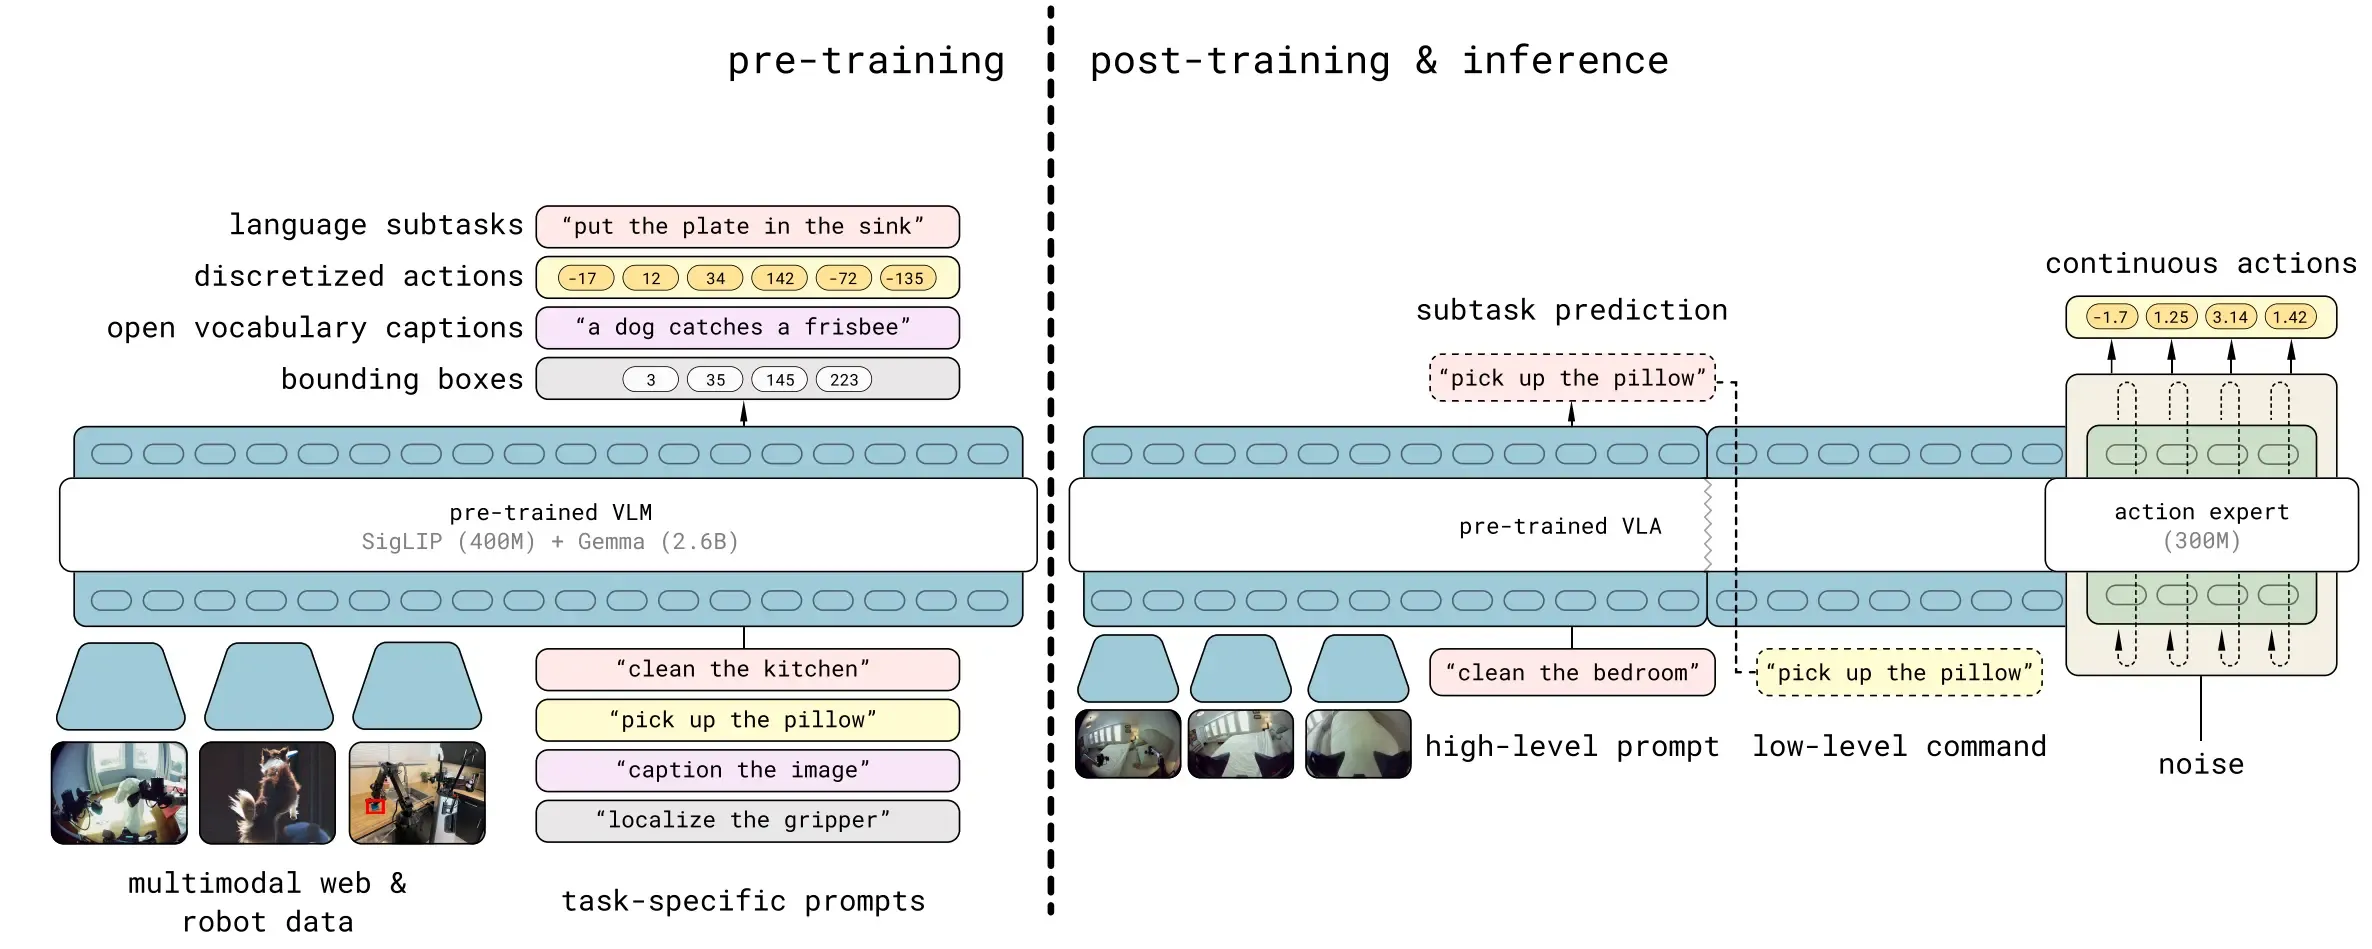
与 同时期的 TinyVLA 以及 CogACT 等工作也都使用了 VLM 和 Actor 分离的设计,来避免后训练中对于 VLM 能力的灾难性破坏。在此之后 是 的一个 Follow-up,引入了更加系统的设计,使用 Web VLM Data 以及离散动作进行预训练,并且在后训练中也包括 sub goal prediction 的环节,并且具有了一些 Zero-shot 能力。其中比较值得考虑的是在预训练阶段引入离散的 Action Token,这一设计在后面的工作被 Follow-up。到现在为止,最核心的主线也还是这样的预训练,以及如何 leverage 更多的数据。
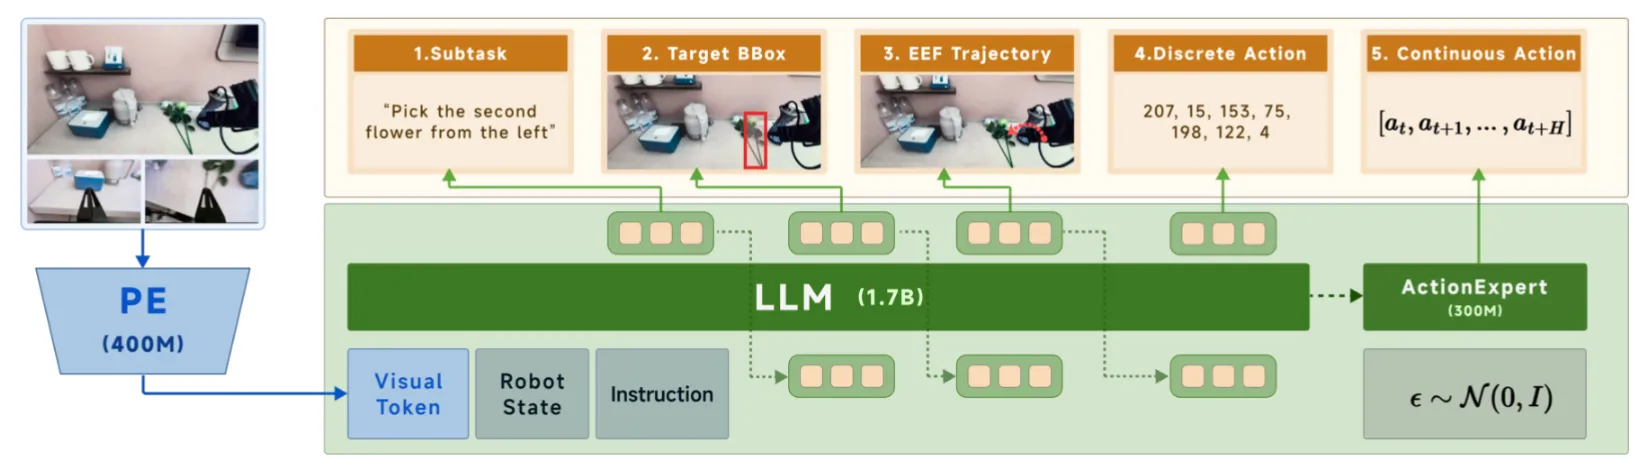
更加近期同样具有代表性的工作来自 Qwen 的 Qwen-RobotManip,作为同样工业级的产出,这篇技术报告更加详细地展示了 VLA 训练的系统工程,如详细的数据清洗以及训练,并且包含了各类简洁清晰的 Ablation Study。
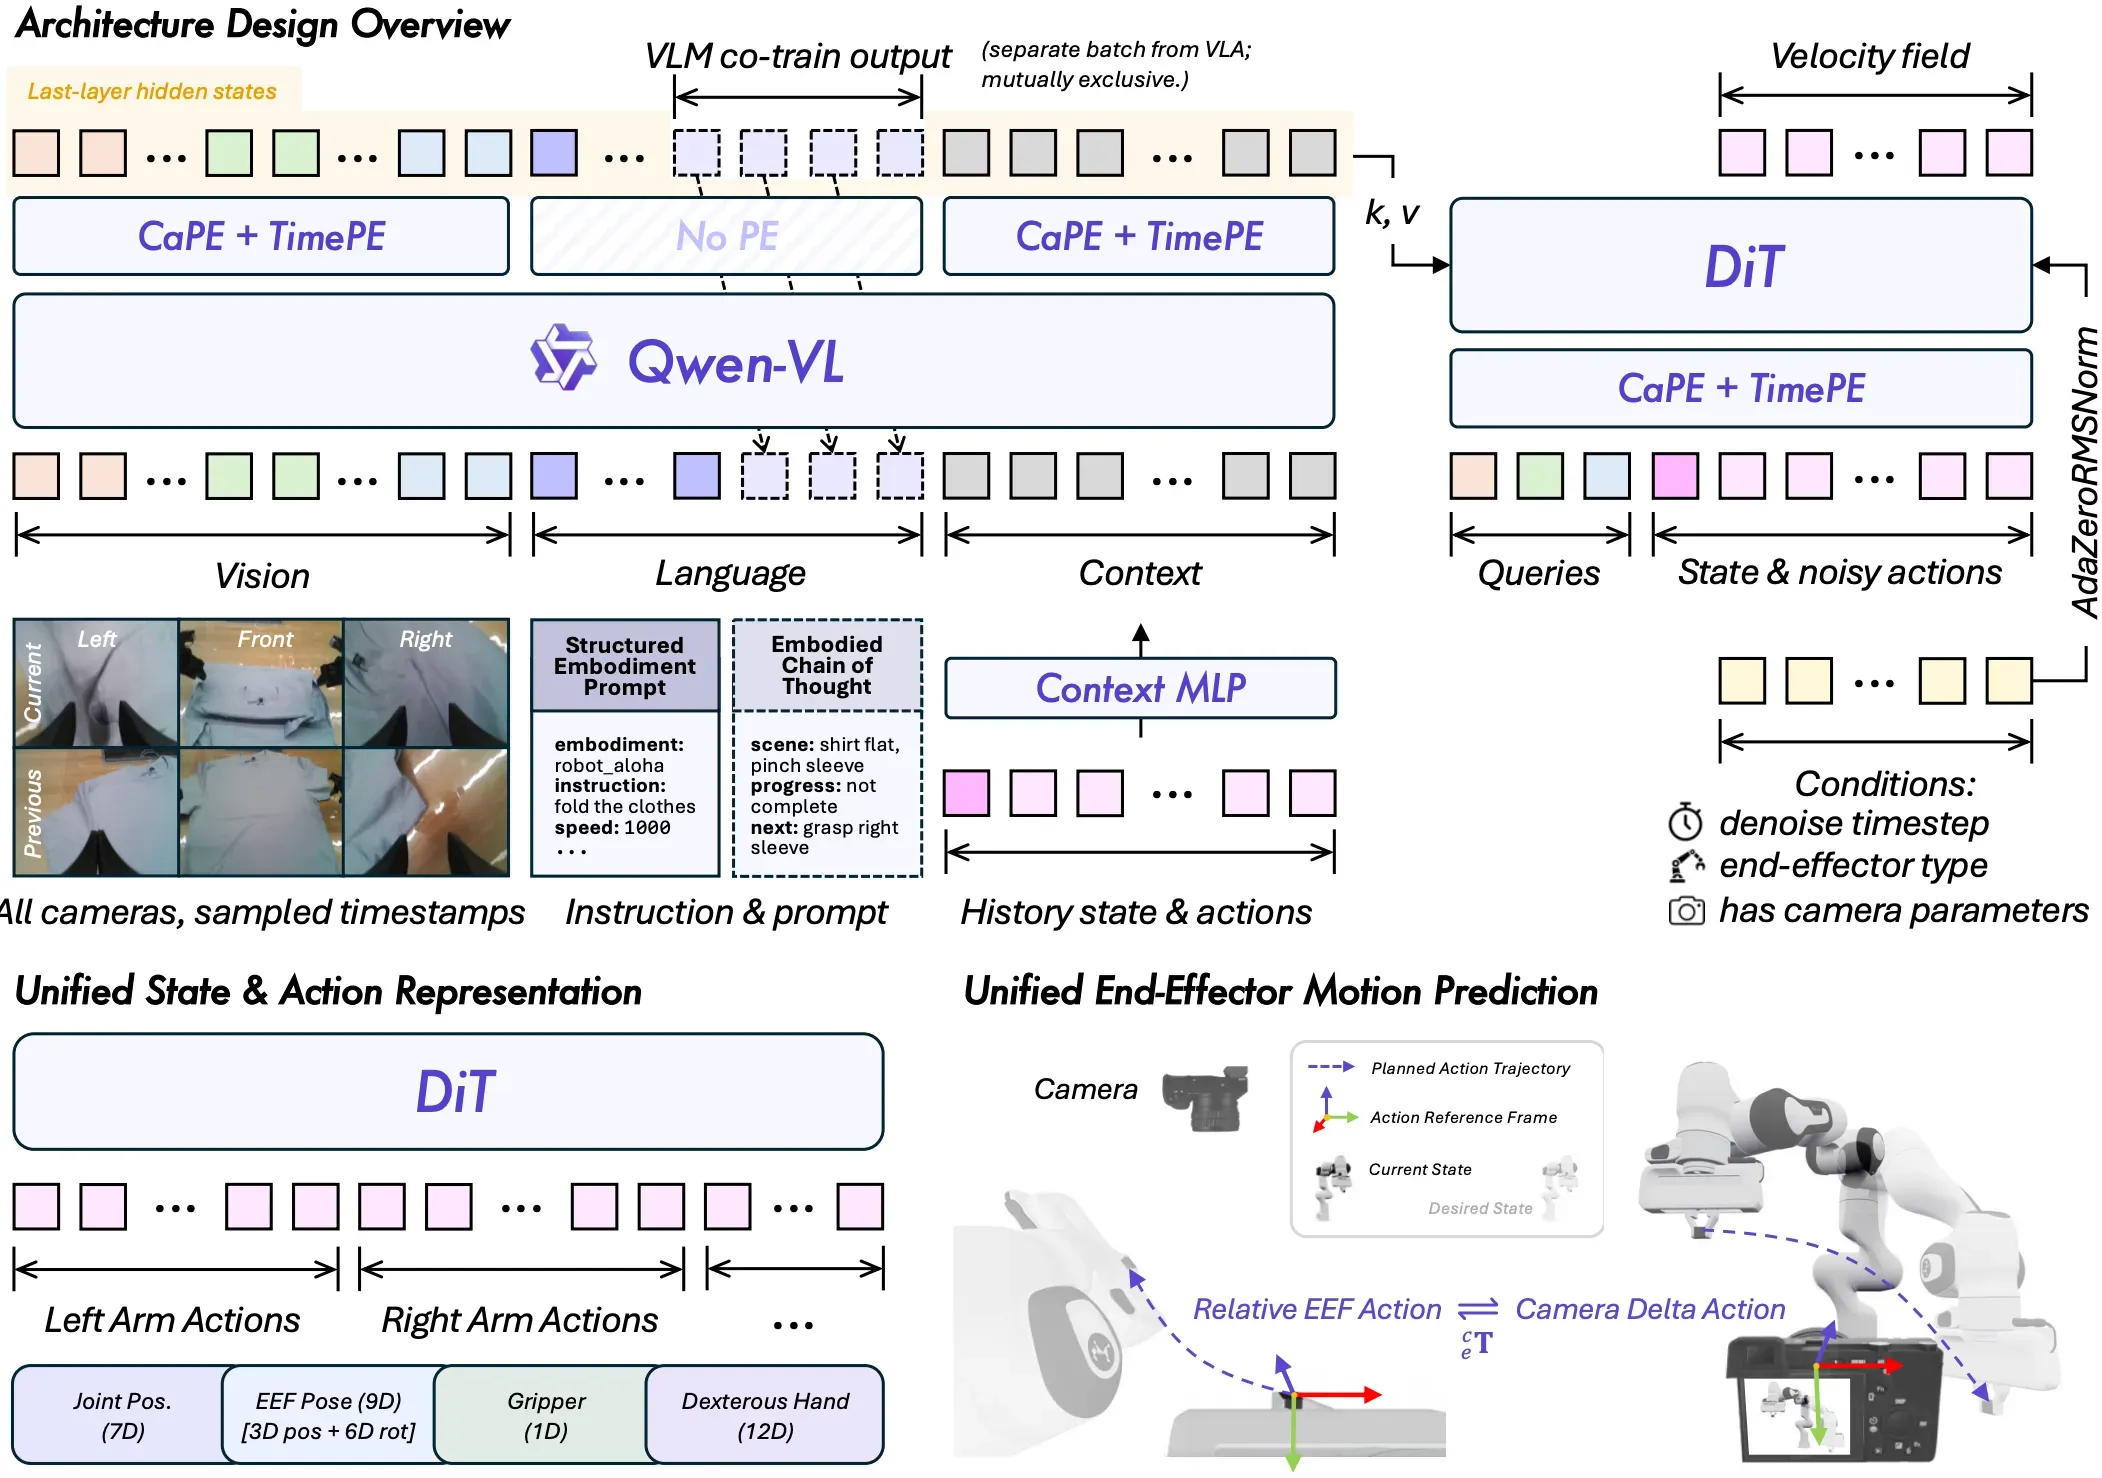
Qwen-RobotManip 的相关内容表明了更多的在训练过程中清洗与设计的必要性,如使用 Uniform Action Space 或者对于机器人的 End-effector Pose2 进行坐标系的统一。除此之外,大多数的机器人数据建立在开源数据的基础上,表明了目前开源的社区所具有的资源已经足以在一定的算力支撑以及严谨设计之下达到第一梯队的模型水平。
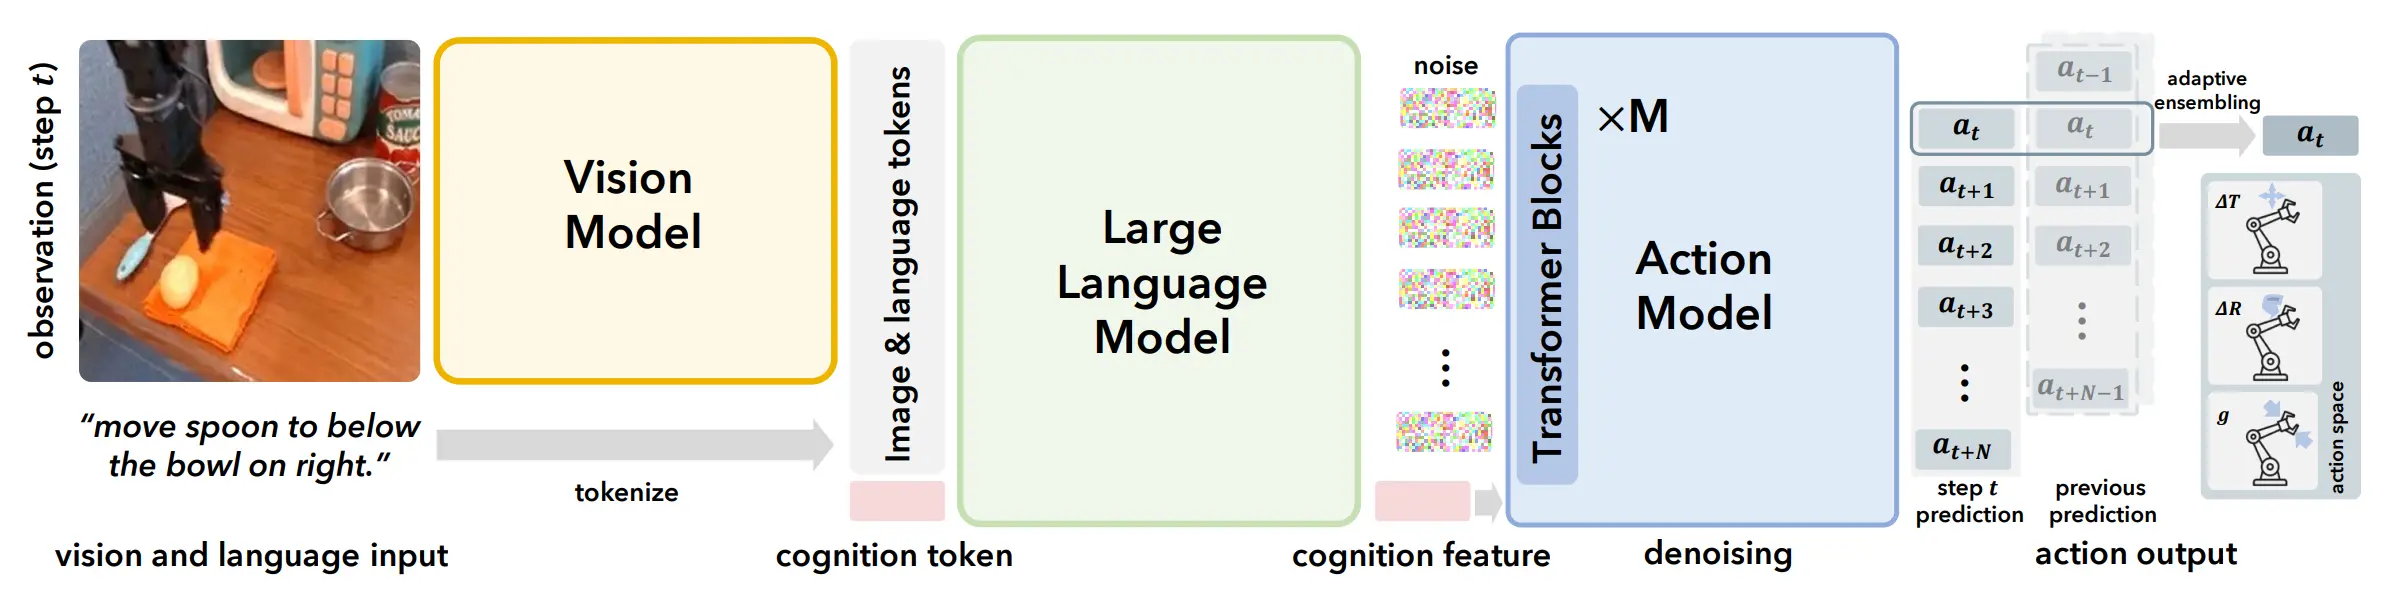
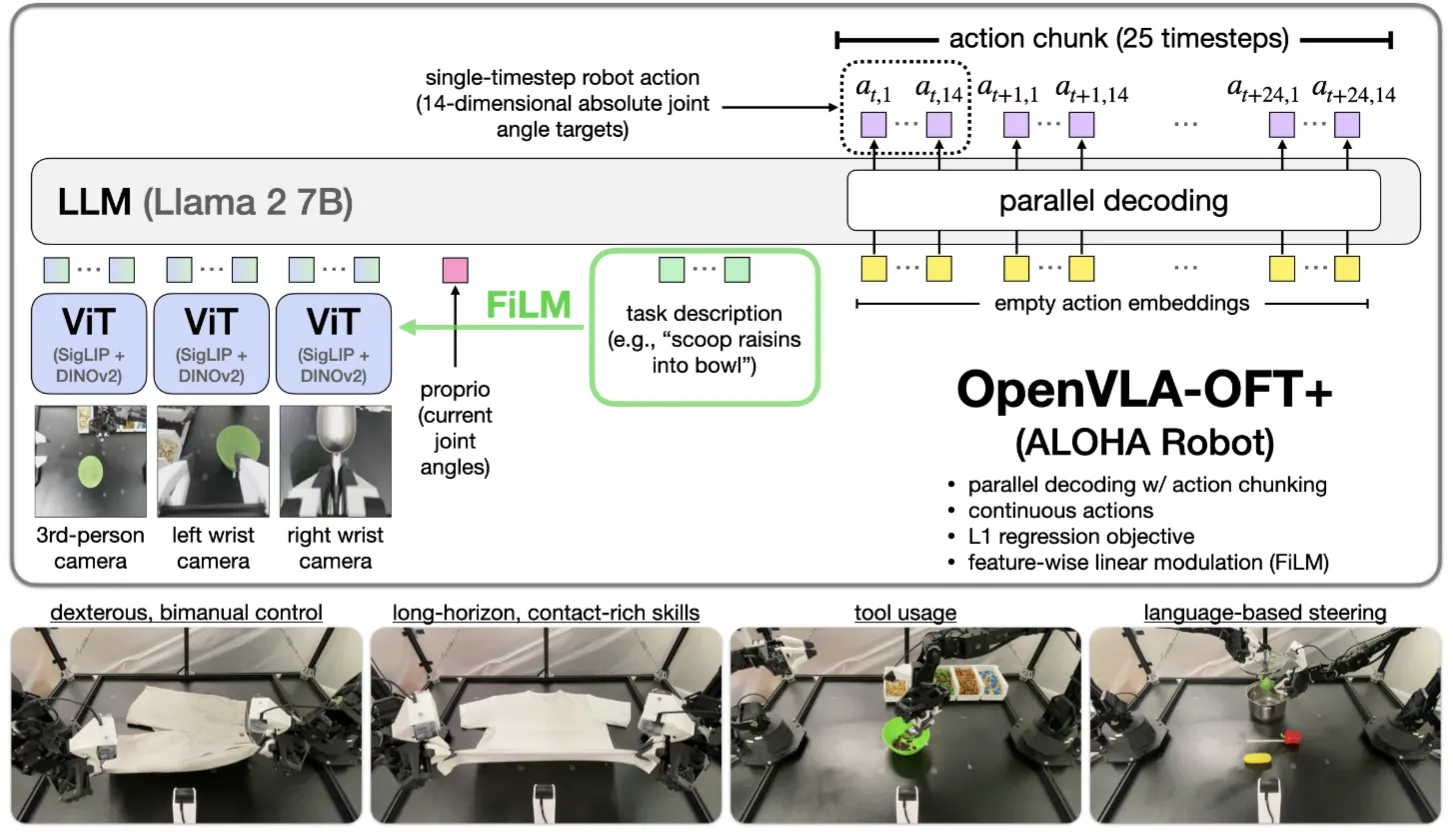
与此同时另外一些值得参考的论文如下,他们均探讨了 VLM 与 Actor 的连接方式:
| 论文 | 主要贡献 |
|---|---|
| CogACT | 使用类似于 BERT 的 CLS Token 的 Cog Token 作为 Condition |
| OpenVLA-OFT | LLM + MLP 直接预测 Action,此方式至今简单有效 |
| TinyVLA | 首次提出 VLM + Actor 设计,使用 VLM 的 embedding 作为 Condition |
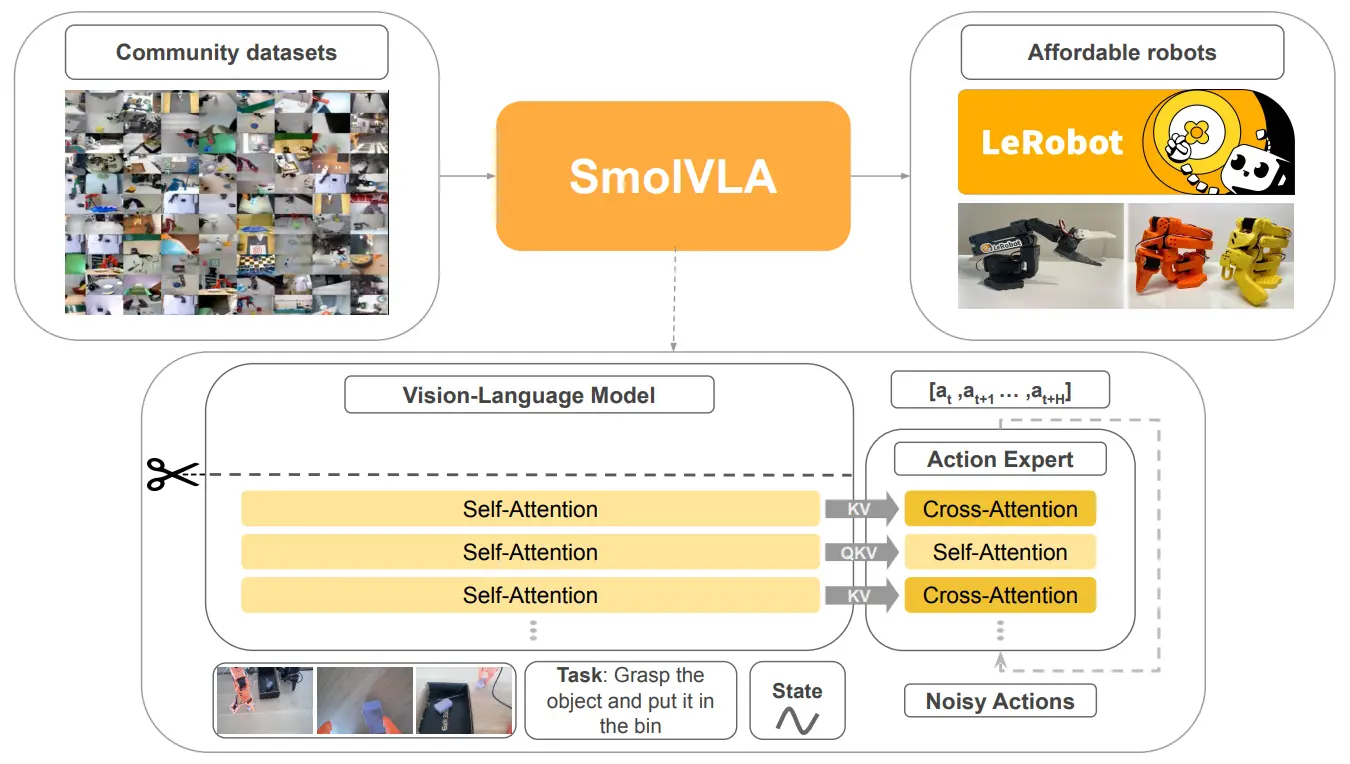
| SmolVLA | 在 Actor 使用了交错的 CA 与 SA,模型更加轻量化 |
跨本体混合训练#
在大规模的预训练中,事实上往往在模型设计本身之外,数据才是最为重要的一个环节。在具身智能领域中,除了长期如影随形的数据短缺问题之外,数据的另一问题即在于数据的种类各不相同。尽管几乎全部的机器人动作数据都可以使用如 EEF + Gripper/Hand Action 来表示,但是在不同的情况下,出于控制以及一些性能问题,往往使用 Joint Position 进行训练也是重要的一个环节,因此来自不同数据的机器人数据长度以及不同位置的表示含义各不相同。
使用的预训练中包含多种不同的机器人数据,使得一些研究者开始研究如何进行跨本体的预训练,这其中 使用比较直接的 Zero-Padding 的方案,即将动作信号在末尾补零至最长的 Action 长度。相较于这种 Simple Padding,现在大家基本都开始使用 Uniform Action Space,即将不同的关节映射到统一空间中对应的维度,而不是直接左对齐然后 padding。
与此同时一些其他的研究如下:
| 论文 | 主要贡献 |
|---|---|
| RDT-1B | 使用 Unified Action,即将不同的本体的动作分配到一个很长的 Space 上的不同位置 |
| X-VLA | 使用 soft prompt 混训的轻量 VLA,包括大量调模型技巧 |
| ACE-Ego-0 | 用 URDF Encoder 输入 Robot Token 以及构造 Human Token 到 Actor 的 GR00t-like VLA,使用 Unified Camera-Space Action |
| UniDex | 灵巧手的 Unified Action Space,功能性对齐,即 FAAS,依然是 Pi-like 架构 |
| HEX | MoE 作为中间件预测未来状态来学习跨本体 Humanoid 数据 |
| EgoWild2Dex | 用 GeoFormer 对齐人类与机器人视角,从 EgoWild 预训练到混合目标任务人类、手套与机器人数据,再用真机示范及失败恢复轨迹训练。 |
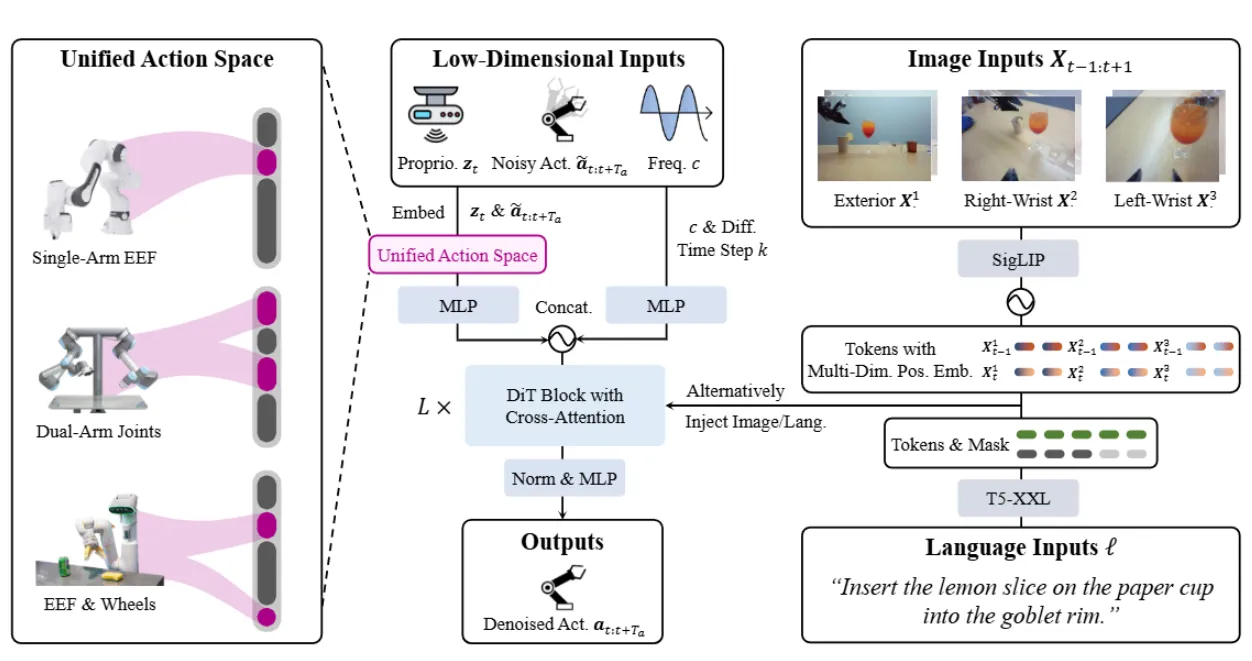
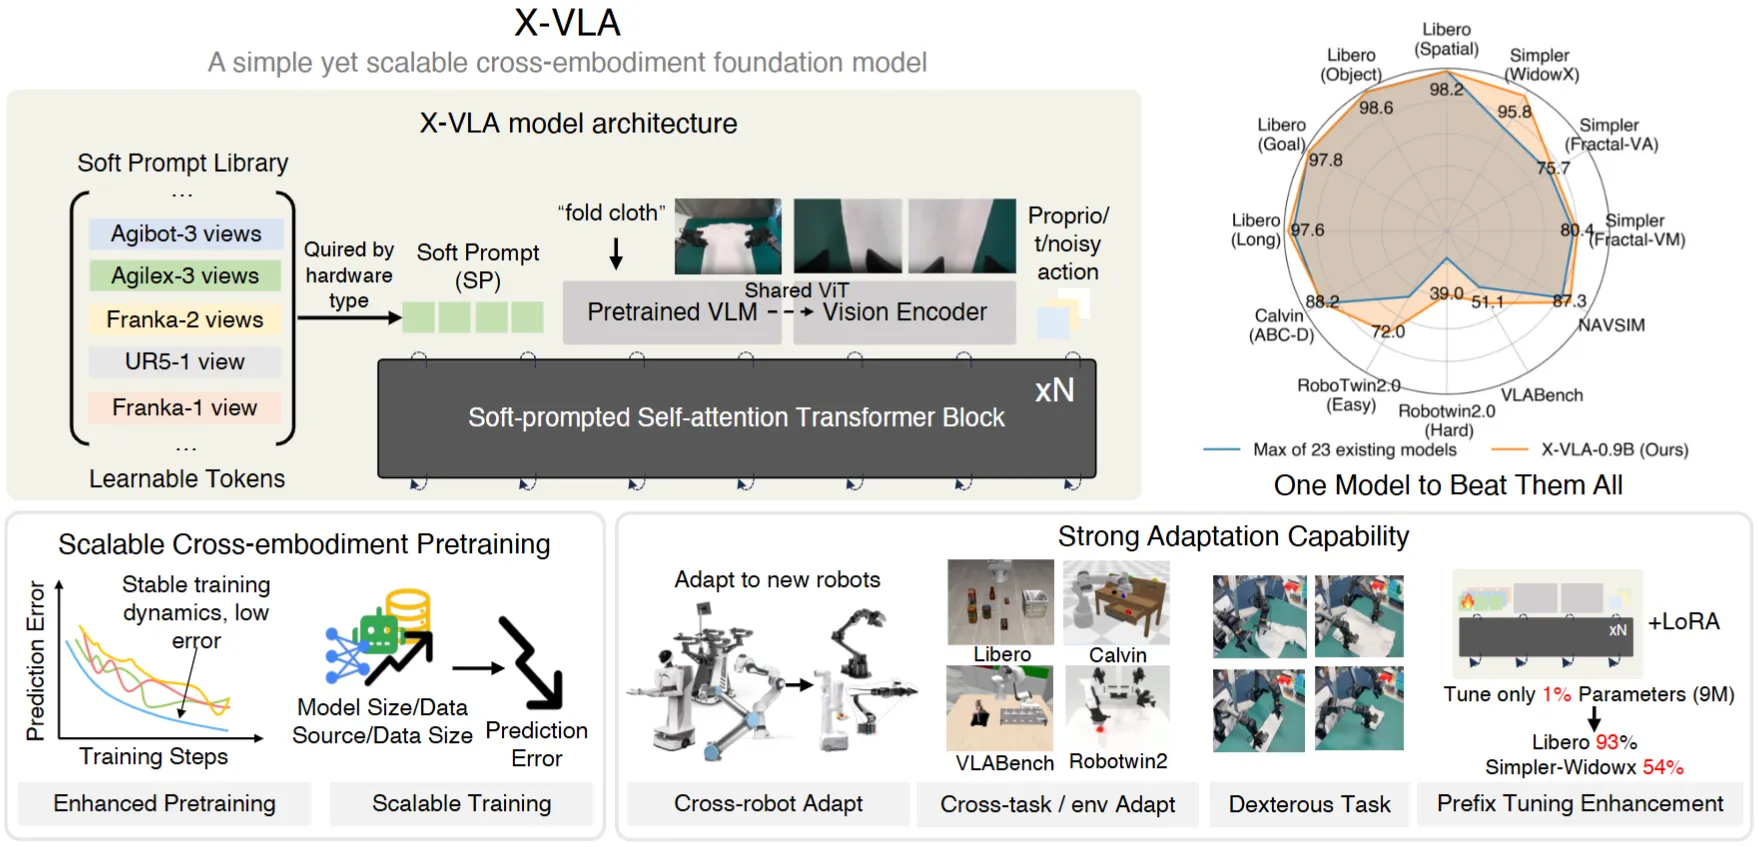
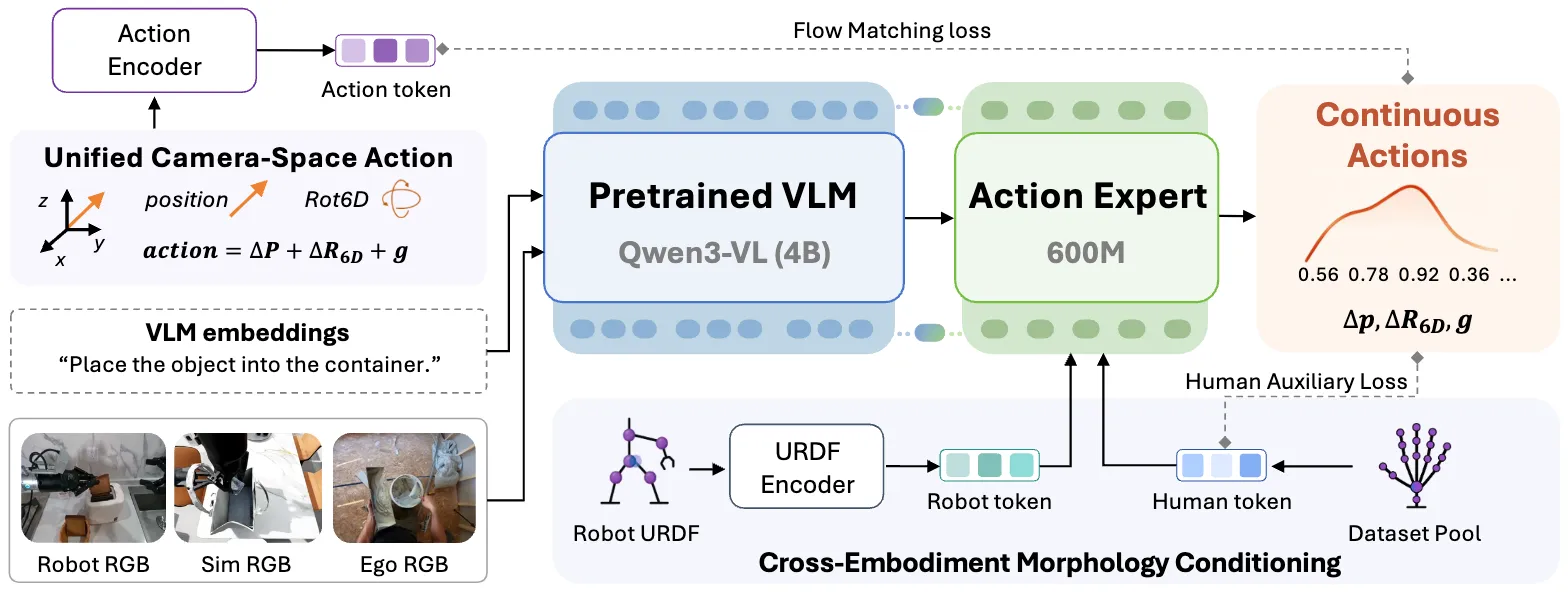
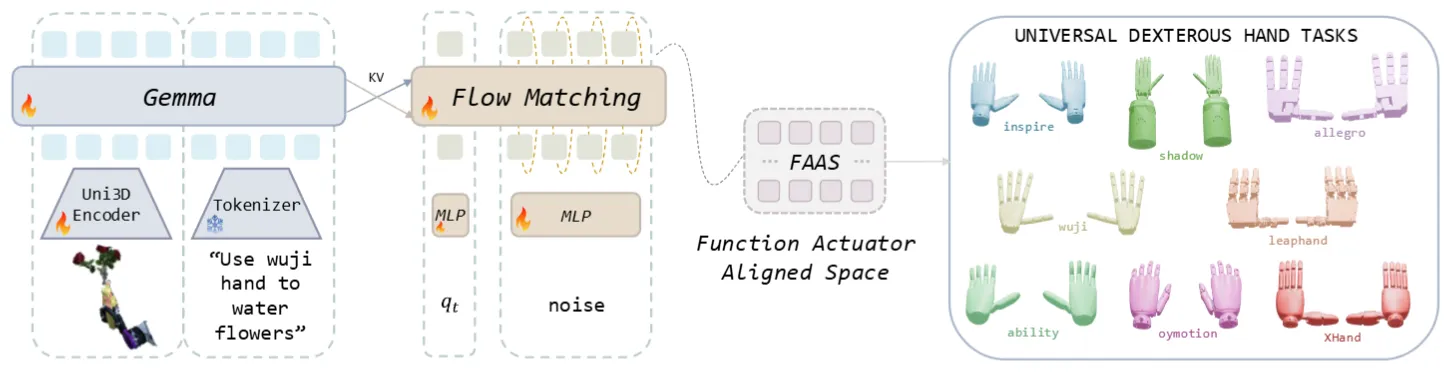
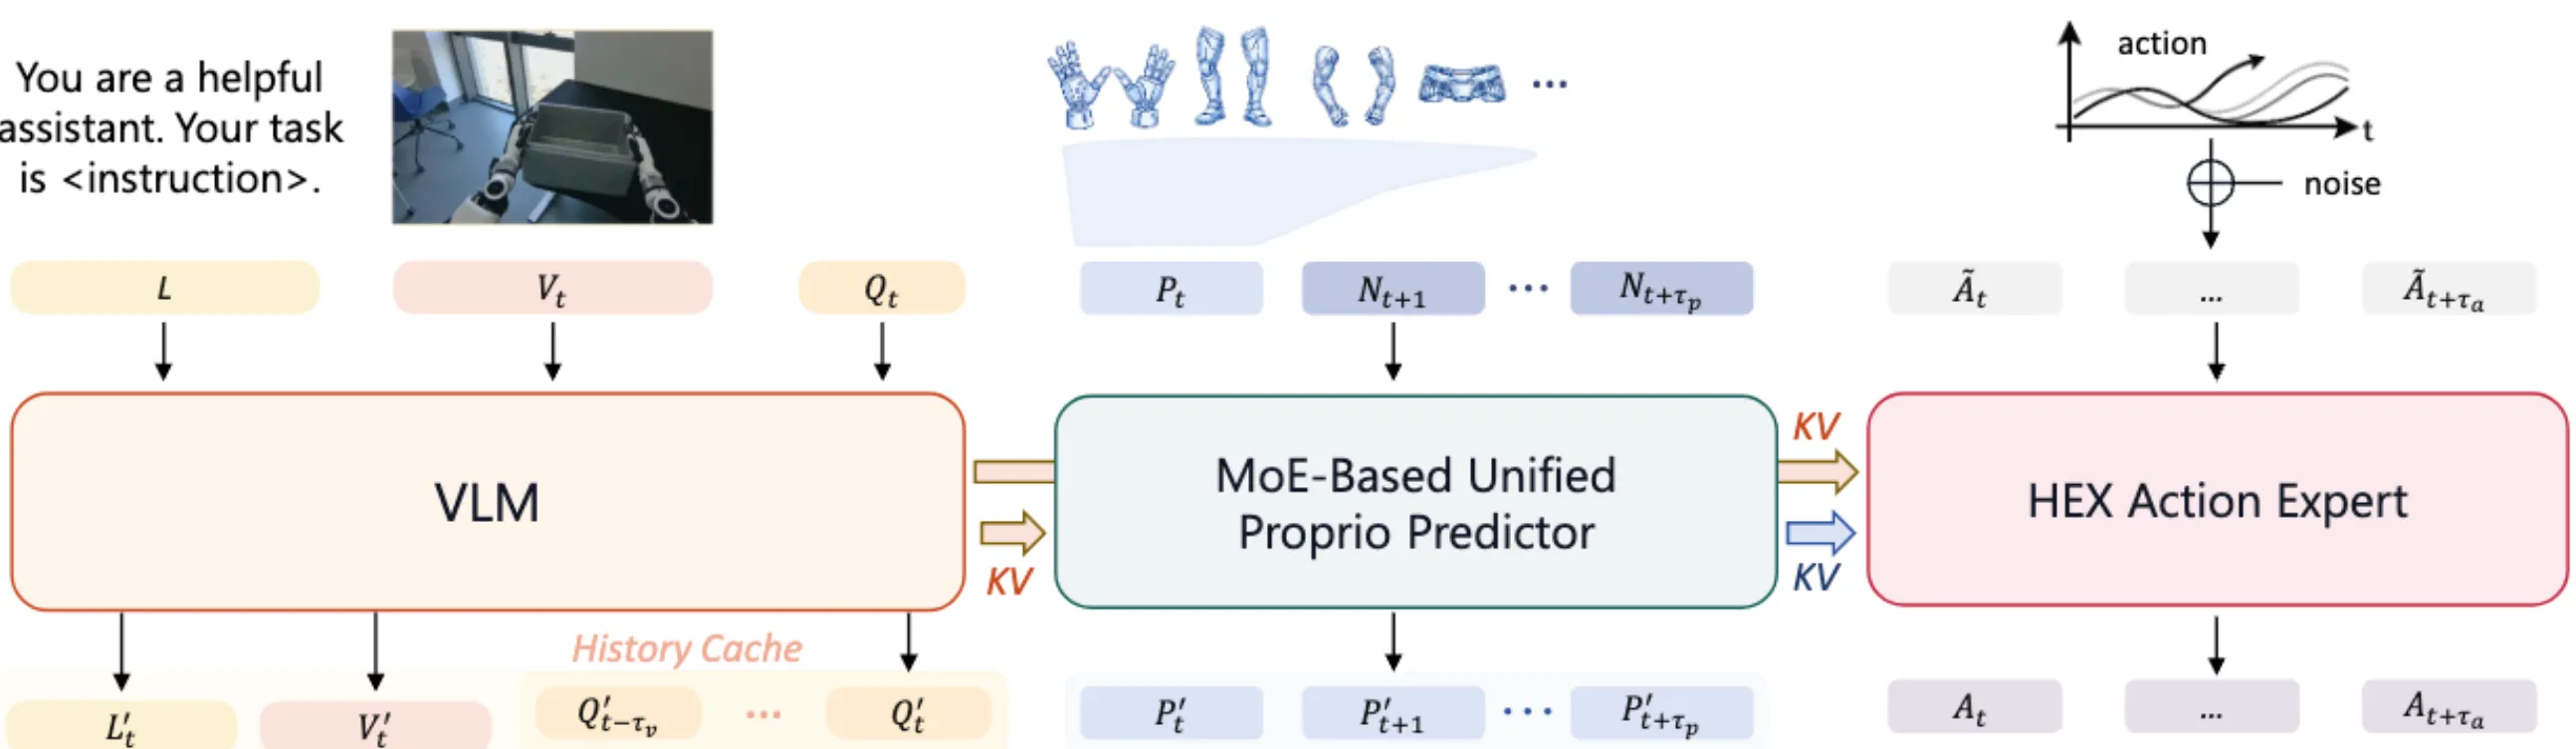
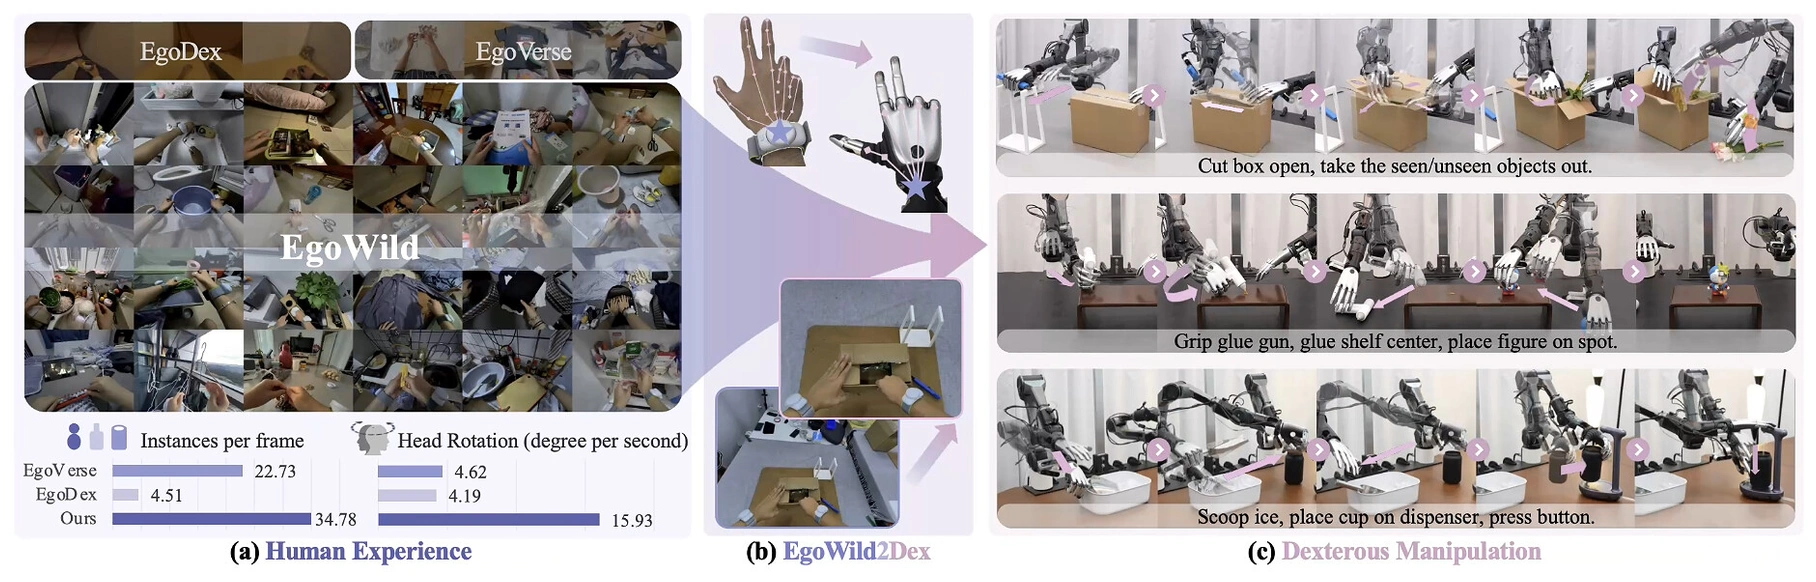
上述方案讲述了如何通过设计 action space,来或显式或隐式地使得不同类型的数据得以放在一起进行混合训练。然而,另外一个难点在于如何让模型意识到数据的本体各不相同,从而更好地进行多峰分布的学习。
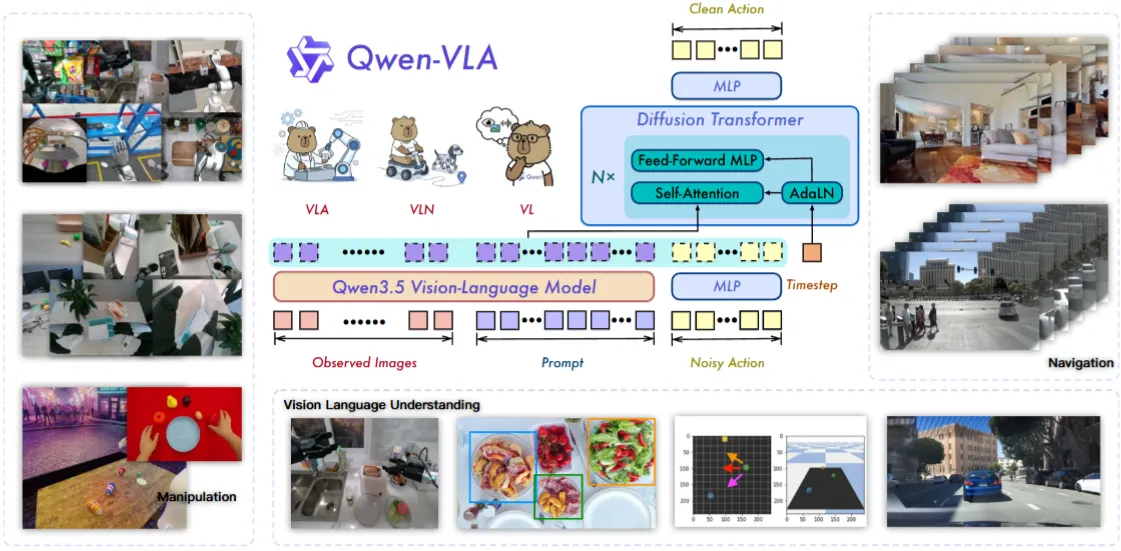
如 等使用 simple padding 的策略进行学习的方法,本质上是坚信模型可以仅通过视觉作为提示,便可以区分不同的本体。然而,在此之后的一系列发展也开始向更加显式的提示进行转变。在 中,抛开蹩脚的使用 Bagel 作为世界模型,其中更是引入了更多的 meta data,这些内容通过文字形式输入到模型中,并且作为模型区分来自不同本体、不同质量以及不同环境数据的凭据。
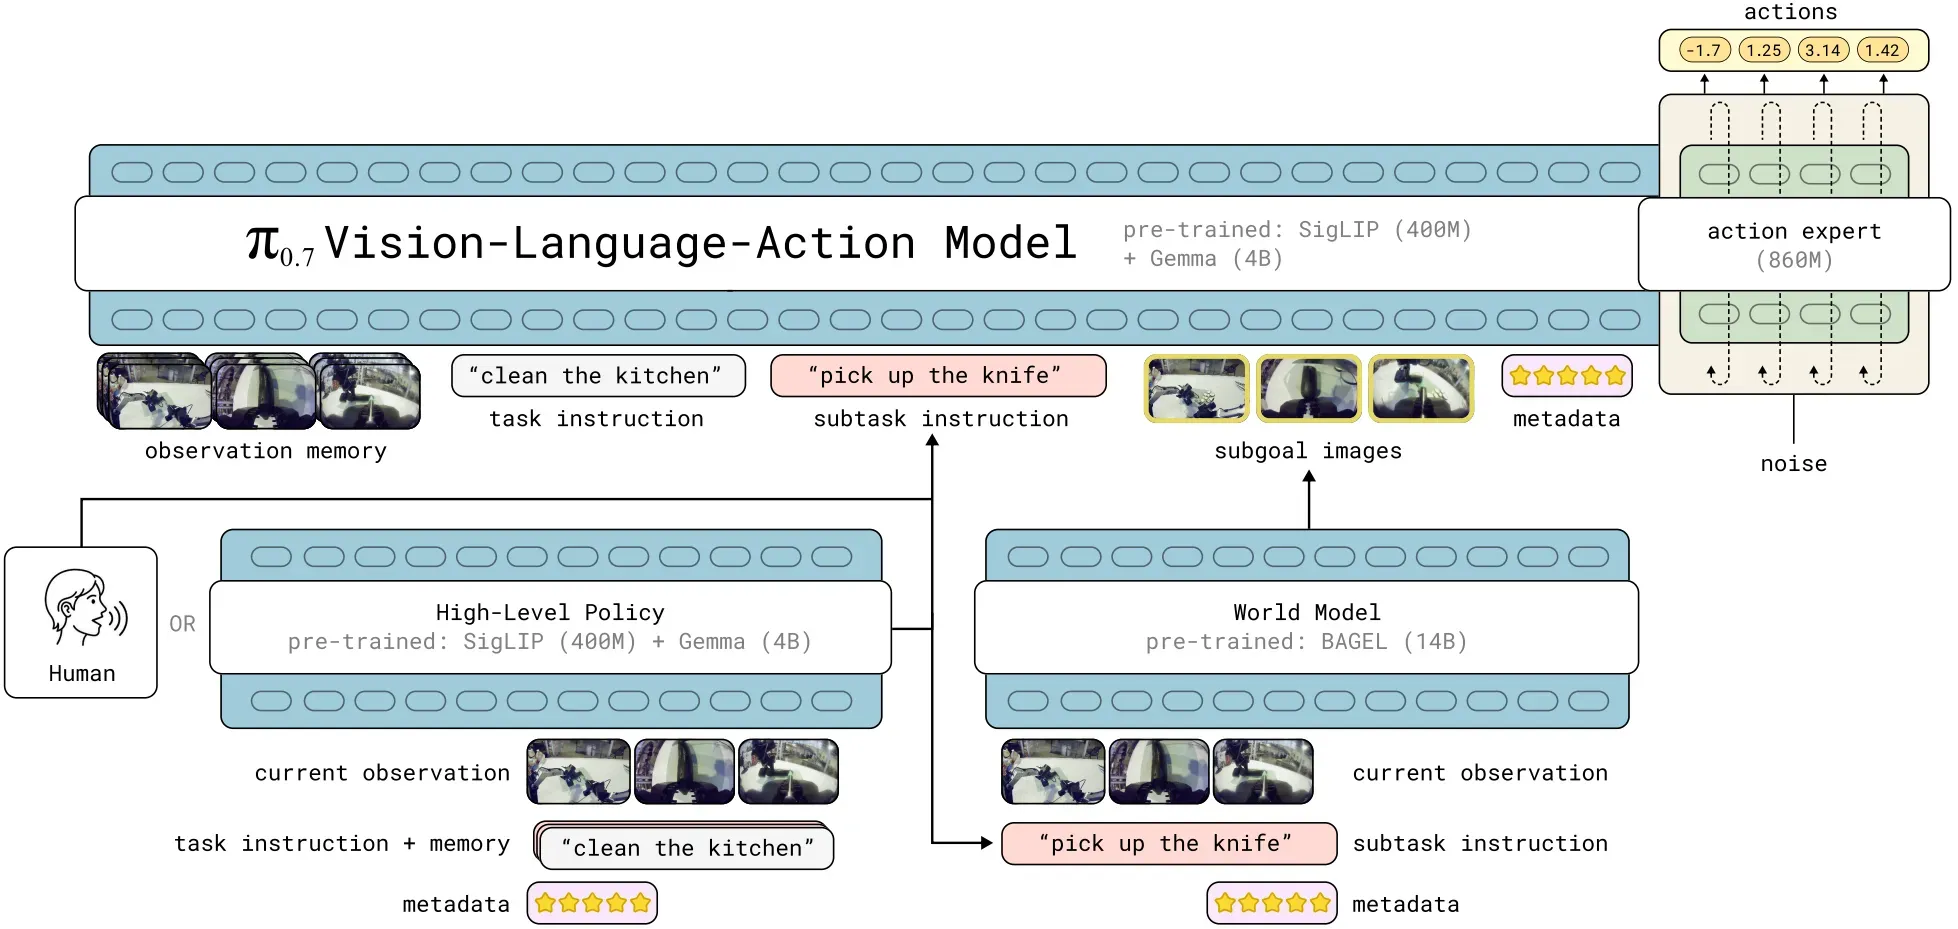
一些其他相关的工作如下所示:
| 论文 | 主要贡献 |
|---|---|
| Qwen-VLA | 使用 meta data 并且进行大规模预训练的 GR00t-like VLA |
Auto-regressive Action Token#
在 VLM + Actor 的训练范式中,本质上与一些 Unified GenAI 领域近似,这一过程中的 VLM 本质可以被草率概括为某种 VL Encoder,而从中 Leverage VLM 的先验知识的能力有限。另一种方案试图直接在 VLM 已有的 AR 范式中直接预测 Action Token。
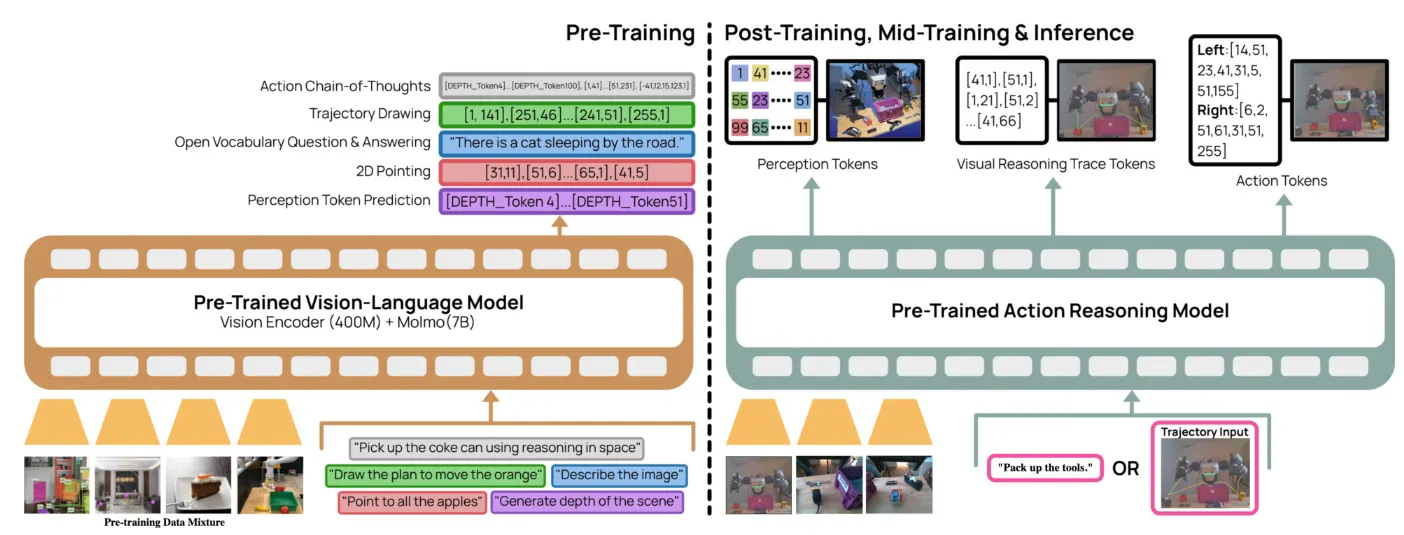
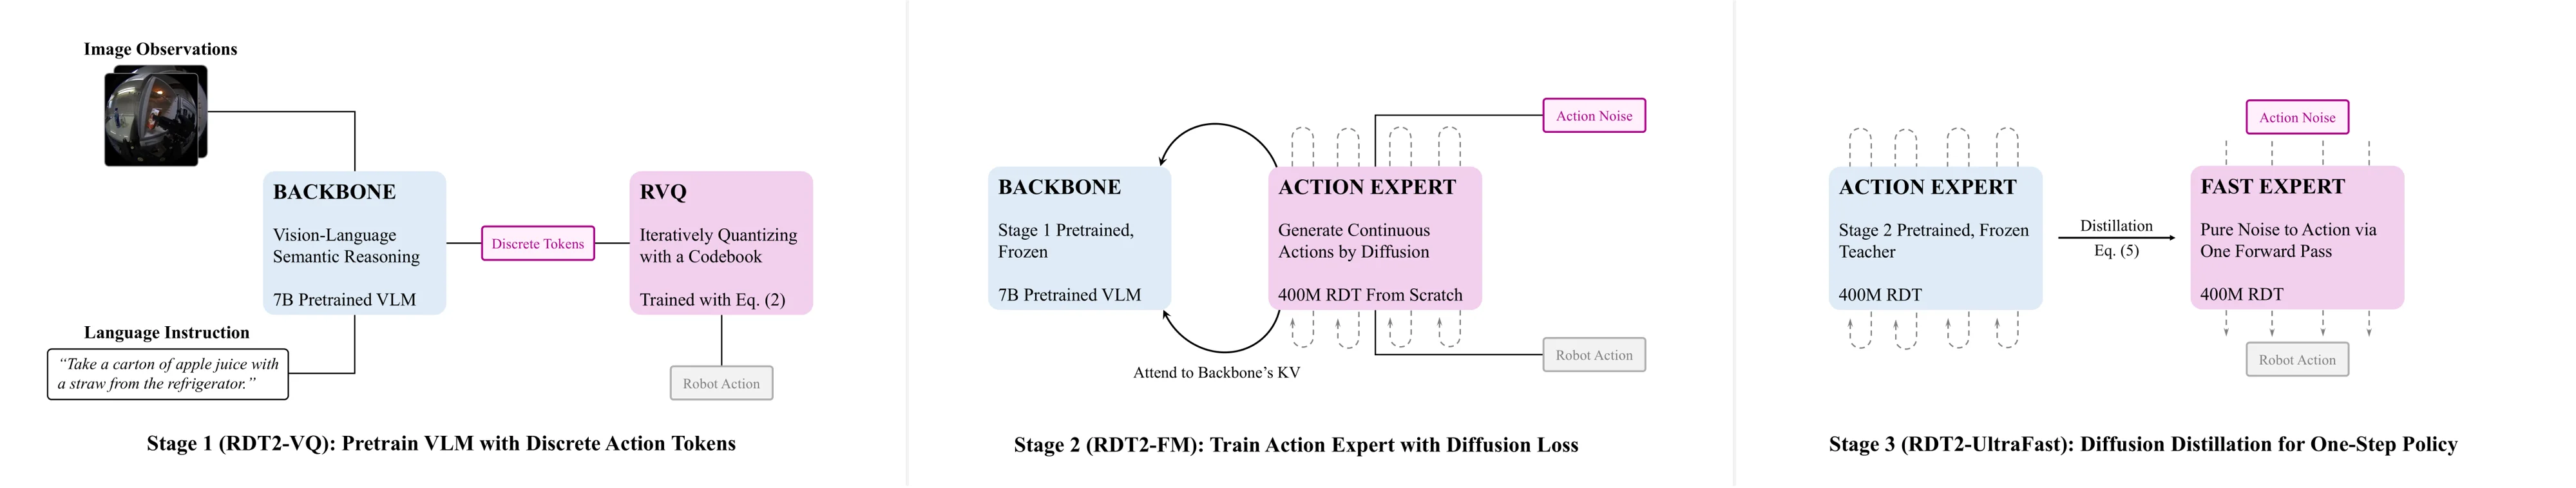
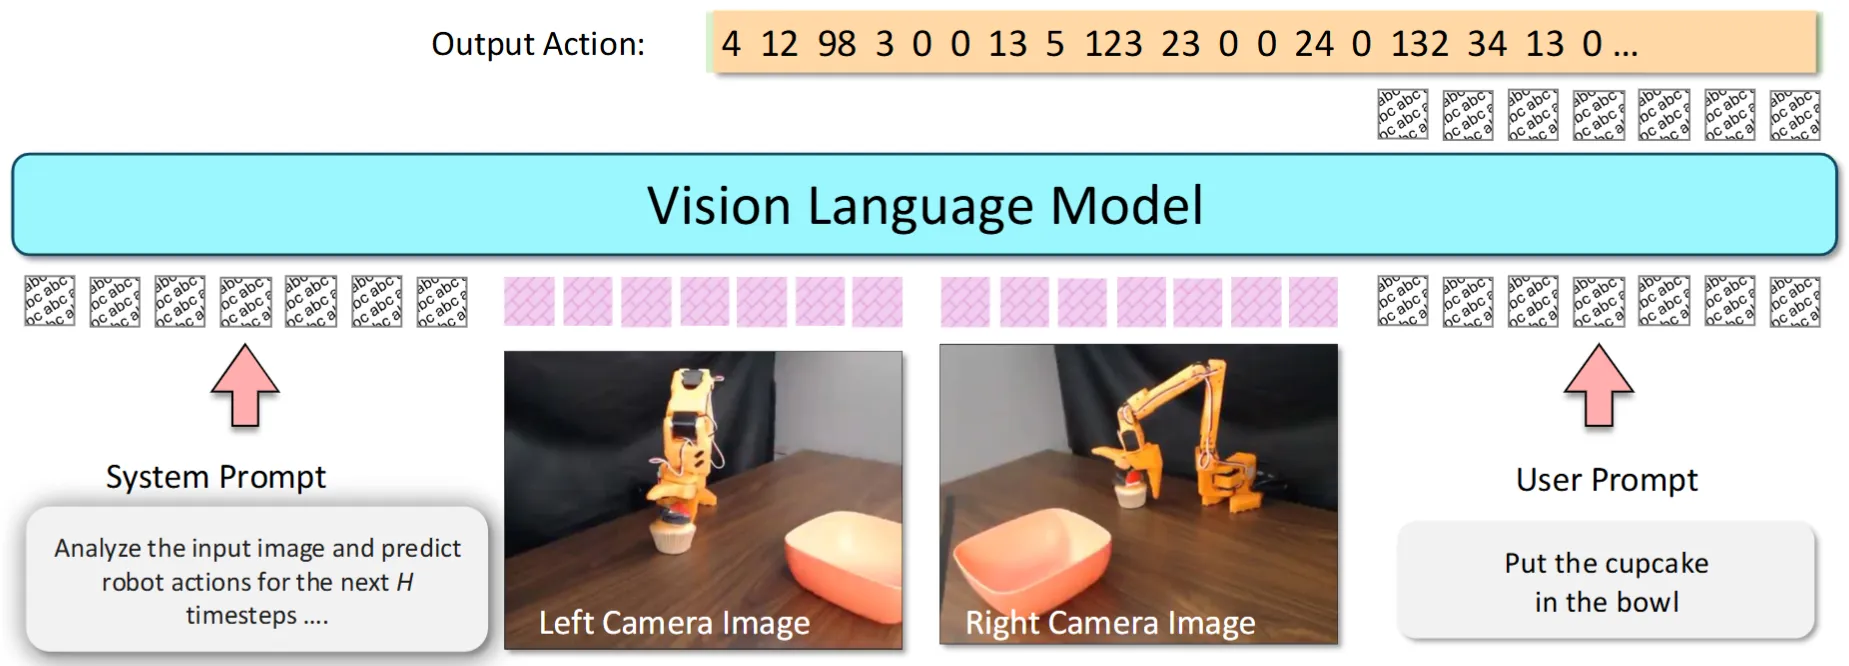
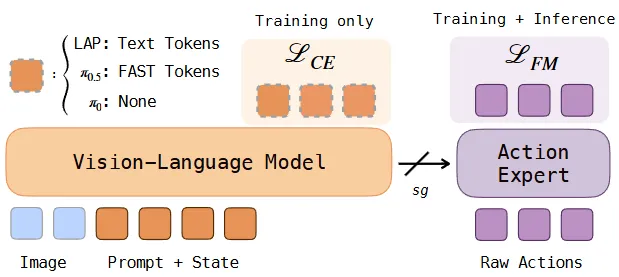
所谓 Action Token,即通过某种算法将连续的 Action 离散化变为 Token,并且确保从 Token 还原为 Action 之后依然具有一定的精度。OpenVLA 等早期 VLA 模型世界预测分 bin 的离散 Token 就是一些早期实现。更加成熟的 Action Tokenizer 中比较经典的是,PI 的 FAST Tokenizer,并且在后续广泛运用在如 等方法的预训练过程中。
其他一些构建 Action Token 或者运用 Action Tokenizer 在预训练中的代表性工作如下所示:
| 论文 | 主要贡献 |
|---|---|
| MolmoAct | Embodied VLM 预训练 + 深度感知 token,轨迹 token 以及 action token 后训练 |
| RDT2 | 使用 RVQ + CNN 取得离散 Action Token 作为 VLM 时跨本体训练,之后正常 Pi 范式 |
| FASTer | 使用 action patchifier 以及 RVQ Tokenizer |
| VLA-0 | VLM 直接输出文本 Action 的 VLA,好玩的尝试 |
| LAP | 使用 Language 对动作的描述作为 Action Token |
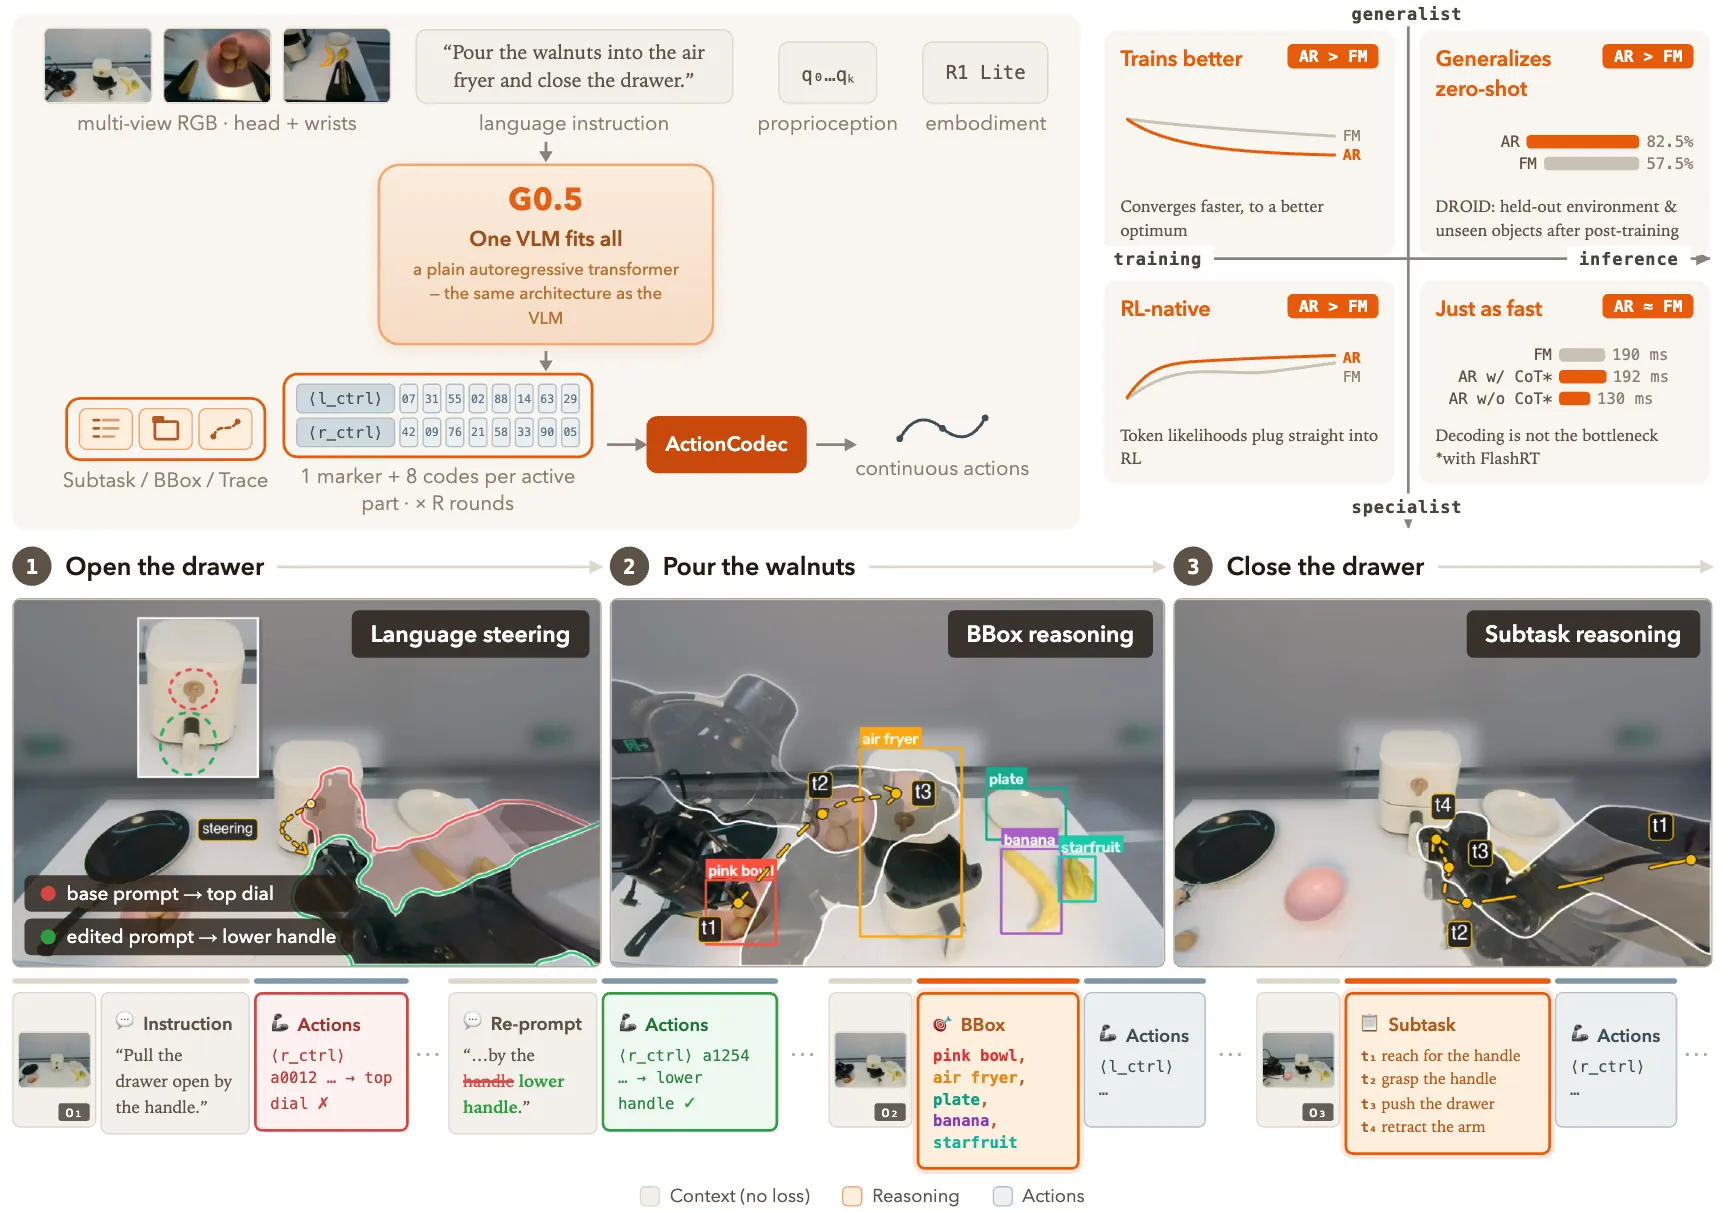
| G0.5 | 使用 Action Token 进行预训练的 AR VLA,可以实现有限的泛化 |
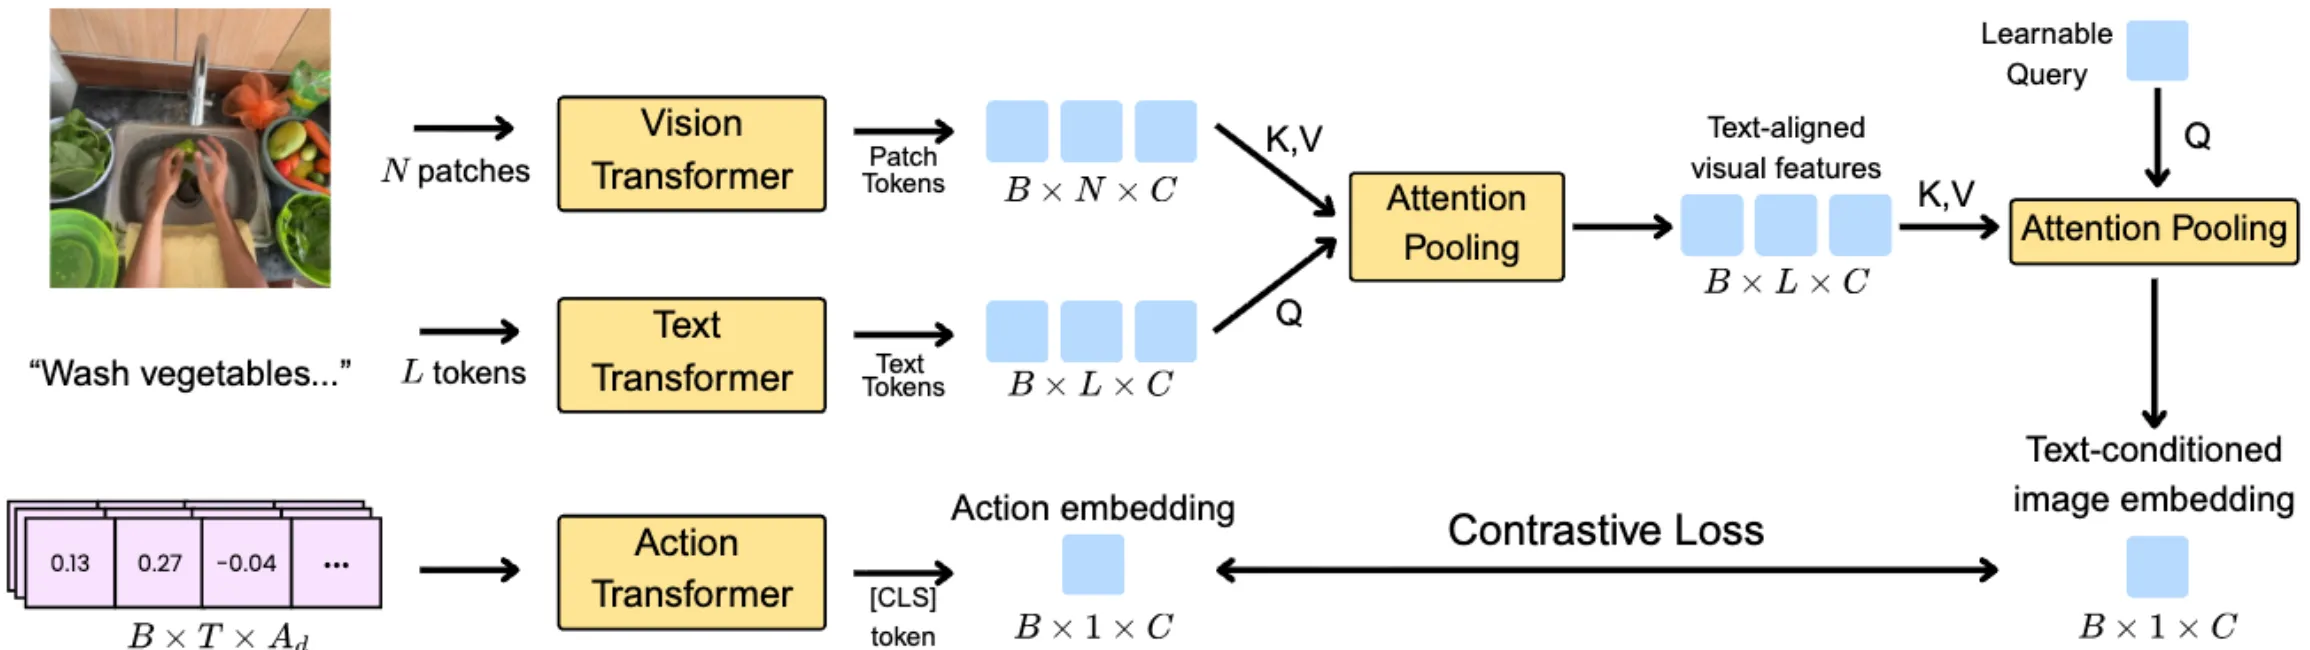
| CAIP | Vision-Action 对比学习构造 Action Token |
| Actioncodec | 定义了一些合理的 Training Objective 并且设计了对应的结构 |
VLM-VLA Co-training#
在这一过程中,从 OpenVLA 开始,VLA 便开始面临一个本质问题,即使用 LLM 或者 VLM 的初衷来自于 leverage 模型的泛化能力,然而在模型的后训练过程中,由于 training objective 的变化以及数据的分布变化,使得模型面临灾难性遗忘的问题。
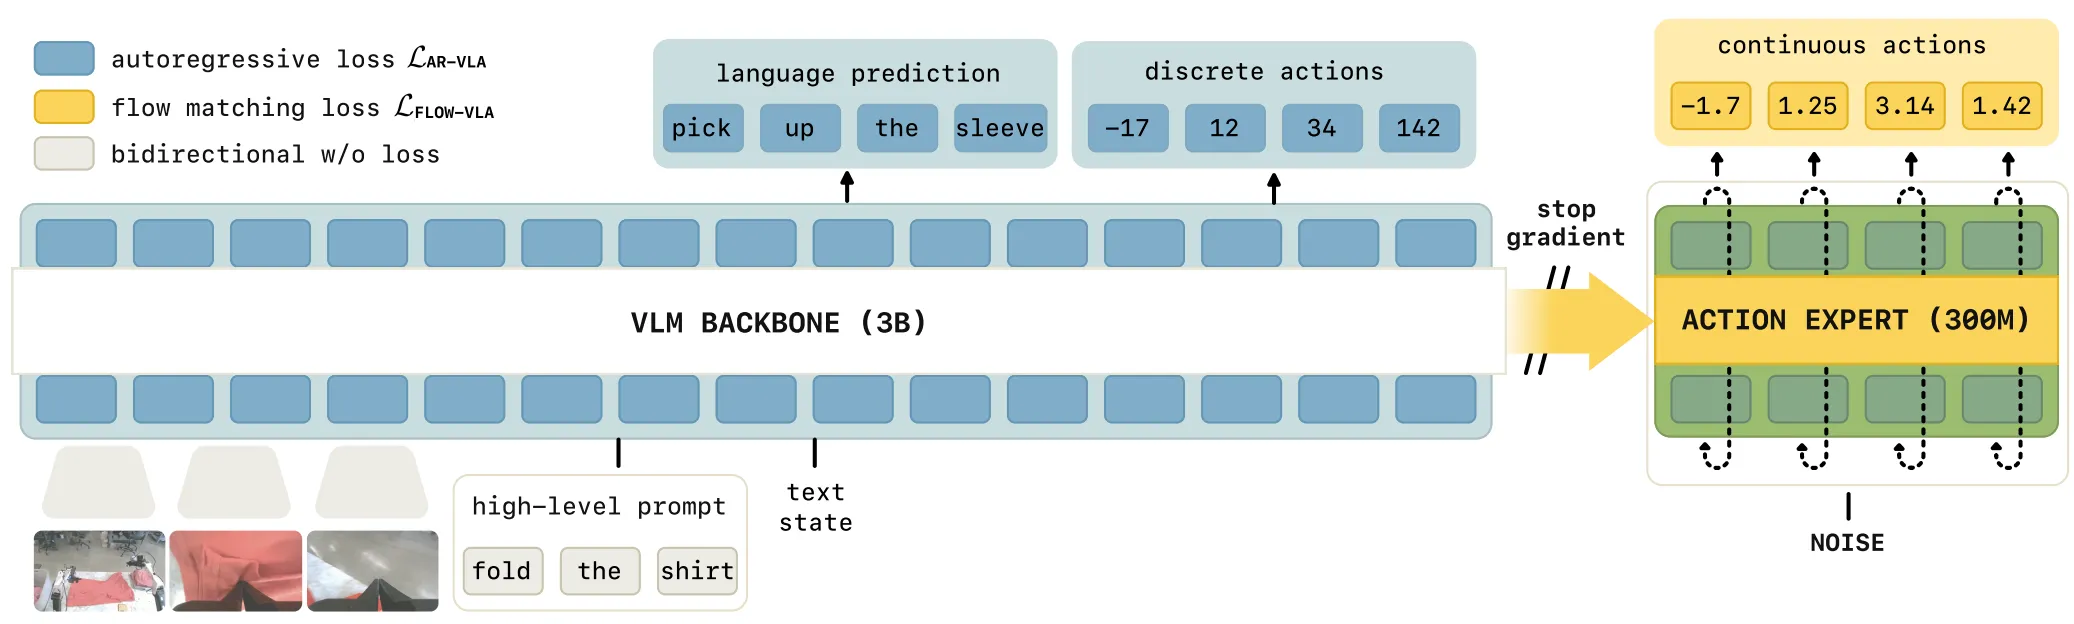
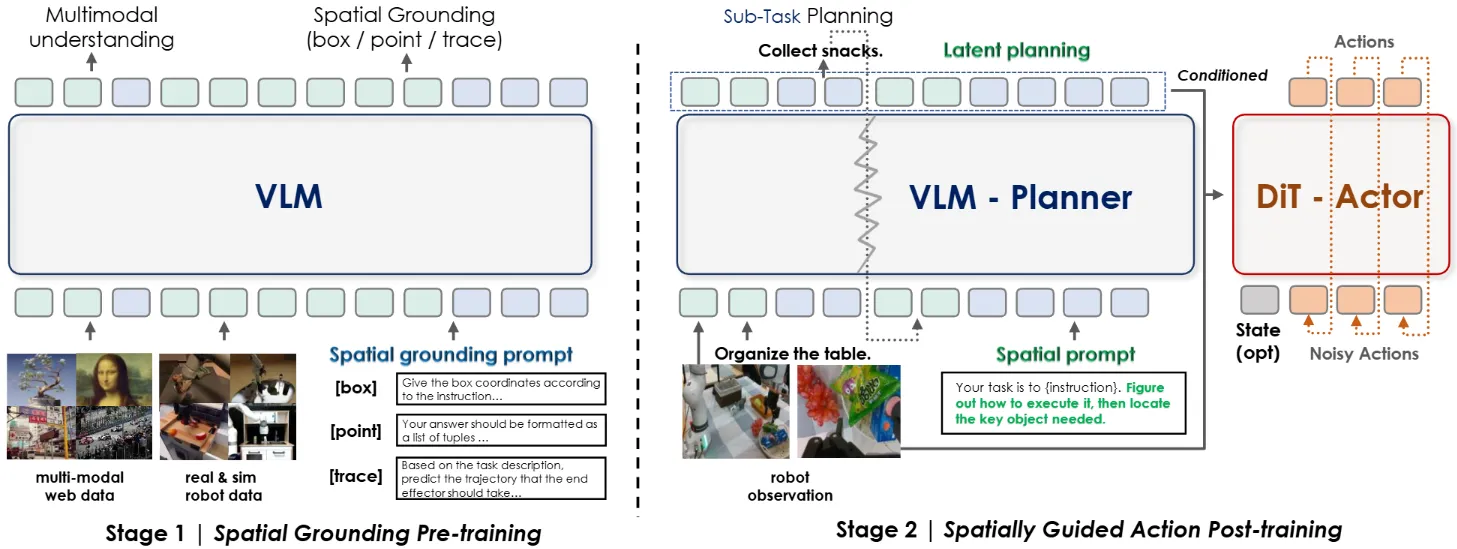
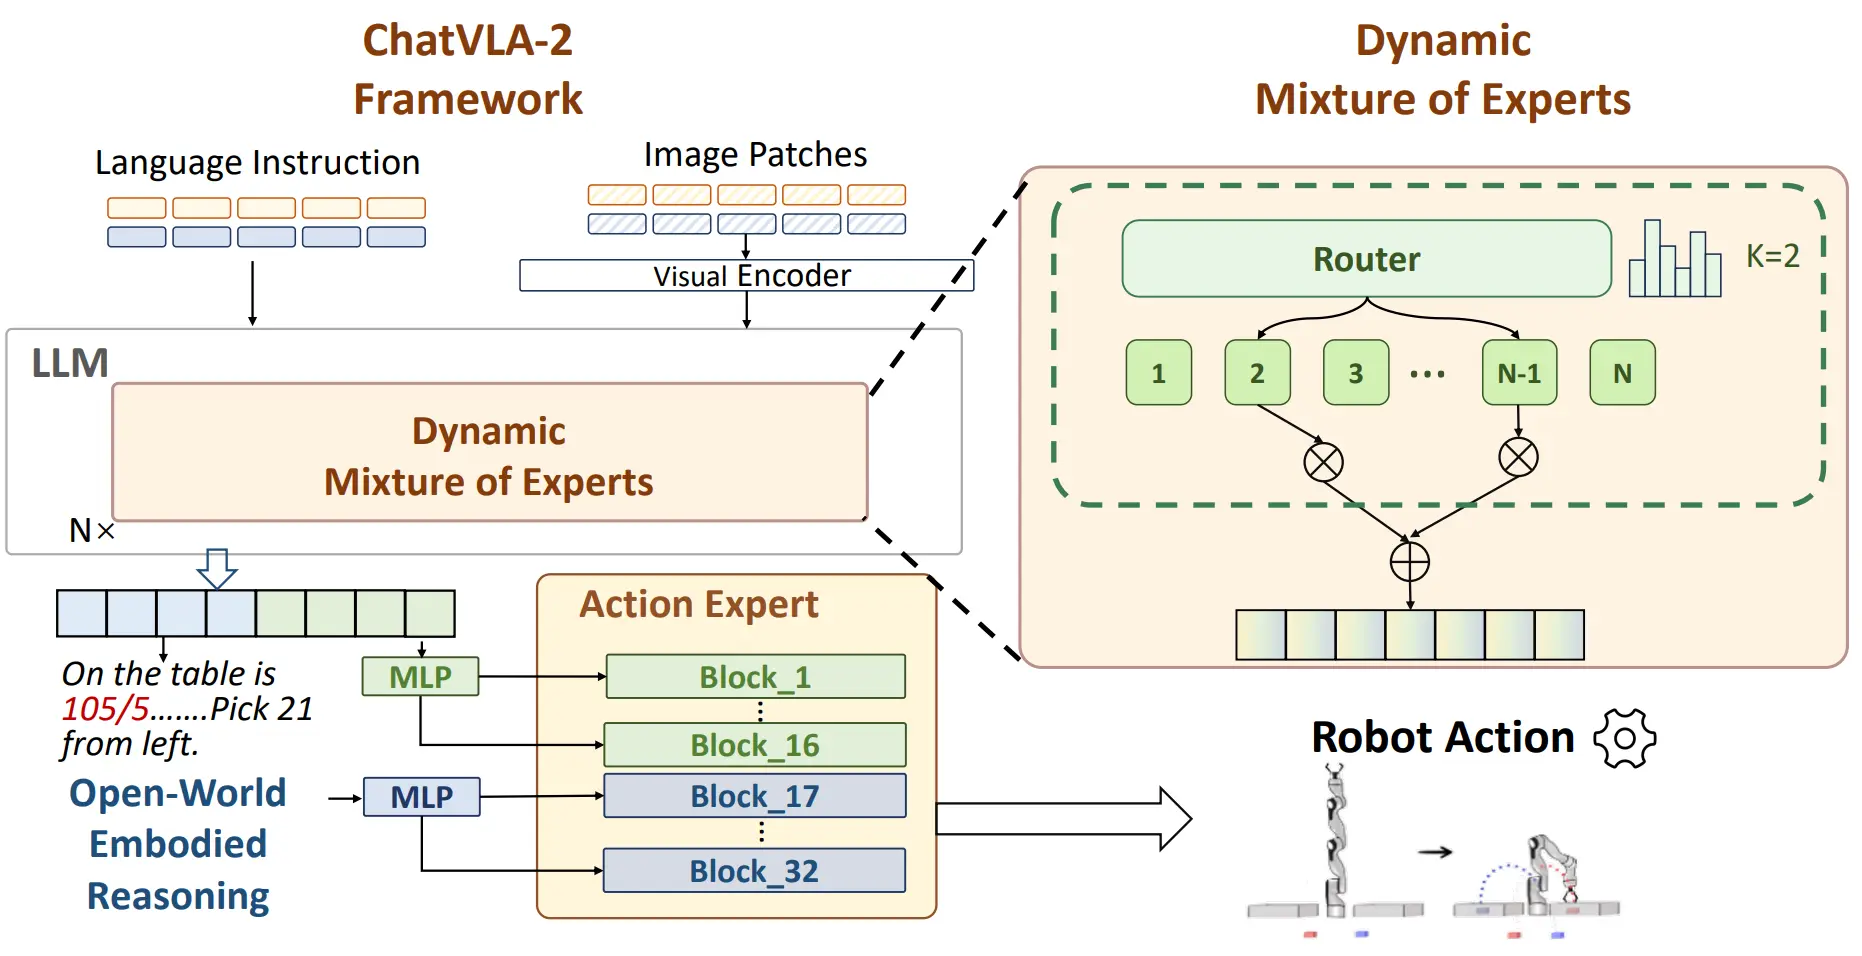
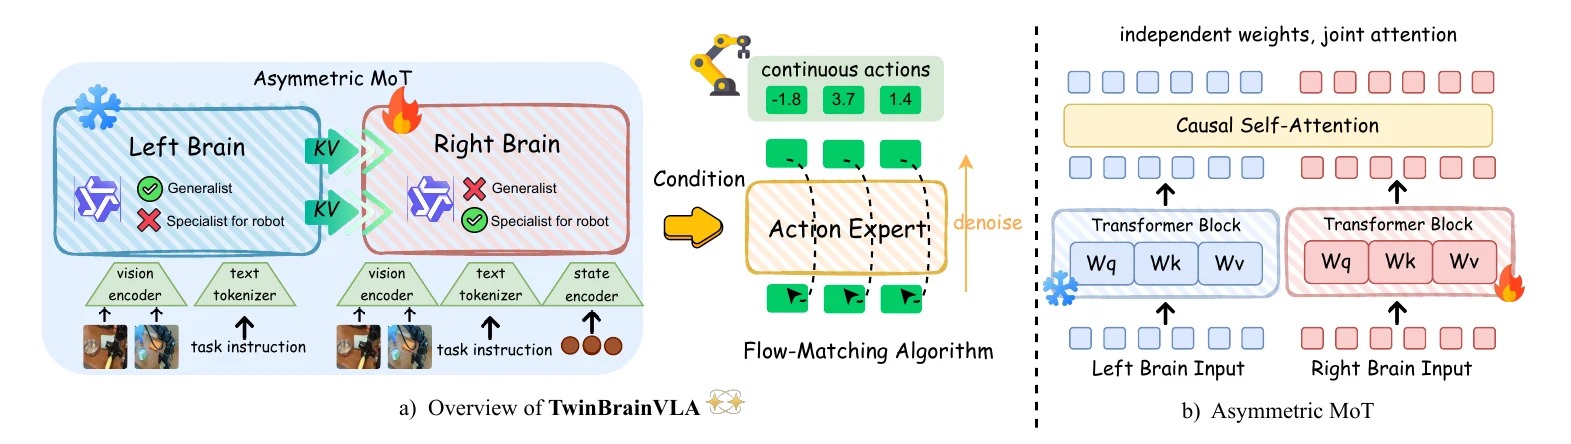
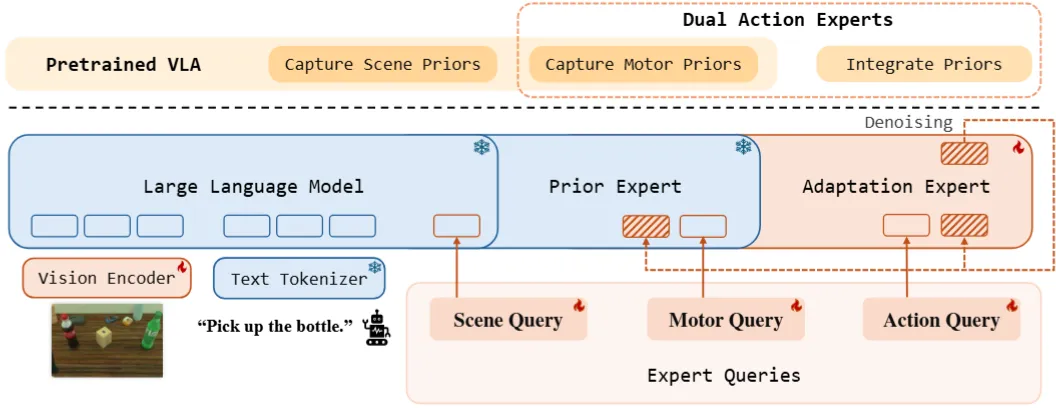
一种简单直接的解法就是直接使用 co-training 的方式,将 VQA 的监督加回到模型的预训练过程中,使得模型本身的 VL 理解能力不会有过多的退化。与此同时,一些额外的技巧得以在这一阶段中被使用,在这方面一系列工作通过不同的角度尝试解决这一问题:
| 论文 | 主要贡献 |
|---|---|
| -KI | 在 VLM 以及 Actor 之间使用 stop gradient |
| InternVLA-M1 | 在后训练阶段依然使用 VLM-VLA 的 co-training |
| ChatVLA-2 | 使用 Dynamic MOE |
| TwinBrainVLA | Frozen VLM + VLM + Actor 的 MoT 以避免灾难性遗忘 |
| PriorVLA | Frozen VLA + Actor 的 MoT 来利用 VLA 先验知识 |
Latent Action#
所谓 Latent Action,一些研究者认为,在全部的视频数据之间存在着一种隐含的隐式动作。这里的“latent”并不等价于我们描述的“latent space”,而是一种更加 general 的 action 表示。在不同的视频中,例如 egocentric 视角中人类操作物体,机器人视频中机器人做出的动作,甚至第三人称视角的人类数据中人类对应的动作,他们之间应该具有一种共通的动作,我们统称为 latent action。
研究者相信,这些视频之间主要的动作部分,即来自于我们希望蒸馏出的本体所获得的运动表示,这是造成这些视频中动态的主要变化来源,因此,通过一些学习的方式,可以从这些视频中提取出这些隐含的动作表示,从而更好地 leverage 更大规模的视频数据,而不仅局限于有限的机器人数据,甚至 UMI 和异构数据。
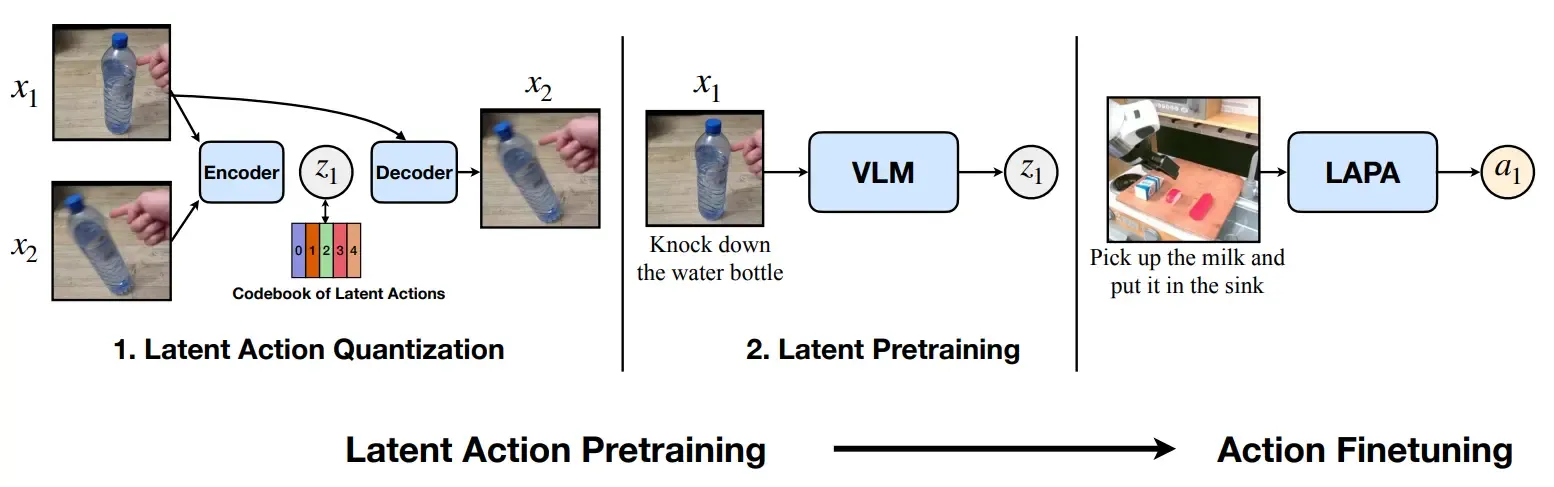
LAPA 较为早期地把 Latent Action 用在了 VLA 的预训练上,其中 FDM 和 IDM 的设计来自更早的 LAPO,一个 Encoder 输入 以及 预测 ,Decoder 输入 以及 预测 ,从此我们认为其中的 可以表征一种动态信息,或者说其实本身就是预测光流的表示。
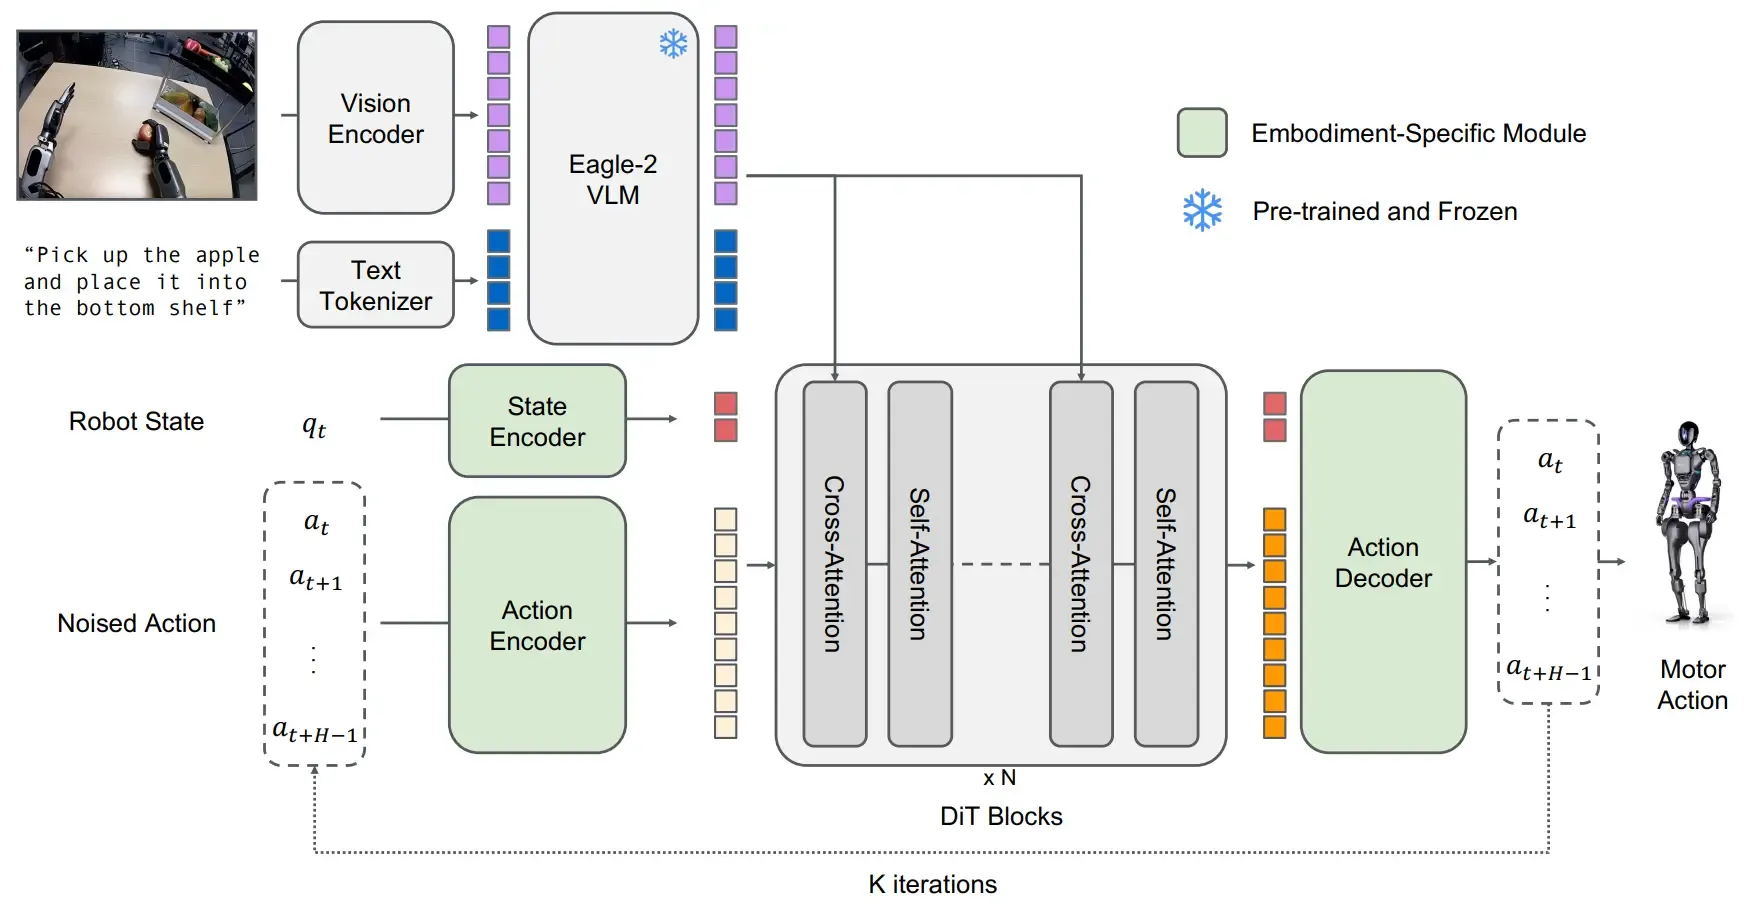
GR00t 是 NVIDIA 出品的另一系列的 VLA 模型,本身使用 VLM 的 Hidden State(N1 中是 Eagle-2)作为 Condition,提供给下游的 Actor。相较于之前的 系列模型,除了连接方式上的差异,GR00t 引入了 Latent Action,即通过 VAE 的方式从视频中提取的一种动态特征,可表征 Action 类似的含义,作为预训练的组成部分。
不过 LAPA 的设计存在一些问题,这些画面的变化不止包括动作本身,还有相机视角的移动、场景本身的变化等其他因素,因此后续也存在一些 Follow-up 来解决这一问题:
| 论文 | 主要贡献 |
|---|---|
| UniVLA | 提出了一种两阶段的训练来更好地提取 Latent Action |
| villa-X | 增加了一组 proprio FDM 来直接基于 z 以及 state 预测未来的 state 以及 Action 来更好提取 latent |
| CLAP | 使用对比学习构造 Latent Action |
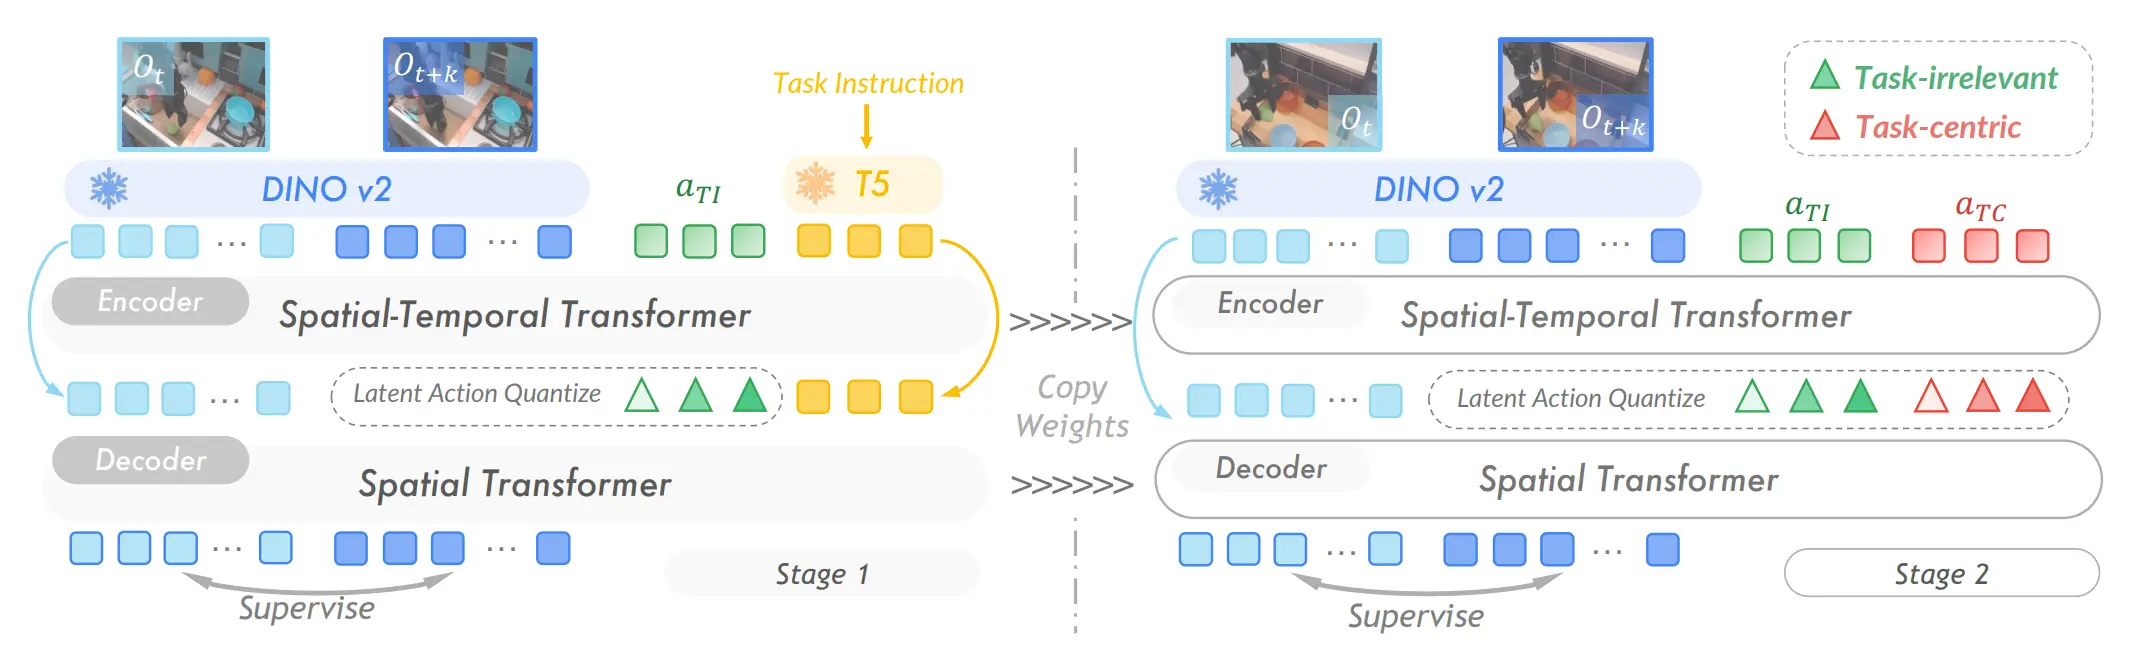
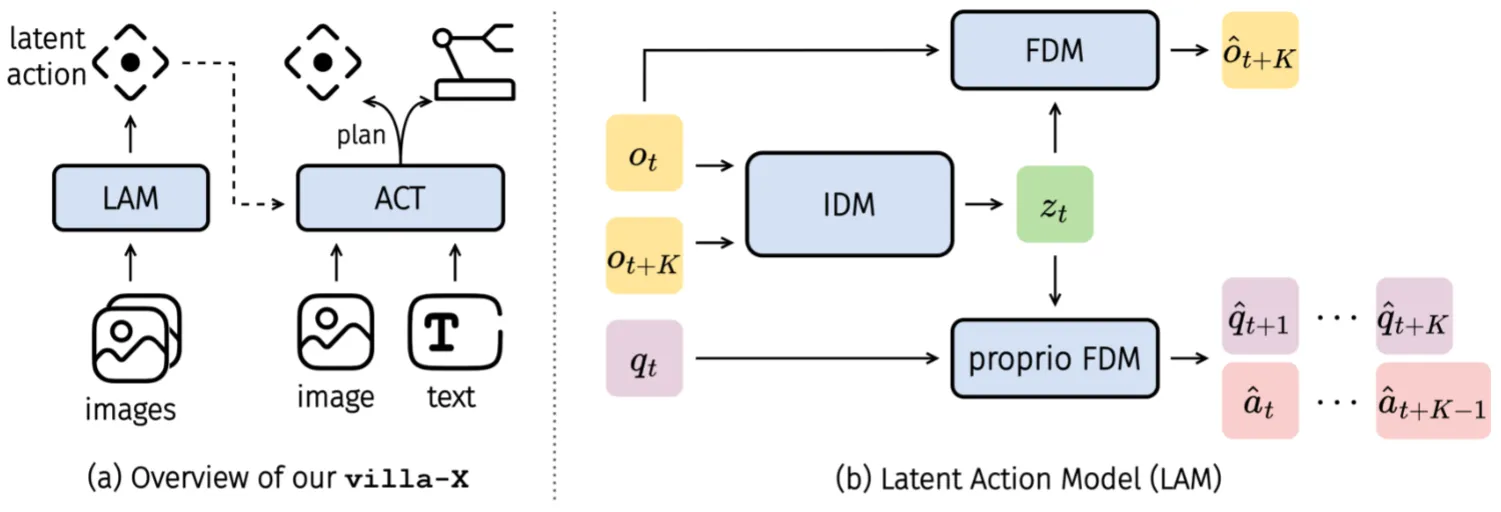
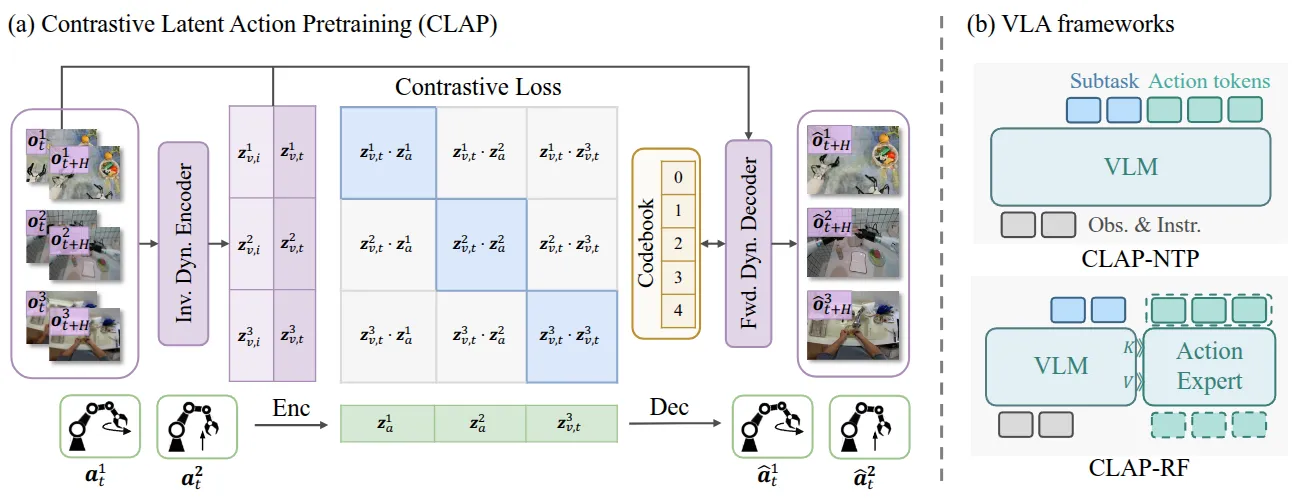
当然,Study 一节中的 What Matters for Latent Actions 也发现,朴素的 LAPO 形式反而简洁有效。
Scaling 异质数据#
一方面,在训练的过程中,我们希望使用更好的数据进行训练。同时,一个现实在于,大量的数据其实质量参差不齐,并且包括若干失败或从失败中恢复的数据,这些数据同样具有价值。由于具身领域中的数据匮乏,以及我们希望全部的数据中不仅包括成功的轨迹,更包括更多样、从失败中恢复的轨迹,从而增强模型策略学习过程中的鲁棒性。因此,我们不得不、也有必要从那些质量和行为模式各不相同的数据中进行统一的学习,并且使得模型尽量在这一过程中,不要因为那些质量较低的数据而产生训练的劣化。
在 的故事中,似乎试图表述一种在离线数据上进行强化学习的技术路线。但本质上,它是通过一个 reward model,并将 reward 作为一种显式信号输入给模型,来让模型 be aware of 数据的质量,从而在事实上是通过输入价值函数的方式来更好地利用那些失败和低质量数据。
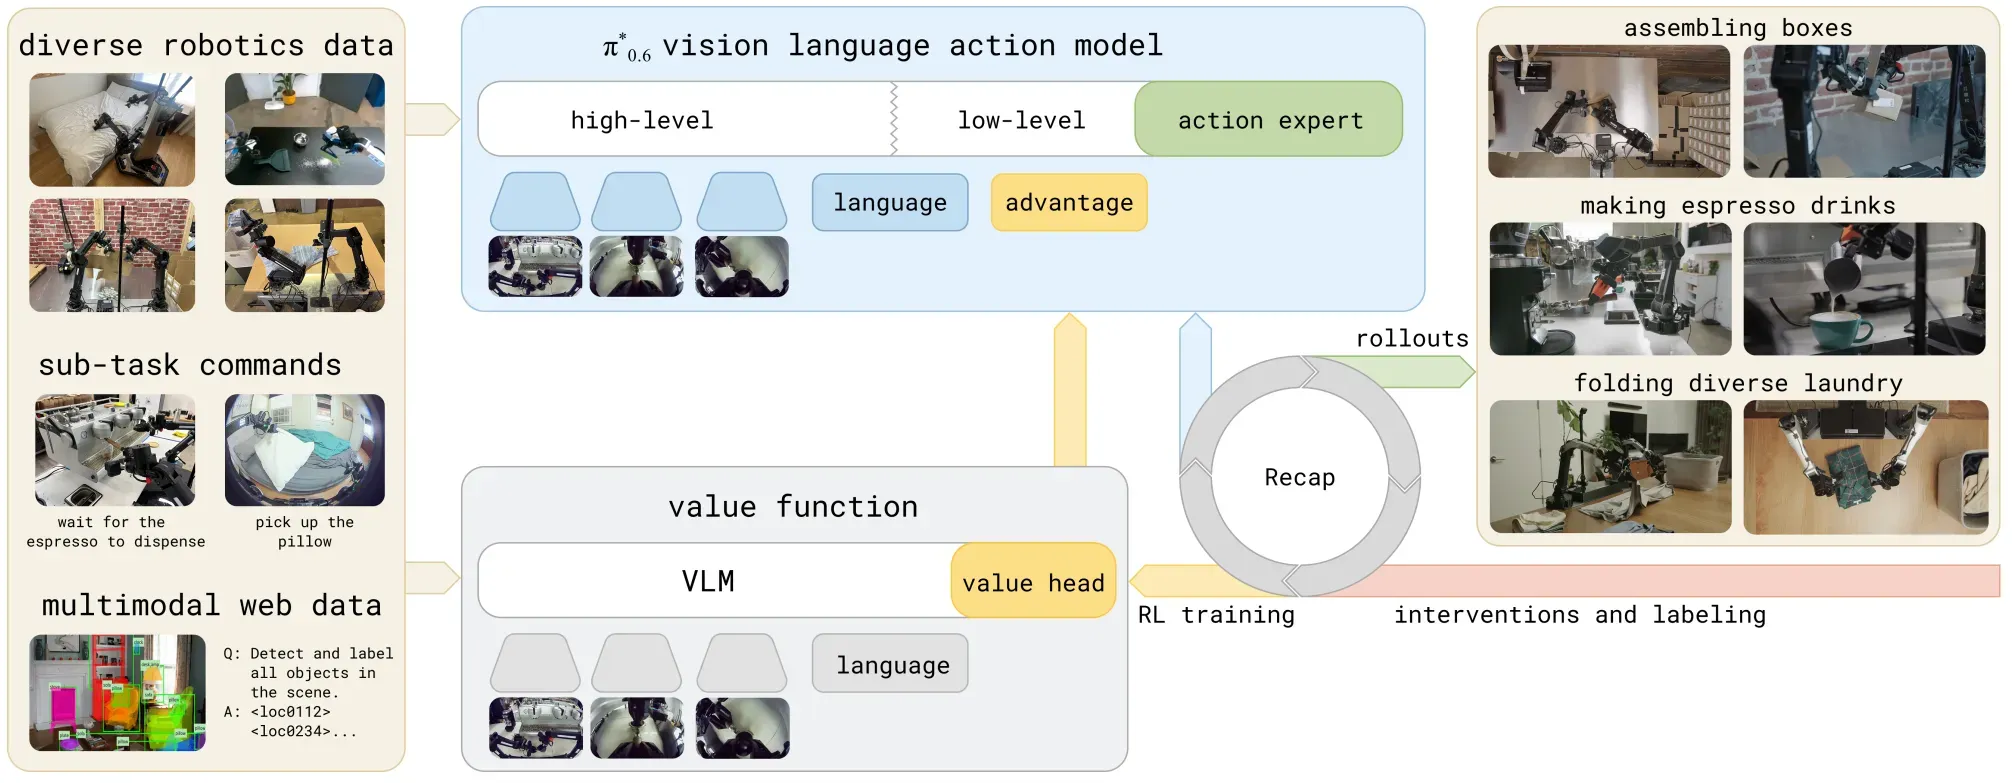
后续也存在一些 Follow-up 来解决这一问题:
| 论文 | 主要贡献 |
|---|---|
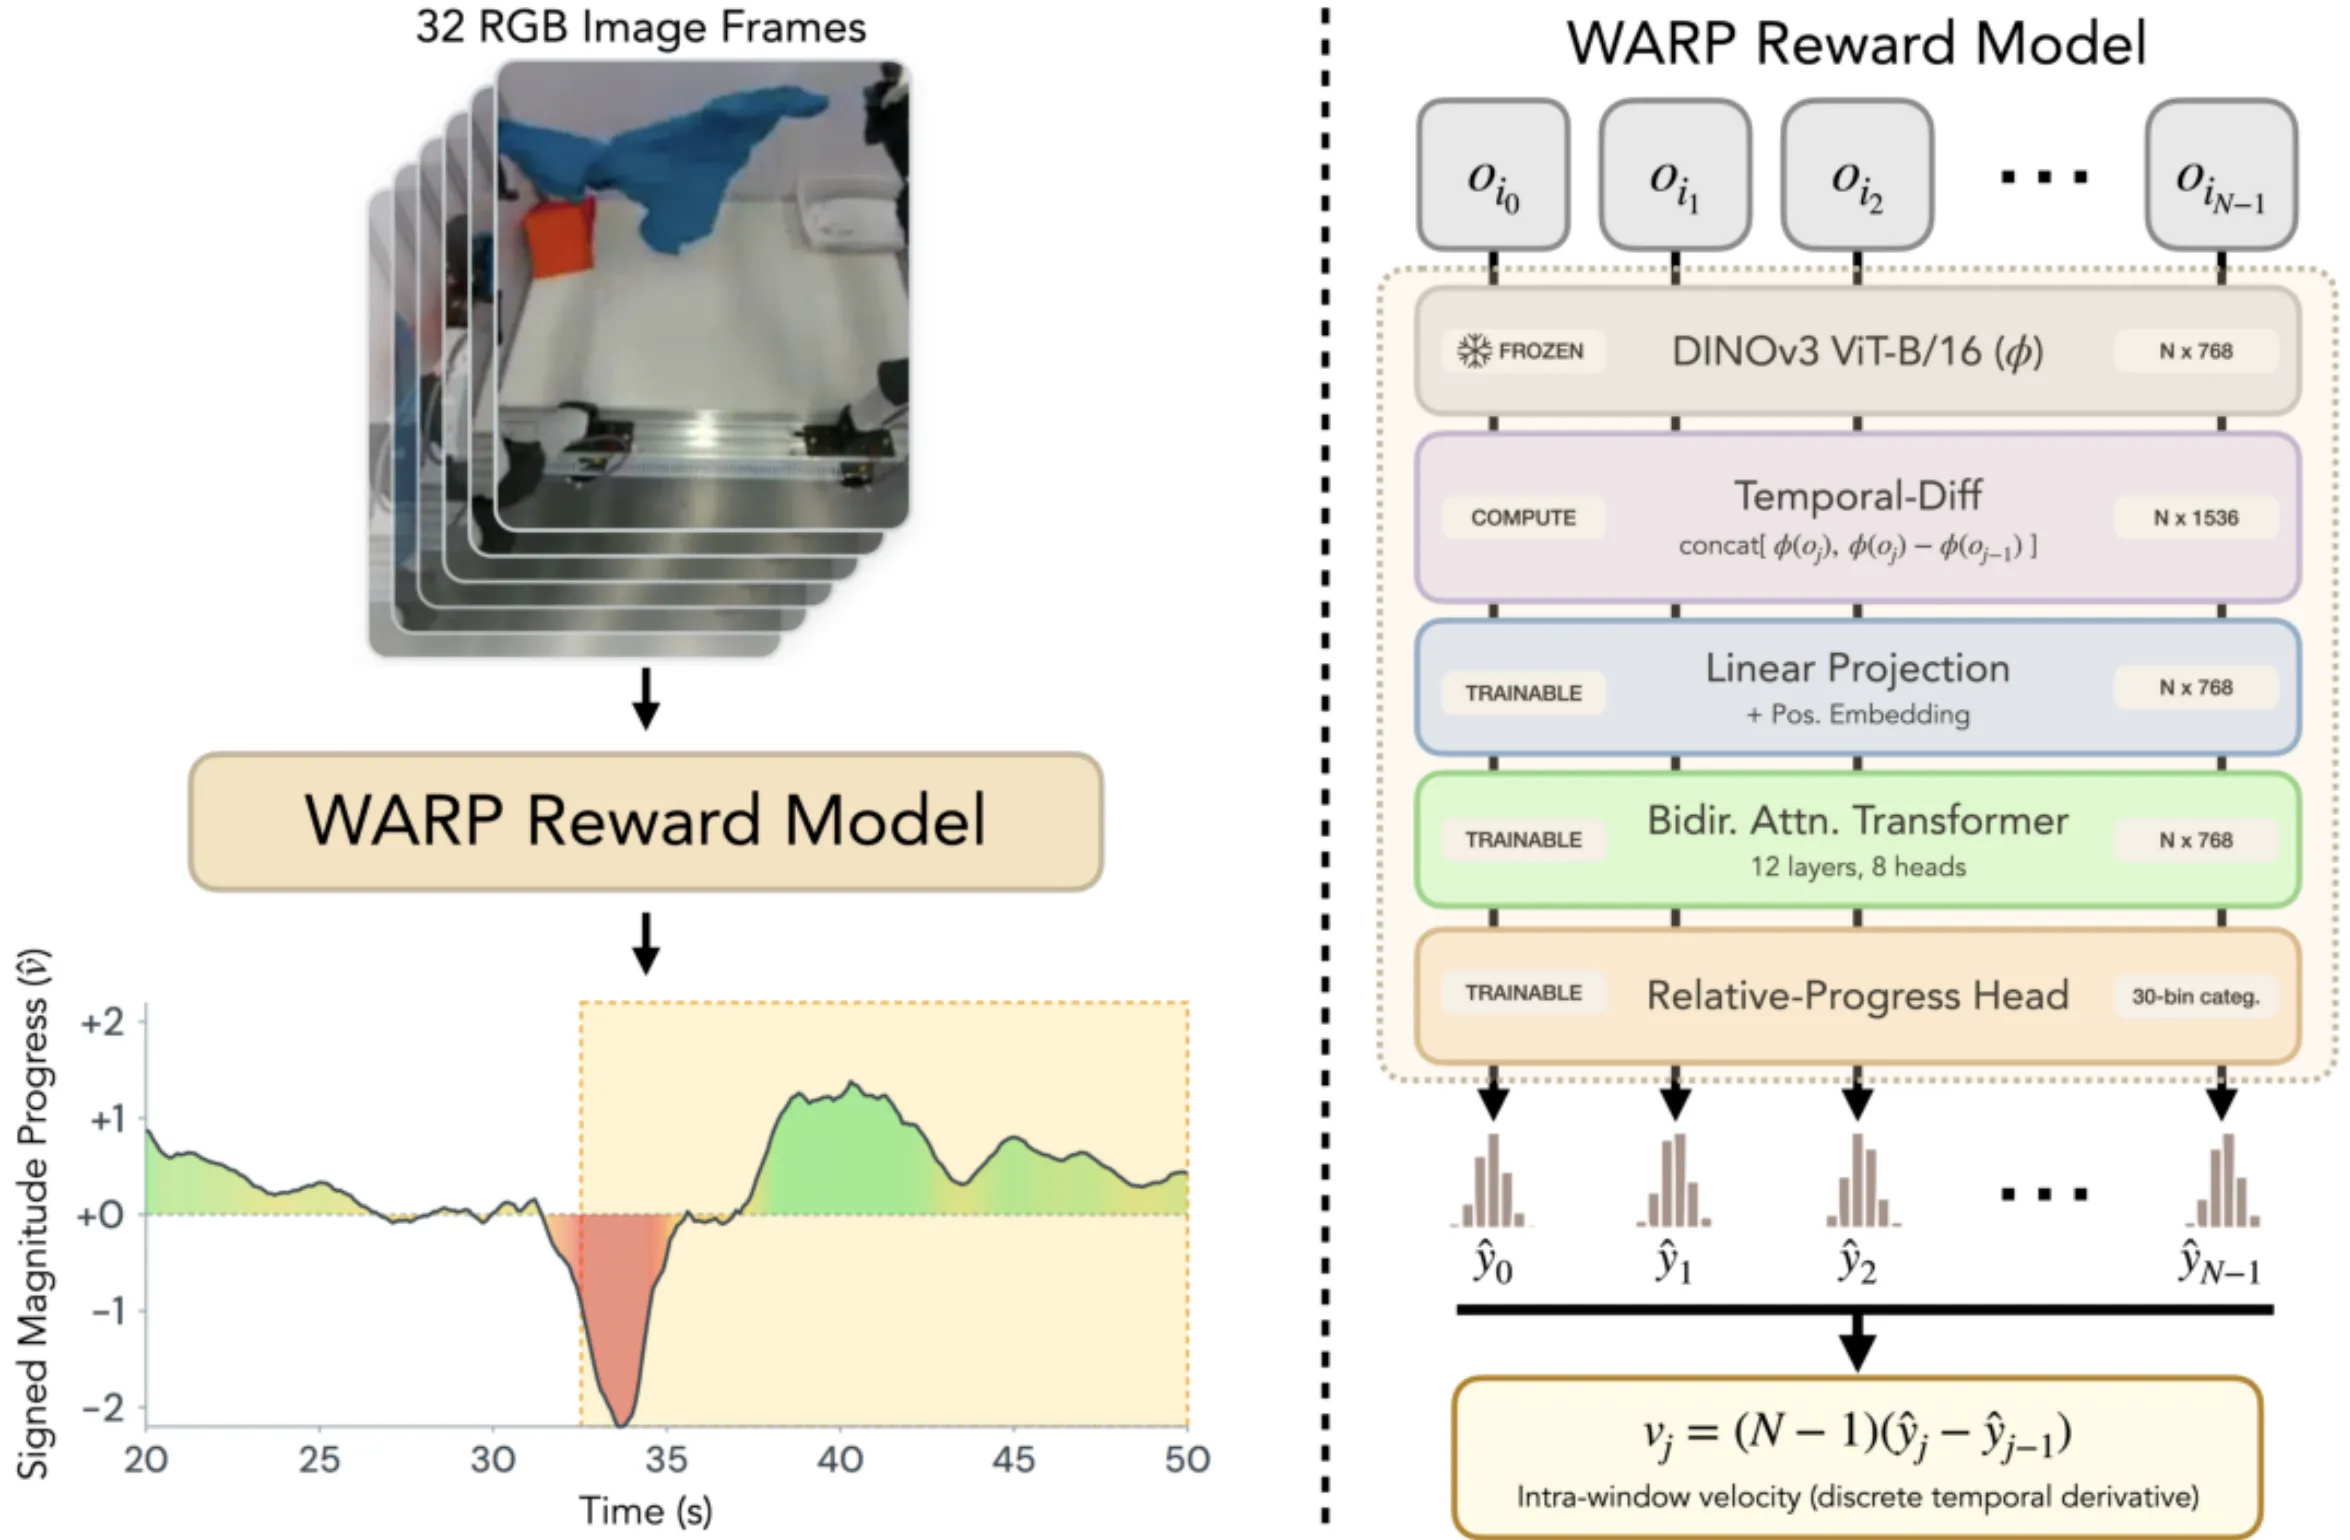
| WARP-RM | 使用不同采样(包括倒放)数据训练相对进度的 RM,并且对于训练数据进行加权训练 |
分层规划 / Sub Goal#
在 VLA 发展的过程中,曾经的一段时间,为了让一个模型可以端到端完成长程任务,我们在整个模型训练过程中引入了 subtask 预测的目标。如 PI 05 等一系列模型其实也延续了这一设计,并在后训练过程中引入了这些内容。尽管随着当前大模型发展越来越迅速,我们开始更加相信一个健全的 agentic VLA 框架能够解决一切问题,而非将所有的 planning 以及 reasoning 连同动作输出都交给单个 VLA 模型去进行处理。然而在此处,我们依然给出对于以往分层规划以及 subgoal 预测相关研究进展的概括。
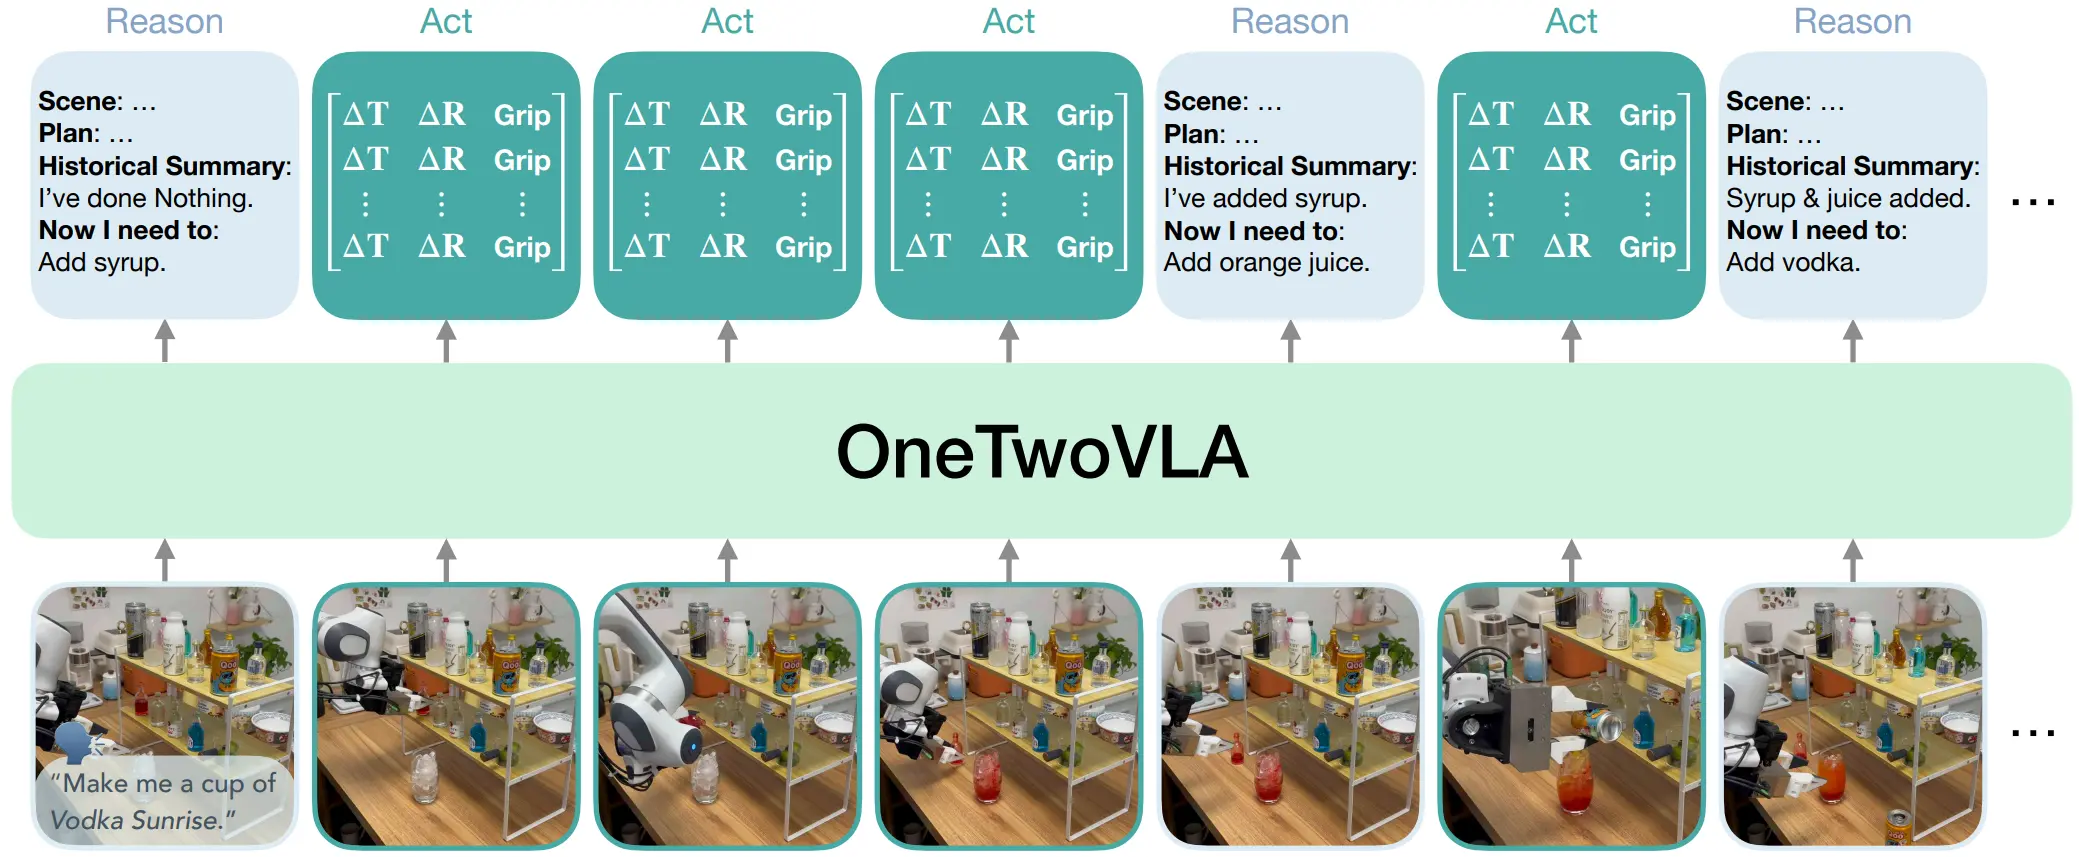
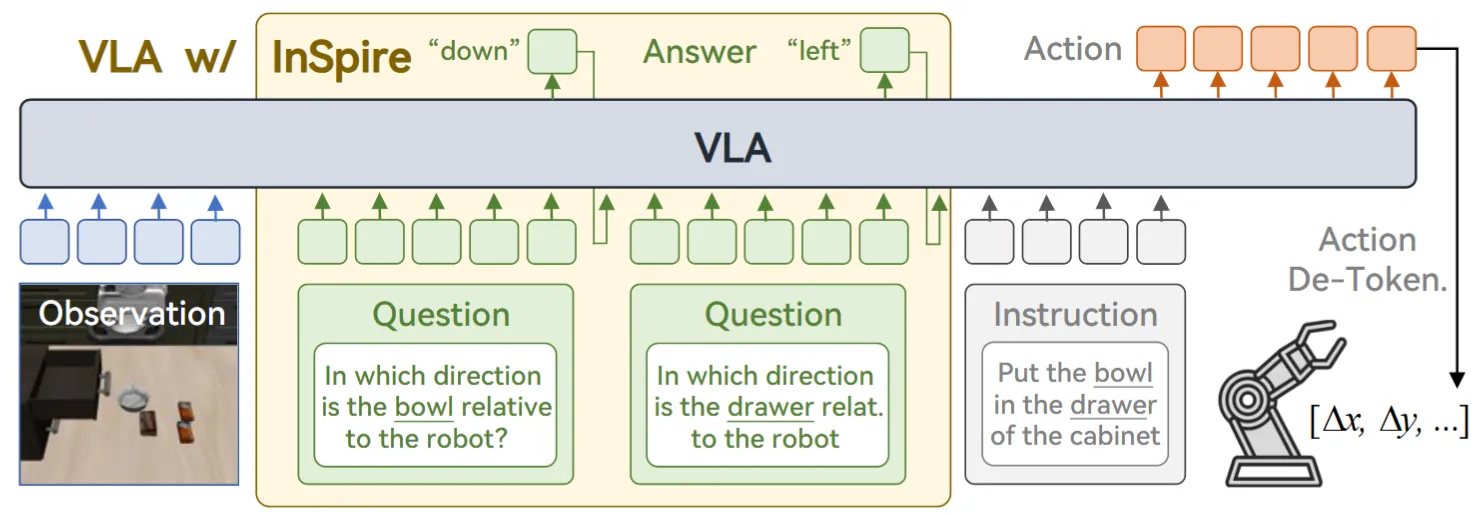
早期方法如 ECoT,在输出动作之前先让模型写出 plan 以及 subtask,是一种早期较为行之有效且比较直接的解法;另外一种方案则是让模型学习一种 Interleave 的模式,自由在 Reasoning 与 Action 之间切换:
| 论文 | 主要贡献 |
|---|---|
| CoT-VLA | 先预测 Future Obs 作为 CoT |
| OneTwoVLA | 使用 Token(BOR & BOA)在 Reason 以及 Action 之间切换 |
| Vista-WM | WM 预测 Future 作为 System2 输入给 system1 |
| Inspire | 在模型进行输出 Action 之前增加了几个问题,即相关物体相较于机器人的方位作为 CoT |
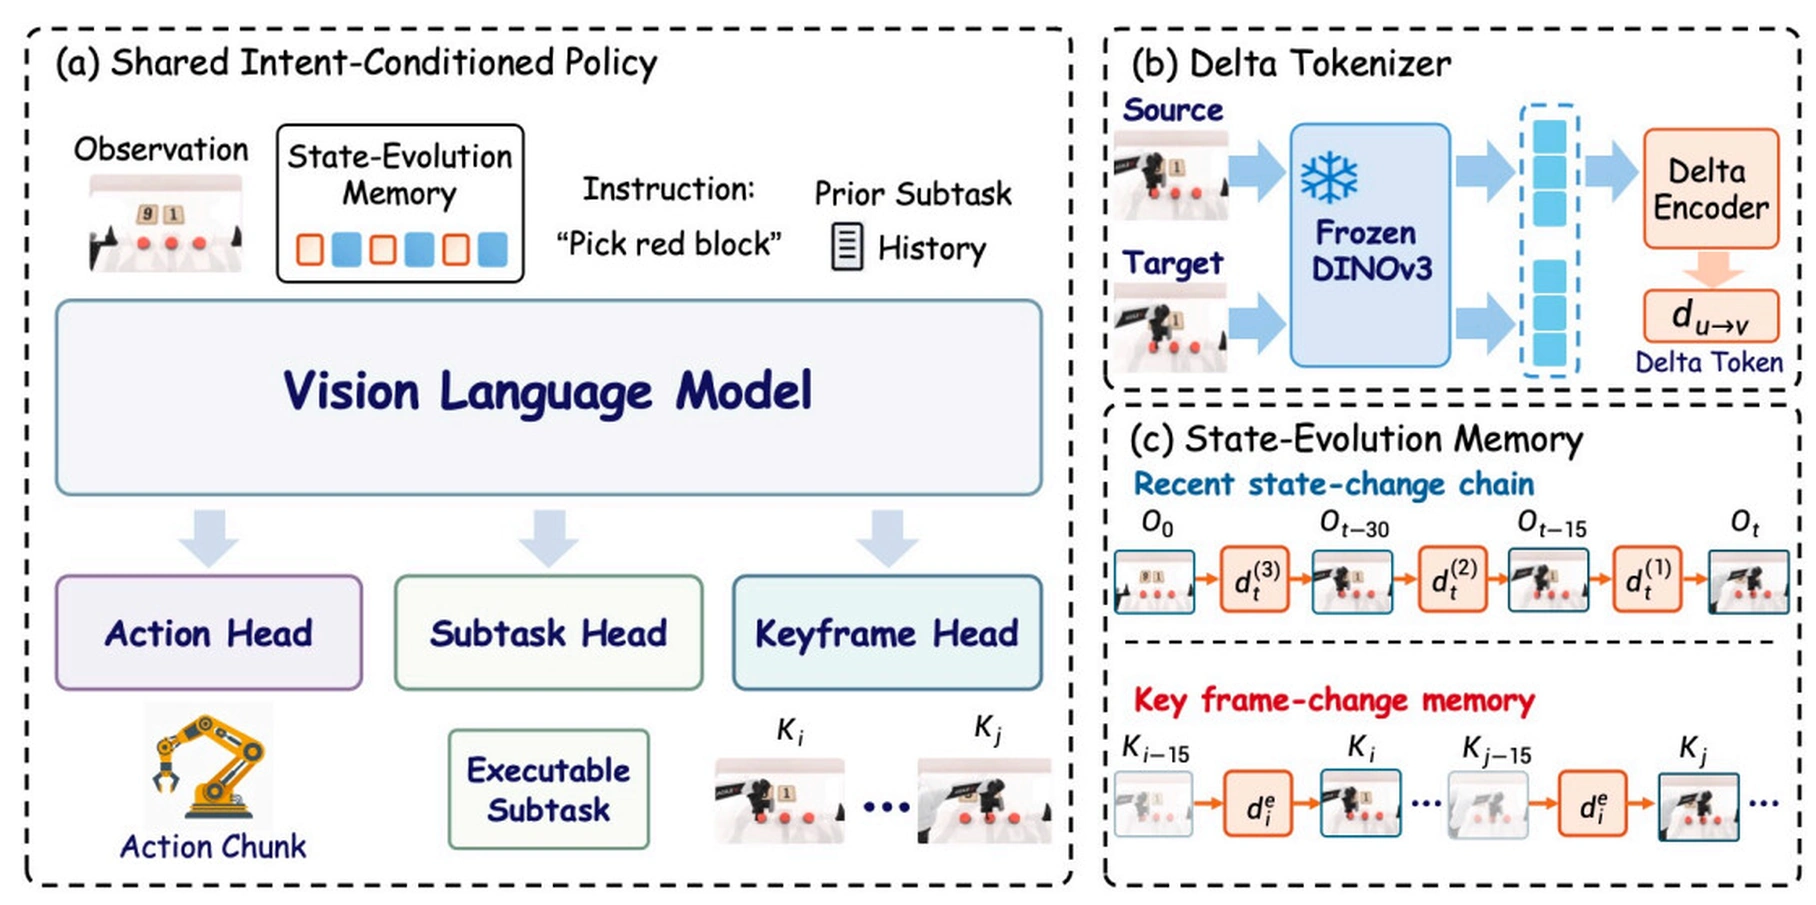
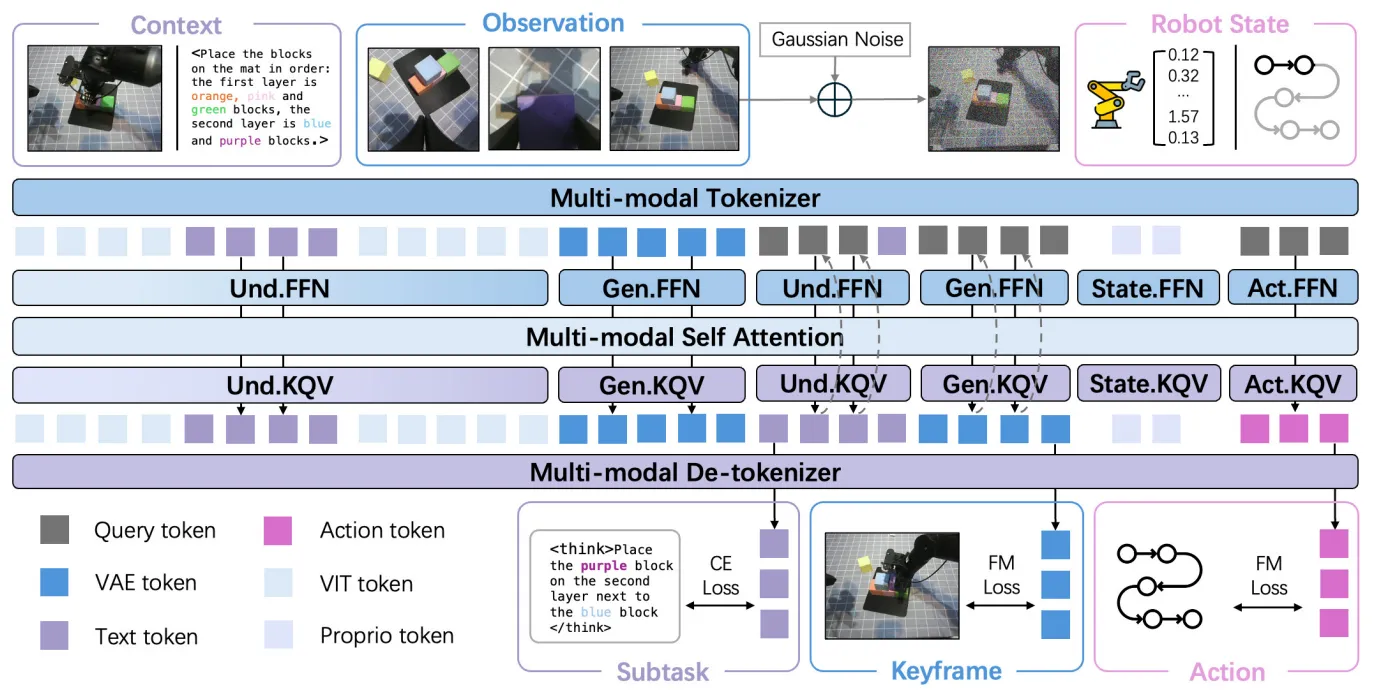
| EvoMem-VLA | DINO 差分 Token + 状态演化链与关键帧记忆,同时预测 Action、Subtask 和 Keyframe。 |

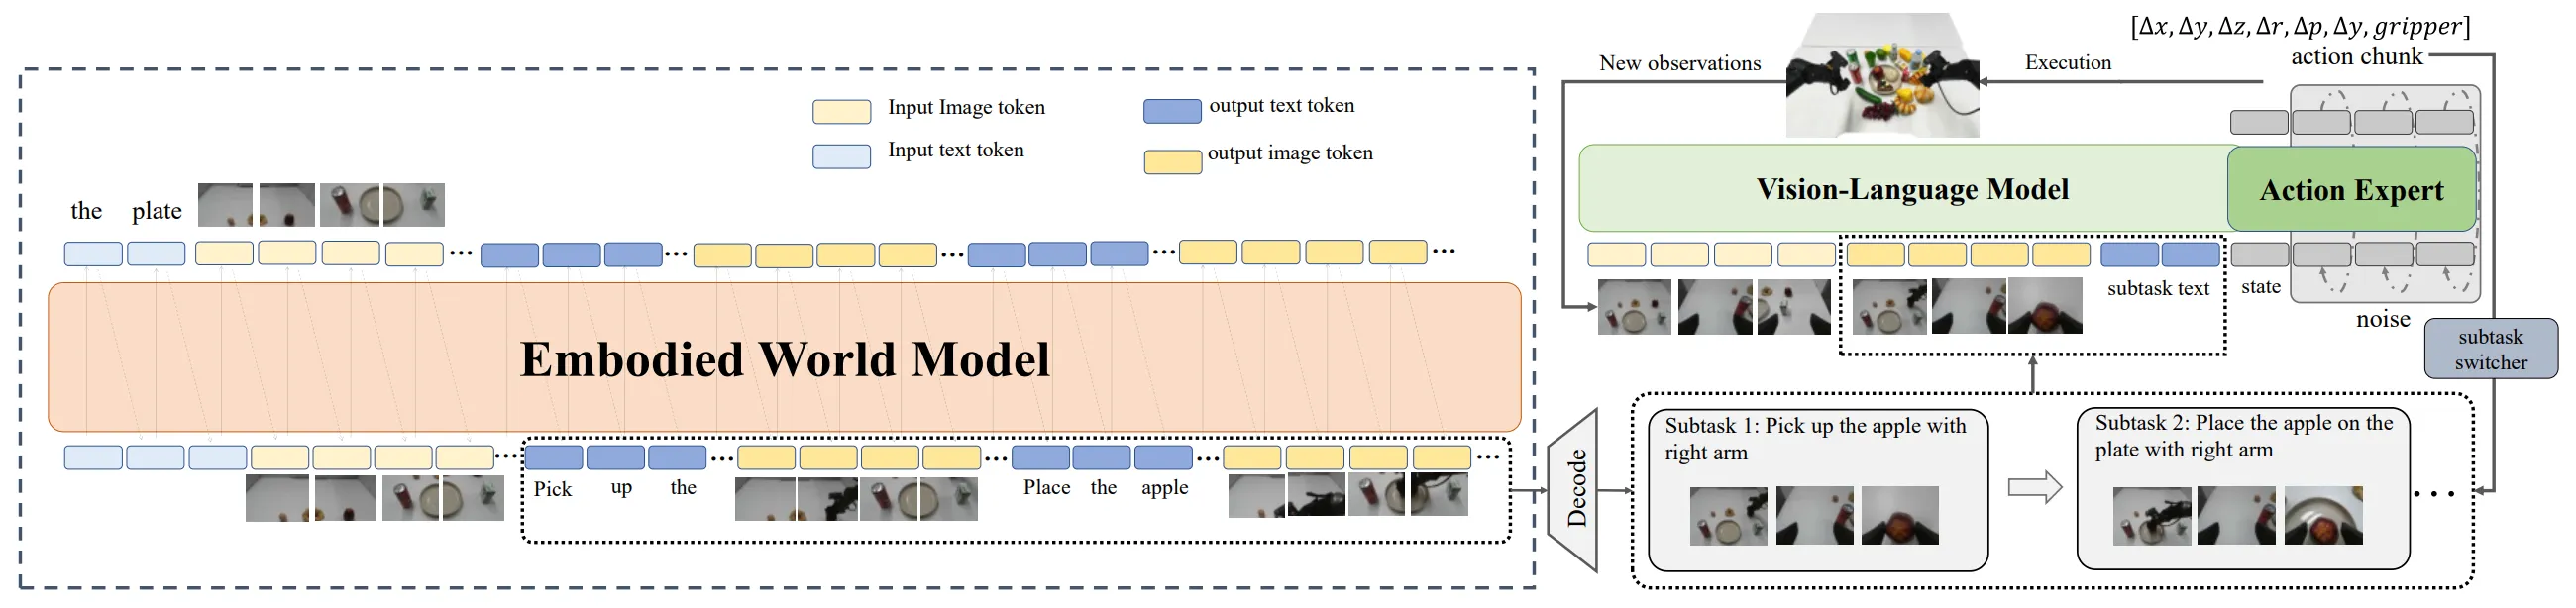
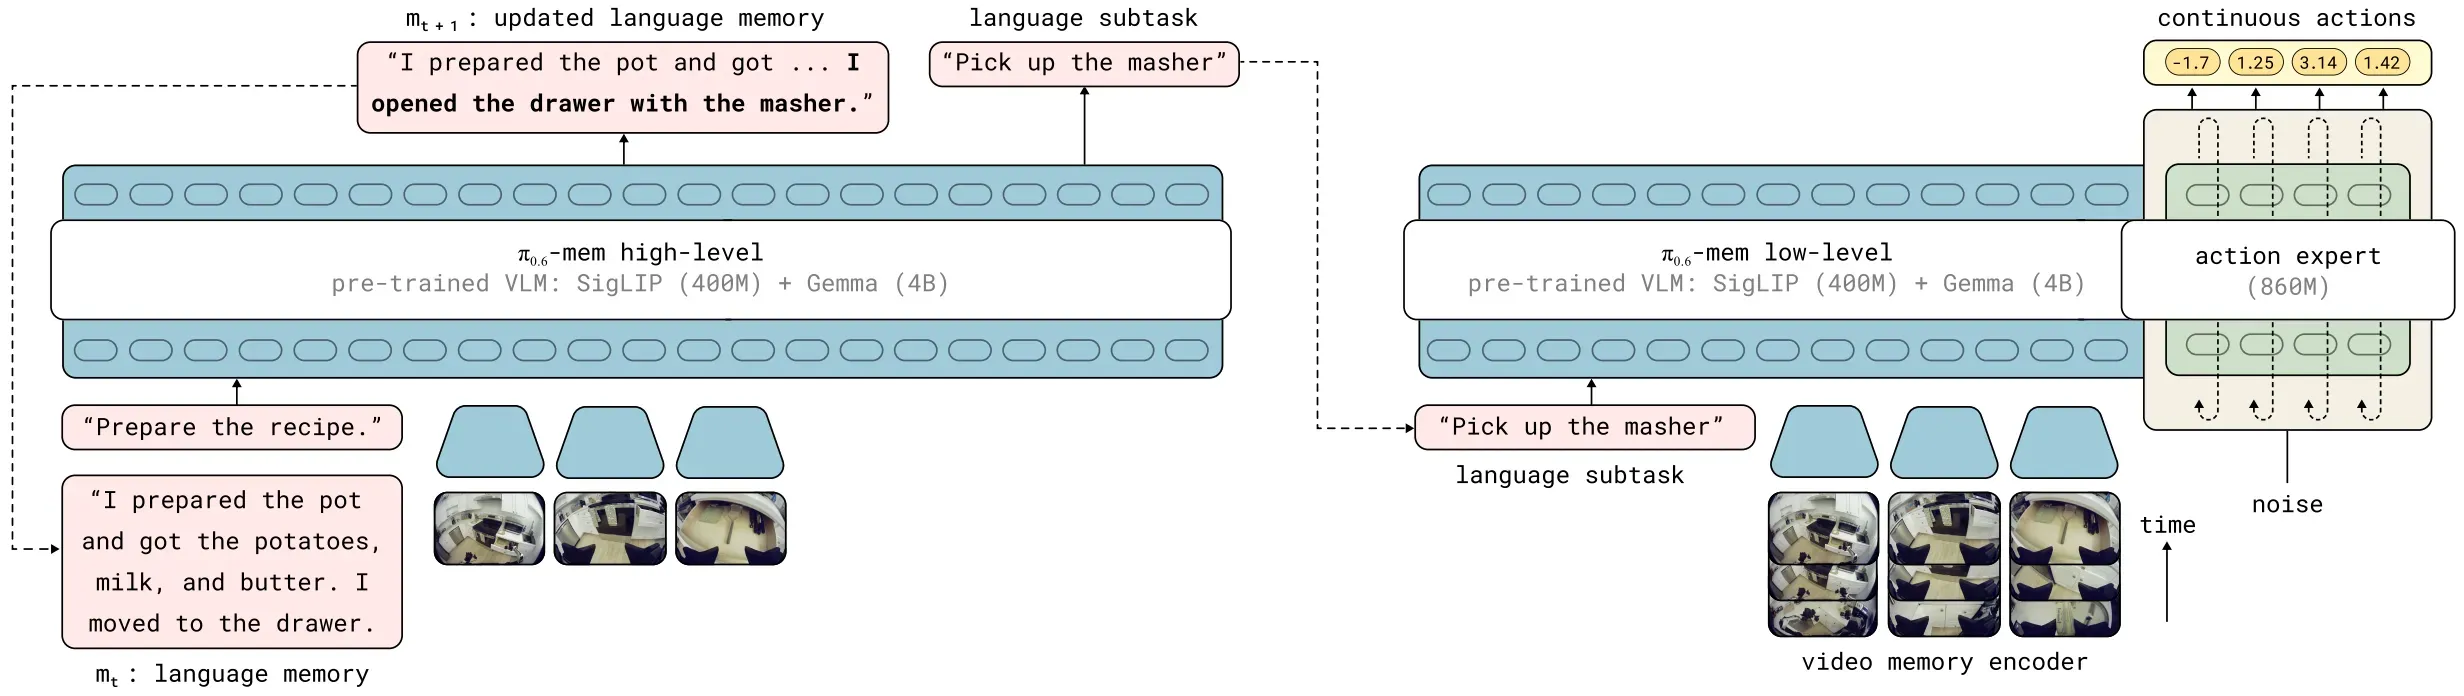
同时,在一段时间的发展之后,业界开始搭建一些更加复杂的双系统结构,来让模型具有记忆能力并且可以完成长时序的任务。这里一个经典且简单的实现来自 MEM,直接使用 VLM 来做长时序总结,并且使用 Video 输入 System1 Policy,来达到短时序能力。当然现在来看,长时序如果只靠单系统的 System1 都不太本质,还是需要一些 Agentic design 以及双系统,由上游来承载这些能力。
| 论文 | 主要贡献 |
|---|---|
| EvoMem-VLA | DINO 差分 Token + 状态演化链与关键帧记忆,同时预测 Action、Subtask 和 Keyframe。 |
WM-VLA / WAM#
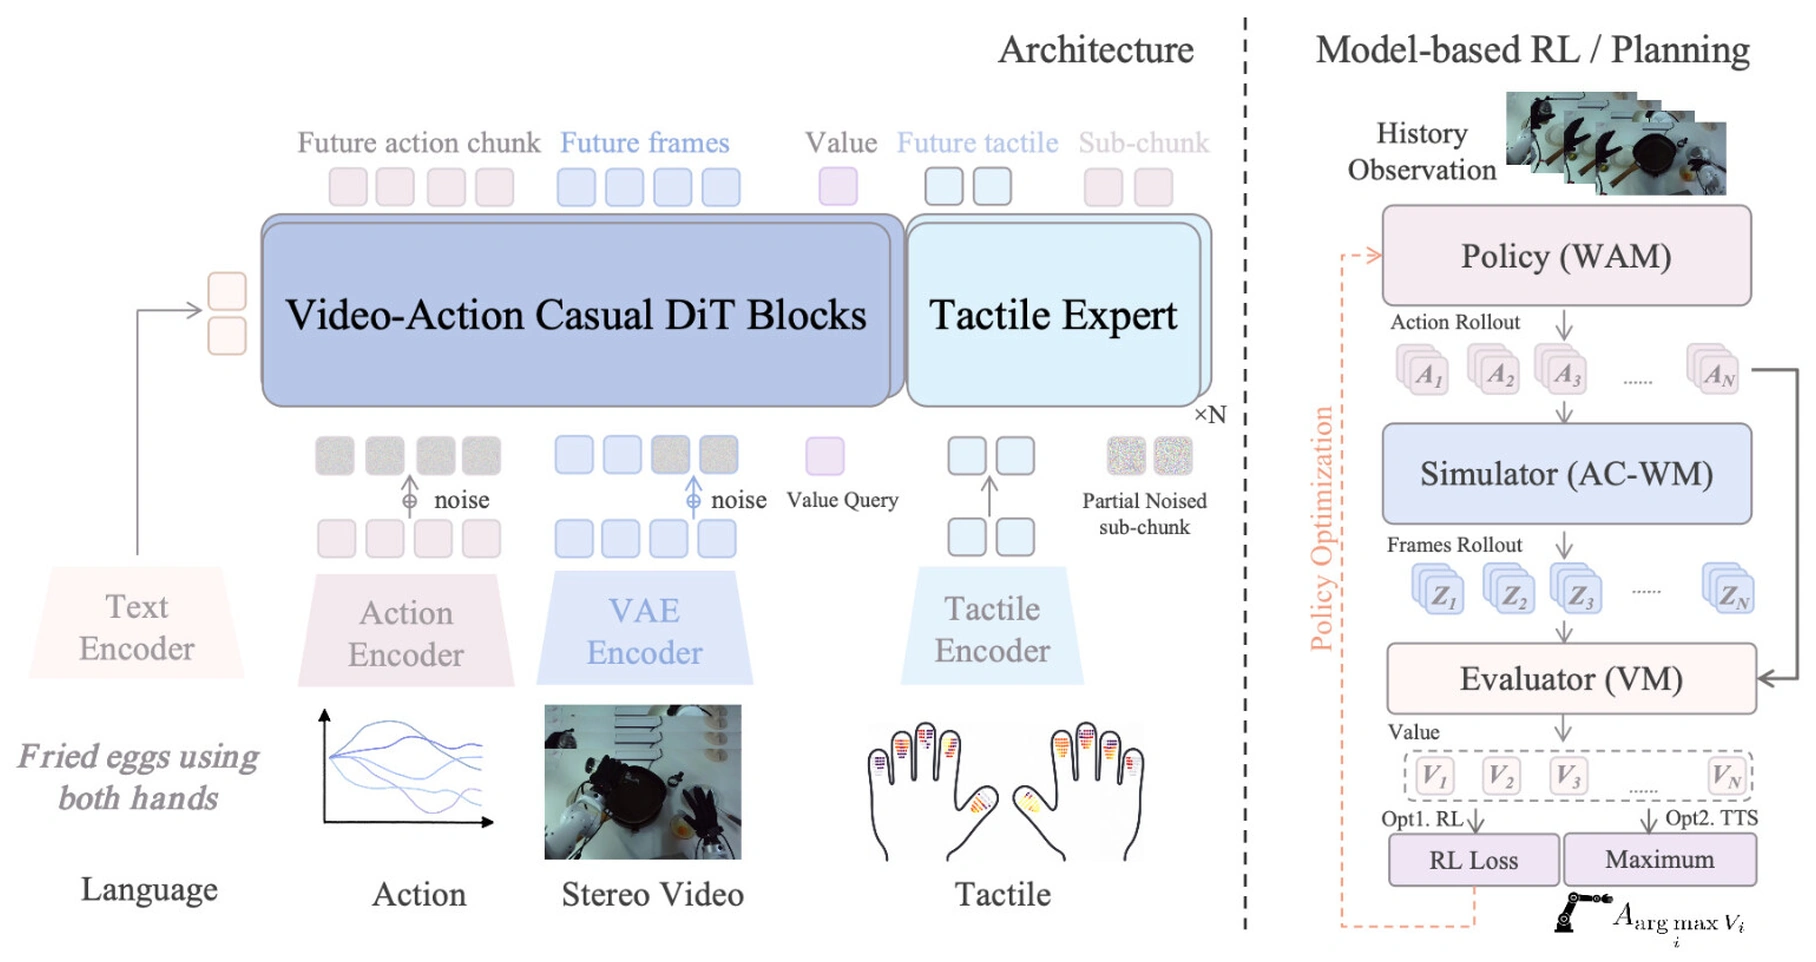
在 VLA 进行长久发展,学界以及业界开始探索另一发展路线,即基于除 LLM/VLM 这一框架之外另一可以 scaling 大量数据并且进行一定程度预训练的预训练模型,即 Video Generation Model,或 VGM,在这一语境下,我们称之为 World Model(事实上在领域中 WM 具有广泛的定义,VGM 是其中一种,但是还有很多其他类型的模型也或多或少称自己为 WM,在这里我们特指 VGM 或者 Action condition VGM 两种)。在这里,另一种常见的称呼是 WAM,即 World Action Model。我们对于 WAM 的介绍会不仅限于那些基于 VGM 的模型,而是对于以预测未来作为模型训练目标的模型的统称。
WAM 范式#
比较早的 WAM 如 GR-1,先进行视频生成的预训练,再同时预测未来帧以及动作;之后的 VPP 则直接使用视频扩散模型预测的表征作为动作头的 Condition。
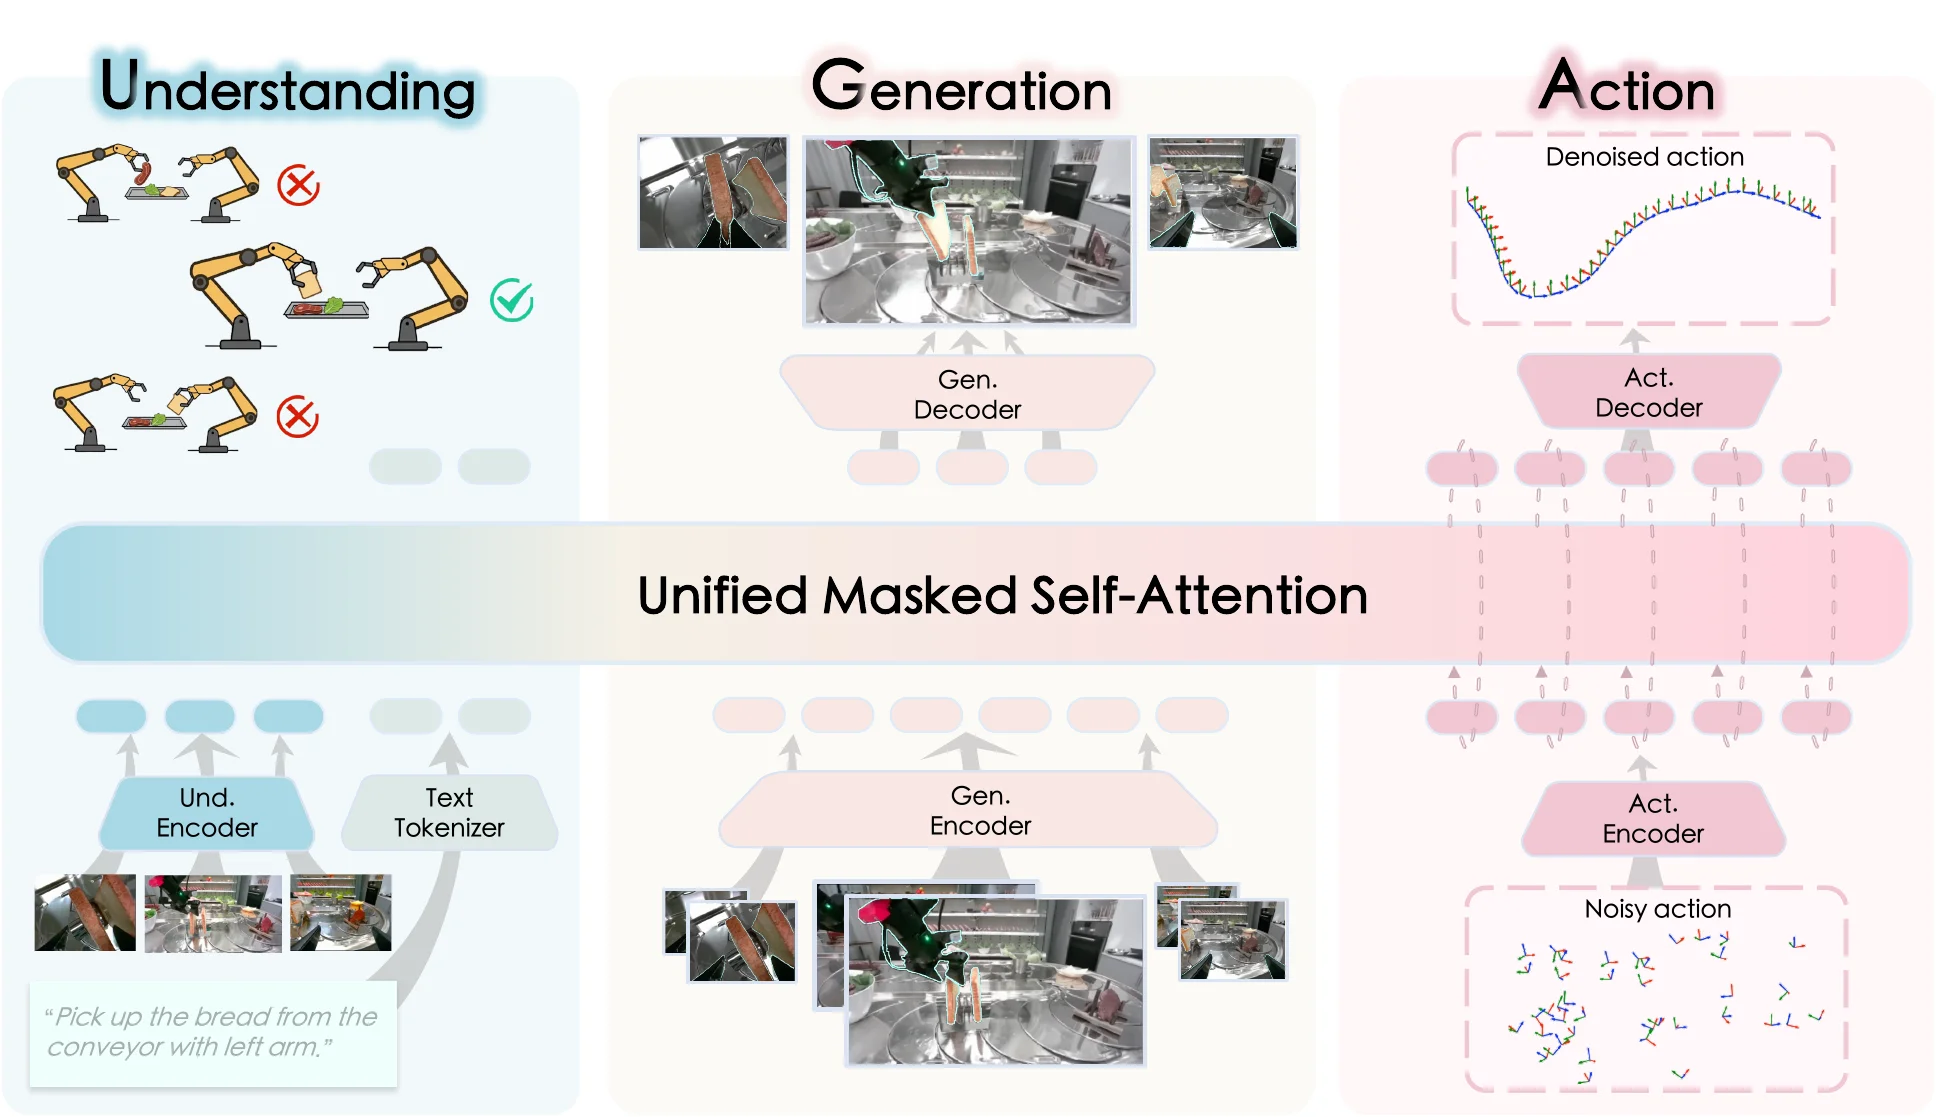
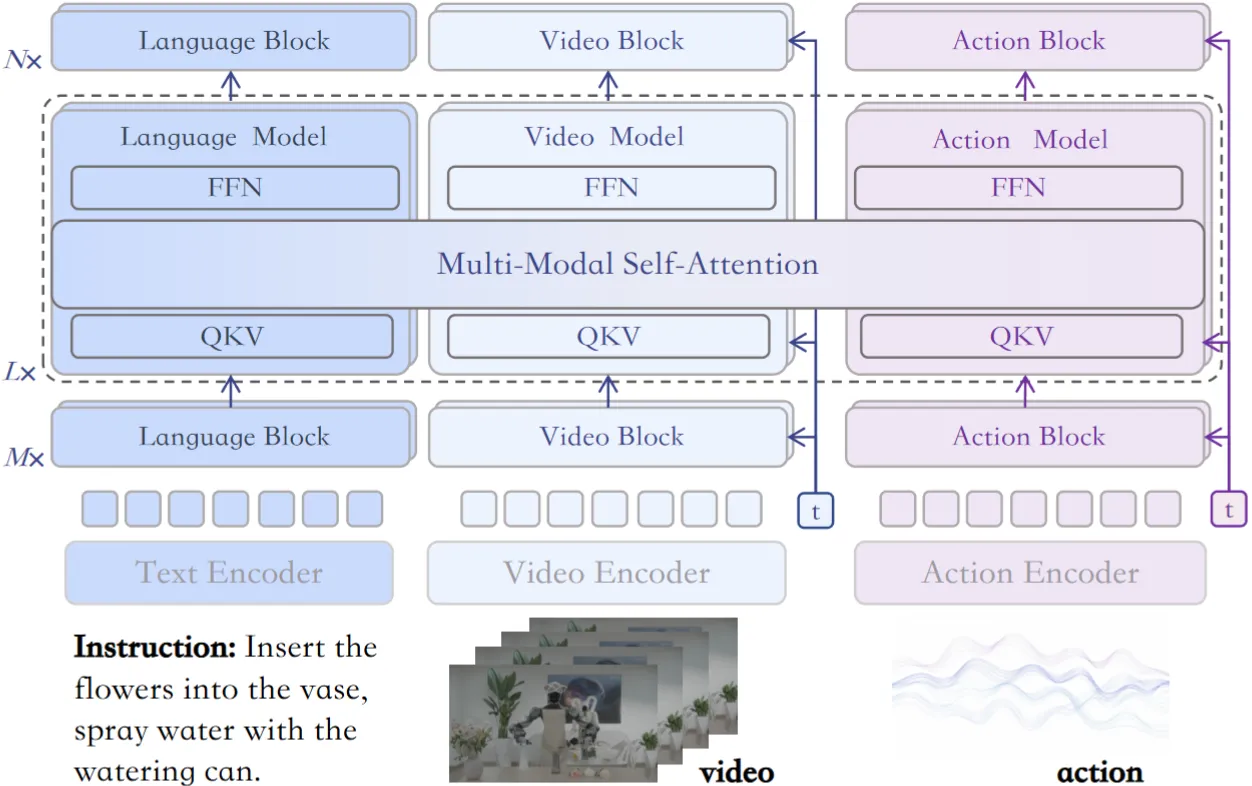
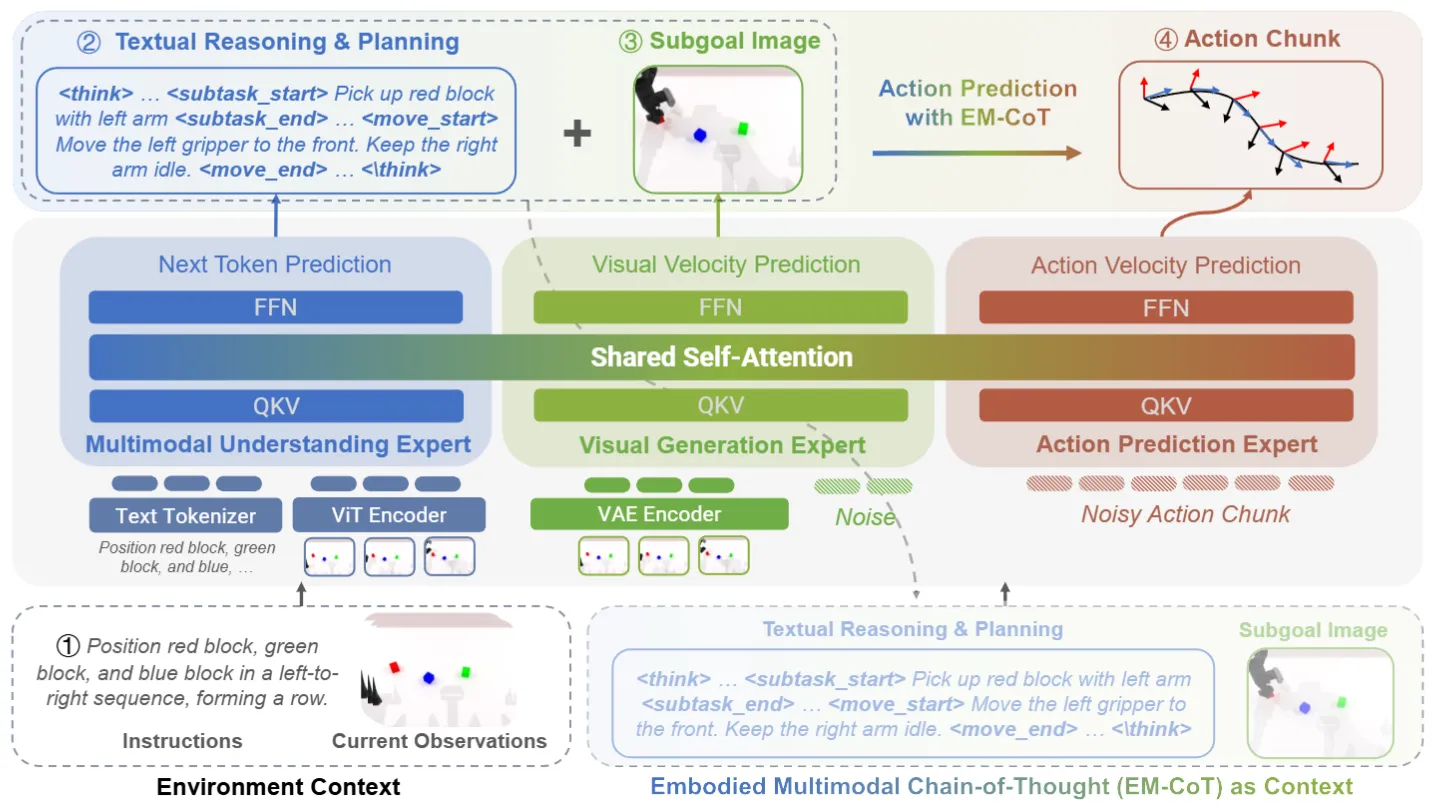
在此之后出现了一些基于 World Model 的 VLA 模型,一种方案是追求完全的 Unified 能力,桥接 VLM / WM / Actor,一般直接通过 MoT 进行连接,如比较经典的 Motus,结构很纯粹,并且比较 work。这些设计一方面希望 Leverage 各种模型的先验知识,另一方面也可以尽可能更多地利用更多的数据。
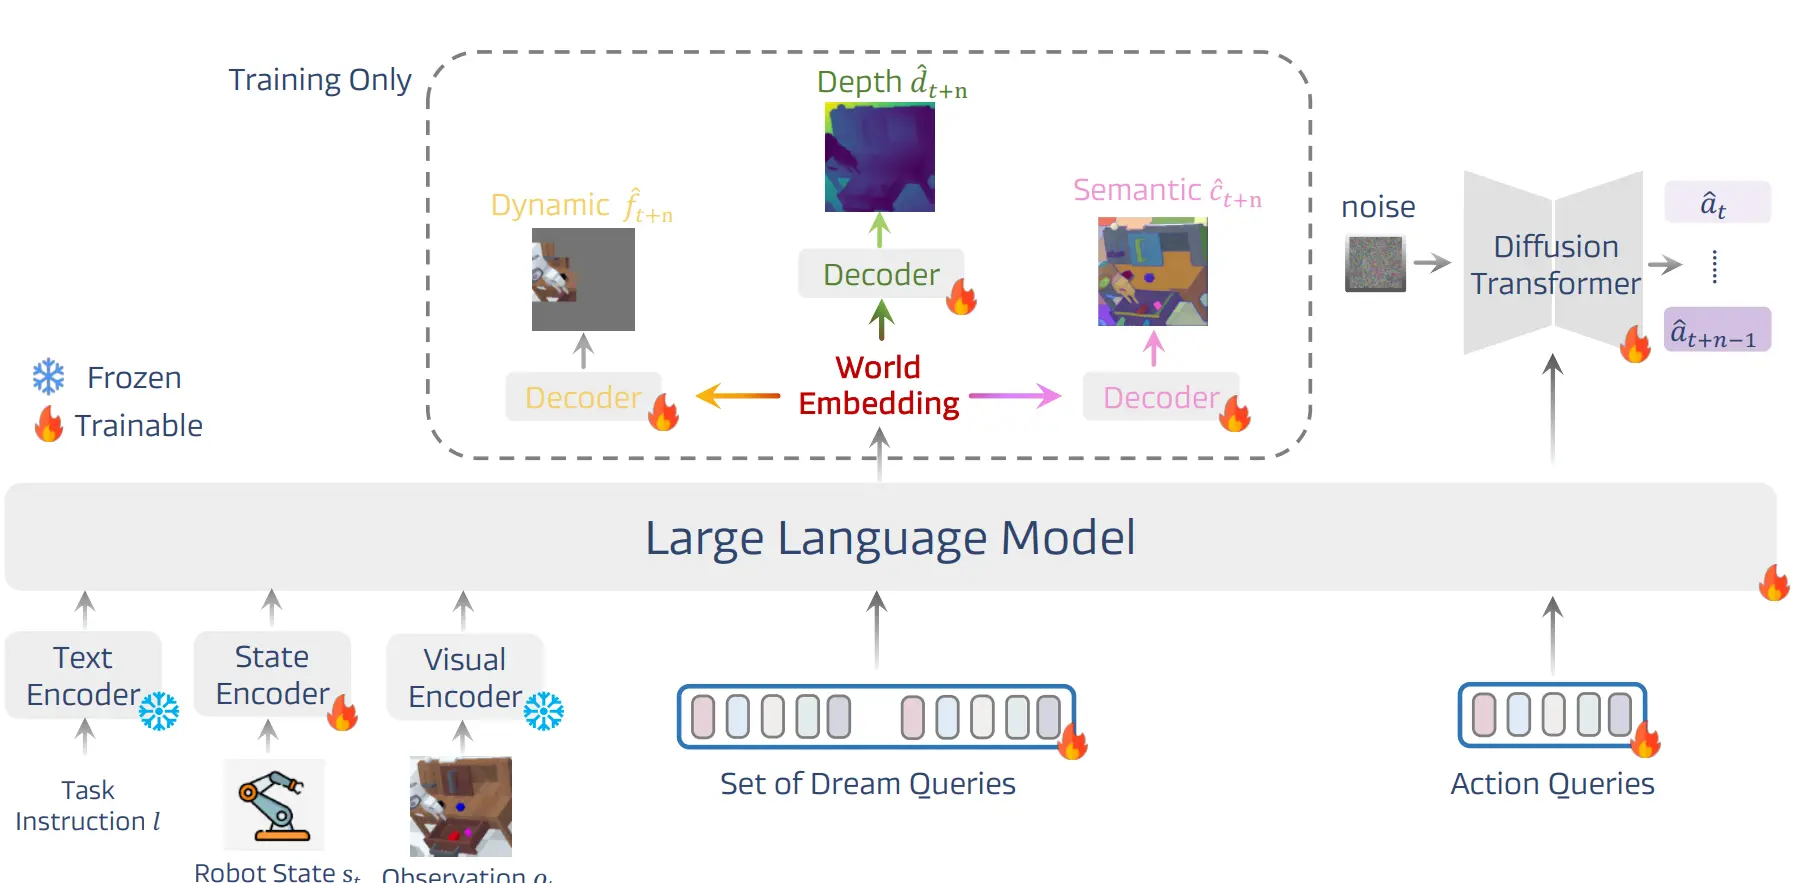
另外一些工作则直接基于 VGM,如 VLM-VLA 的范式一样,在此研究 VGM 与 Actor 的交互方式。NVIDIA 在这方面的一系列探索可以说是相当可圈可点的,基于他们的视频模型 Cosmos,先后推出了直接预测全部复杂表征的 Cosmos Policy 以及在此之后进行了更多的打磨,仅预测世界表征以及 Action 的 DreamZero,可以得到号称 Zero-shot 的能力。从这两篇也可以看出,并不是无脑加入更多的监督就会更好。
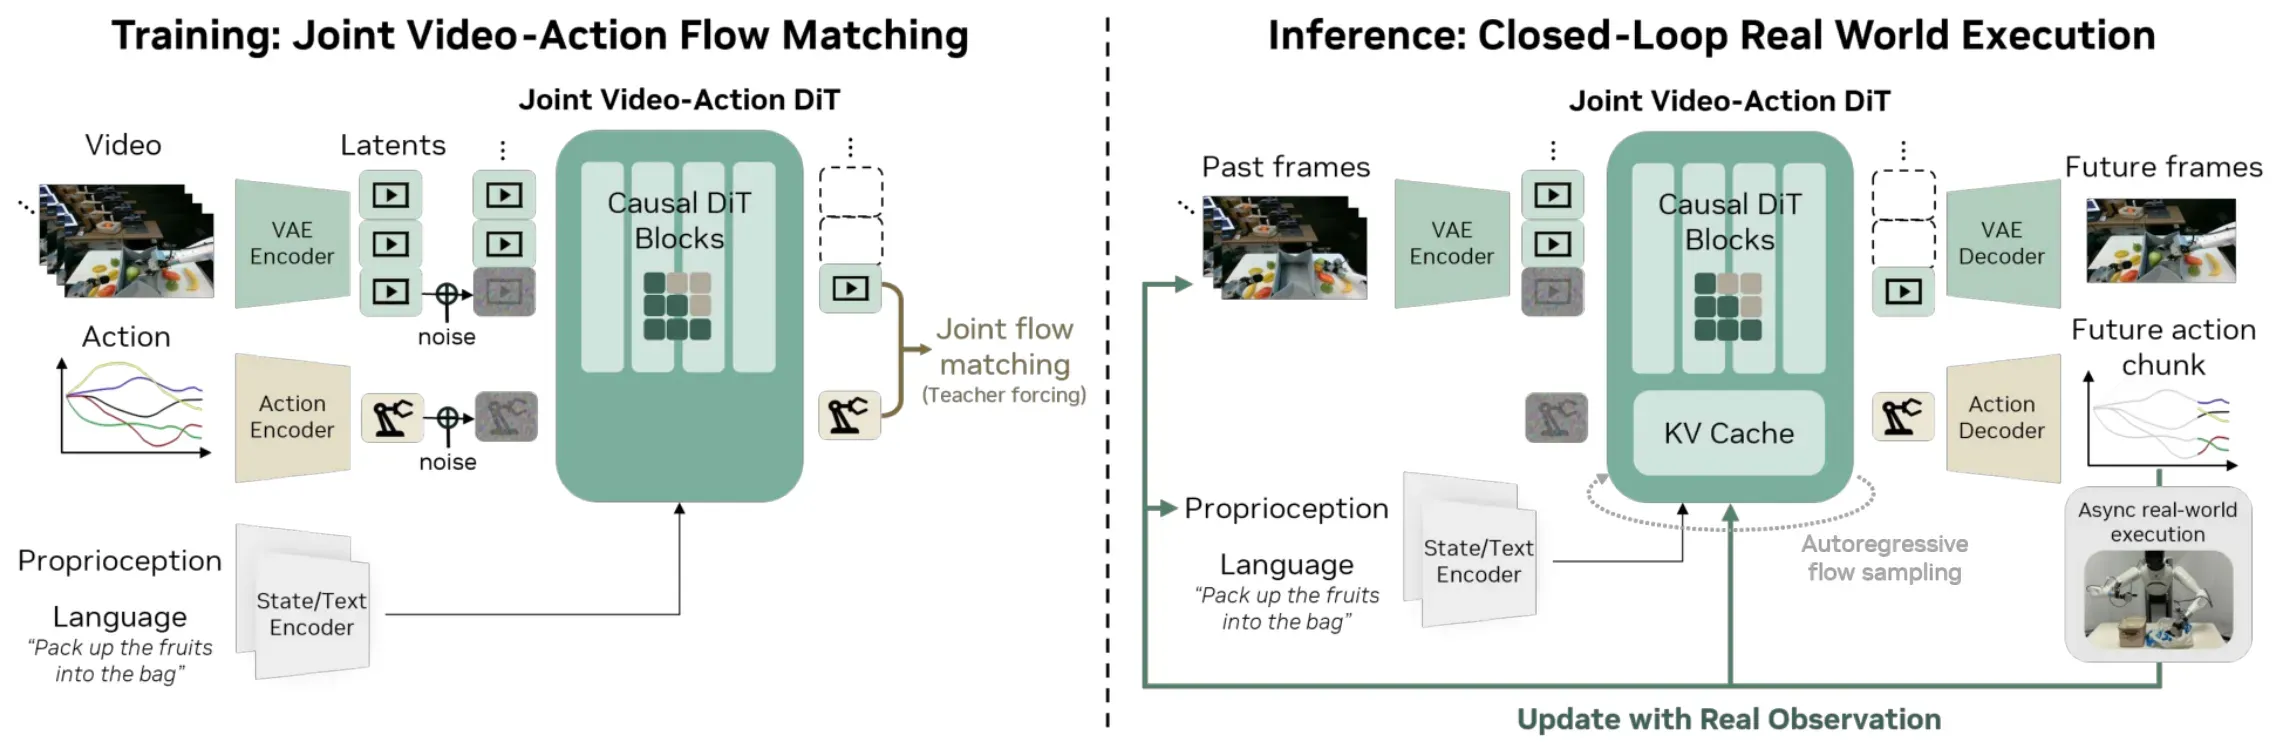
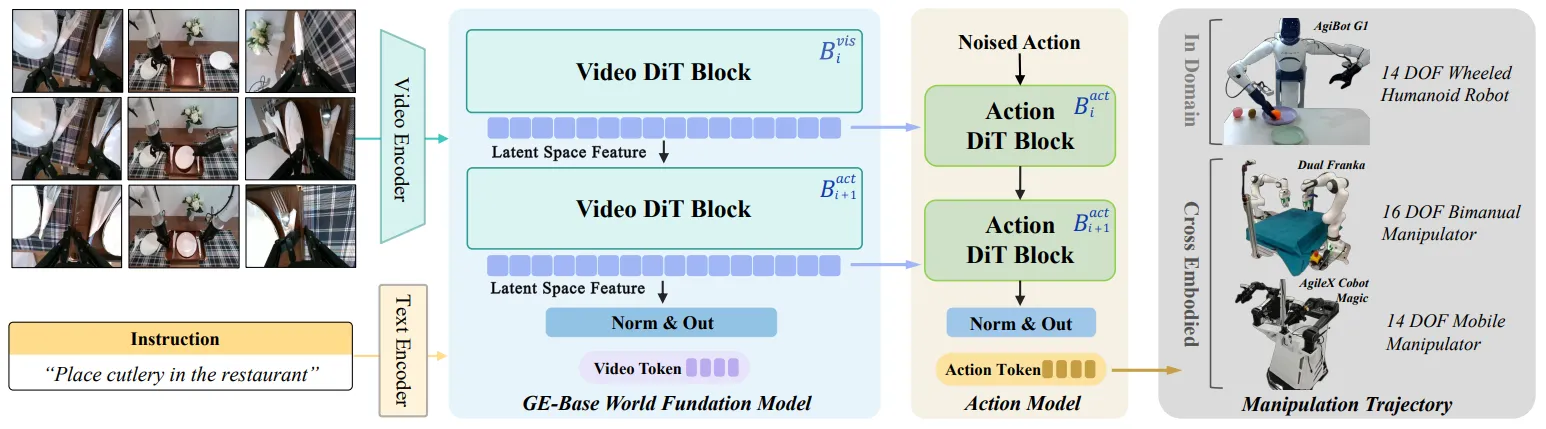
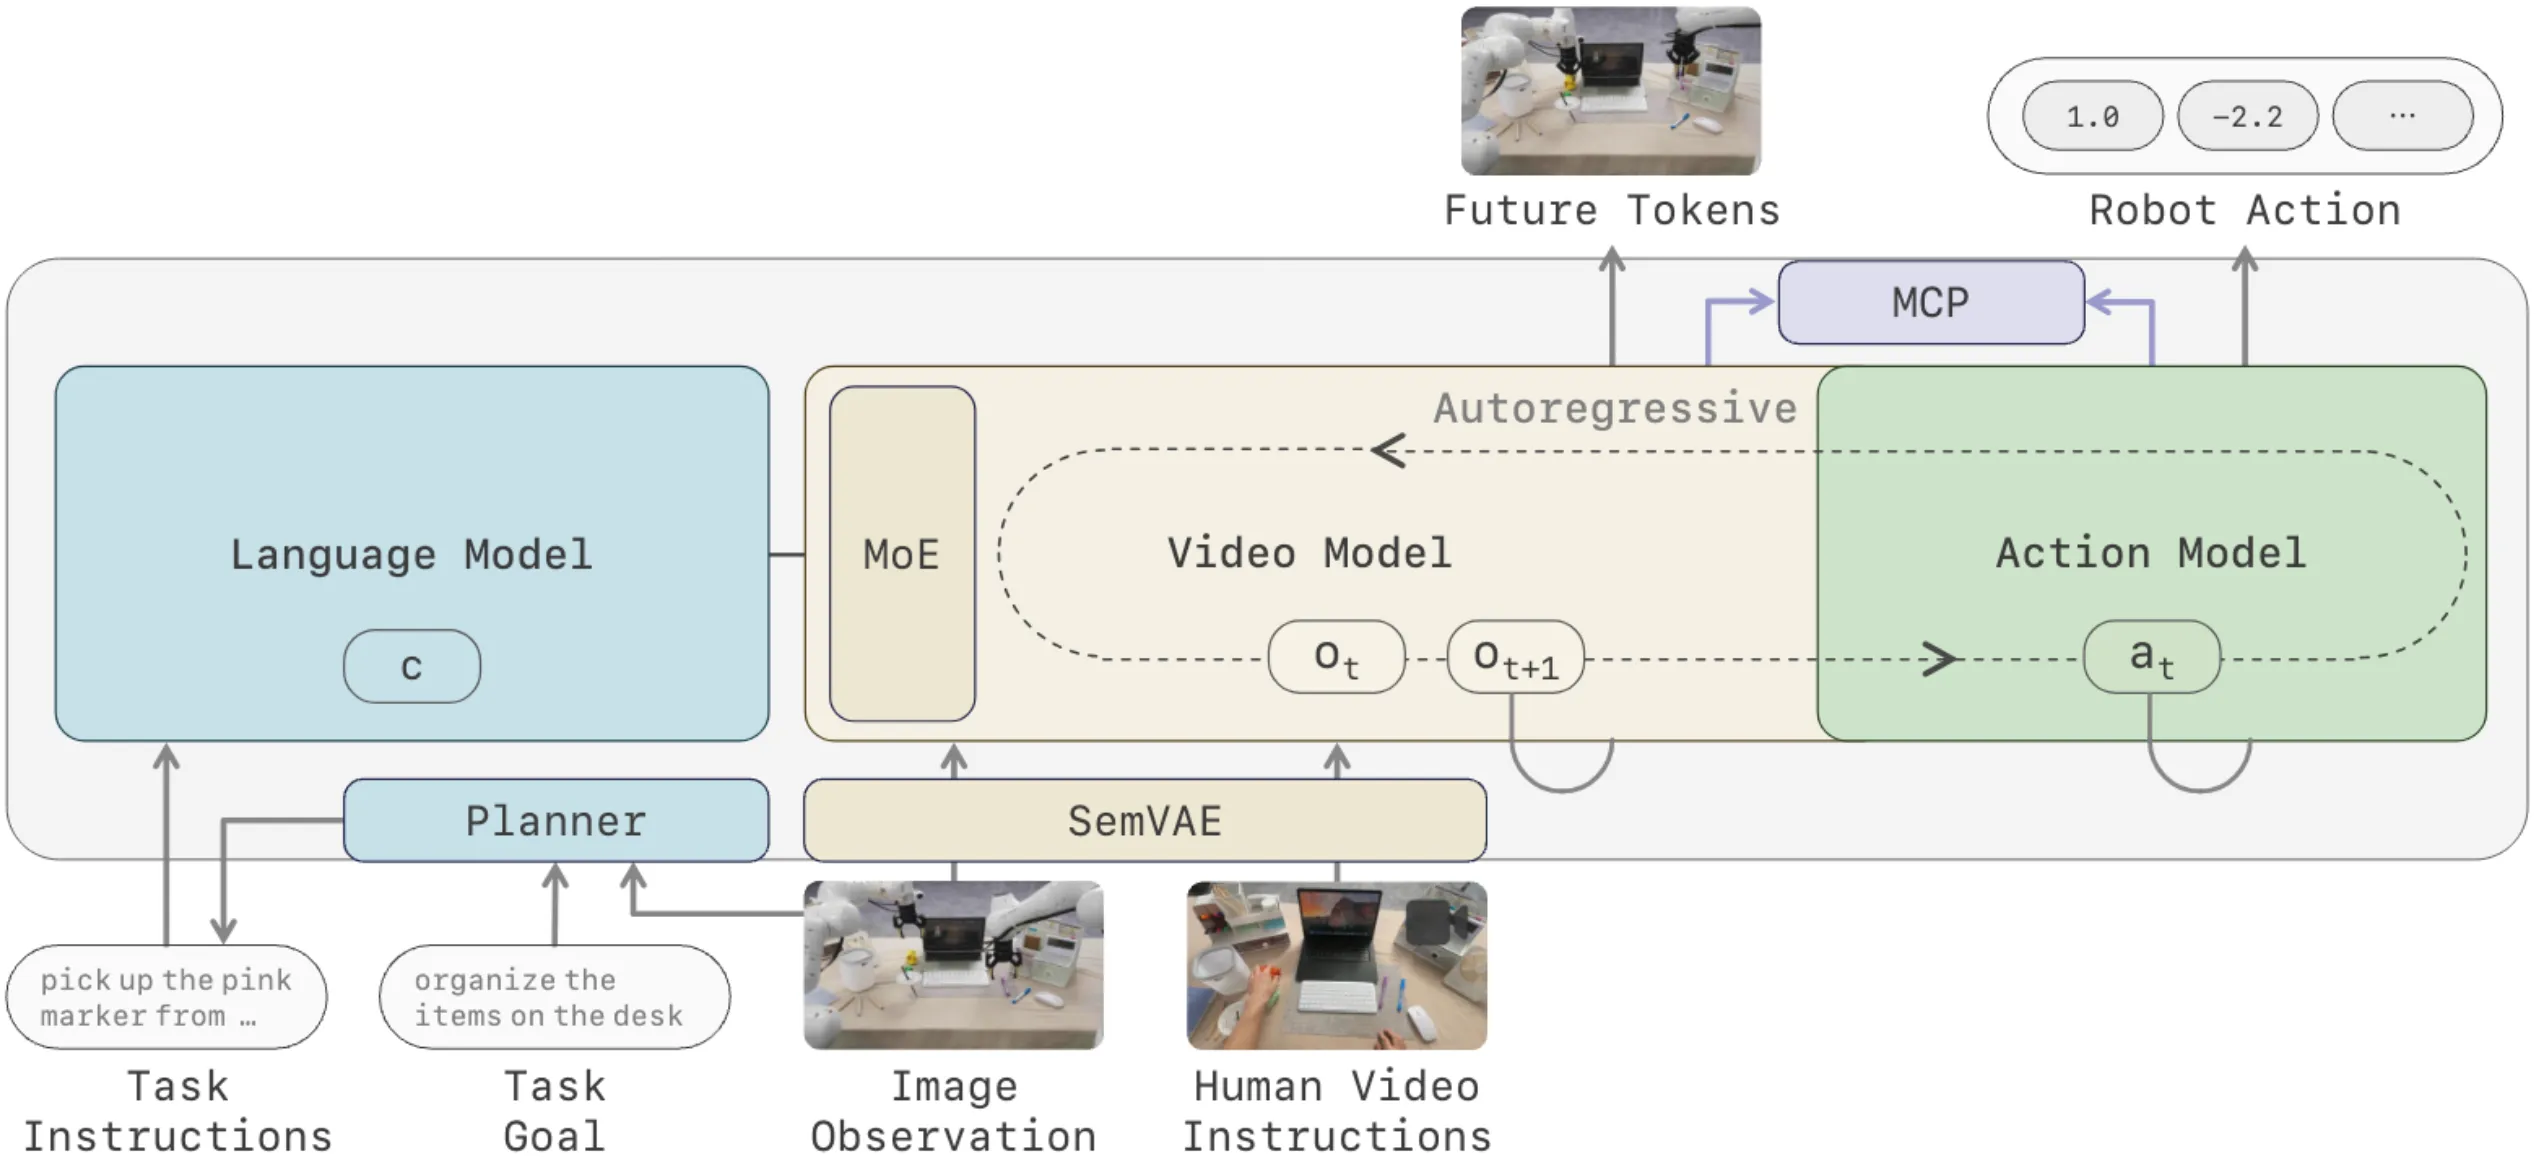
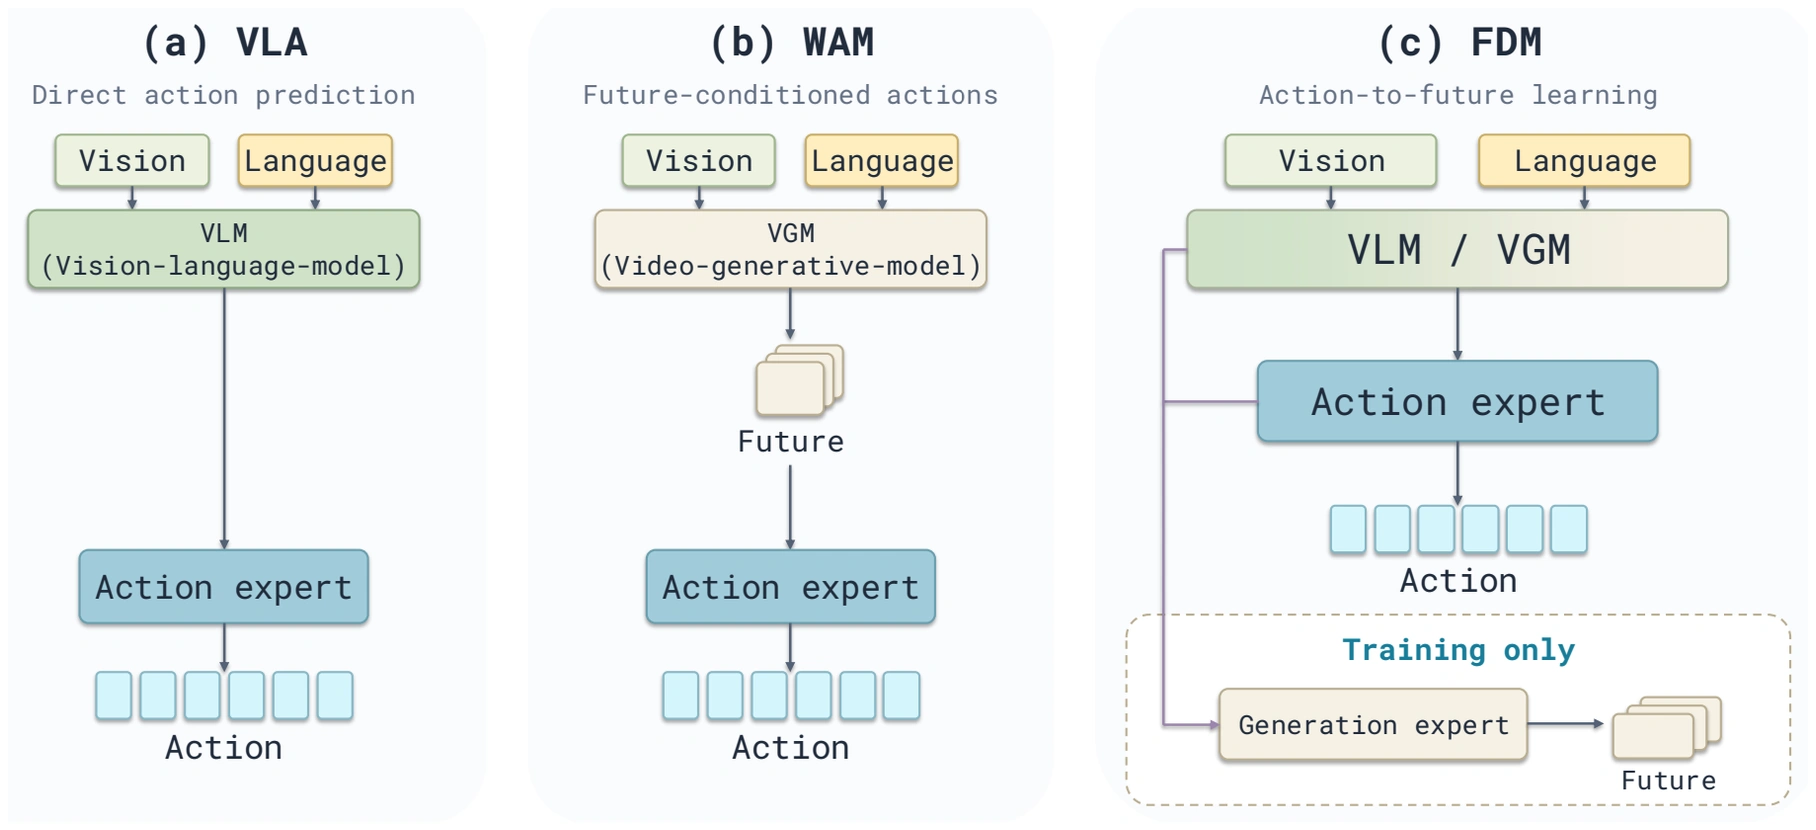
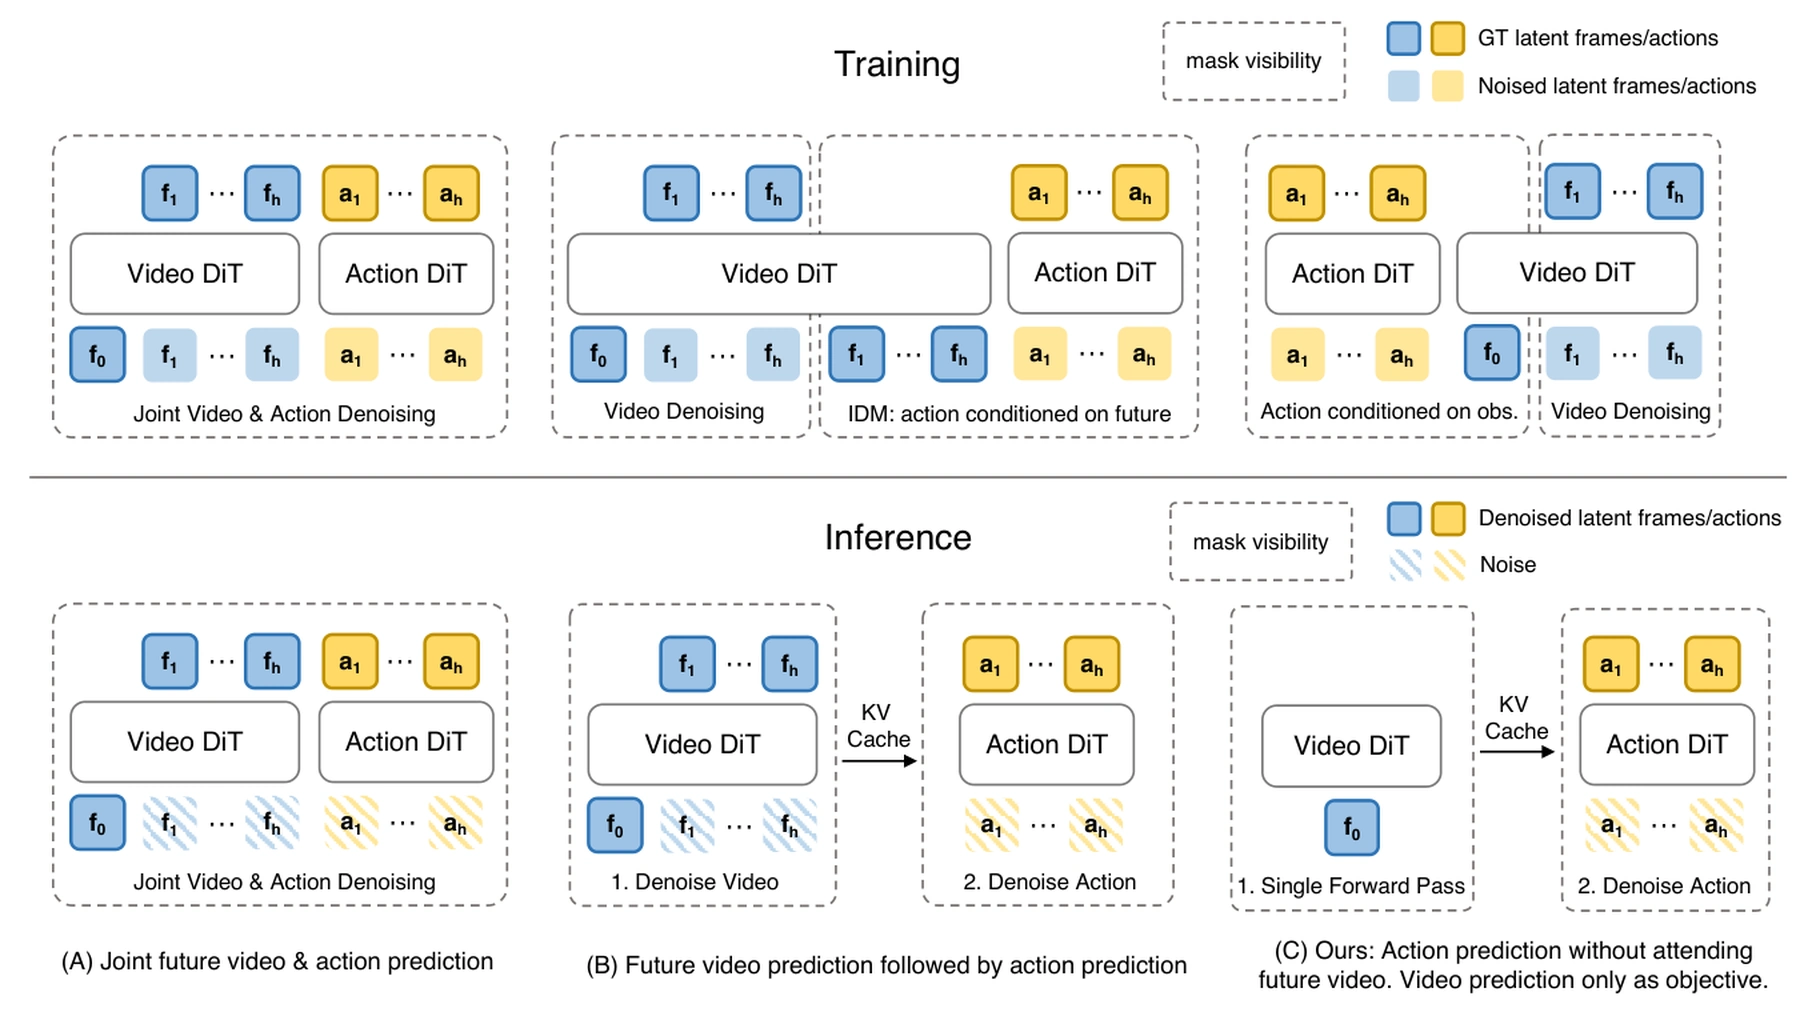
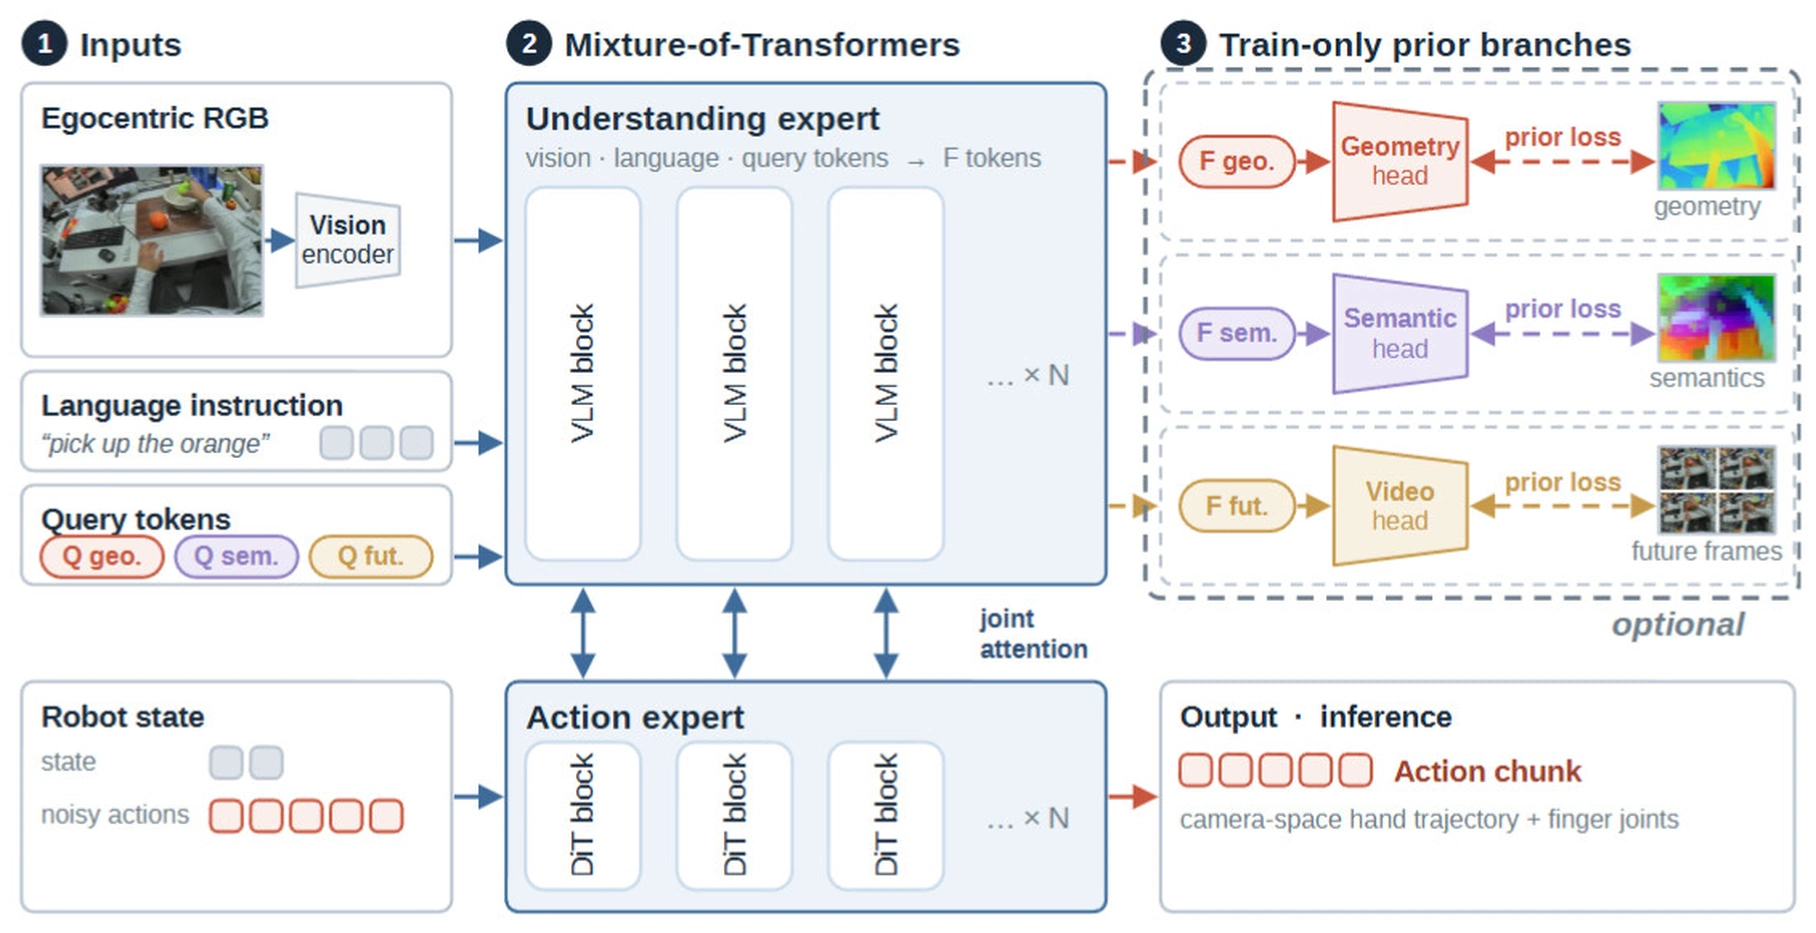
本质上 future prediction 是一个很 dense 的好监督,但是作为测试时预测 cost 太大了,所以可以拎出来,比如 Fast-WAM 保留视频 co-training,但是在推理时不再预测未来,InternVLA-A1.5 也只在训练时使用未来的监督。剩余常见的工作在这里列举部分有代表性的:
| 论文 | 主要贡献 |
|---|---|
| Genie Envisioner | 训练 DiT Base 具身 VGM 基模,DiT Latent 作为 Actor DiT condition |
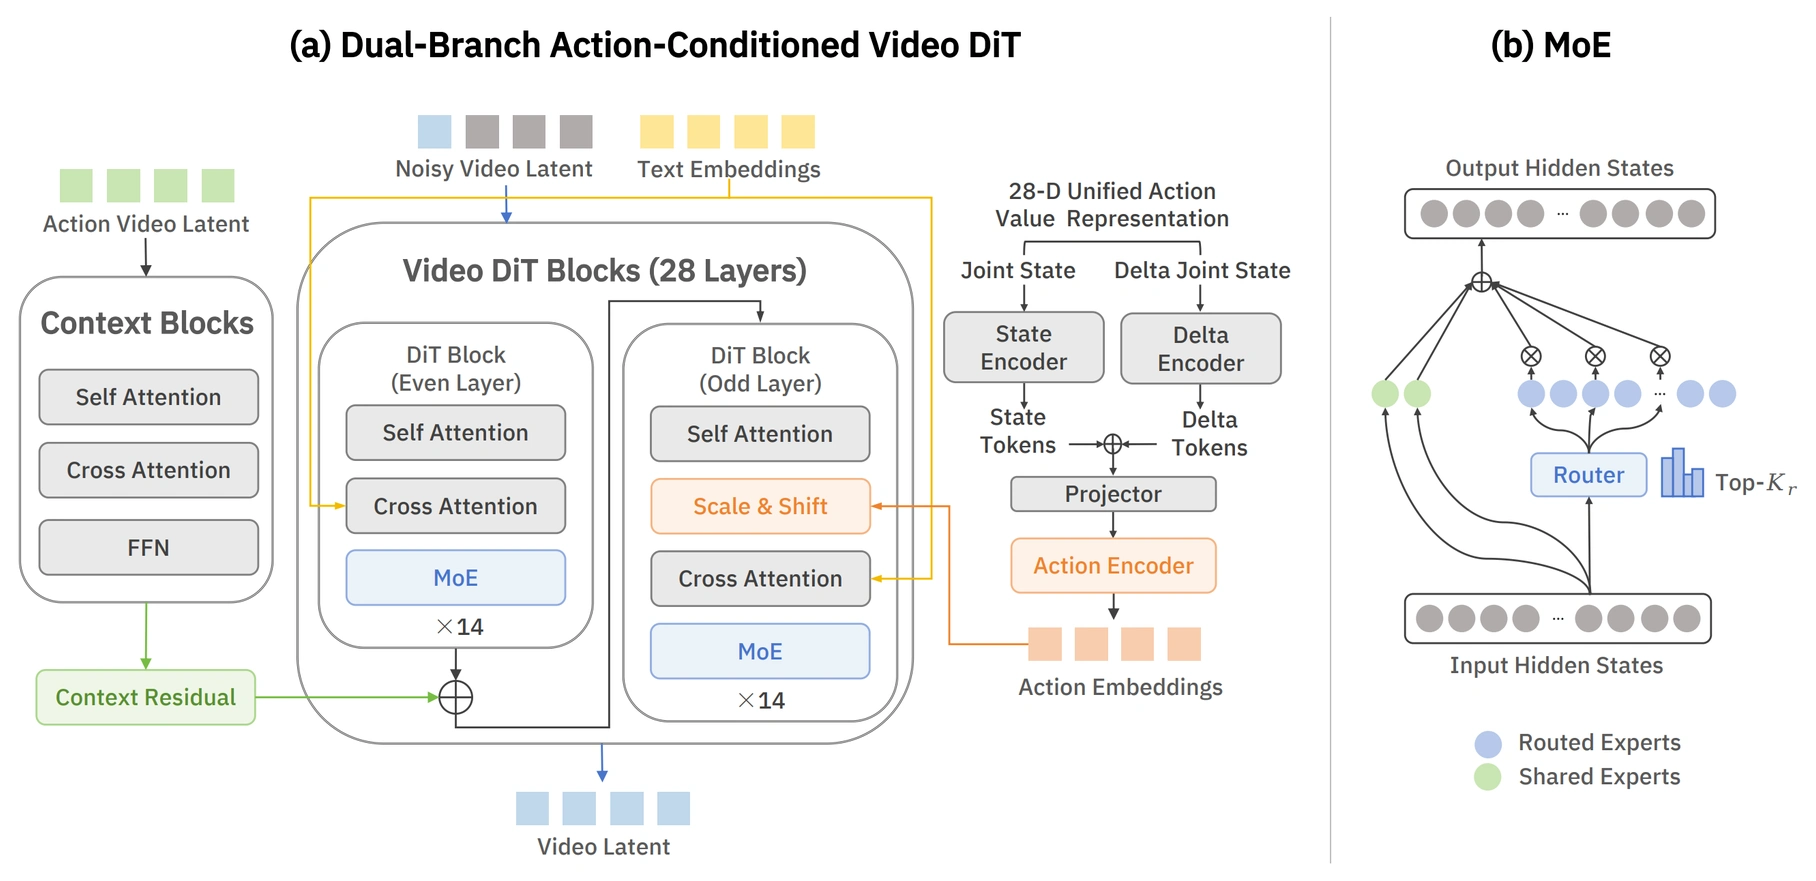
| LingBot-VA 2.0 | 预训练 VA 模型,MoE Video Model + 正常的 Action Expert,语义视觉动作分词器 + Casual + 前瞻推理 + 多块预测等细节 |
| FDM | 把未来预测作为训练期的稠密监督,推理去掉生成分支;在保留视觉监督收益的同时避免逐步生成未来的成本。 |
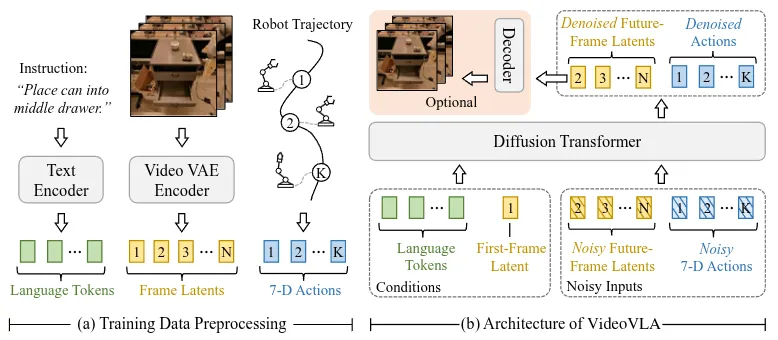
| VideoVLA | DiT VGM 后训练同时预测 Frame Latent + Action |
| InternVLA-A1 | VLM + VGM + Actor 的 MoT |
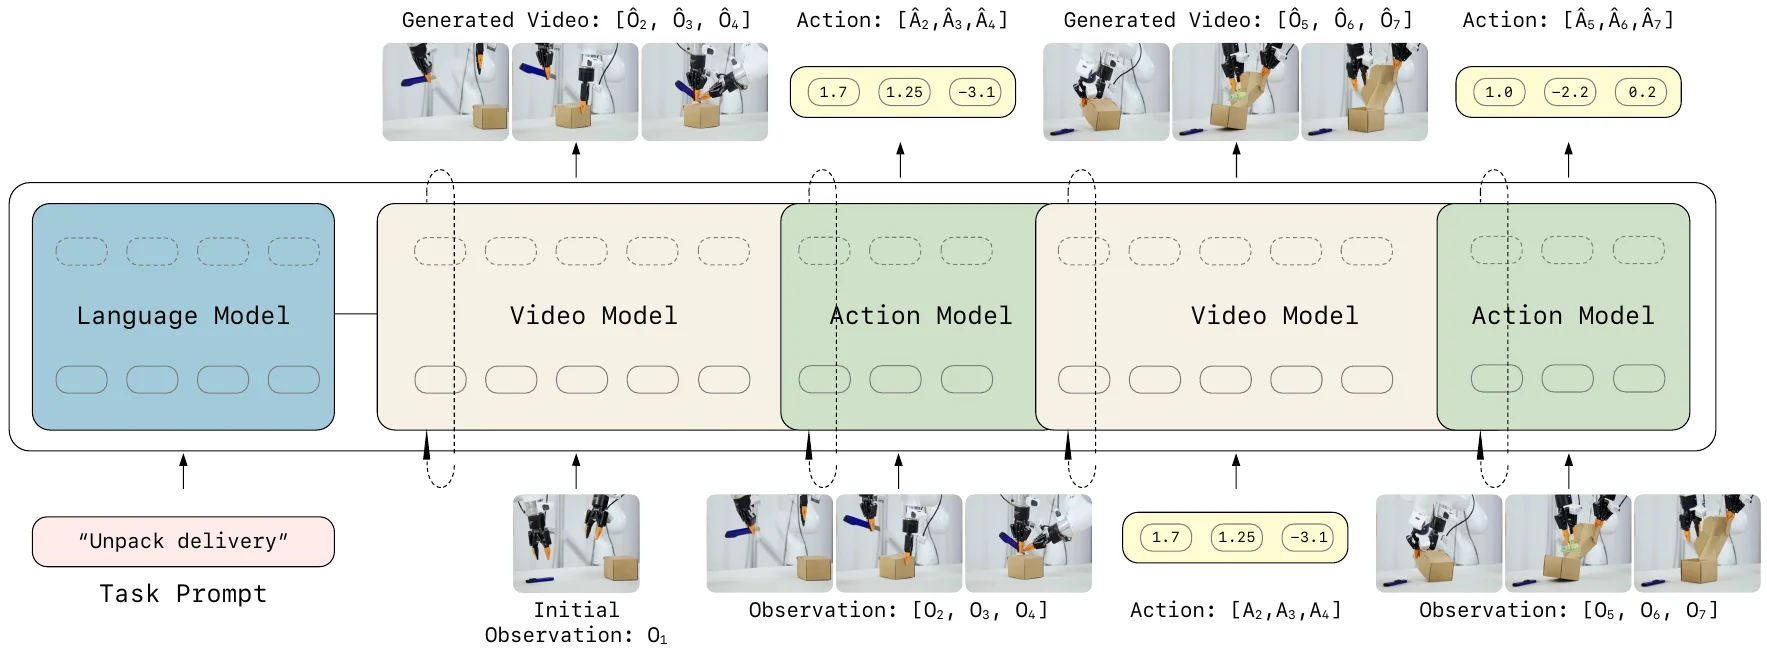
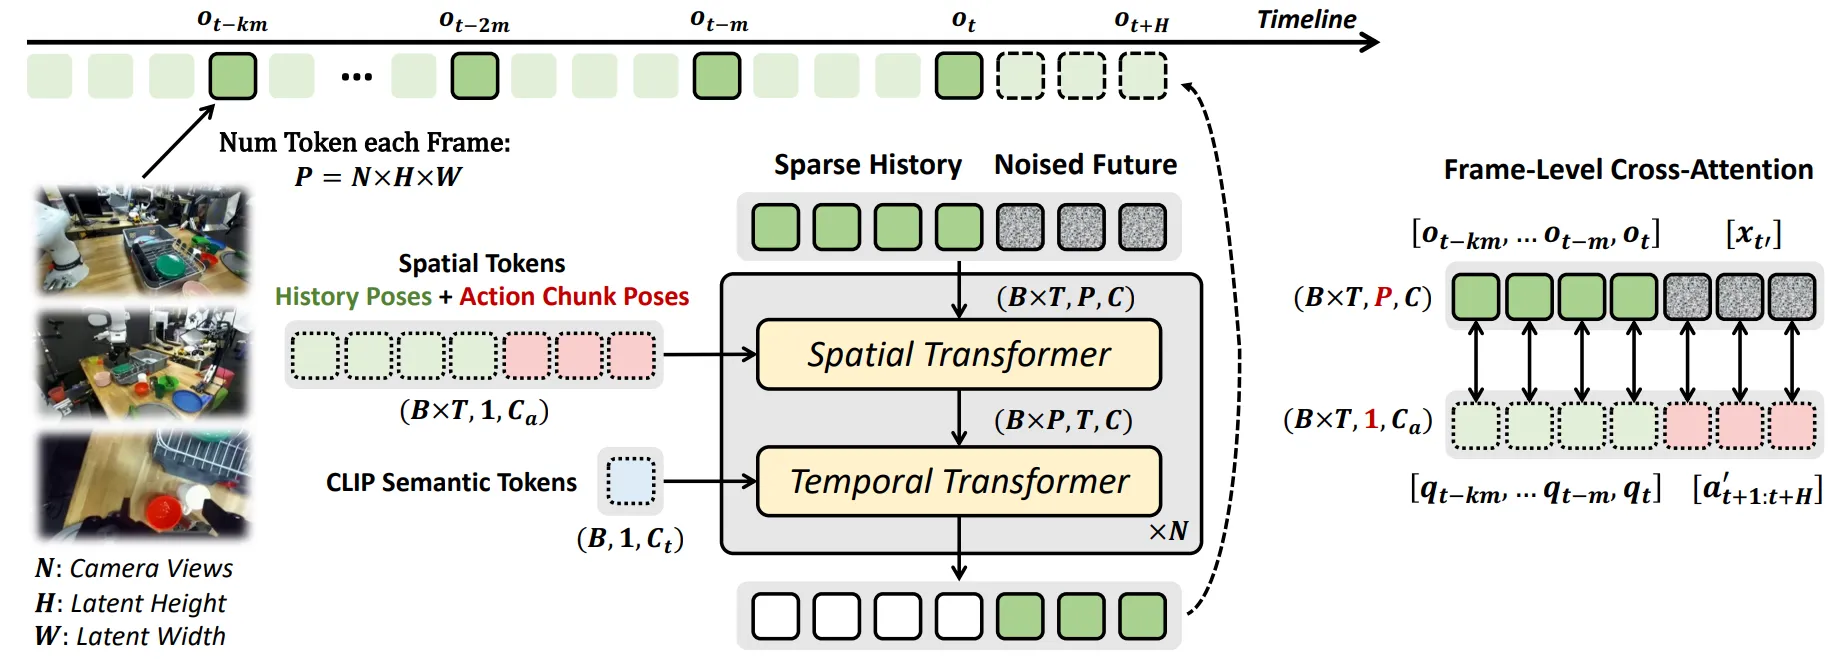
| LingBot-VA | 解耦 WM + IDM 进行 Casual 预测 |
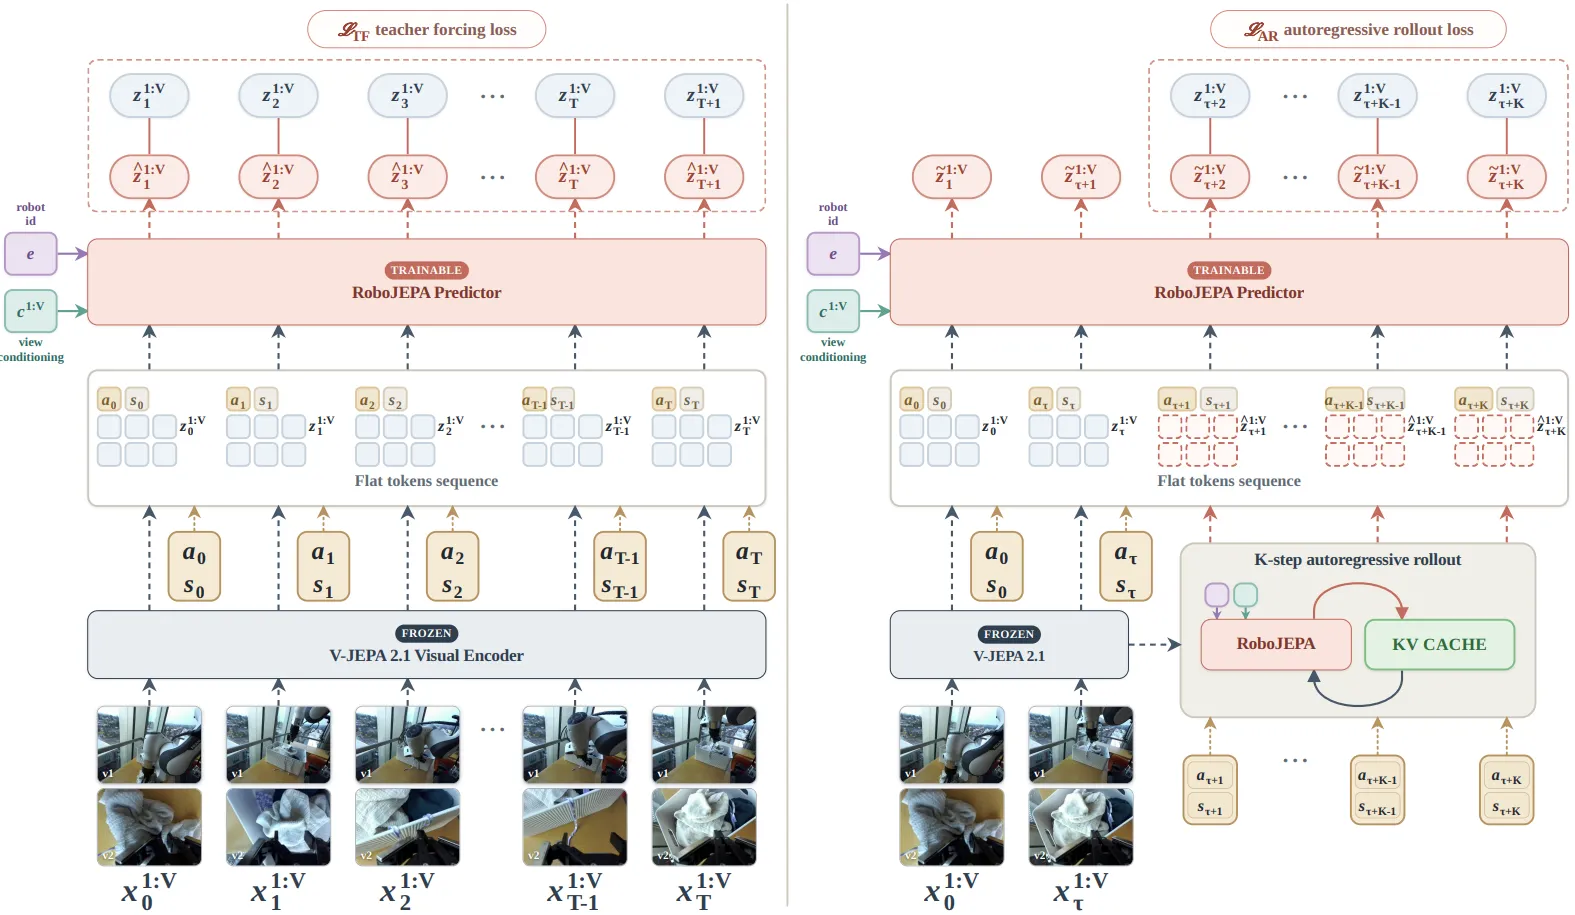
| RoboJEPA | 冻结 V-JEPA 2.1,训练动作条件 Latent 预测器;用目标图像和 CEM/MPC 做规划,并研究预测器与数据的 scaling。 |
| DreamVLA | LLM 侧预测 Dynamic/Depth/Semantic 的 embedding |
WM as Simulator#
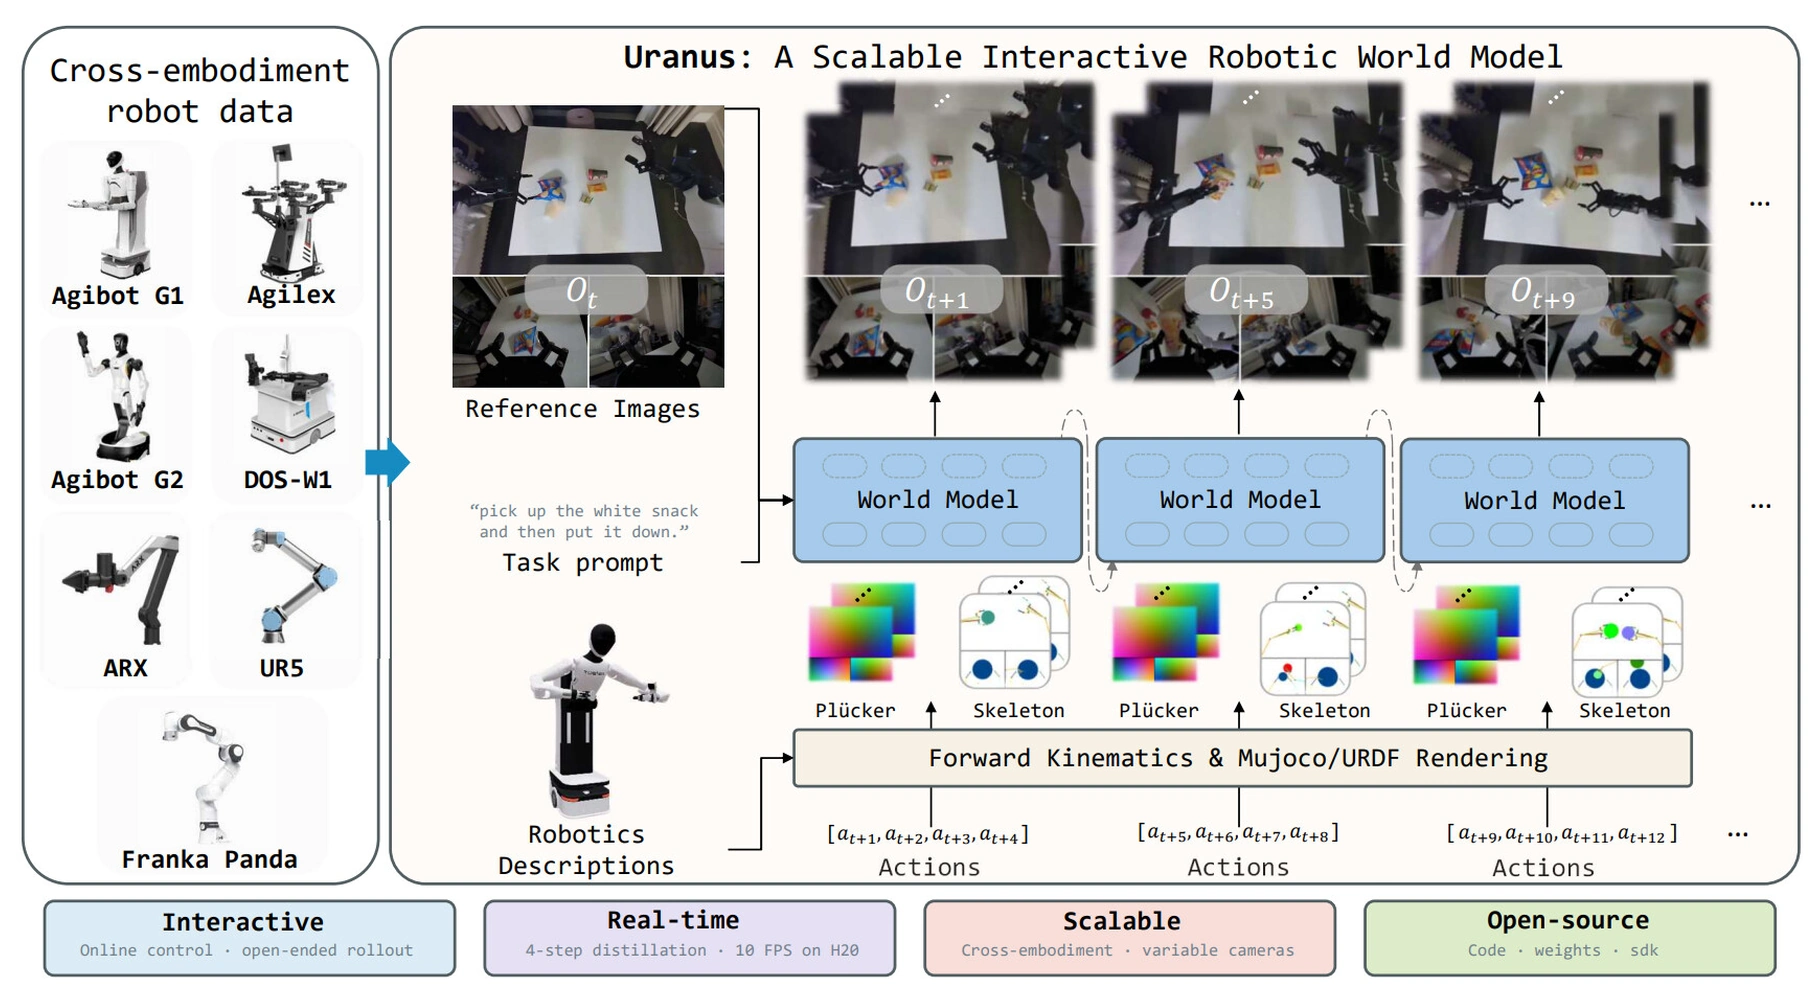
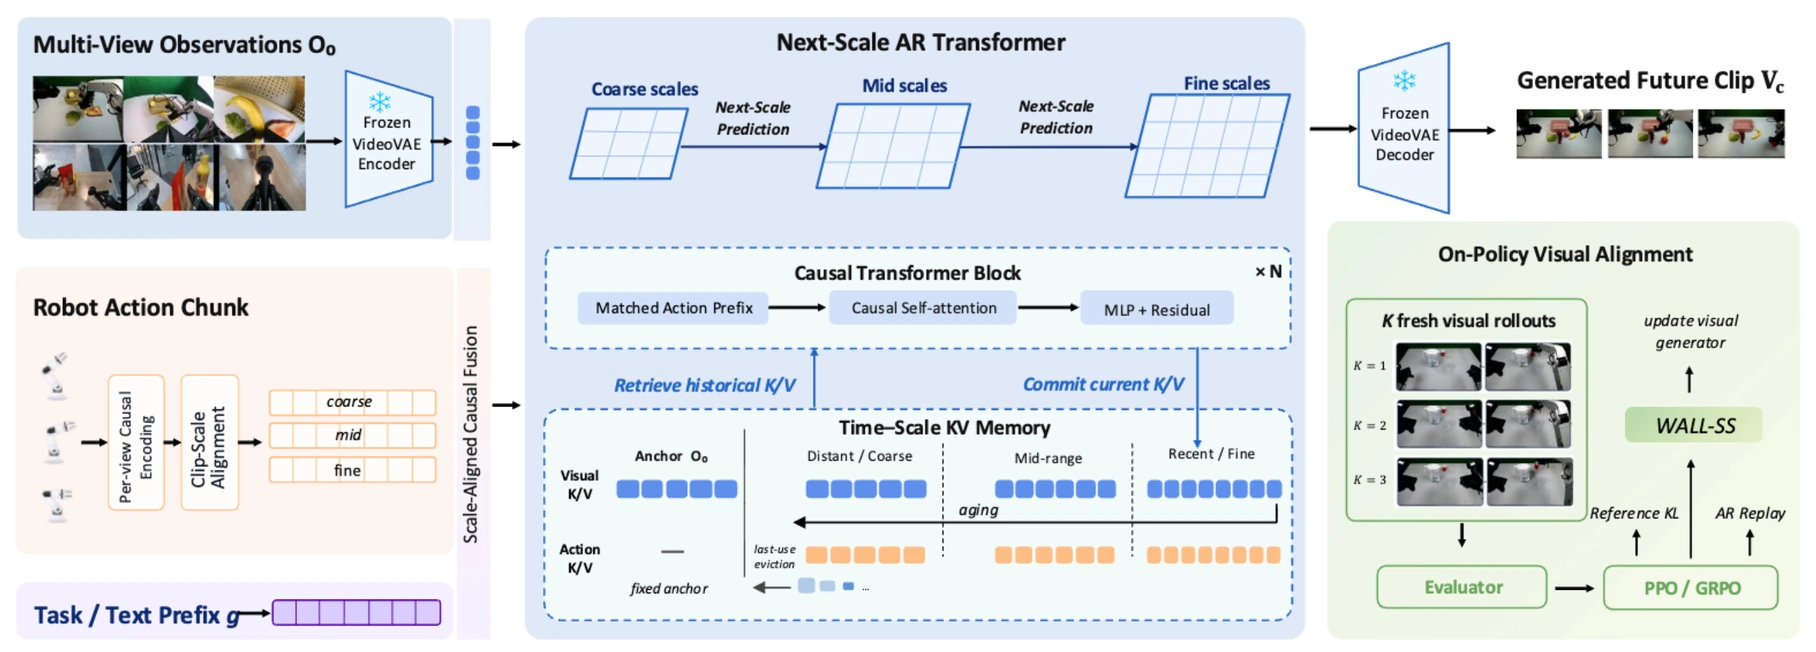
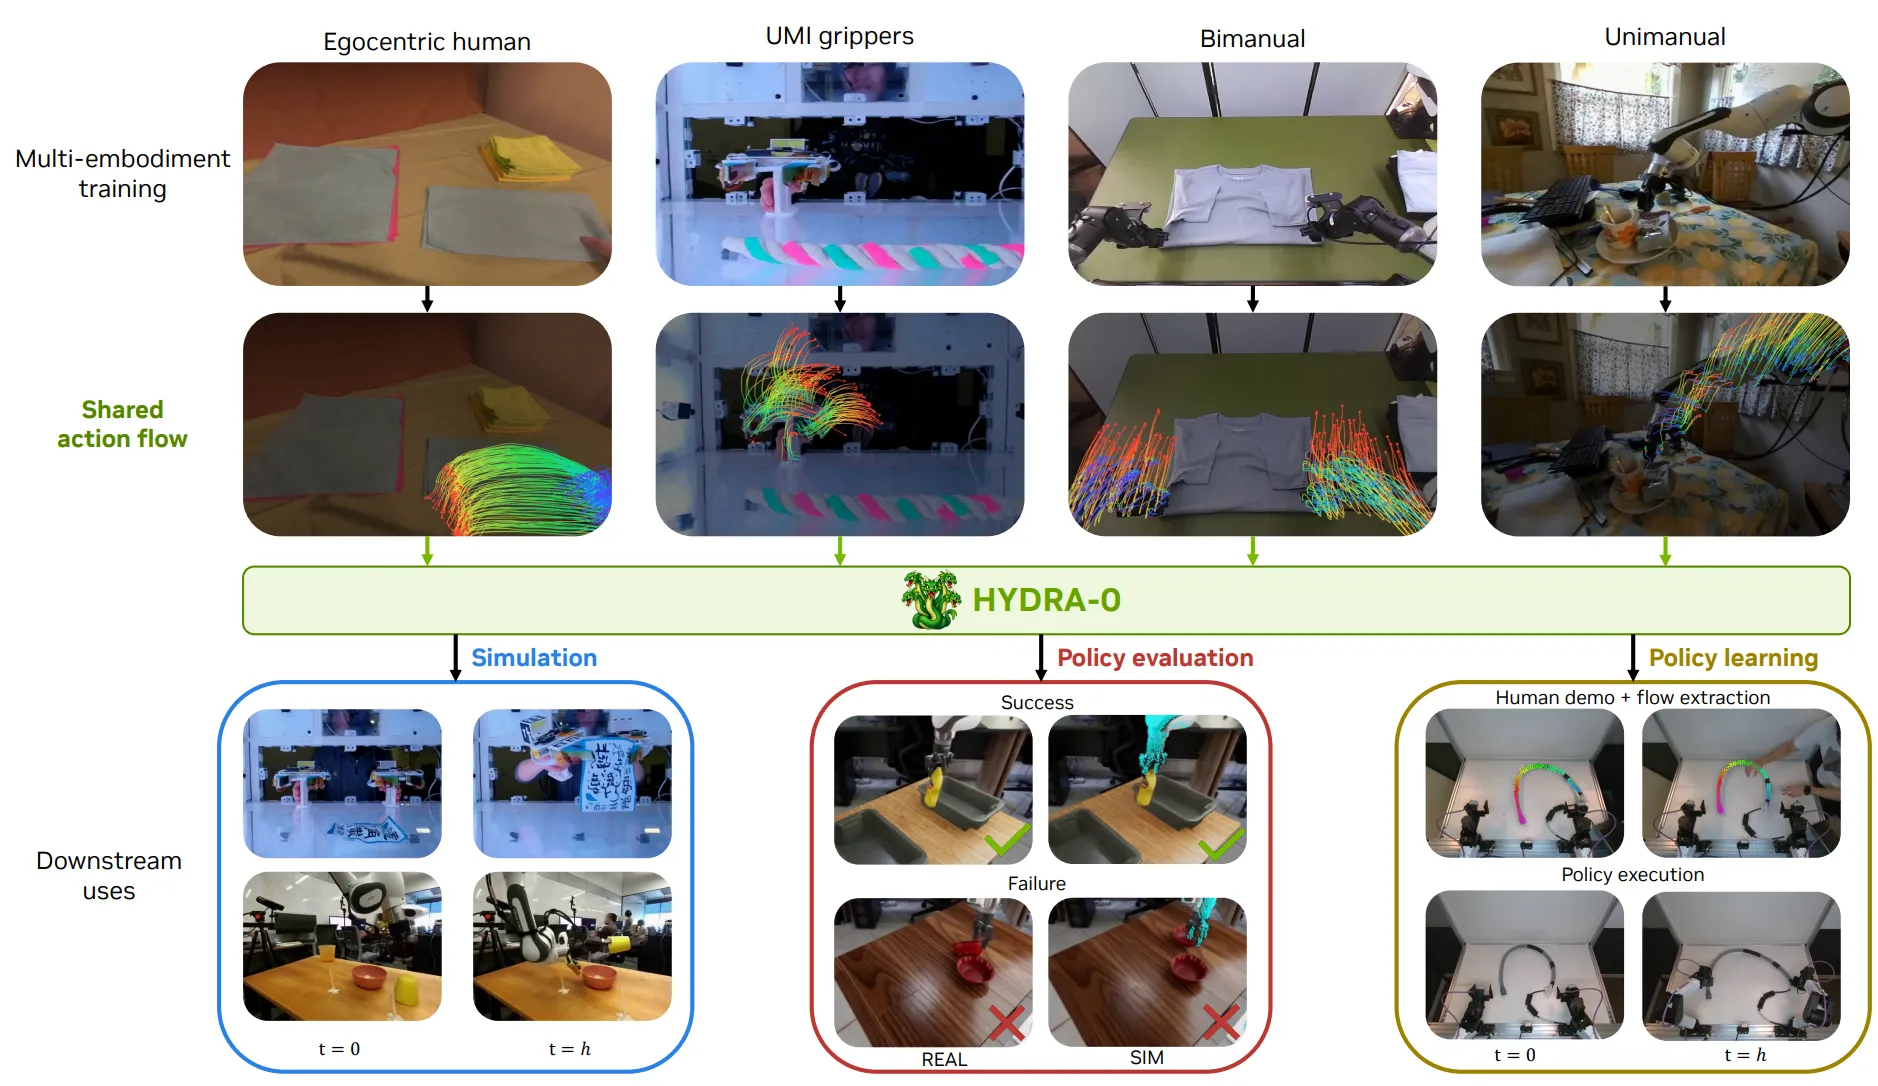
Action condition WM 指的是对于下一帧的预测不仅 condition on history image,同时也在某种动作的约束上,从而可以达成某种在视频生成器中进行游戏中控制的效果。与此同时,如果说 Action condition WM 所谓 Action 的输入不是 WASD 而变成机器人的动作信息,这个就延伸成为了我们所谓的 WM as Simulator。
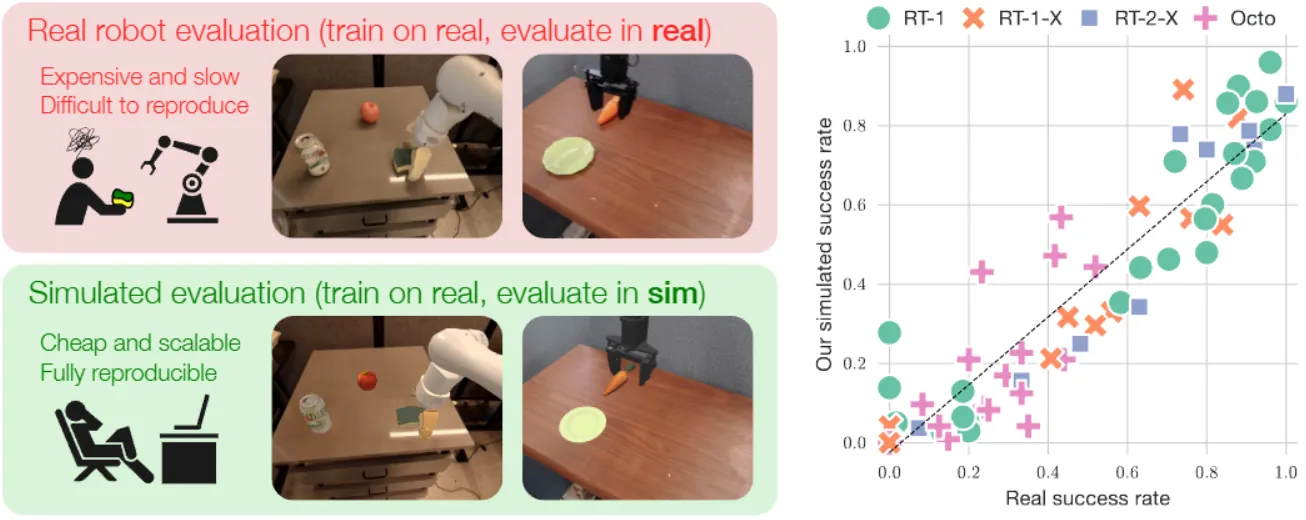
比较早的有 UniSim,后来 Google 也用 Veo 改造了一个来测评 Gemini Robotics 的策略。这个领域的一个问题在于数据的 bias:训练用的数据主要都是机器人成功的数据,用这个 Simulator 来测试的时候,成功率就会比理论成功率要高,比如夹爪接近物体之后就直接吸附上去了。ProWorld 用仿真造了一批抓空之类的失败数据混进去训练,虚高确实少了一些,不过本身解决这种 Bias 问题还是需要 data centric。
| 论文 | 主要贡献 |
|---|---|
| Ctrl World | 可控多视角 World Model as Simulator |
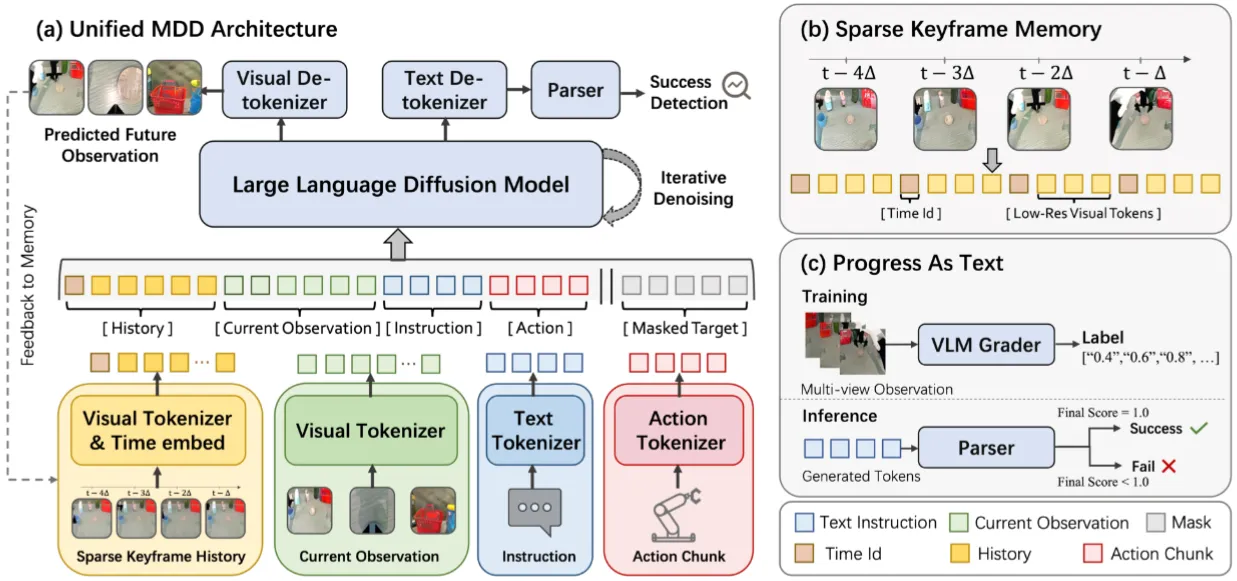
| dWorldEval | 使用 LLaDA 输入 History / Obs / Text / Masked Target,预测 Obs 以及 Success |
| Pelican-Sim 1.0 | Open-X-Humanoid 出品的基于 Cosmos 2.5 训练的机器人世界模型模拟器。 |
| Uranus | 以关节轨迹为条件自回归生成多视角视频的机器人 WM Simulator,面向流式交互与低延迟推理。 |
| WALL-SS | 自变量出品的,从 InfinityStar 初始化,以 next-scale prediction 训练 action-conditioned 世界模型,将既有生成范式迁移到动作条件建模。 |
| Hydra-0 | 以 Action Flow 条件统一动态建模与控制的世界模型;光流数据本身不方便构建。 |
Embodied RL#
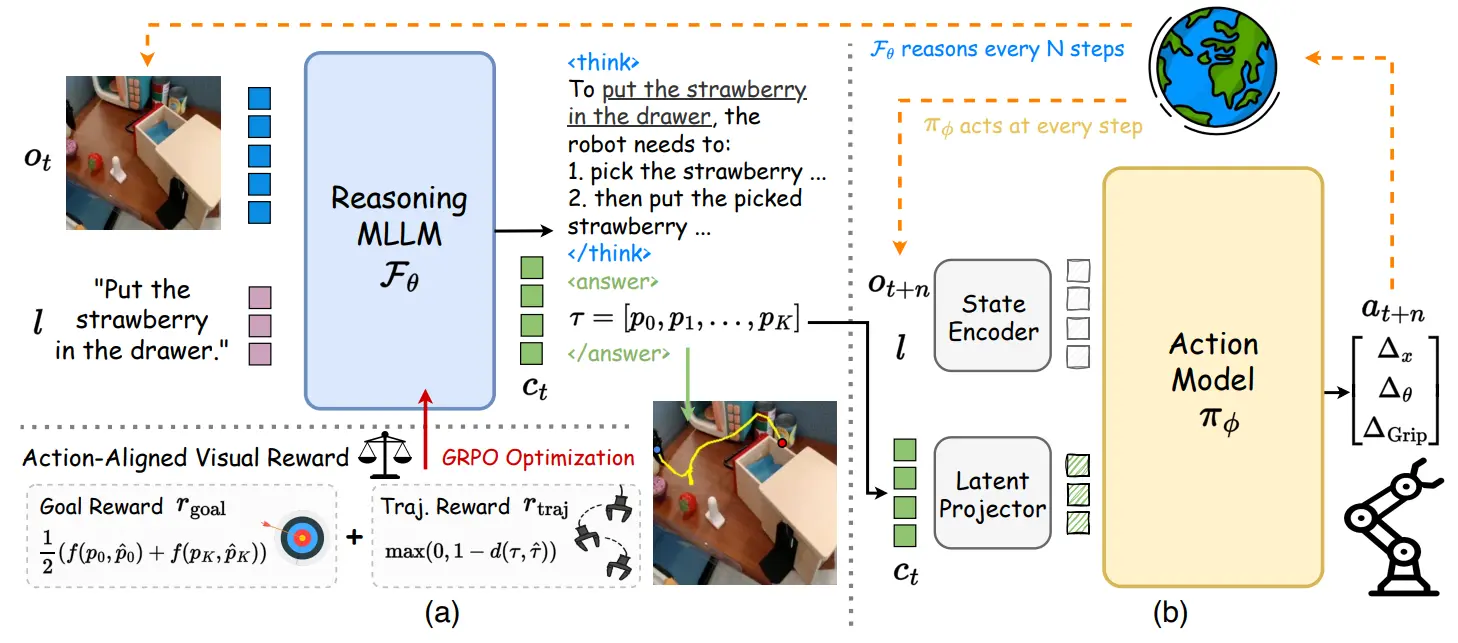
伴随着 VLA 技术的发展,在 LLM 以及 VLM 中流行的 RL 技术也迅速涌入了具身领域,在对于 Flow Matching 施加 RL 之前,一些研究先探索了对于 VLM 进行具身导向任务的 RL,比如说轨迹预测等:
| 论文 | 主要贡献 |
|---|---|
| ThinkACT | 对于 VLM 使用 GRPO 训练轨迹预测能力 |
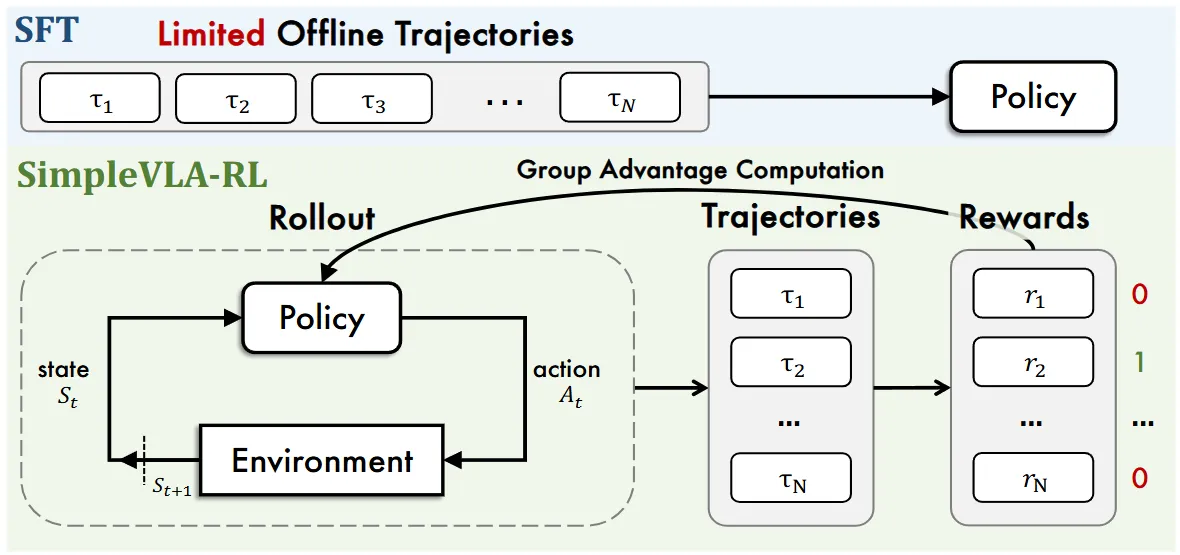
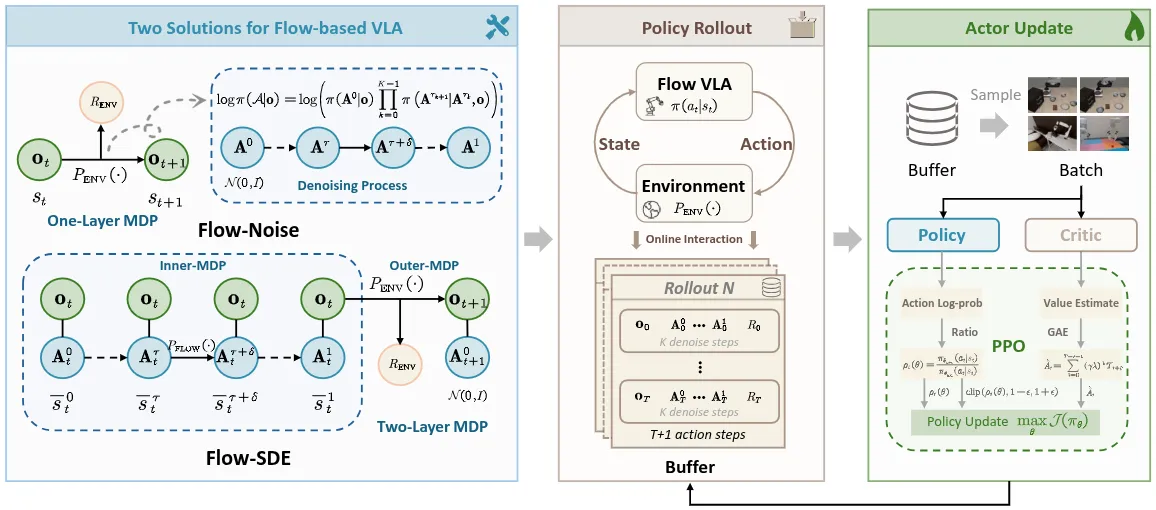
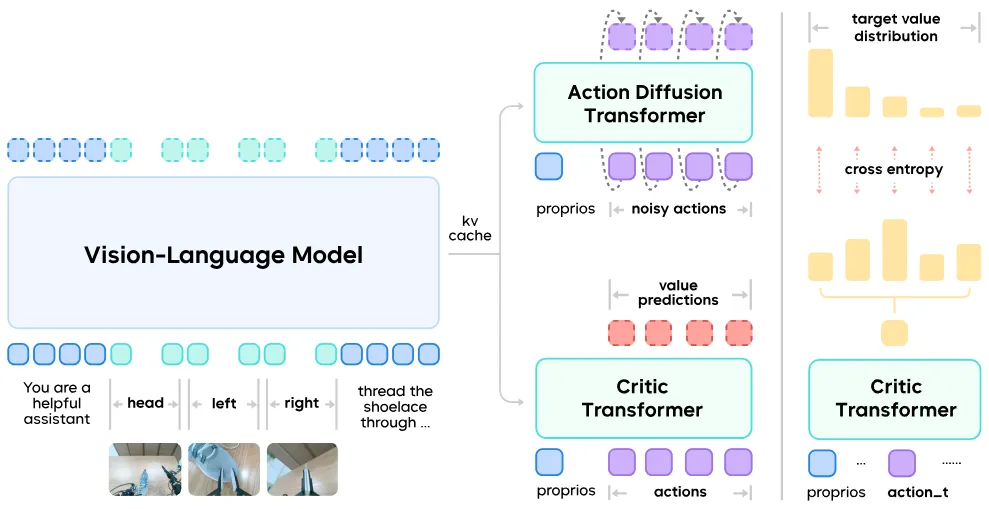
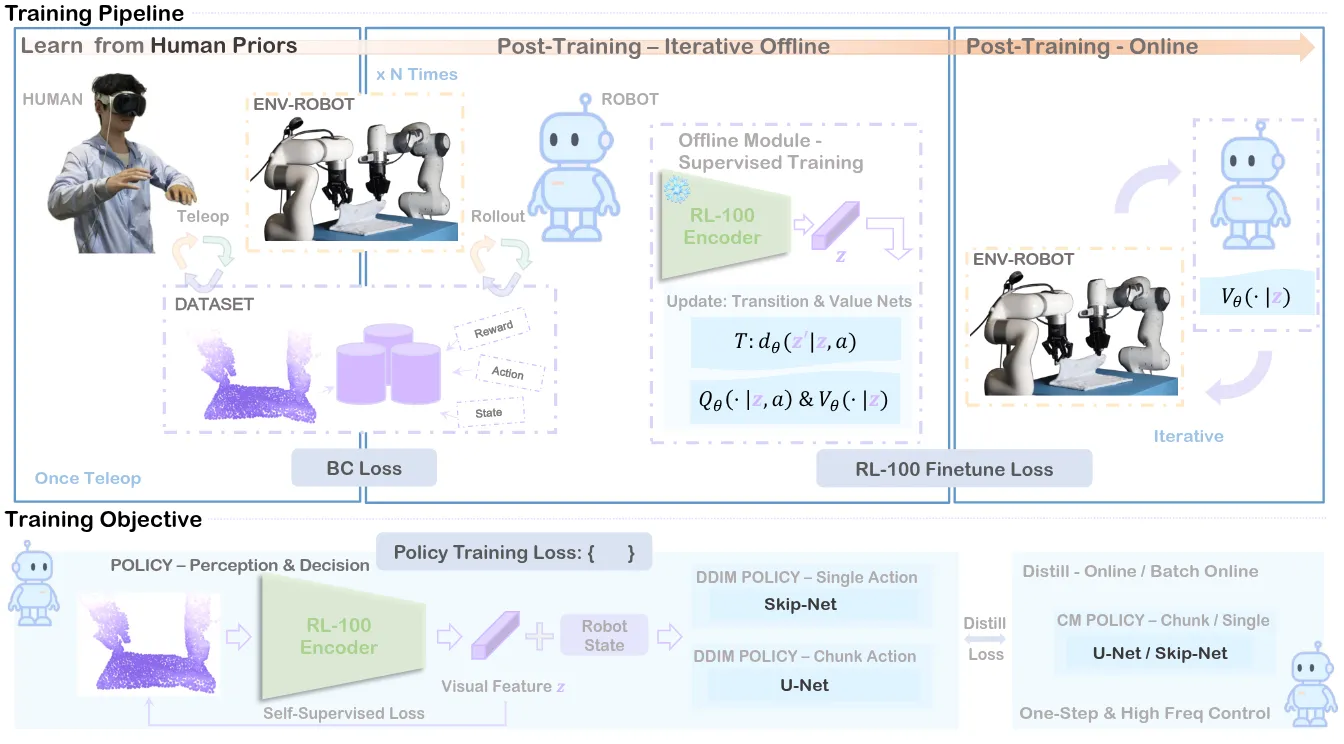
在一些工作在 VLA 领域中进行了一些探索之后,如 等工作开始出现,这些工作伴随一种特性,其中一部分工作试图通过一些方案绕过 RL,而直接在 SFT 中达到类似 RL 的效果,这里如 使用优势值作为模型的输入,本身依然是进行正常的训练,从而可以在部署时,如果输入较大的优势值,则模型趋向于输出优质轨迹,同时在训练中可以 leverage 更多的数据;另外一些工作则进行严格意义上的 RL,通过 online 或者 offline 的方式展开。
RL 范式#
以下是一些 RL 训练相关的工作:
| 论文 | 主要贡献 |
|---|---|
| SimpleVLA-RL | 使用 GRPO 进行 online RL |
| 基于 RLinf 的两种对 Flow 的 RL 策略 | |
| GR-RL | 设计并对 Actor 的初始噪声预测器进行 RL |
| RL-100 | 将降噪描述为 MDP 来构建 RL 并先 offline 再 online RL |
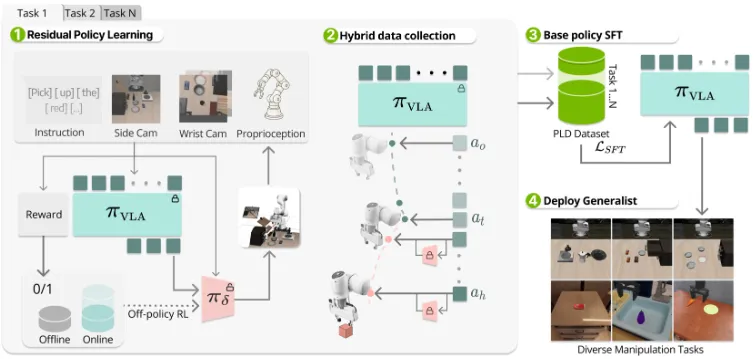
| PLD | RL + 数据回流并通过残差网络学习 |
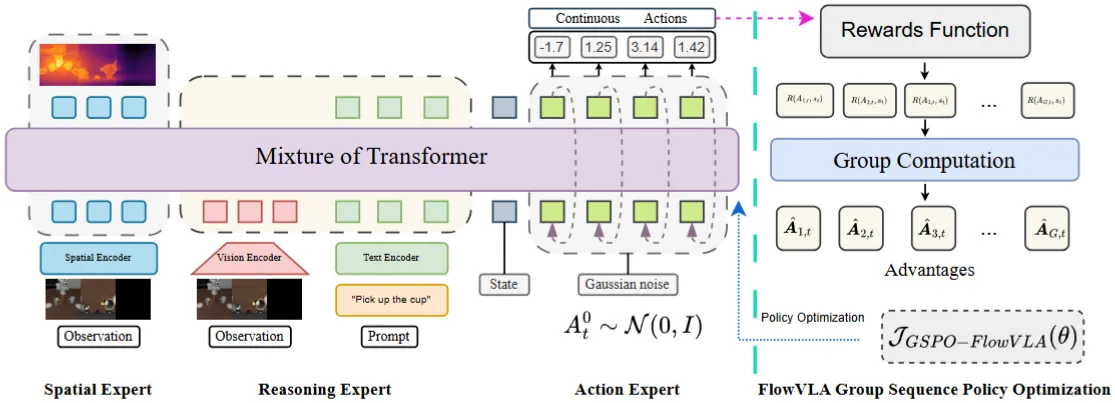
| OmniVLA-RL | 3D + Text + Actor MoT,用 Flow GSPO 进行 RL |
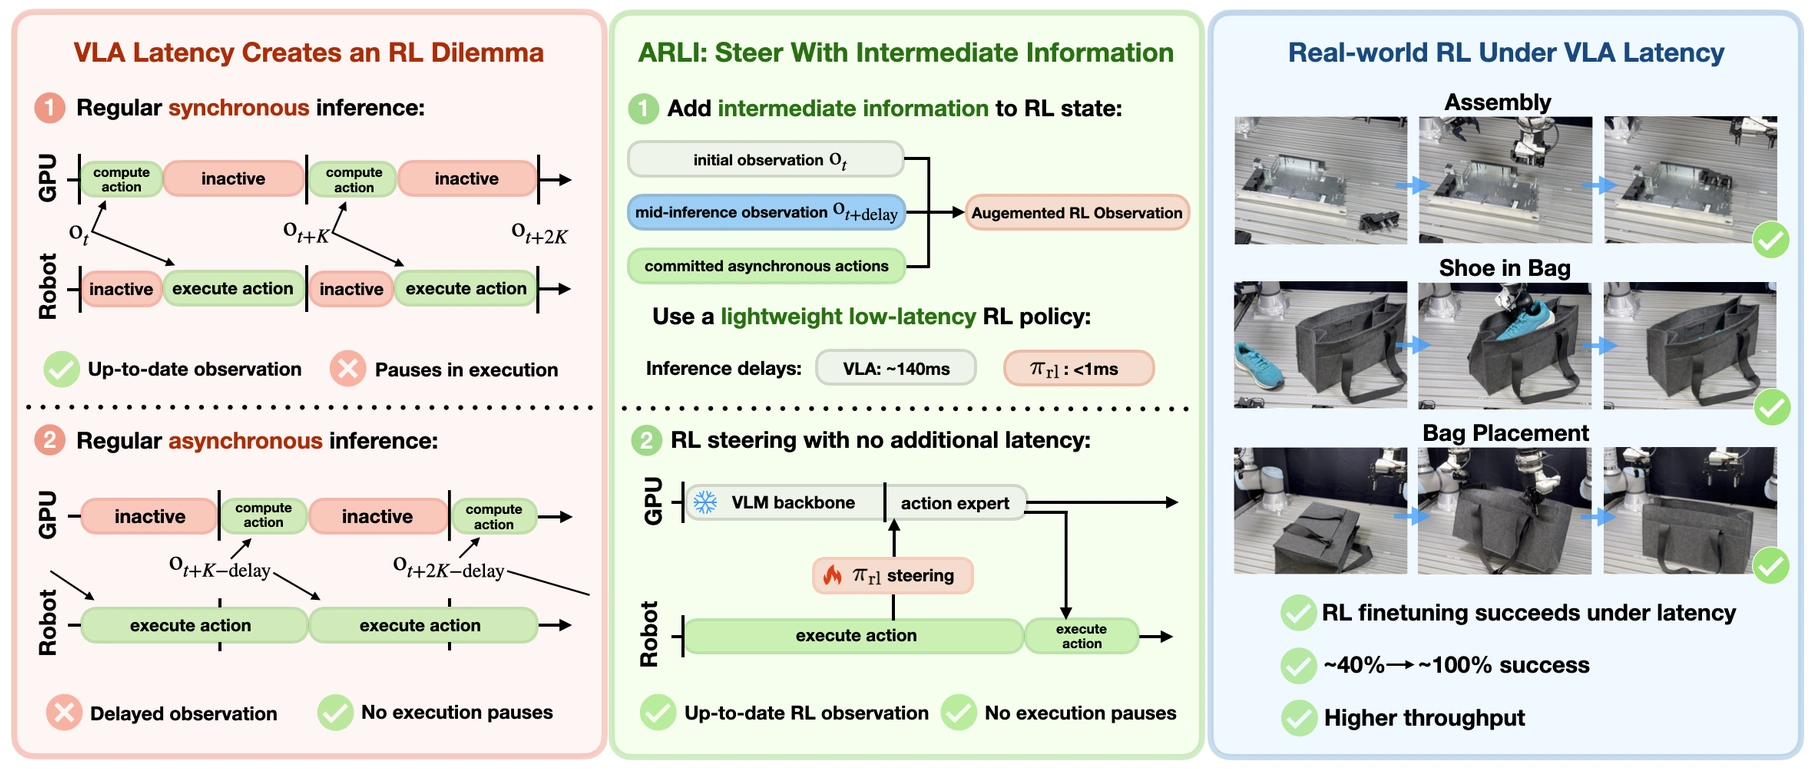
| Learning to Act While Waiting | 在推理等待期间继续执行并进行 RL 微调,让策略适应真实推理延迟。 |
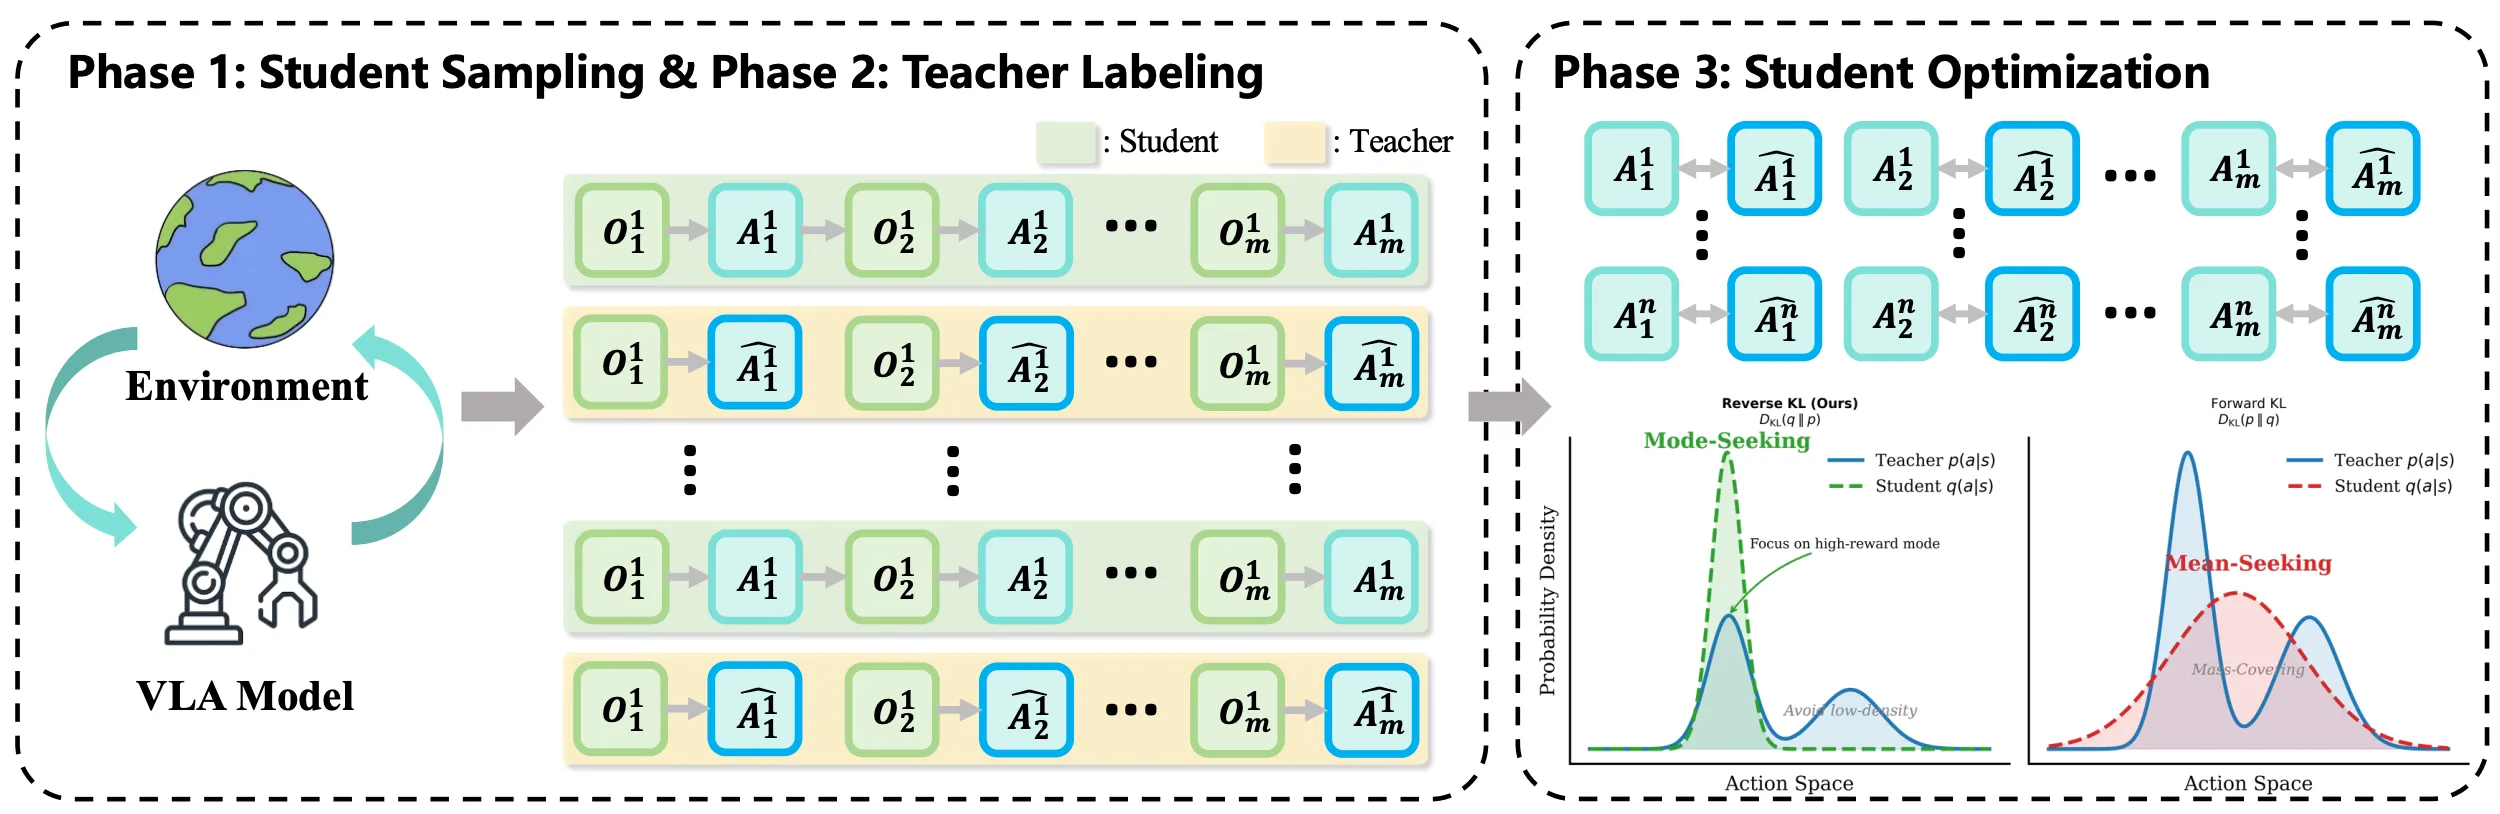
| VLA-OPD | 在 VLA 训练中使用 On-policy distillation,用 SimpleVLA-RL 作为 Teacher |
Reward Model#
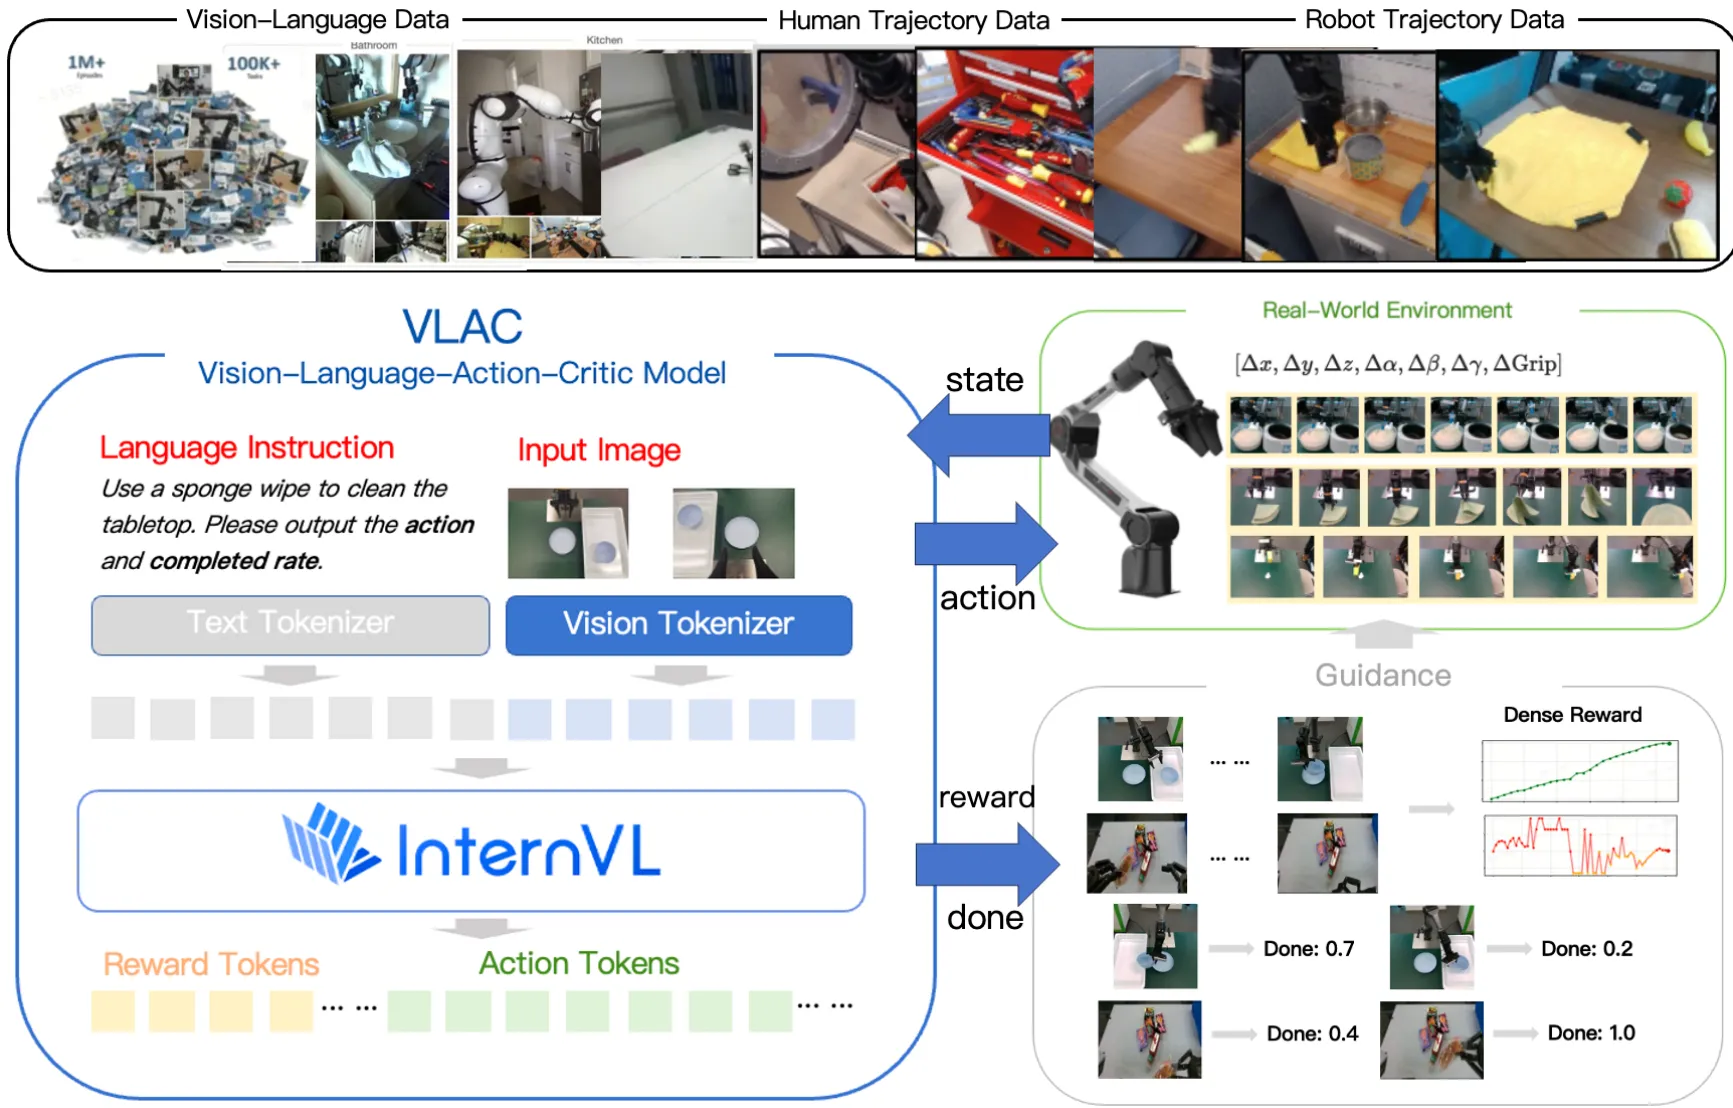
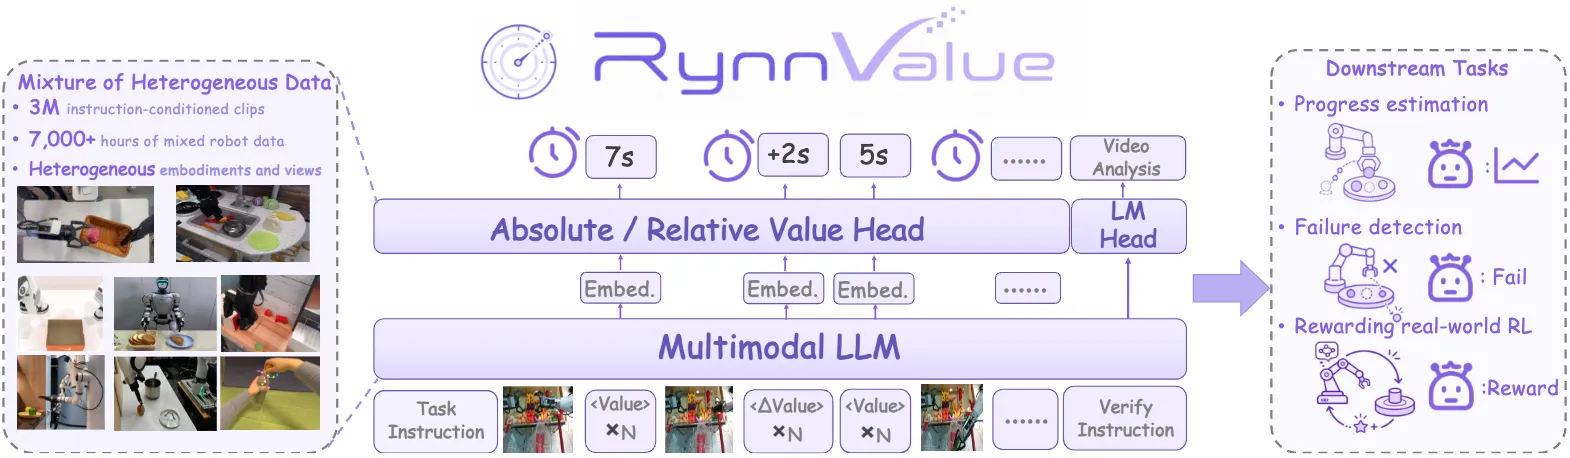
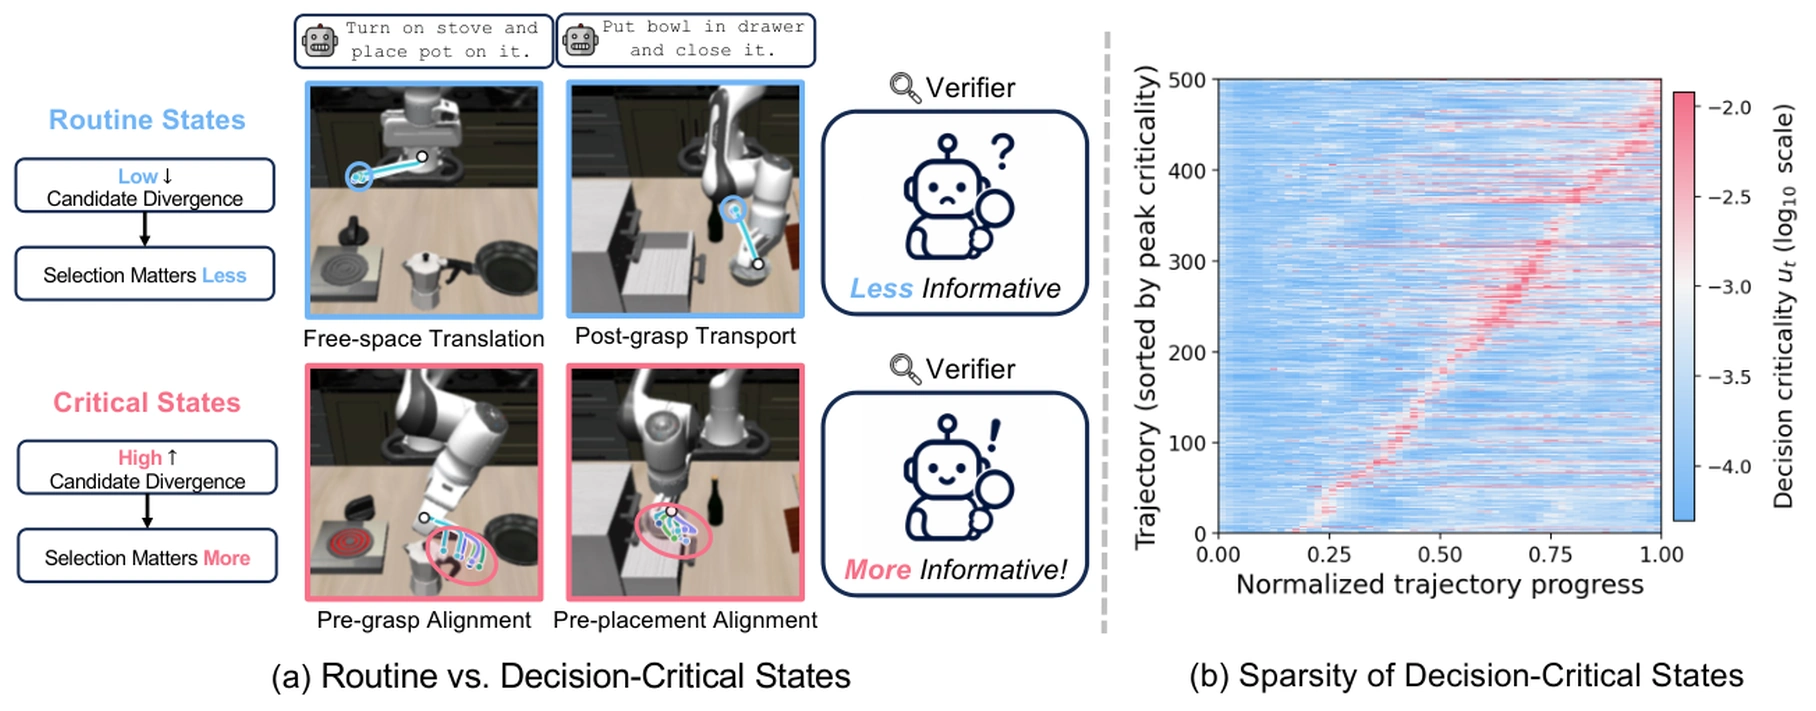
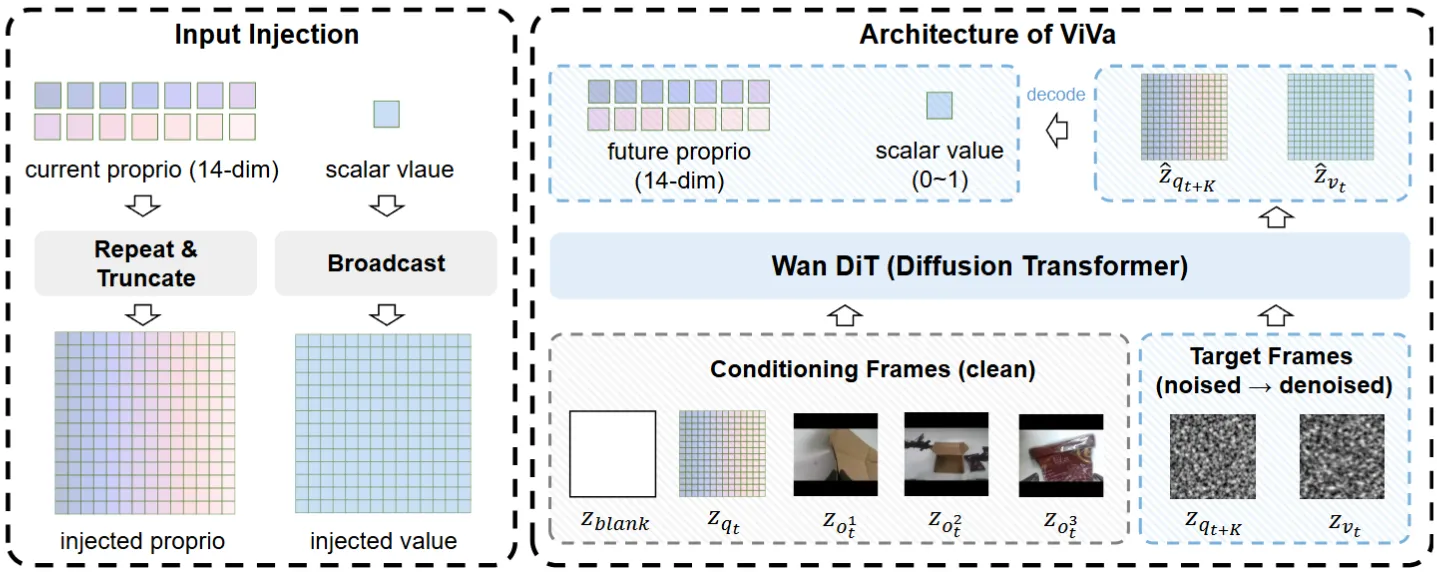
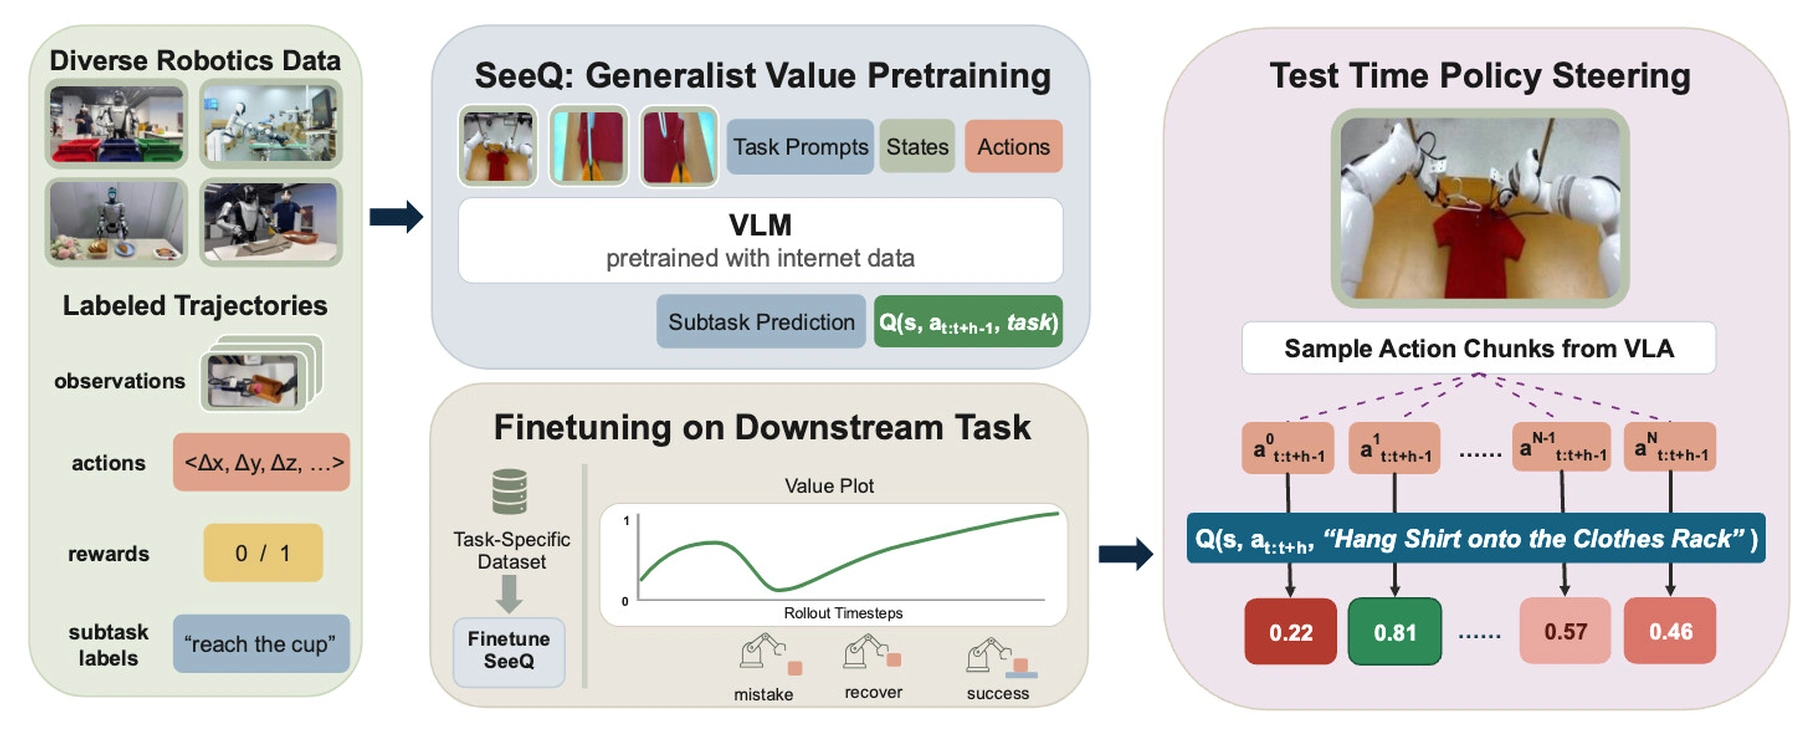
RL 本身的范式是一个关键,同时,除了通过任务的成功率训练模型,训练一个 reward model 可以更好地提供 dense reward 从而达到好的效果,在这方面一些模型有一些早期的探索,比如直接让 VLM 给打乱的视频帧排序来估计任务进度的 GVL。
| 论文 | 主要贡献 |
|---|---|
| VLAC | 从 InternVL 初始化预测 Action 以及 Value |
| RynnValue | 用剩余完成时间进行建模的 Value Foundation Model |
| DiVeR | 利用冻结策略在轨迹关键段不确定性更高的观察训练评分模型,用于训练数据加权与部署时的候选选择。 |
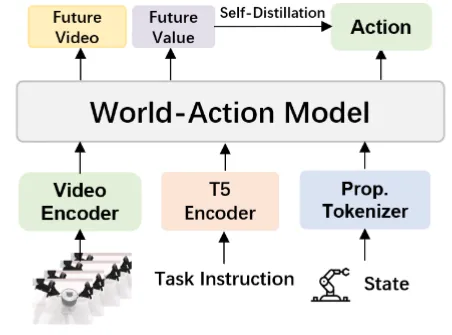
| ViVa | World Model Based DiT 预测 Action 以及 Value |
| AIM | World Model Based DiT 预测空间价值 Map,并且在后训练可以直接用 GRPO 自蒸馏 |
| SeeQ | 从 PaliGemma 初始化的视觉语言 Q 模型,先用自然语言预测当前子任务,再估计其价值,并用 TD 学习。 |
杂项#
除了以上的主要命题之外,具身依然包括很多其他的子问题,对于读者来说,阅读这部分的内容并非必须,但是在相关的话题下,或许可以提供一些有价值的参考。
有价值的 Study Paper#
除了对于模型架构以及训练范式的探索,一些对于模型能力以及训练的系统消融也是有价值的,它们与前文介绍的不同方案息息相关,相关结论总结在这里。比较早的 RoboVLMs 系统比较了 backbone 的选择、VLA 的搭建方式以及跨本体数据的加入时机。值得一提,由于领域仍在发展,一些结论具有局限性,不同论文之间也有区别。
VLM-VLA 训练消融#
| 论文 | 方案 | 结论 |
|---|---|---|
| How Do VLAs Effectively Inherit from VLMs? | 通过 reach emoji 的任务来消融不同训练方案对于 VLM 本身泛化能力的影响 | VLM 的先验是有必要的;LoRA 或者 Frozen VLM 虽然可以提升 SR,但是容易欠拟合;一起训练的问题在于灾难性遗忘,因此 co-training 被验证是有效的。LAPA 类型的 Latent Token 相较于离散 Token 对于训练效果更好。非机器人相关的 VLM 数据也可以 benefit VLA。 |
| StarVLA- | 在全部流行的 Benchmark 上系统 Study 不同的模型训练 setting | 基于 StarVLA 这个很好的 Infra,消融了模型结构、预训练、一些 trick、Batch size、Model size 在内的大量内容在单一 Benchmark 以及跨本体多 Benchmark 混合训练的现象,非常值得一读 |
| Multi-Camera View Scaling for Data-Efficient Robot Imitation Learning | 从提升相机视角数量的角度来 Scaling 并且训练模型 | 不同视角一起训练可以使得模型的注意力 focus 在目标物体上,并且具有更强的性能以及视角鲁棒性 |
| FineVLA | 对比使用细粒度指令与正常指令 | 即使对于目标级任务,细粒度指令仍然可以提升性能 |
| LA4VLA | 在预训练阶段加入细粒度的 Language-Action 数据并在下游 Benchmark 验证预训练效果 | 加入 LA 对于 VLA 预训练有好处,可以促进 VLA 下游表现 |
| What Matters for Latent Actions in Robot Learning | 对于 LAM 的类型以及正则方式等大量内容在不同的仿真以及真机上进行测试来横向比较 | 原始的 LAPO 形式 LAM 具有不错的效果,正则的方式效果不显著,而正则强度效果比较显著,Latent 的 d 为 32 是较好的折中值。更多大量内容见论文内 |
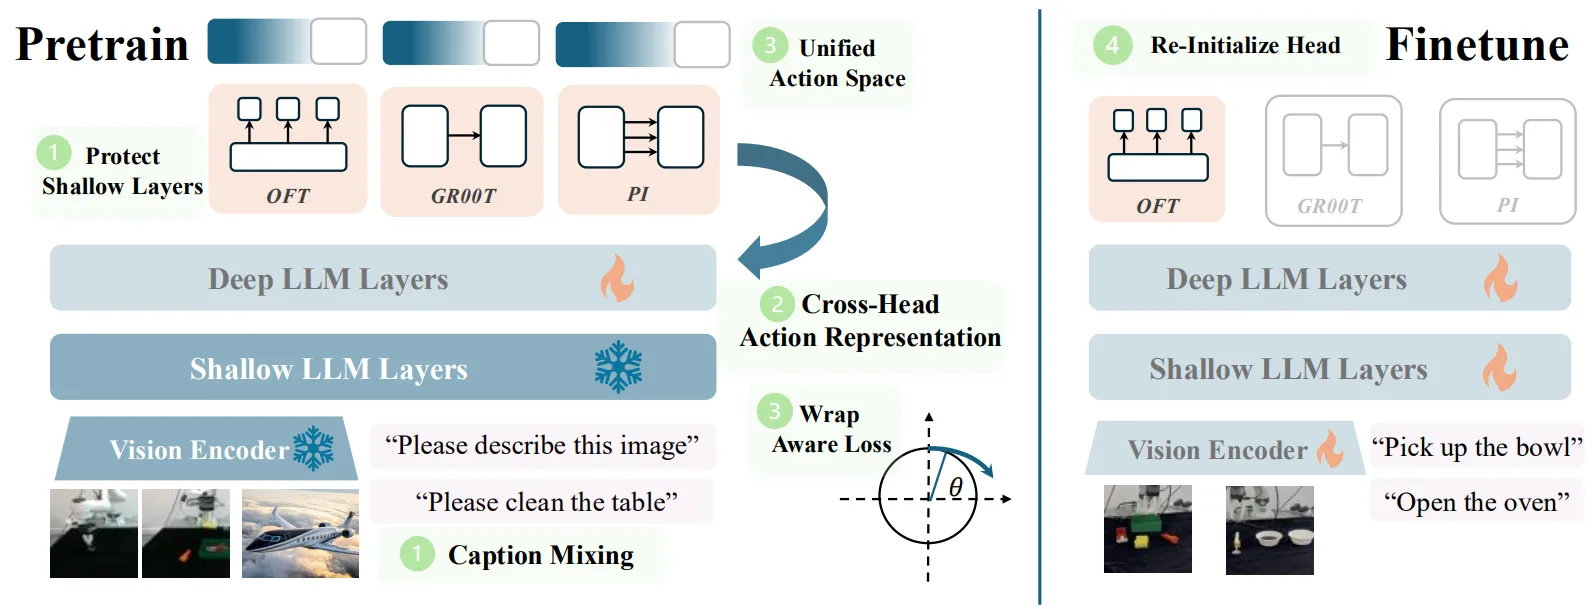
| VLAct | 对于 Action Head 之间的预/后训练迁移以及 VQA co-train 相关内容进行横向比较,构建多 Head 预训练 | Head 改变 Backbone 权重使得预训练之间无法迁移,多 Head 预训练可以取得更好的后训练效果,VQA co-training 在可以带来性能提升,采用的 Unifed Action Space 依然是值得借鉴的现代手段 |
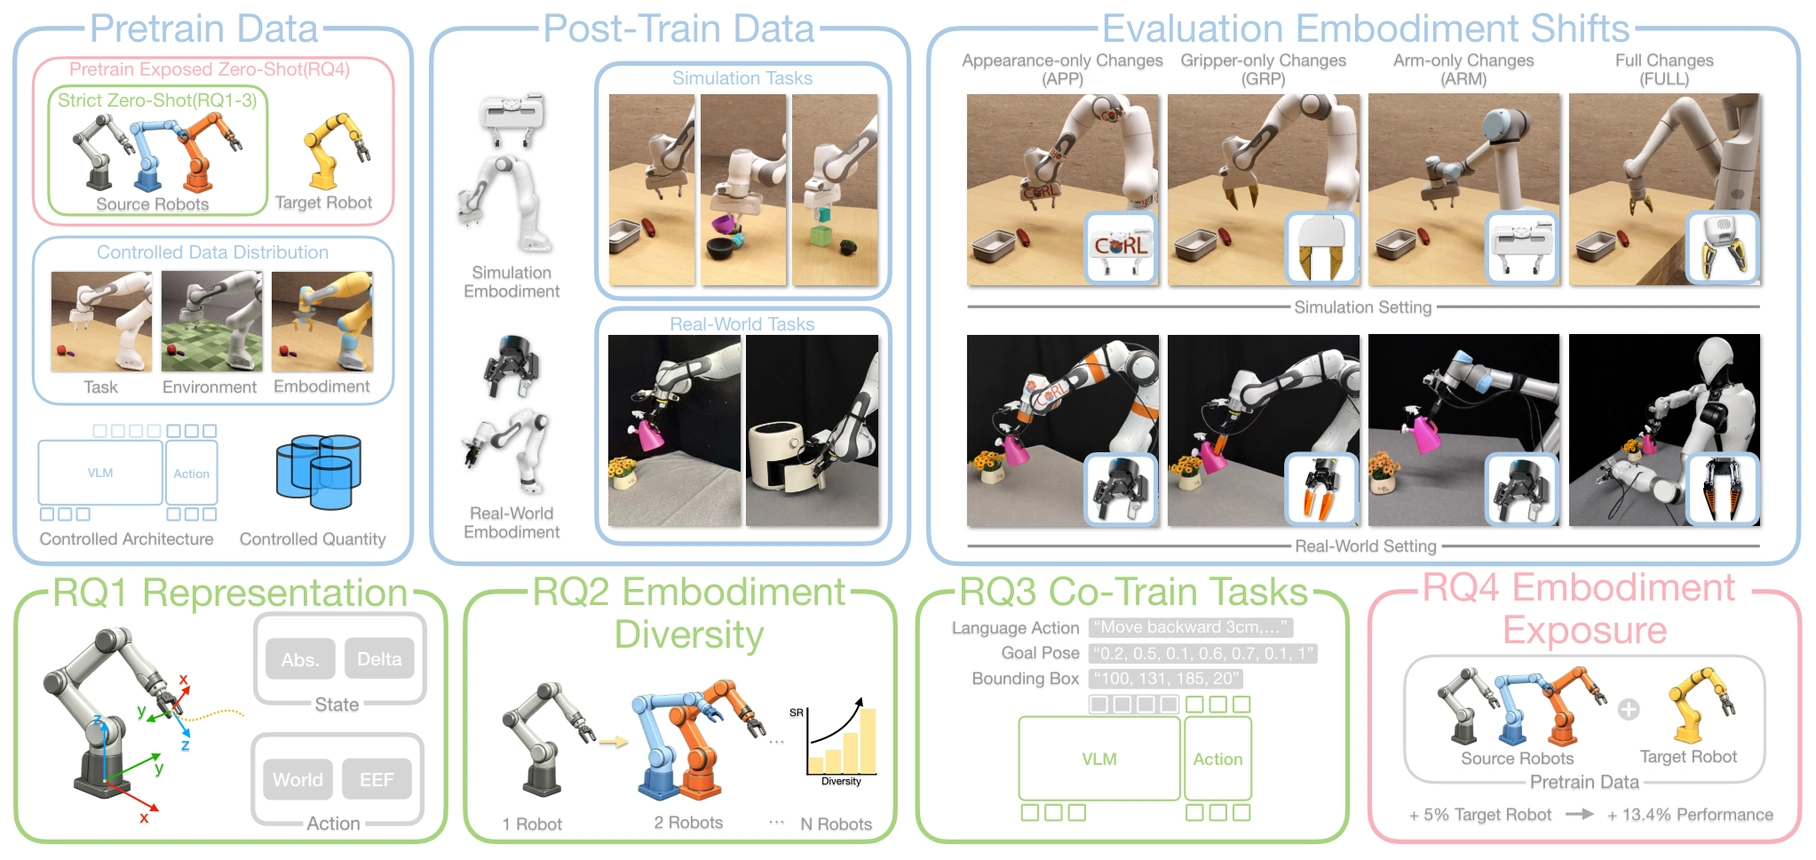
| ZETA | 用可控合成数据研究跨本体预训练与迁移 | 固定数据总量时增加本体有益,Delta EEF 与任务条件 BBox 监督在其设置下较好;预训练是否覆盖目标本体也很重要。 |
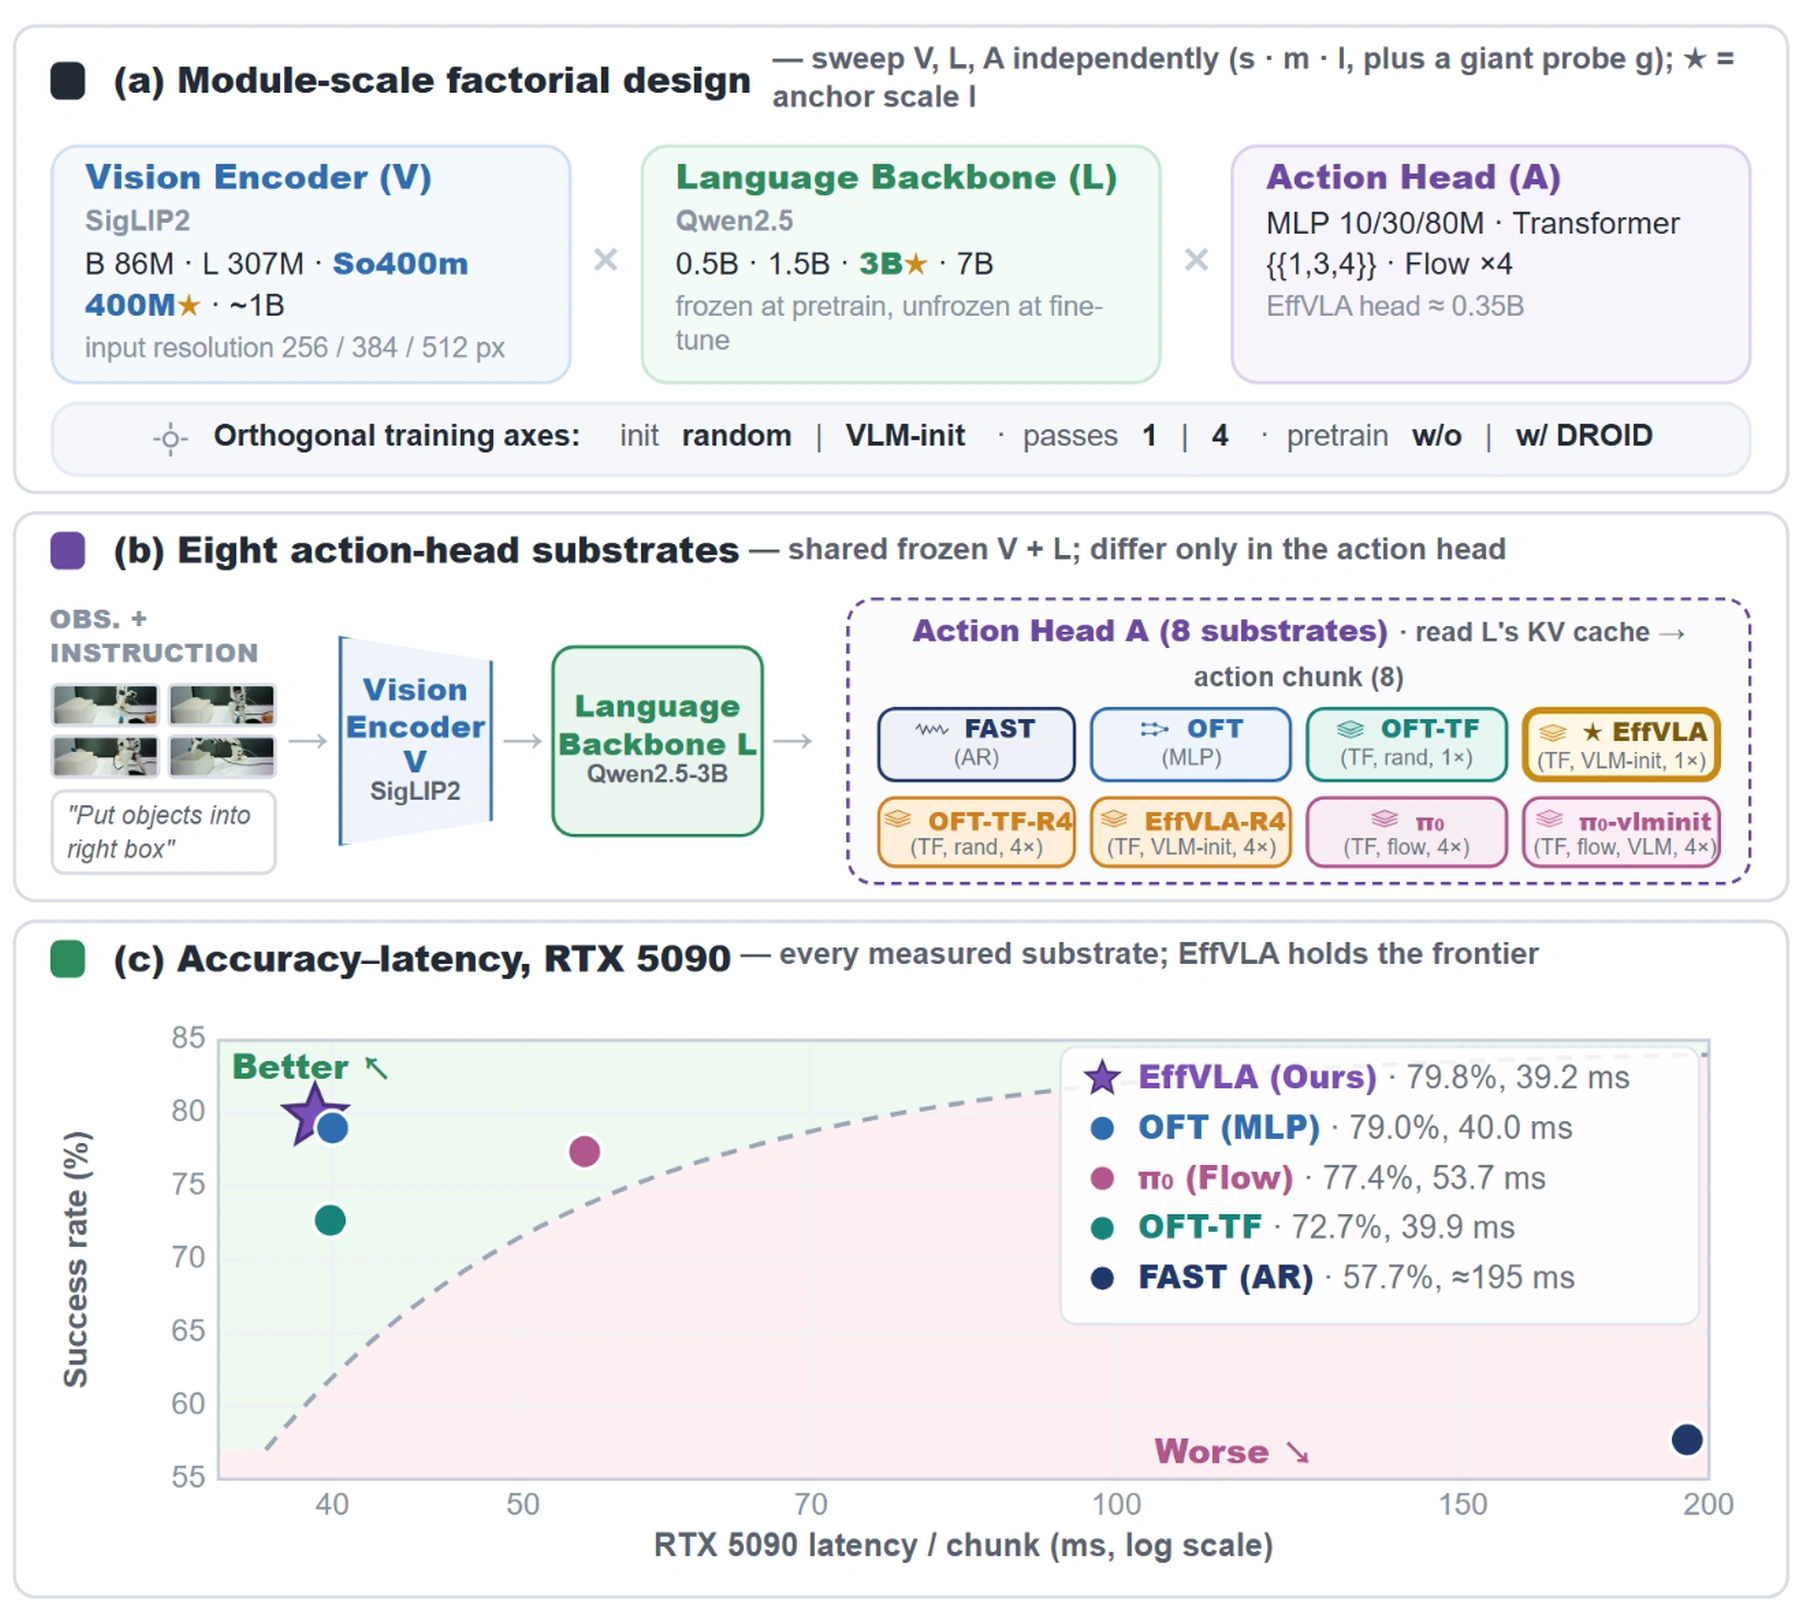
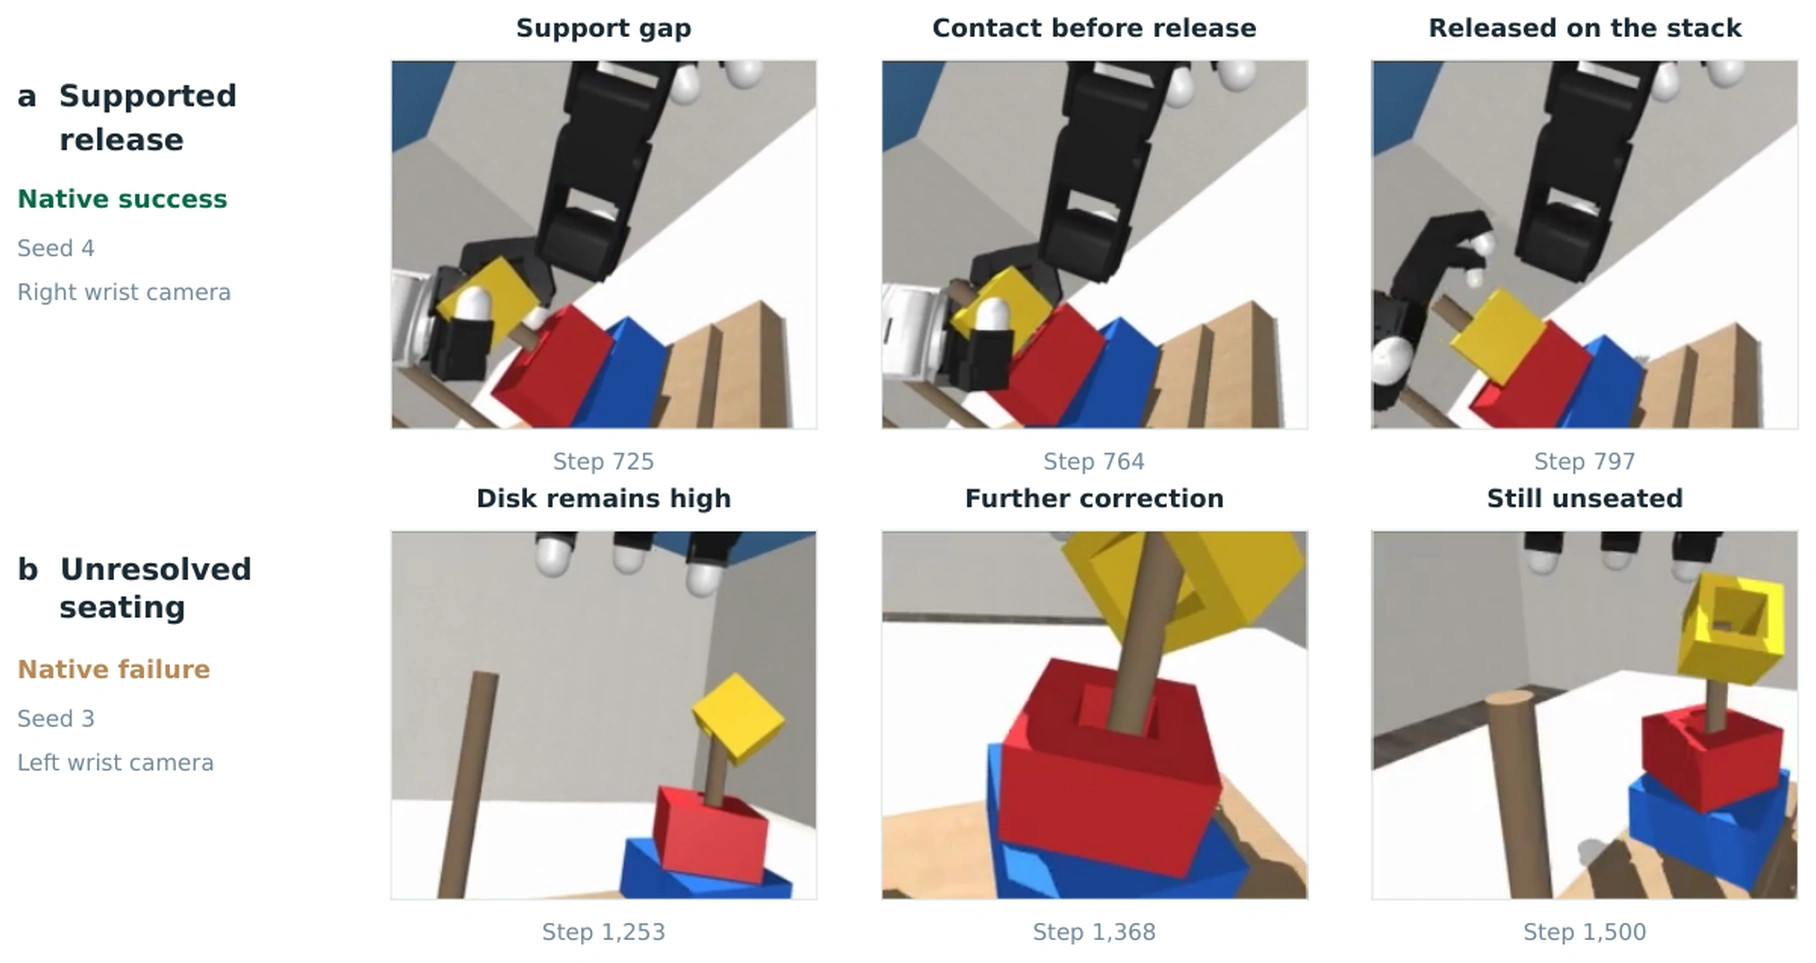
| EffVLA | 比较视觉/语言主干与 Action Head 的容量分配 | 扩展 Action Head 与从 VLM 裁剪初始化都有收益;主要是 DROID 预训练和下游仿真的结论。 |
| Astra as Embodied Policies | 比较通用模型直接动作输出与搭配小 VLA 的混合控制 | 混合小 VLA 的方案通常更好,同时暴露通用模型直接控制的 Token 开销。 |
视频预训练与 WAM 消融#
| 论文 | 方案 | 结论 |
|---|---|---|
| Do World Action Models Generalize Better than VLAs? A Robustness Study | 通过使用 LIBERO 以及 RoboTwin 的扰动版本,测试不同的 WAM 以及 VLA,并且比较二者的差距 | WAM 普遍对于扰动更鲁棒,VLA 想追平需要更大、更杂的 robotic 数据;混合 video prior 的 hybrid 方案落在中间 |
| Fast-WAM | 保留视频 co-training,对照是否在推理时生成未来 | 省掉 Future Generation 依然有较好性能 |
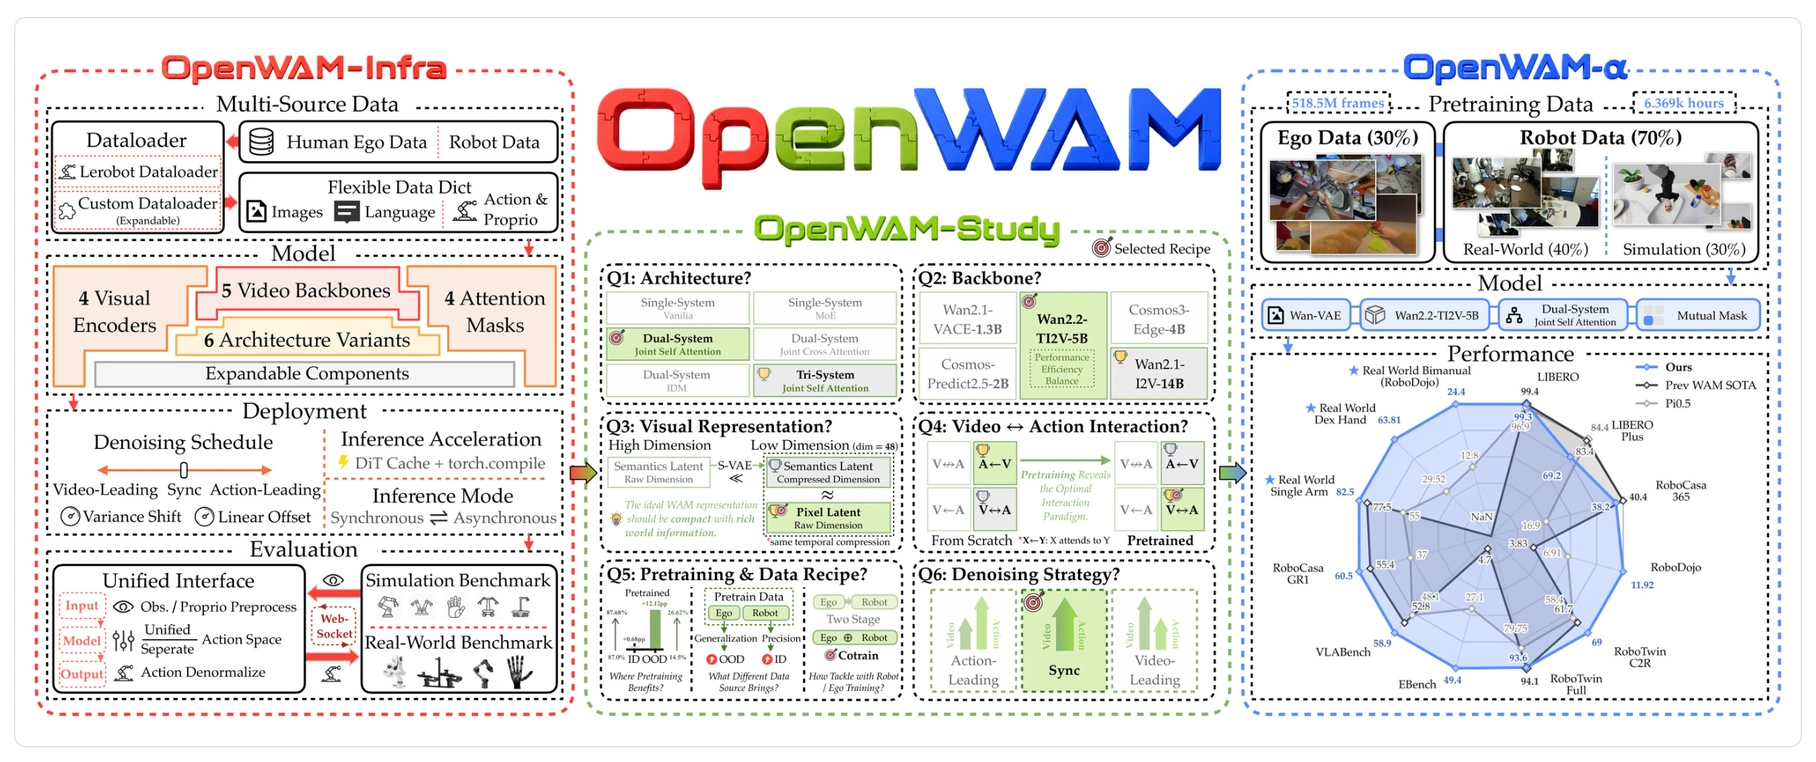
| OpenWAM | 系统对照 WAM 架构、Backbone、表征、注意力与 Ego 训练方式 | Joint Attention、像素 Latent 与 co-training 的效果更好;更多大量结论见论文 |
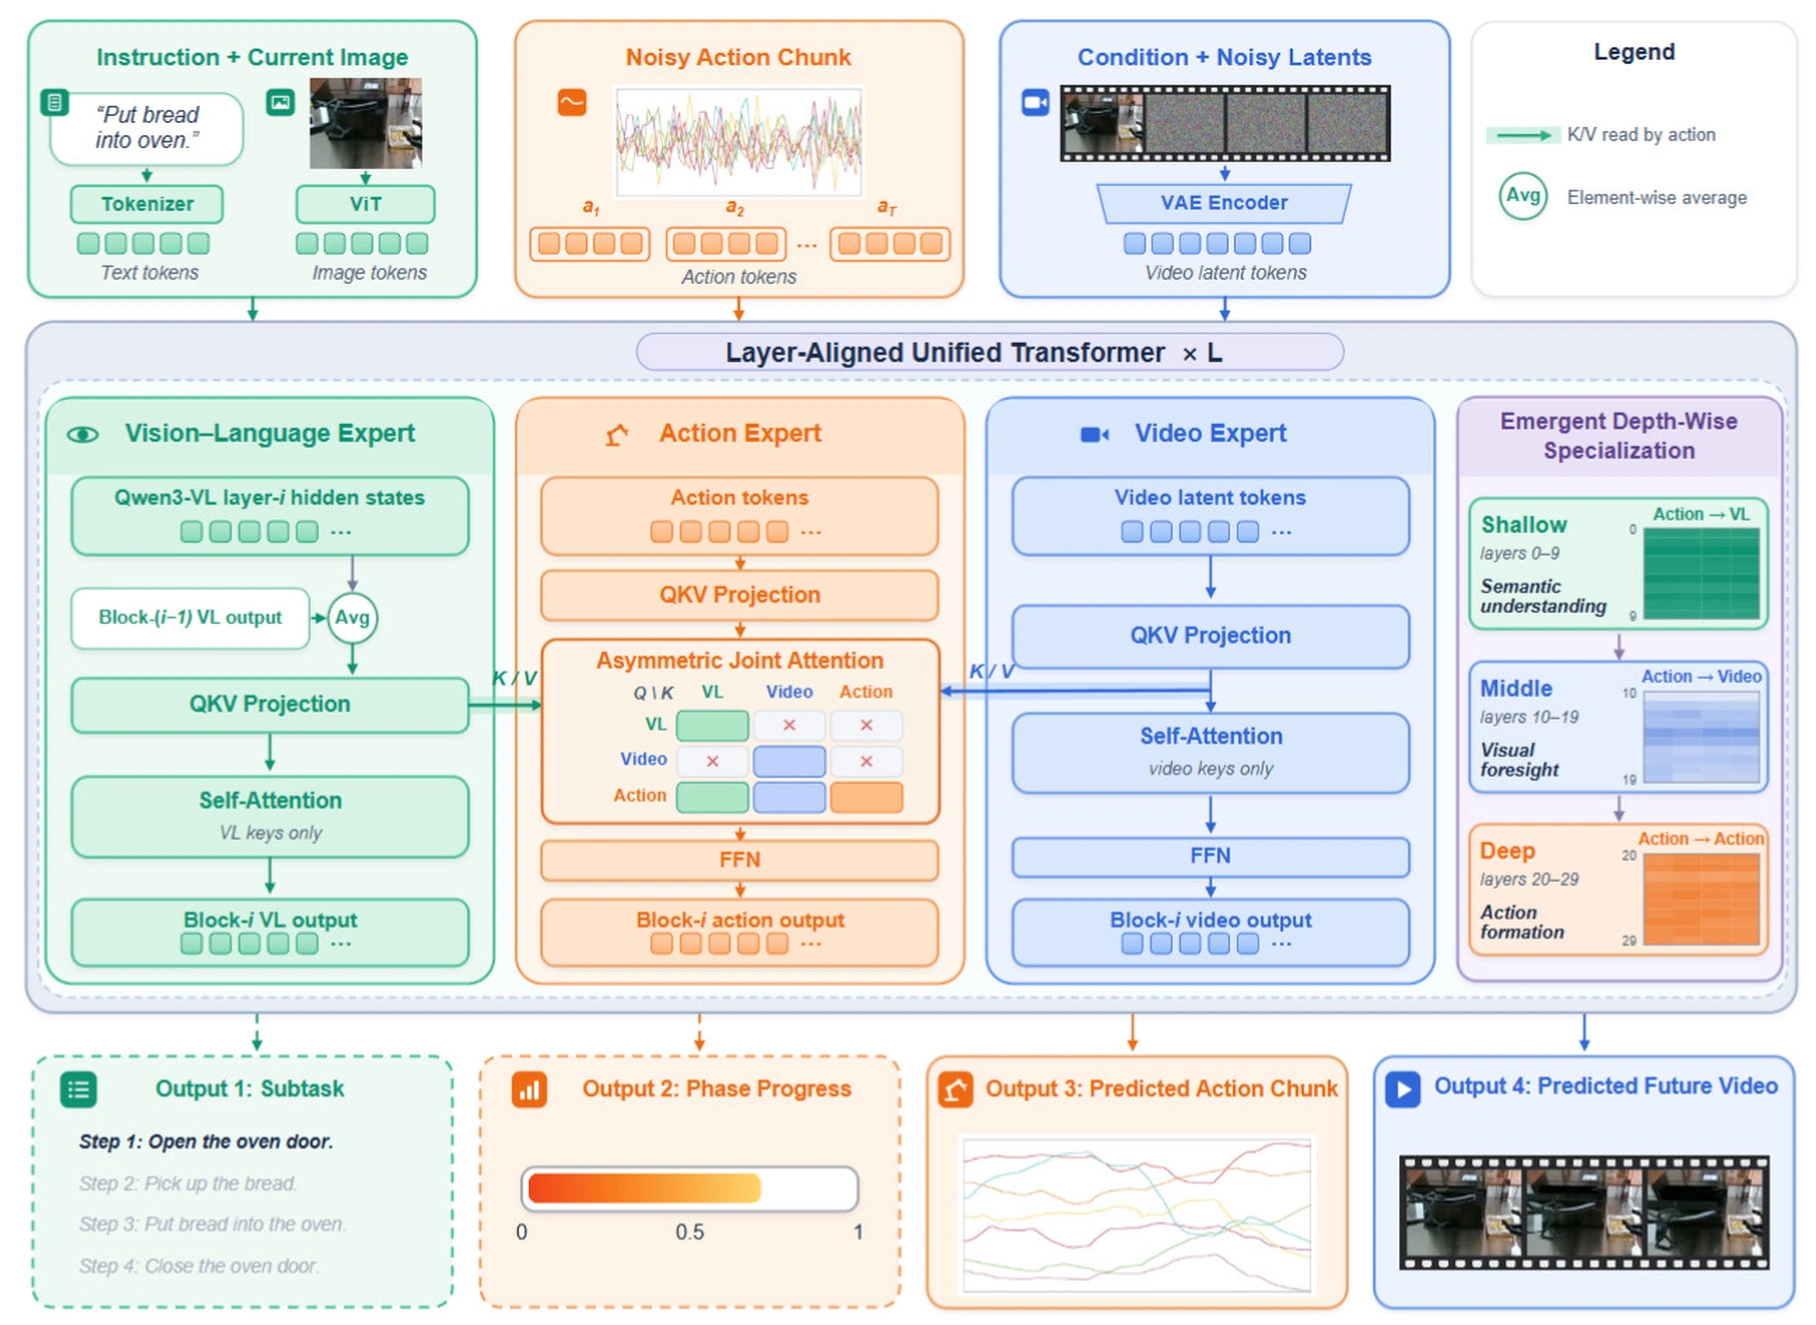
| EWAM | 研究 Qwen、Wan 与 Actor 之间逐层的注意力交互 | 注意力逐层从视觉语言偏向视频,再偏向动作,值得参考其跨模块交互与对齐方式。 |
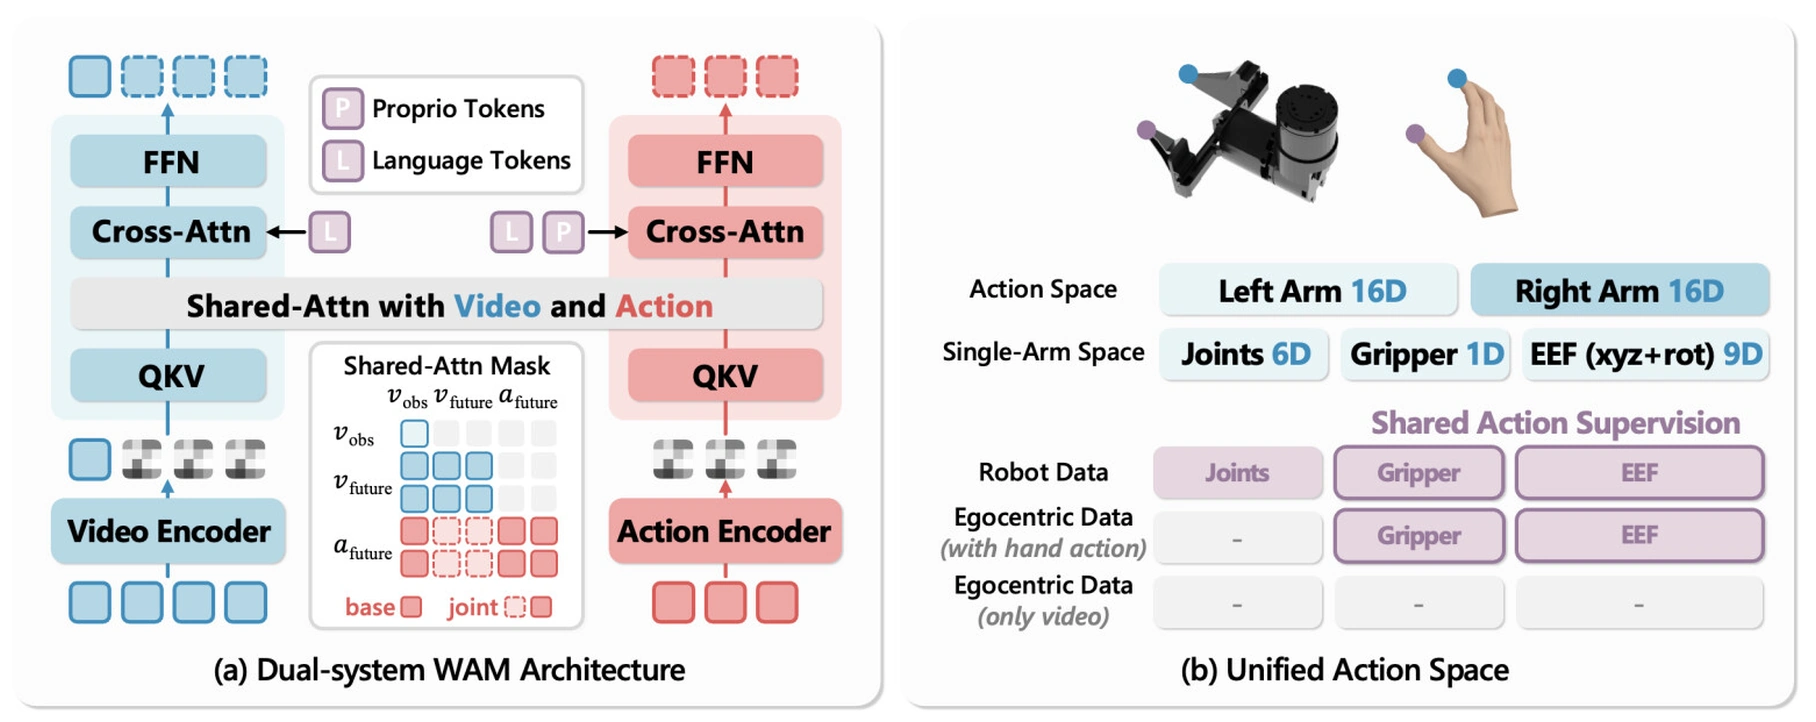
| Ego4WAM | 对照 Ego 视频、动作标注与 WM/Actor 的分阶段训练方式 | 先视频预训练,再引入人类动作监督及未来 Latent;人类数据预训练改善 WAM 的 few-shot 效果。 |
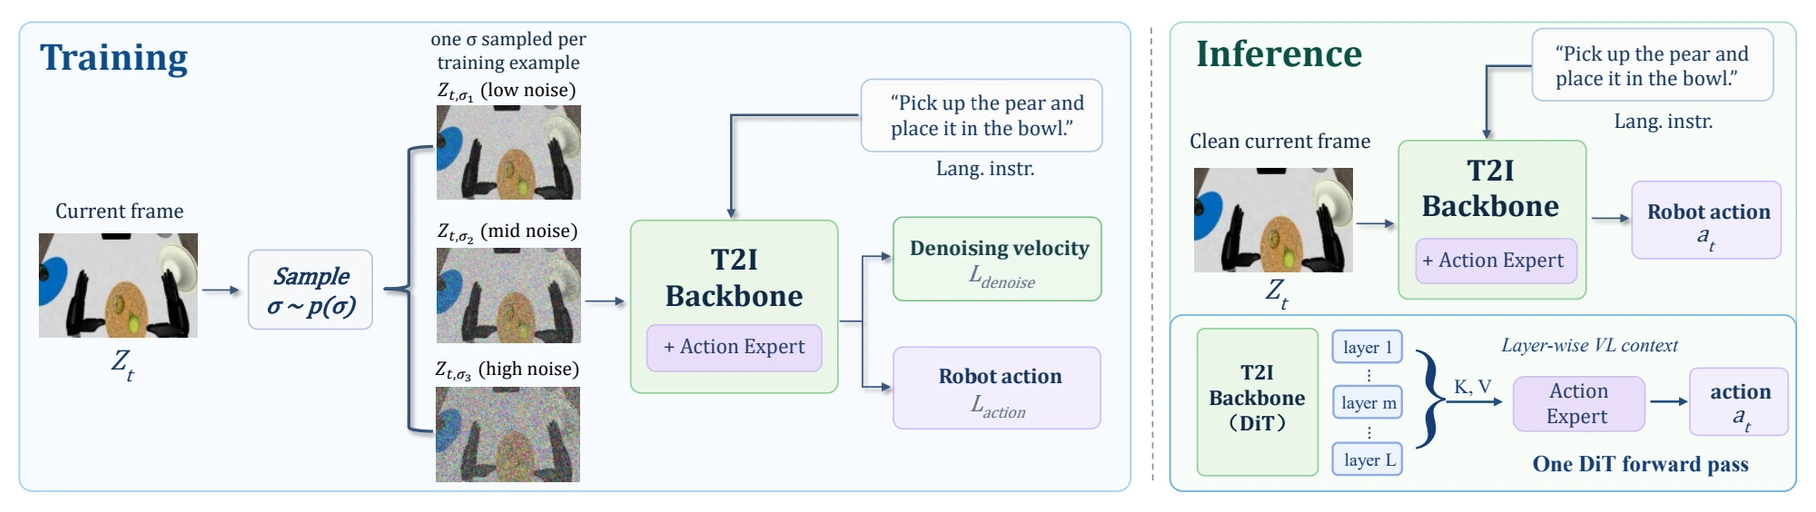
| NowWAM | 用 T2I 主干重建带噪当前帧,对照后训练中的未来预测 | 后训练中预测 history 和 future 的效果差不多,使用 Noise Current 来 denoise 作为任务利用图像监督获得较好效果;局限于后训练 |
其他#
| 论文 | 方案 | 结论 |
|---|---|---|
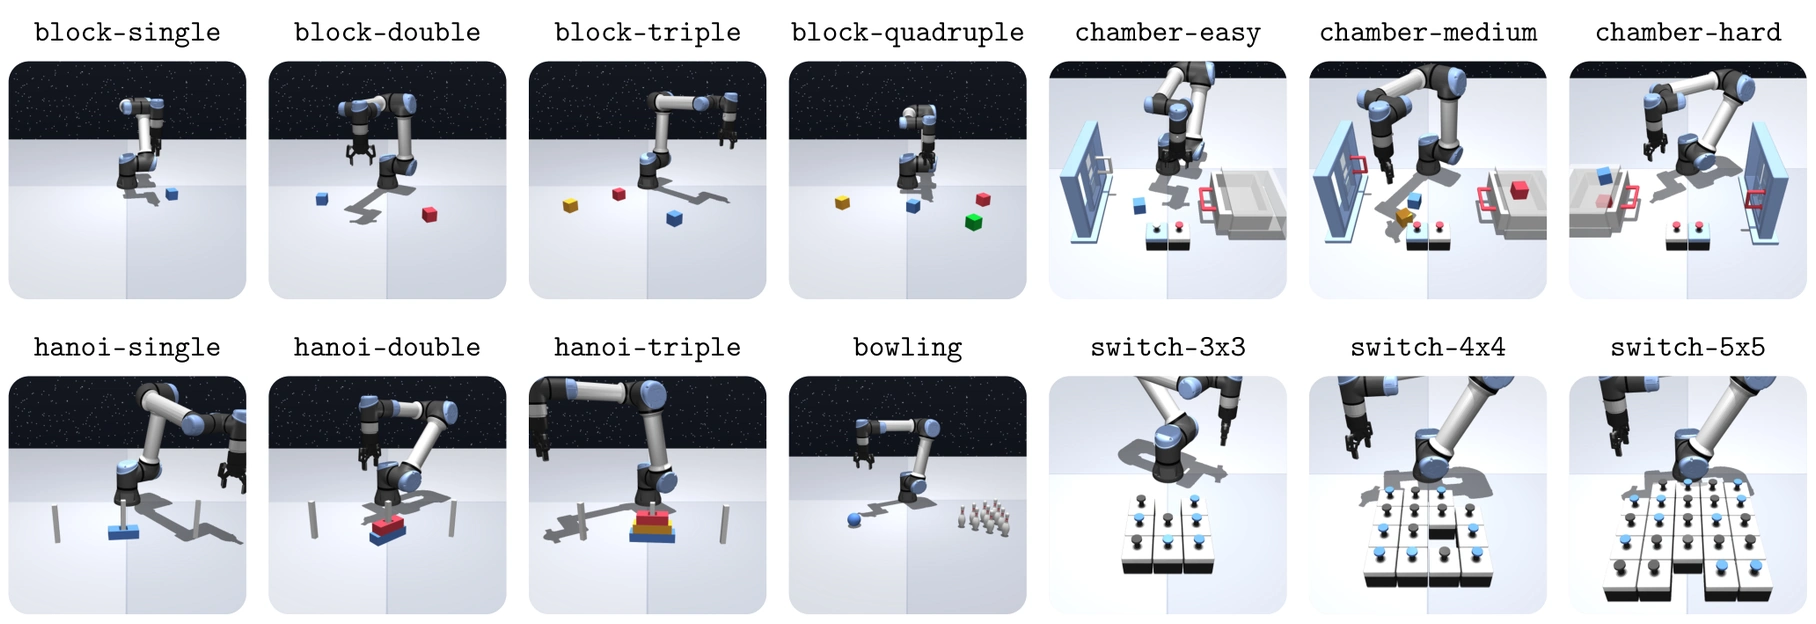
| BC Mystery | 在更接近人类采集分布的环境中,控制数据量研究 BC | 讨论过拟合、Action Chunk、网络规模与输入特征的反直觉现象;问题值得研究,目前还没有统一解释。 |
VLA Infra#
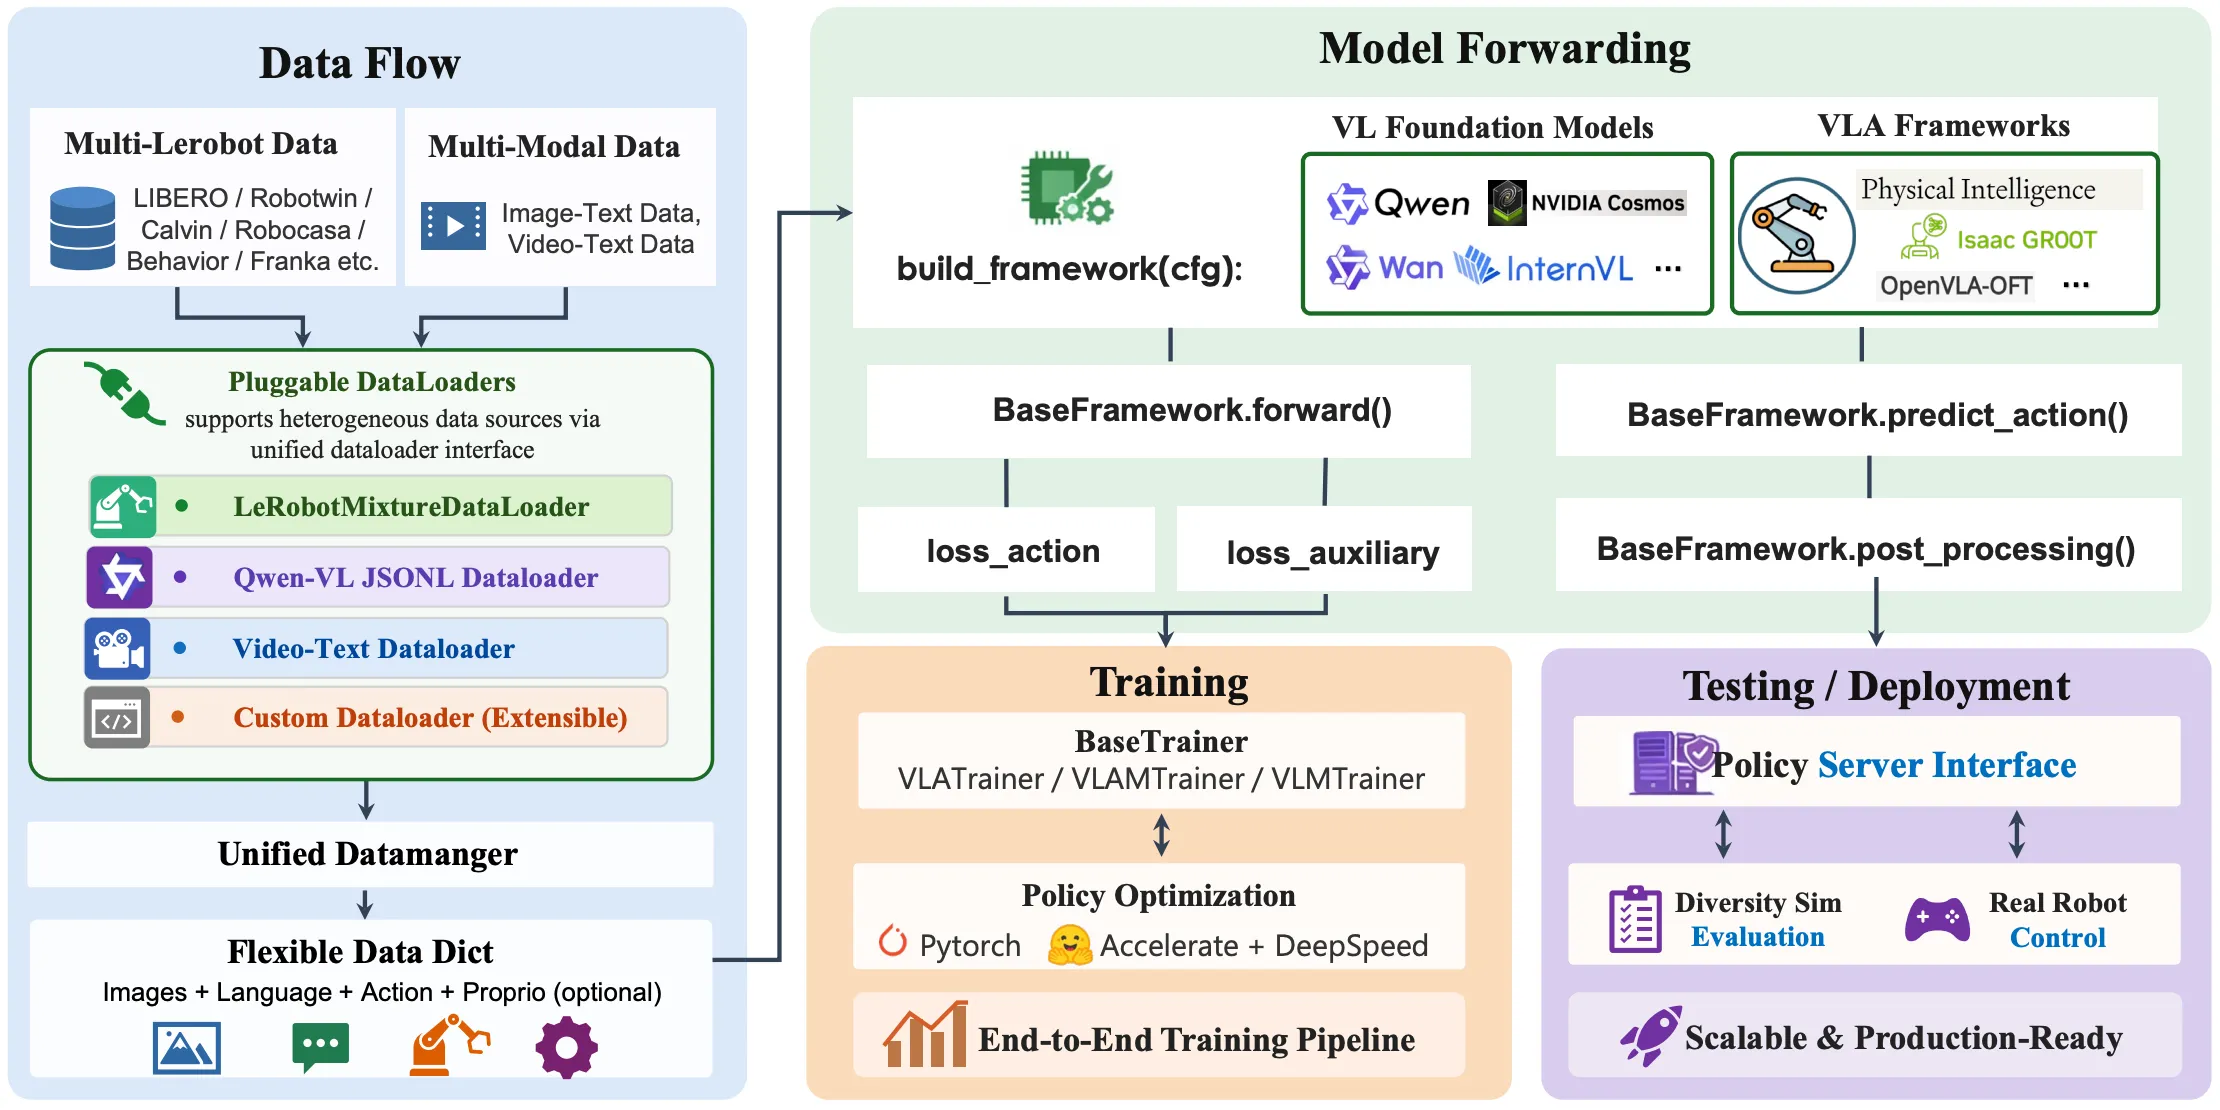
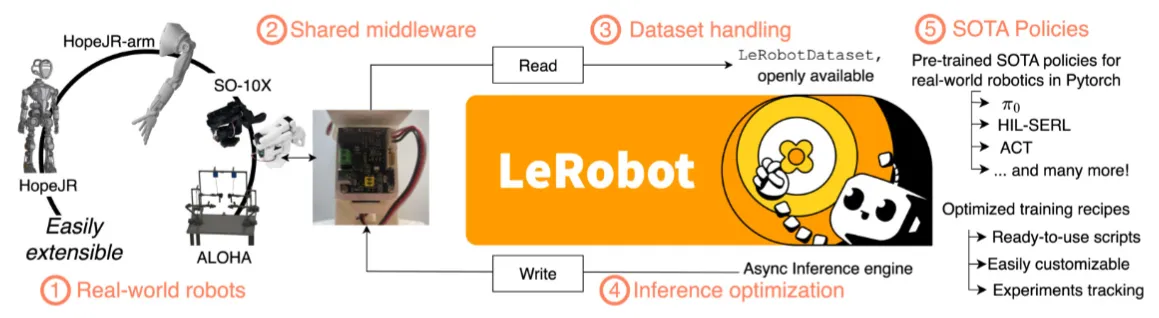
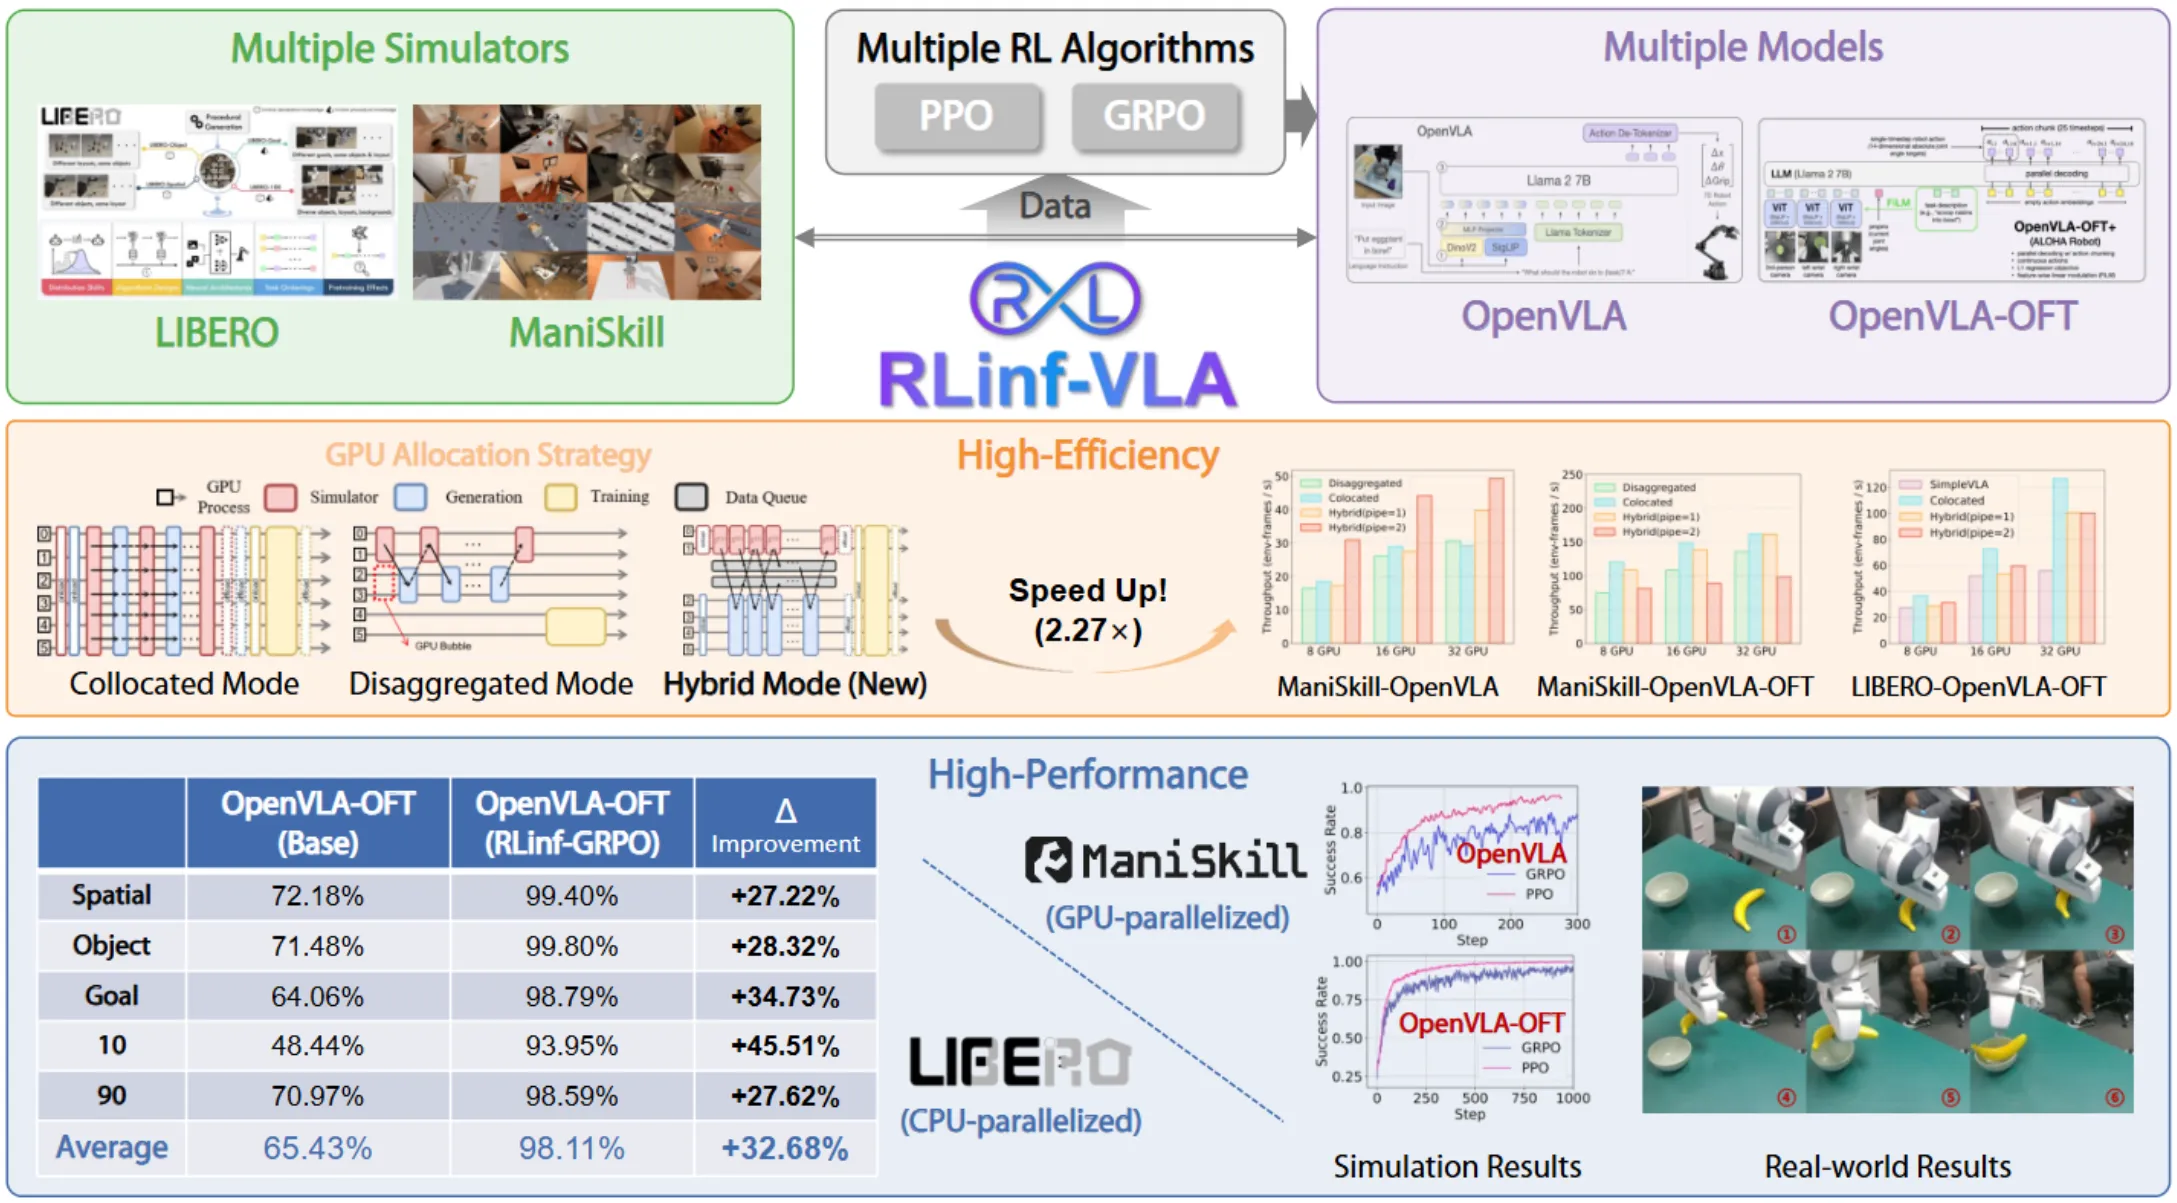
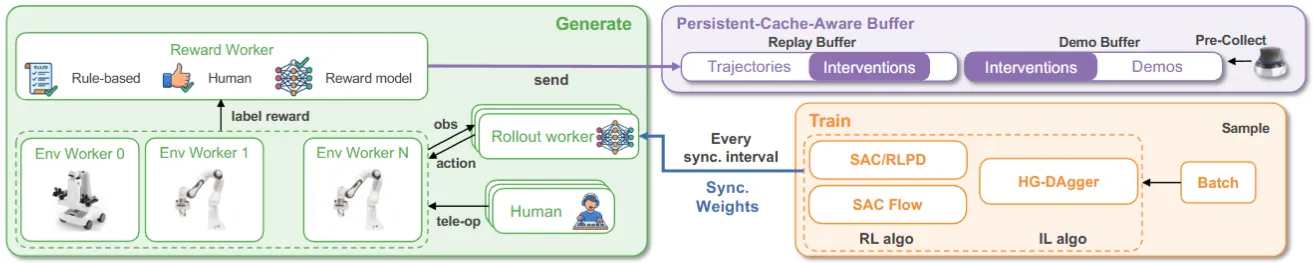
在 VLA 为时尚早的发展中,因为模型的体量较小,但是同时数据种类也有所区别,面临着不一样的模型生态,也存在不同的社区以及工作,尝试搭建 VLA Infra,并且发表他们的 Tech report。PI 也开源了 openpi,可以直接复现以及微调 系列的模型。
需要注意的是,在这一方面,所谓的 VLA Infra 本质上有别于大语言模型领域的 Infra。相关工作本身并不聚焦于,或者说暂时发展的情况使得其并不聚焦于性能的优化,而是仍然专注在如何构建一个更加通用的模型训练框架以及对应的测评系统。这使得用户可以在框架中仅定义自己的模型结构,从而便捷地利用当前的数据与测评生态,对方法进行快速迭代和真机部署。本质其定位更加接近于 MM-Detection 而非 Megatron。
| 论文 | 主要贡献 |
|---|---|
| StarVLA | VLA 模型训练框架,训练测试一体,支持很多内容,目前算是最流行的框架 |
| LeRobot | HuggingFace LeRobot 技术报告 |
| RLinf-VLA | RLinf RL 框架 |
| RLinf-USER | RLinf 的真机 RL 基建 |
| LWD | SII + Finch AgiBot 出品的离线 + 在线强化学习框架 |
触觉/力控模型#
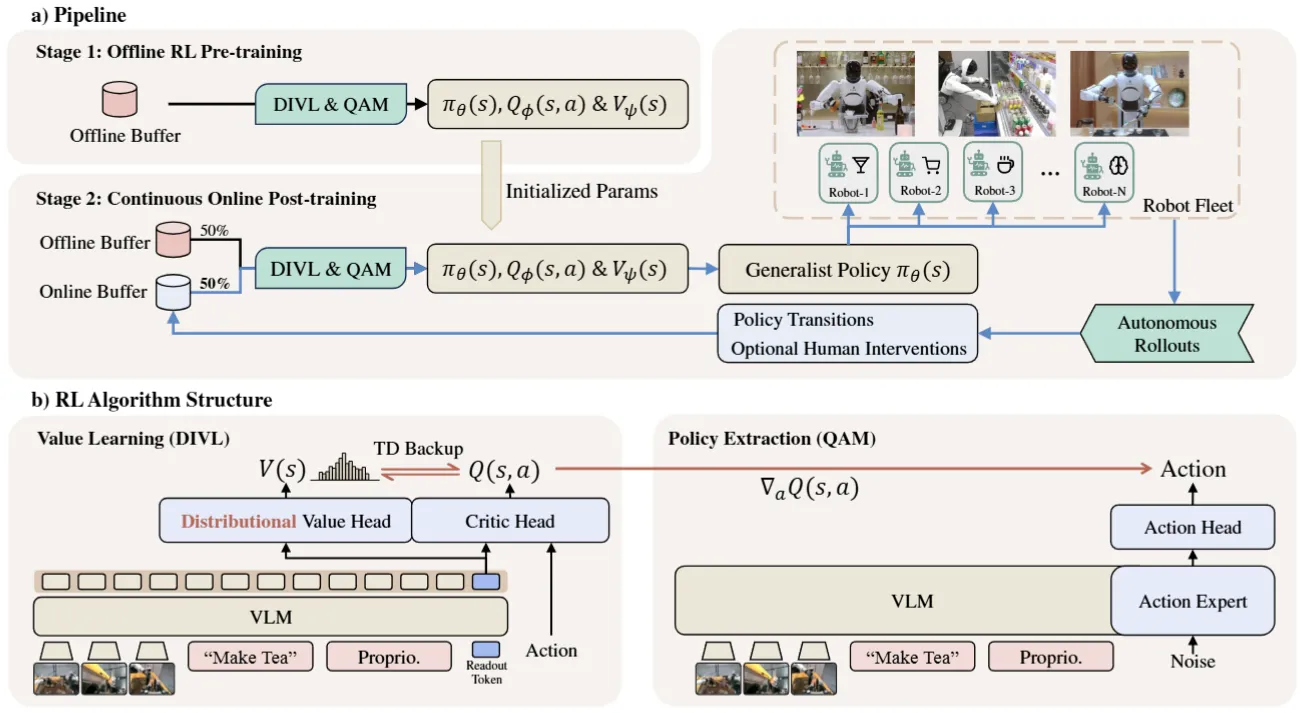
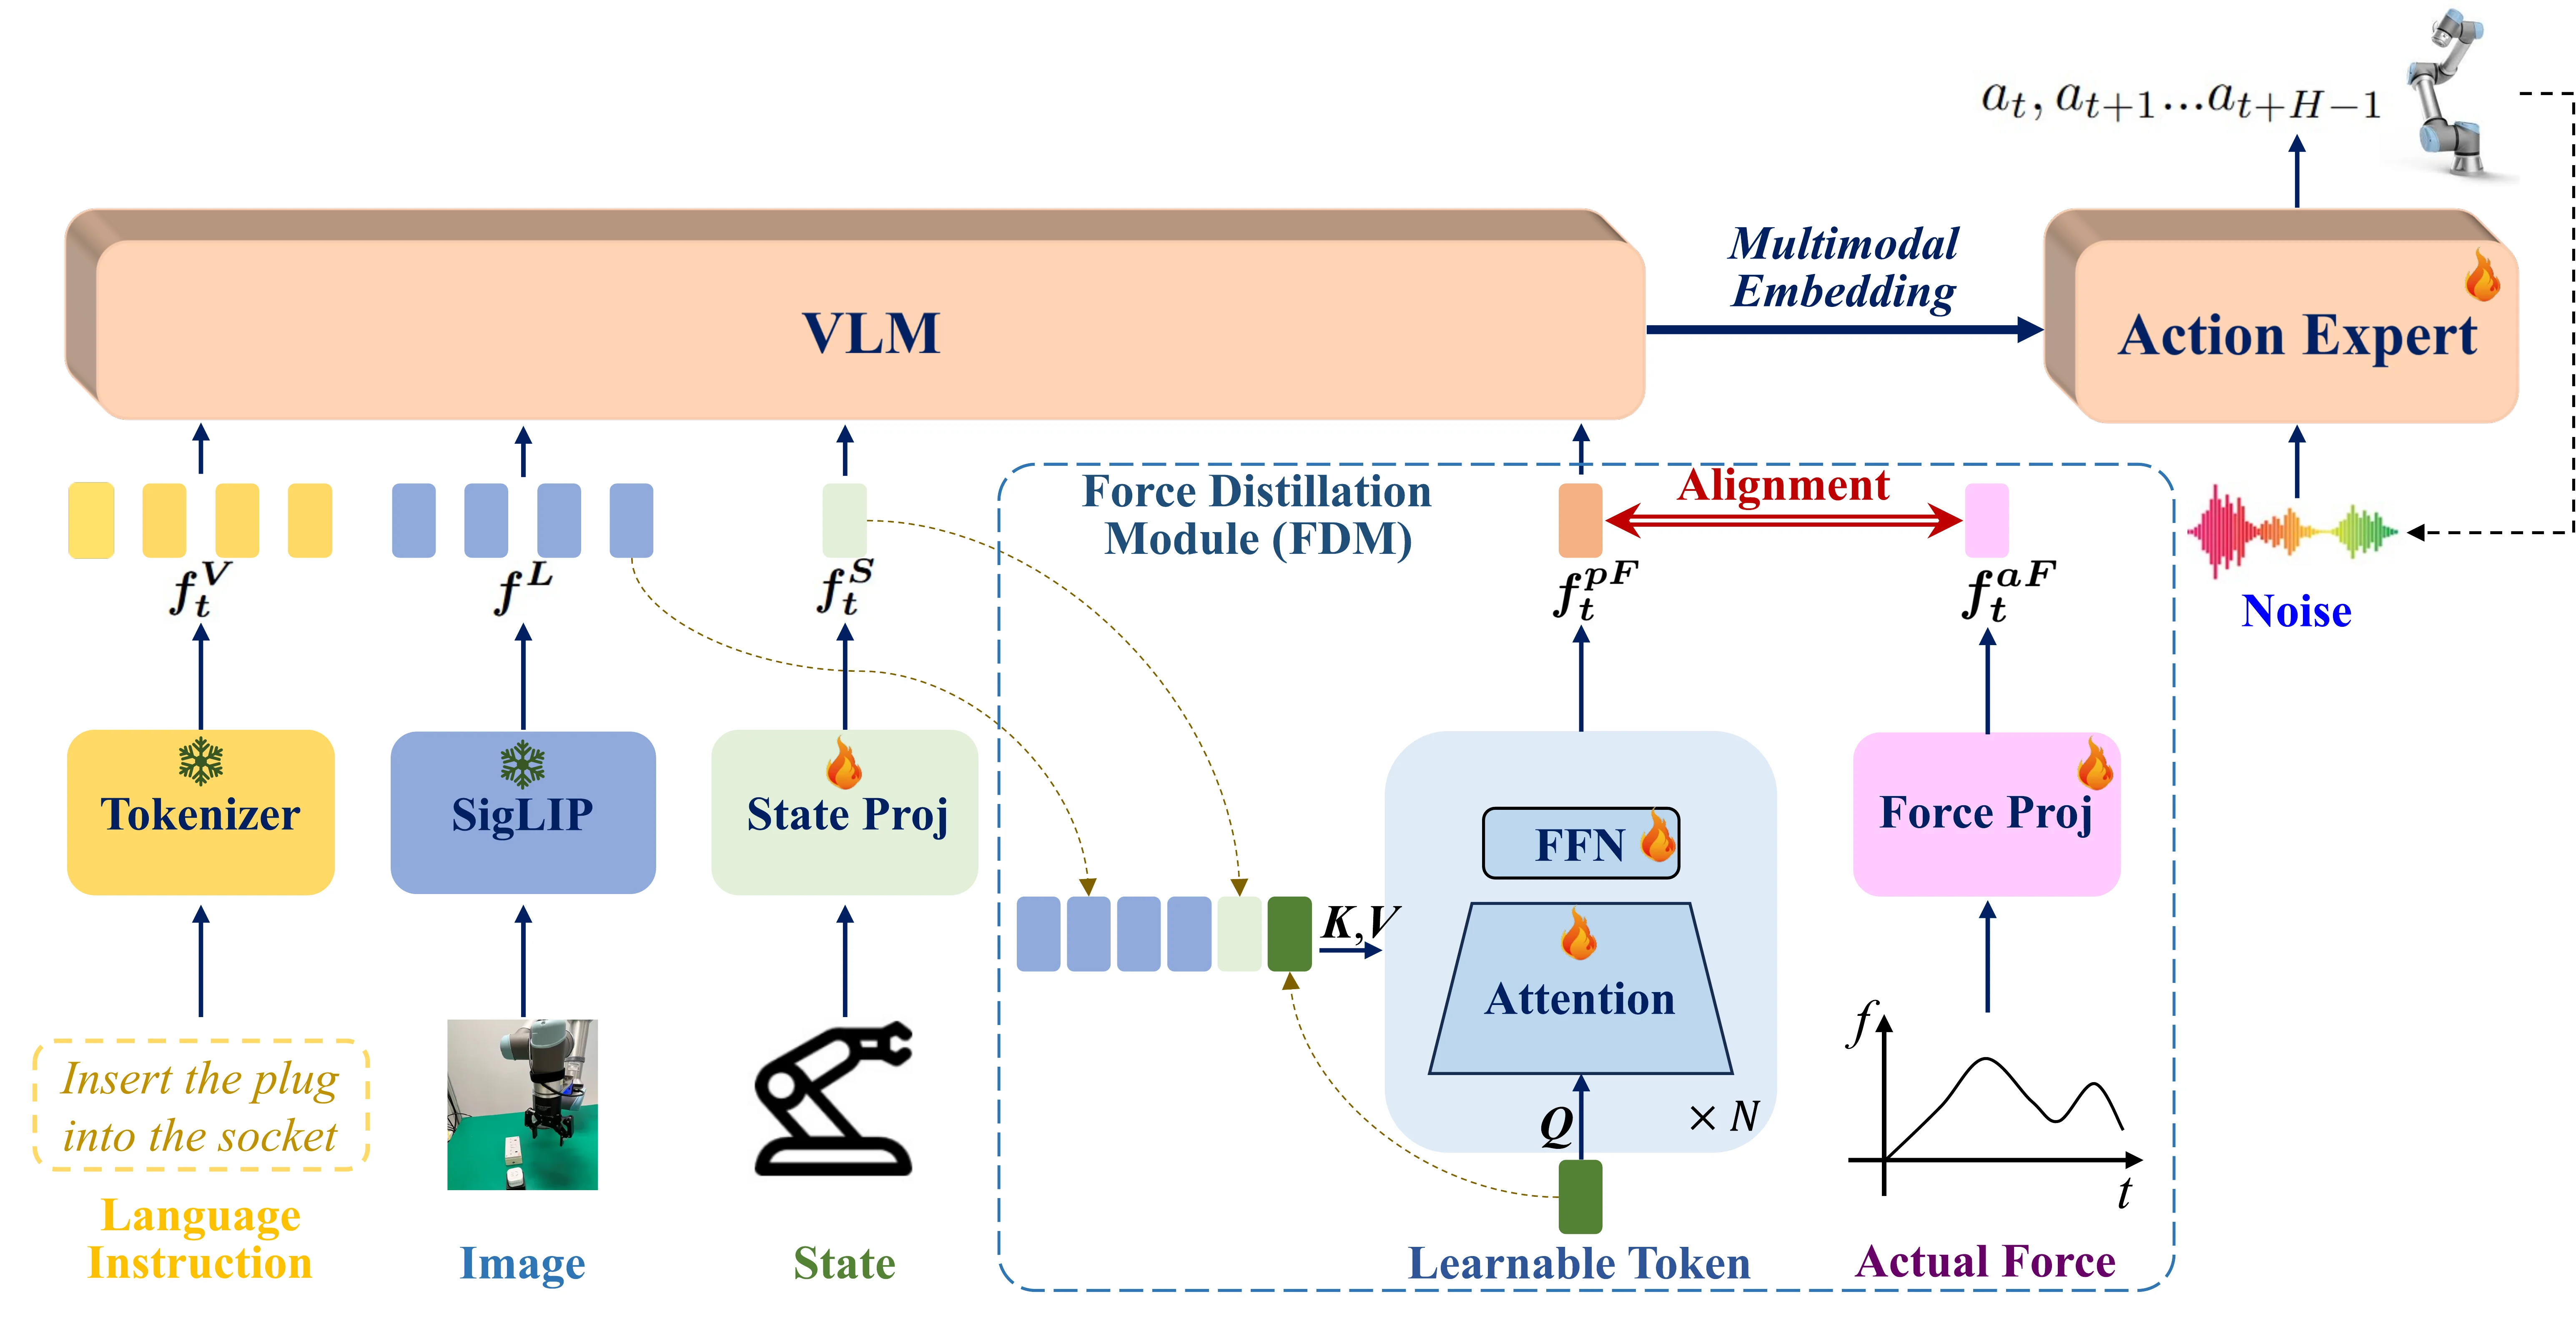
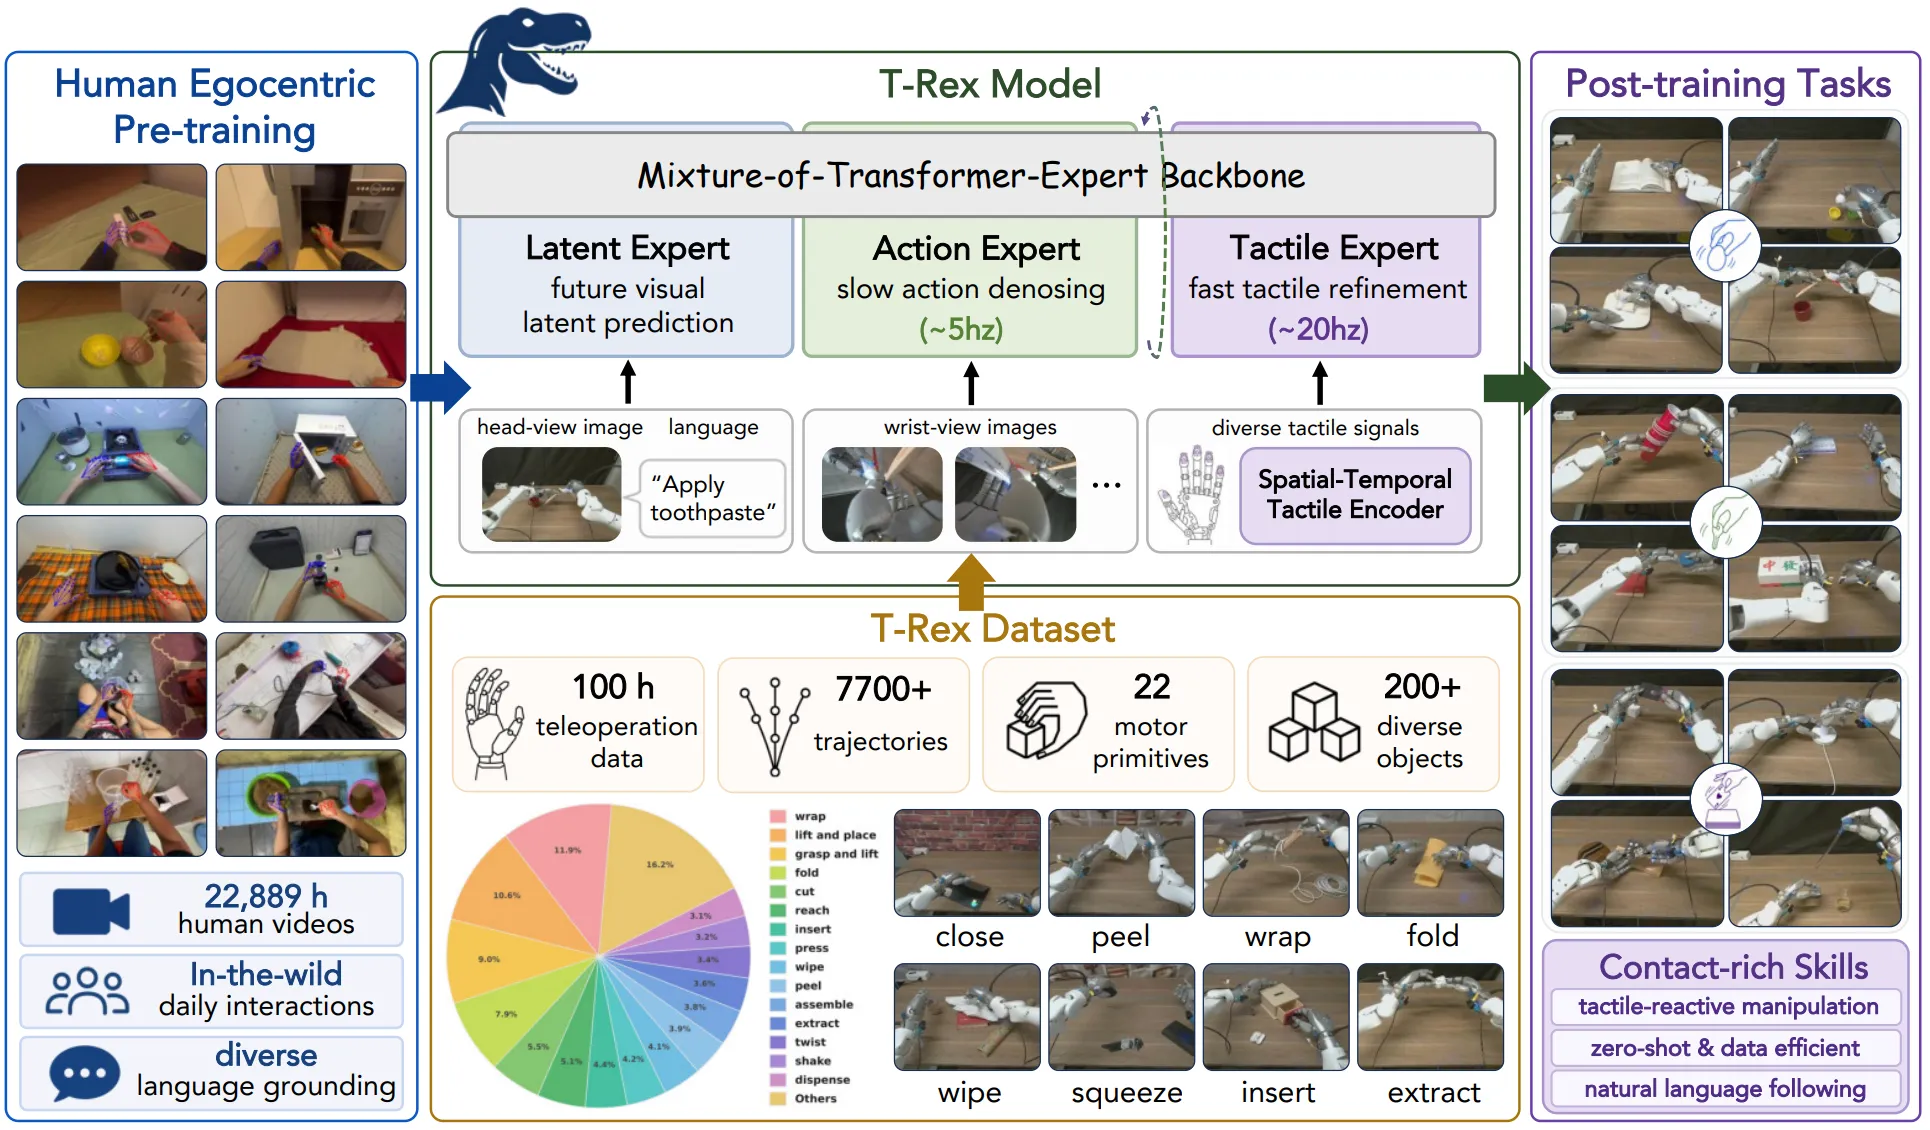
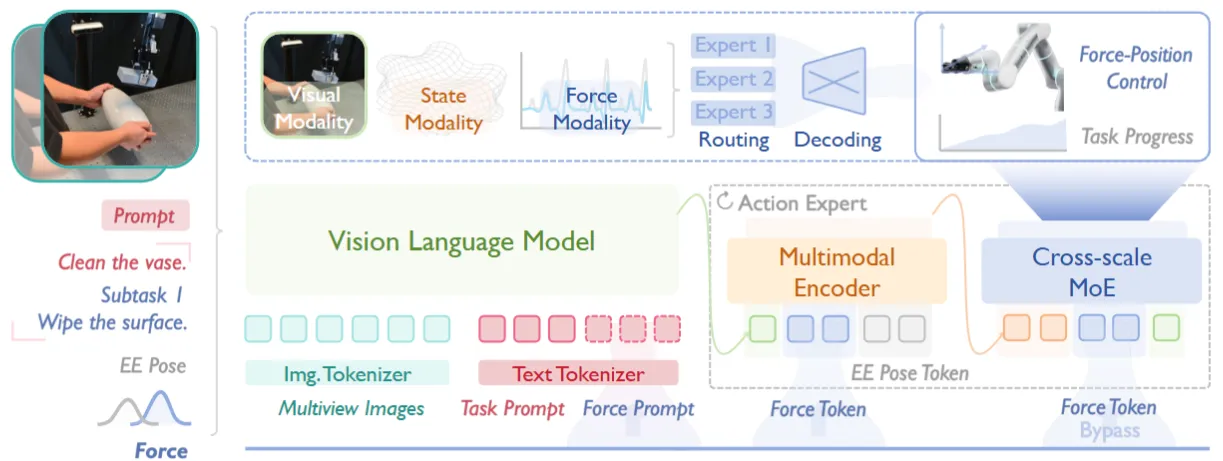
一些模型在使用 VLA Data 之外,也尝试引入更加 Rich Annotation 的数据,其中比较在机器人学中热门且被认为有效的就是使用触觉数据,在这方面也有做出相当可观的探索,比较早的如 ForceVLA,用力感知的 MoE 将力觉融入 。
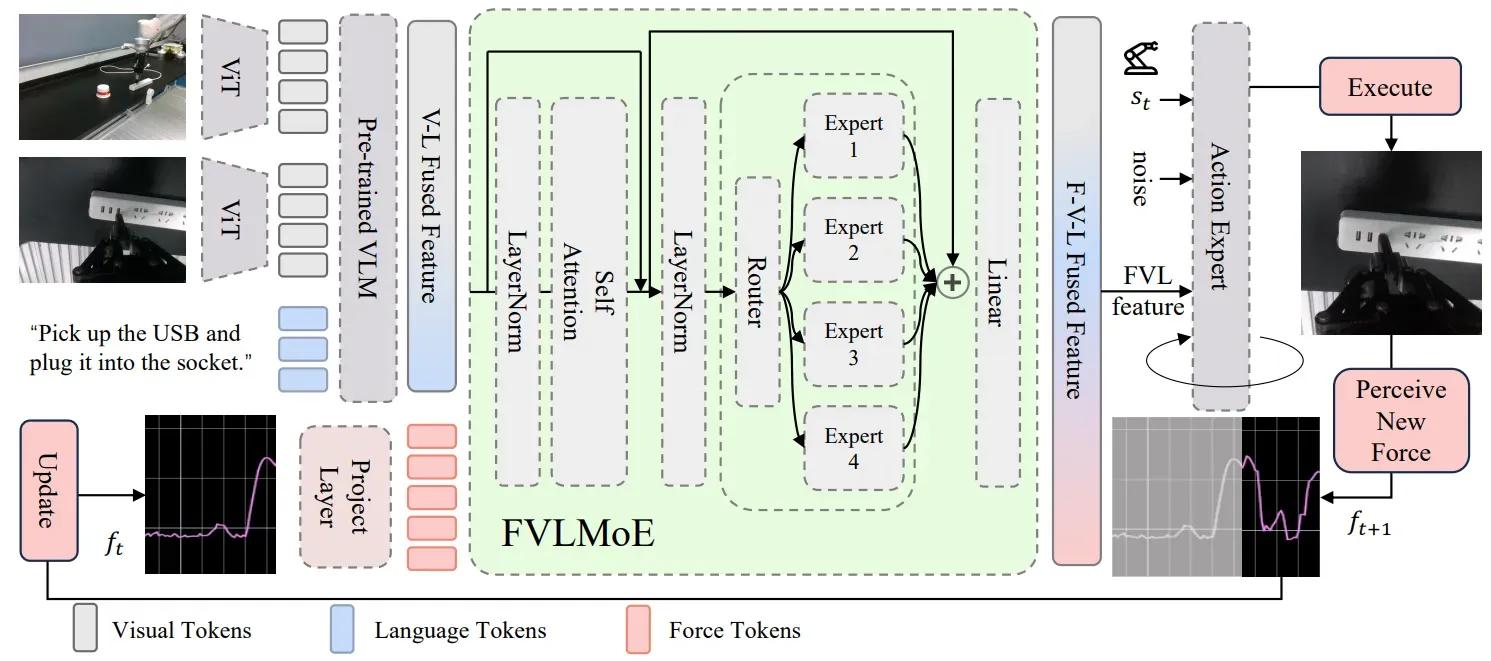
如今,大量从带有触觉的夹爪和灵巧手,甚至 UMI 中采集的数据,被大量使用在模型训练过程中,并且期望在将来的发展后,能得到一些更加属于触觉的具体提升。
| 论文 | 主要贡献 |
|---|---|
| FD-VLA | 在训练时从图像 + 状态蒸馏出 force token,可无力传感器部署 |
| T-Rex | Latent WM Expert + Slow Actor + Fast Tac Expert 的 MoT 预训练触觉输入模型,以及触觉数据集 |
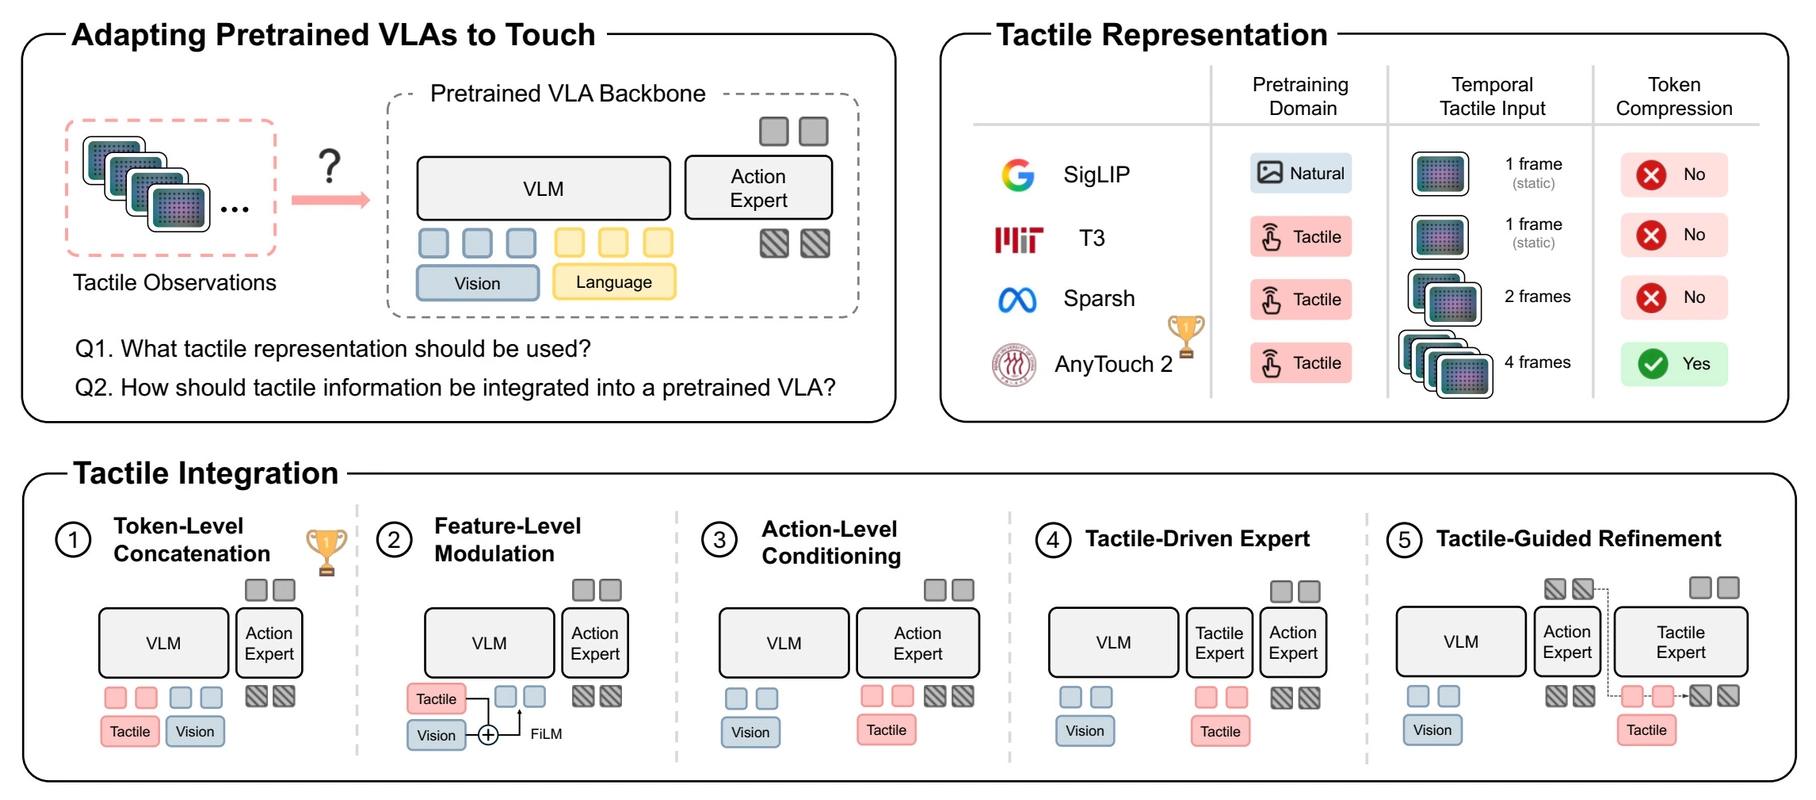
| OpenViTac | 系统对照如何给无触觉预训练的 VLA 接入触觉,包括图像化表征、融合位置与动作修正;结论主要针对后训练适配。 |
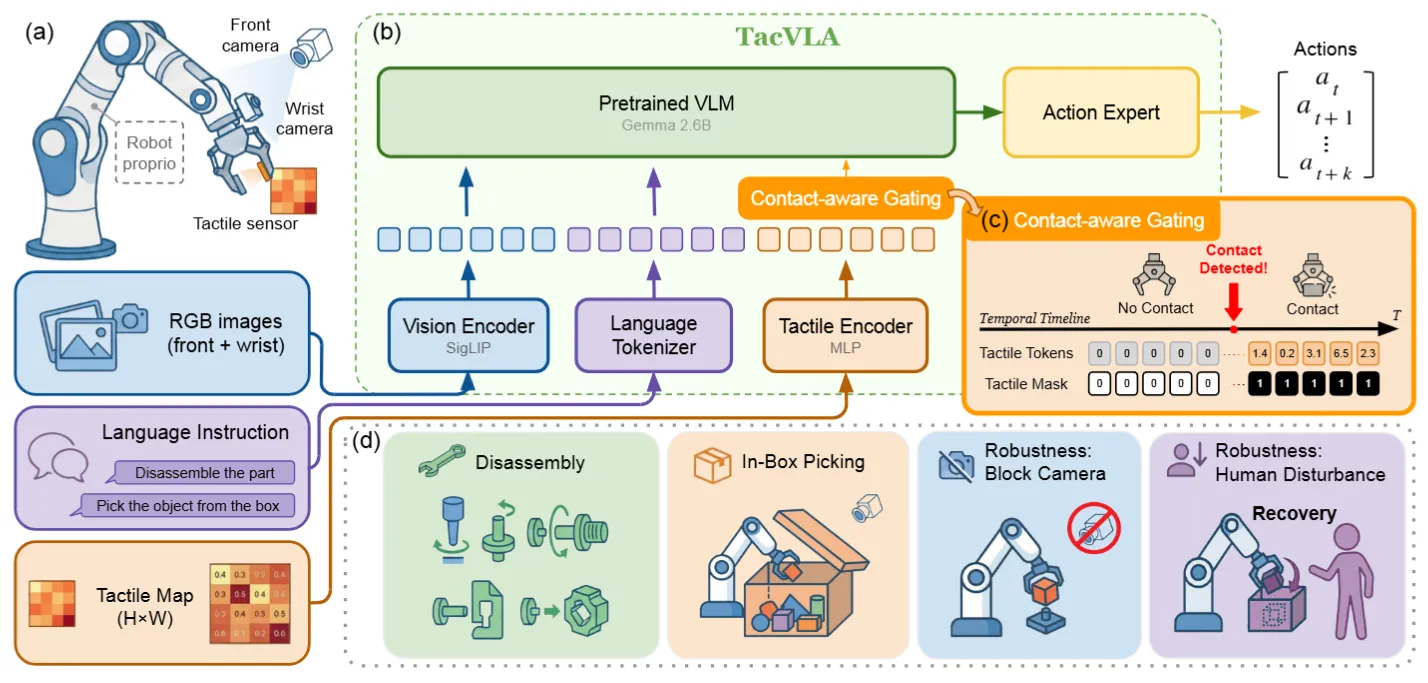
| TacVLA | 紧凑触觉 token + 接触感知 gating 的 PaliGemma VLA |
| ForceVLA2 | Cross-Scale MoE + 力 prompt 引导任务分解的 hybrid 力位 VLA |
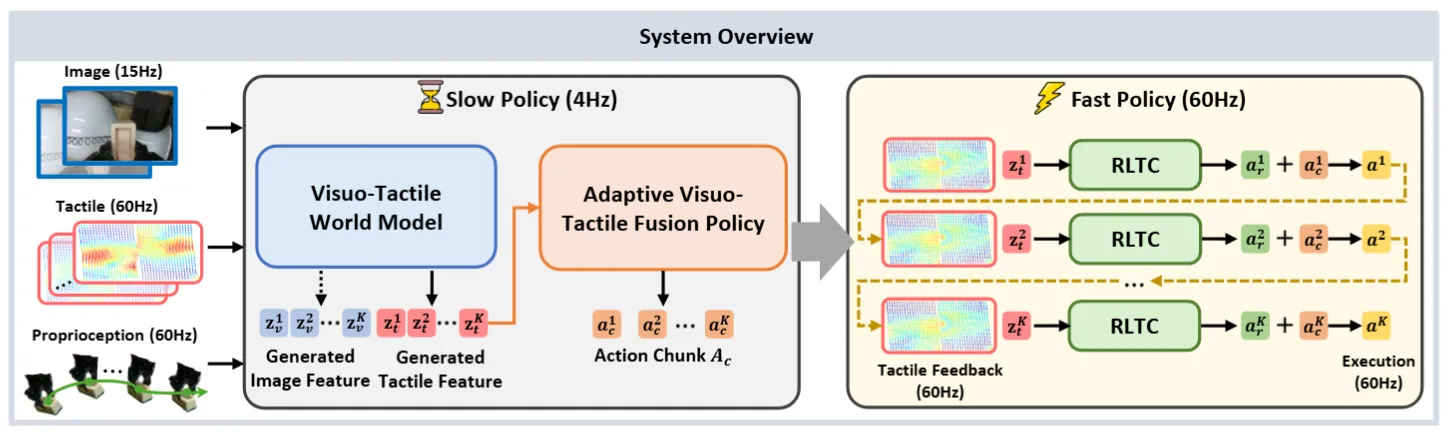
| OmniVTA | 训练 Tac Encoder,于慢系统 WM 同时预测 Visual 和 Tac,接 DiT,下游小模型快速纠正动作 |
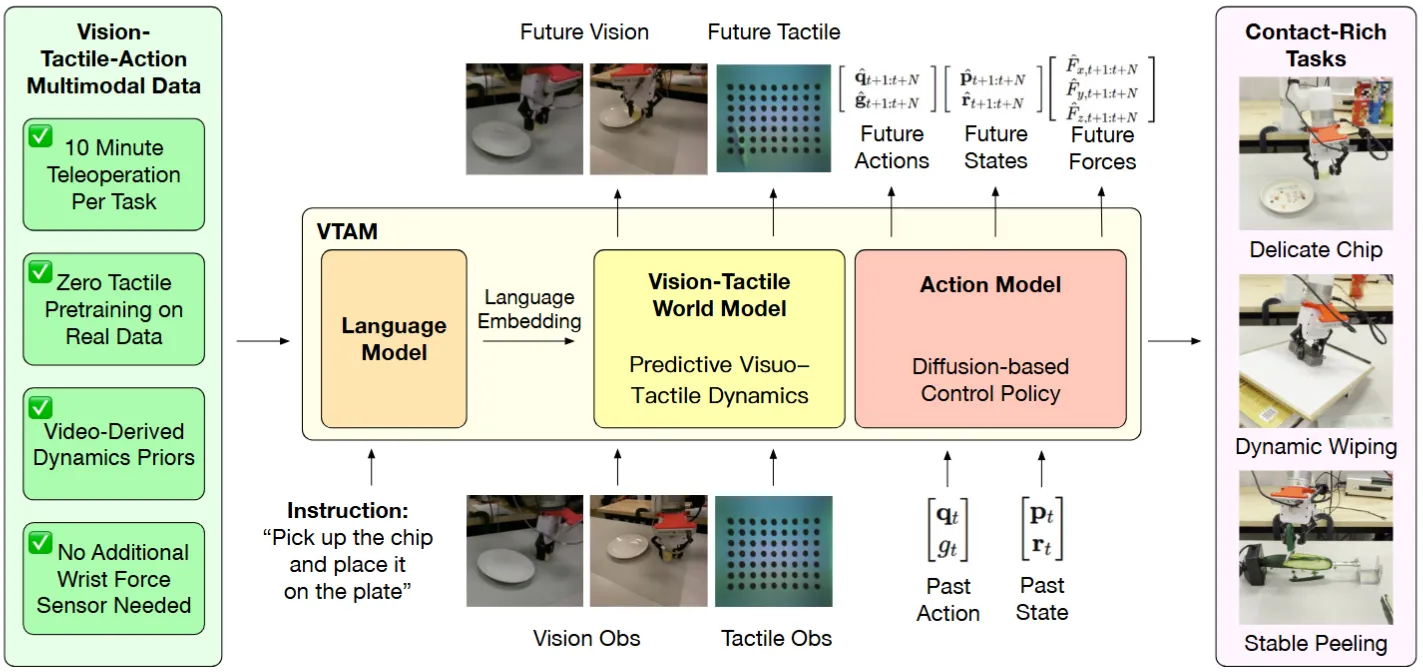
| VTAM | 使用 LM 输出 Embedding 之后 WM 预测 Visual + Tactile 接 Actor |
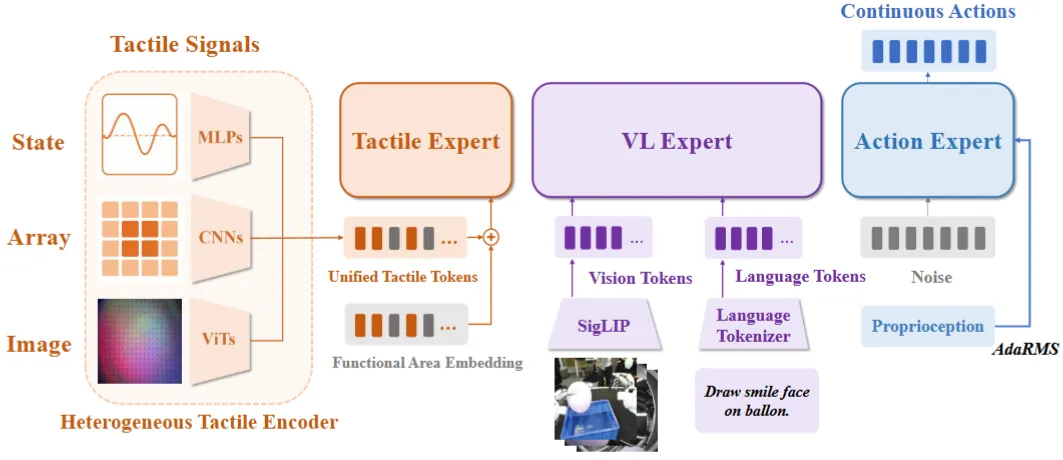
| FTP-1 | Tac Expert + VLM + Actor 的 MoT 预训练触觉输入模型,以及触觉数据集 |
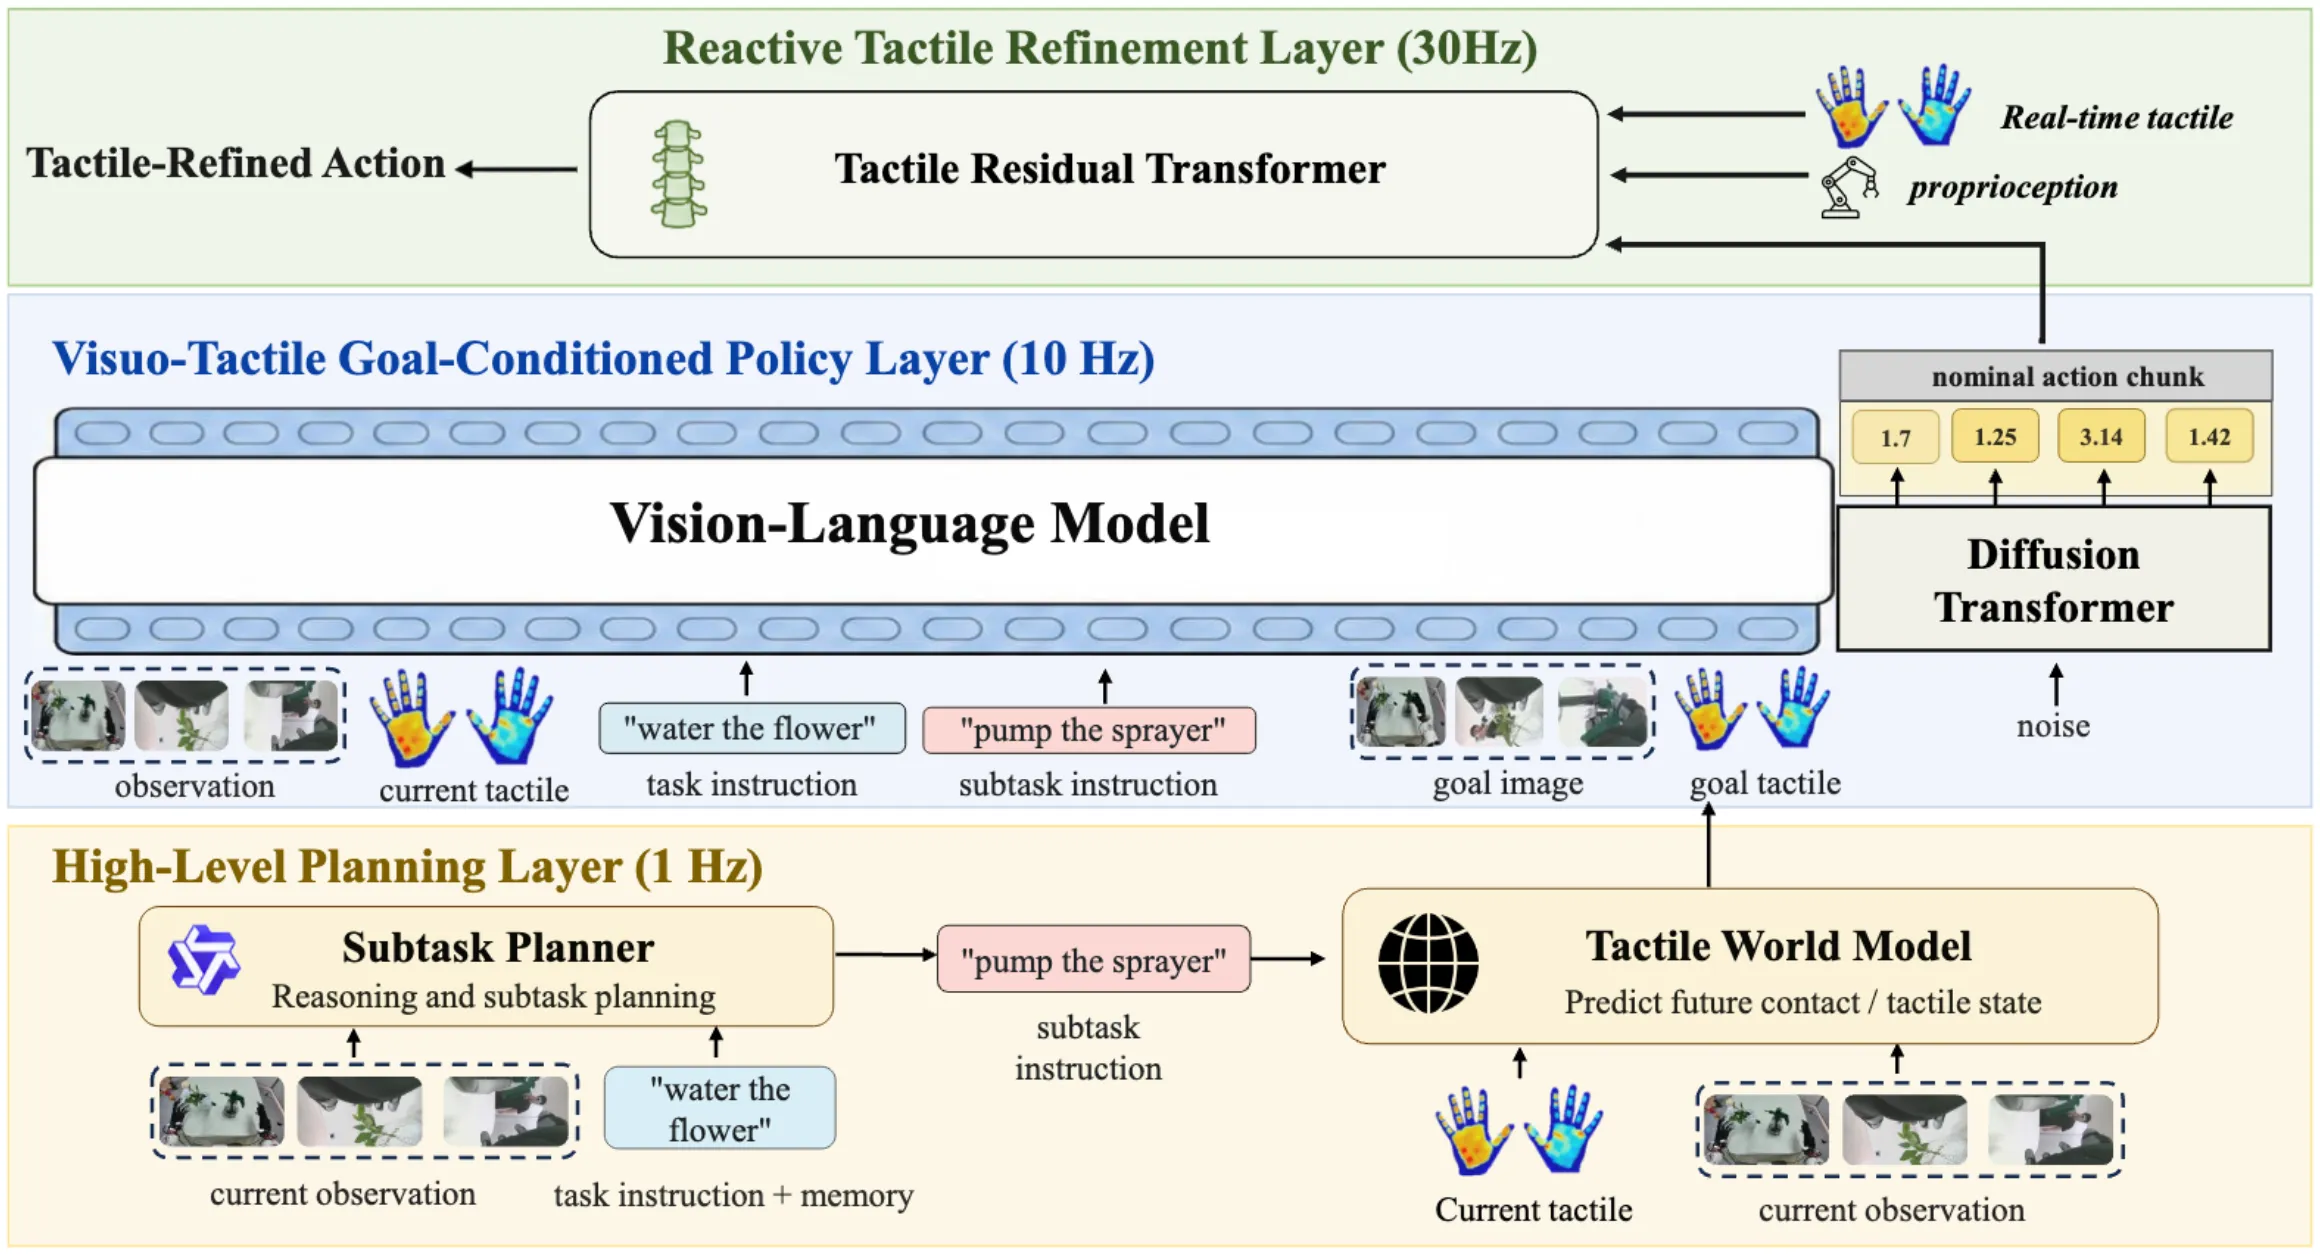
| TouchWorld | WM 预测 Goal Image + Tactile 的 System 2 + VLA System 1 + Tactile System 0 |
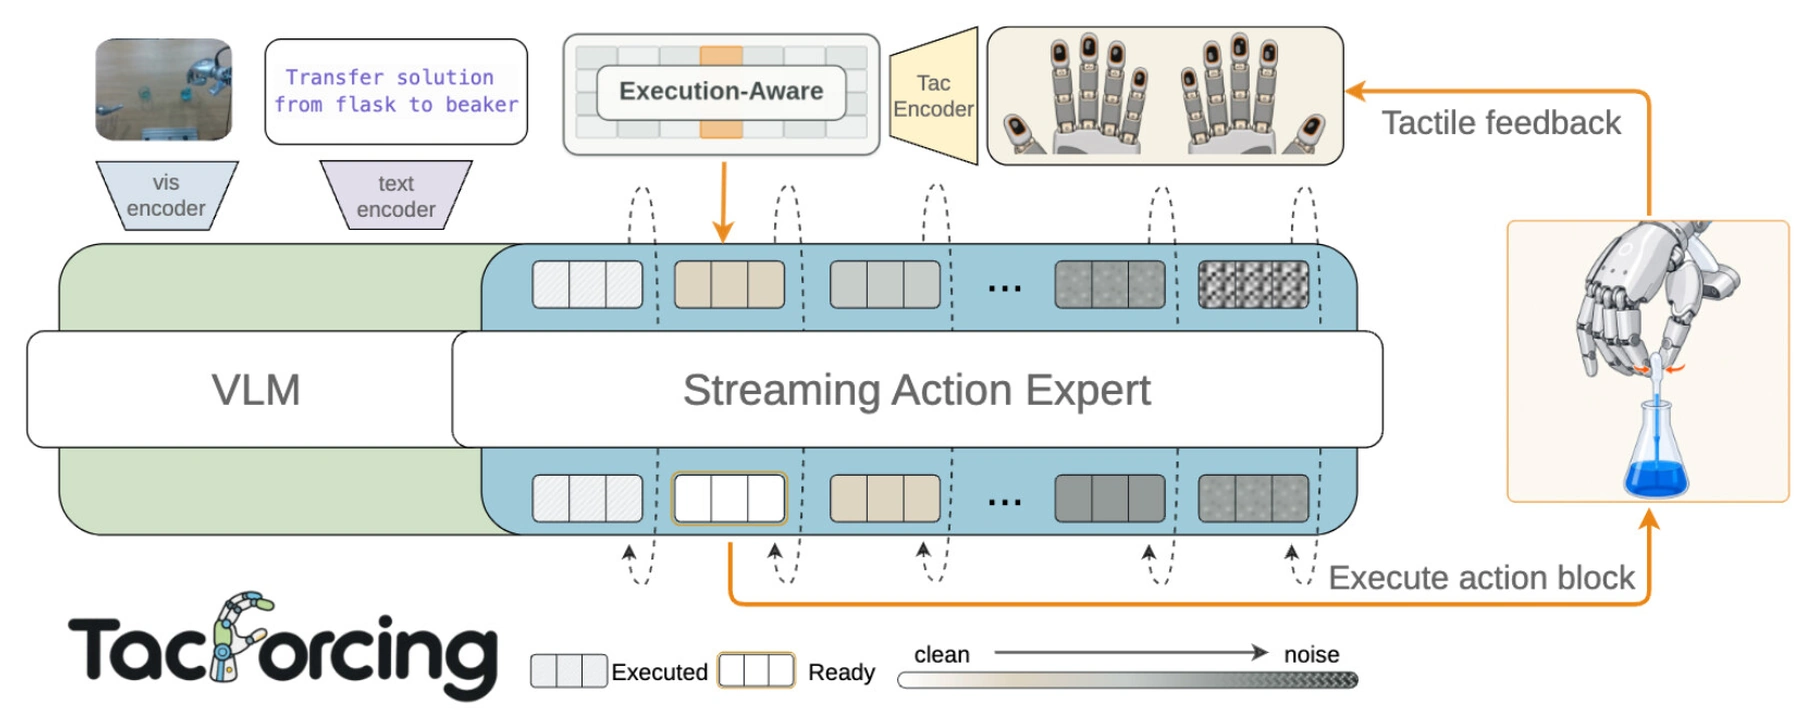
| TacForce | 流式 Action Expert 进行实时力反馈动作预测 |
In-context Learning#
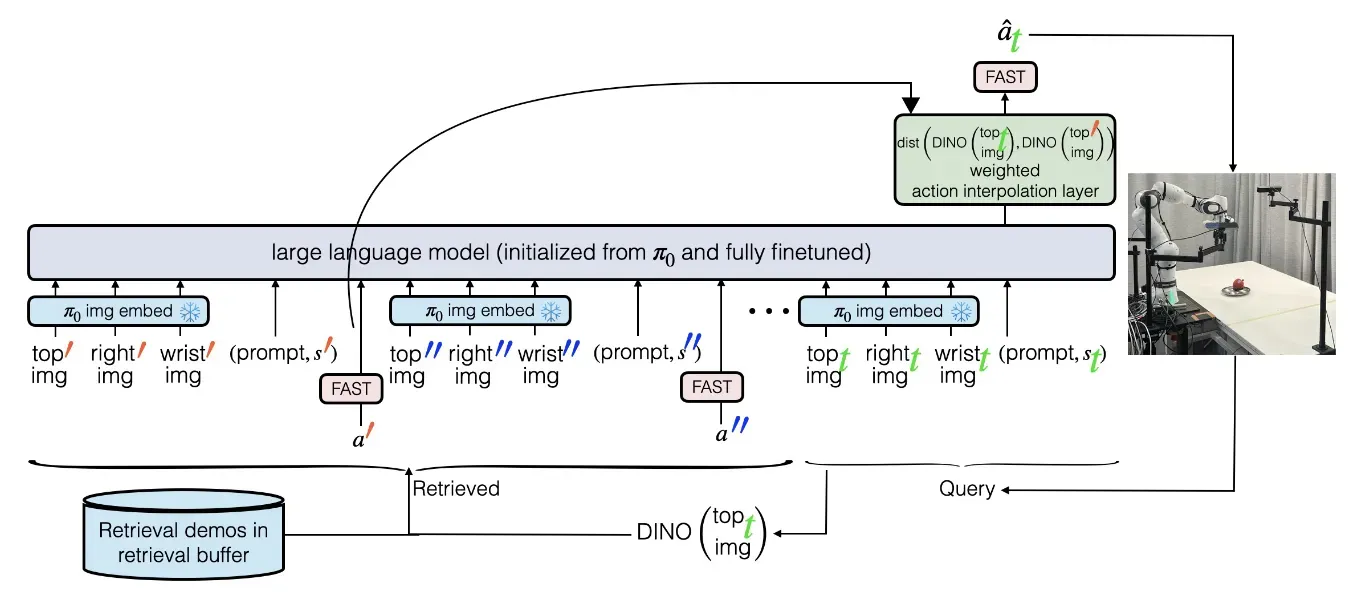
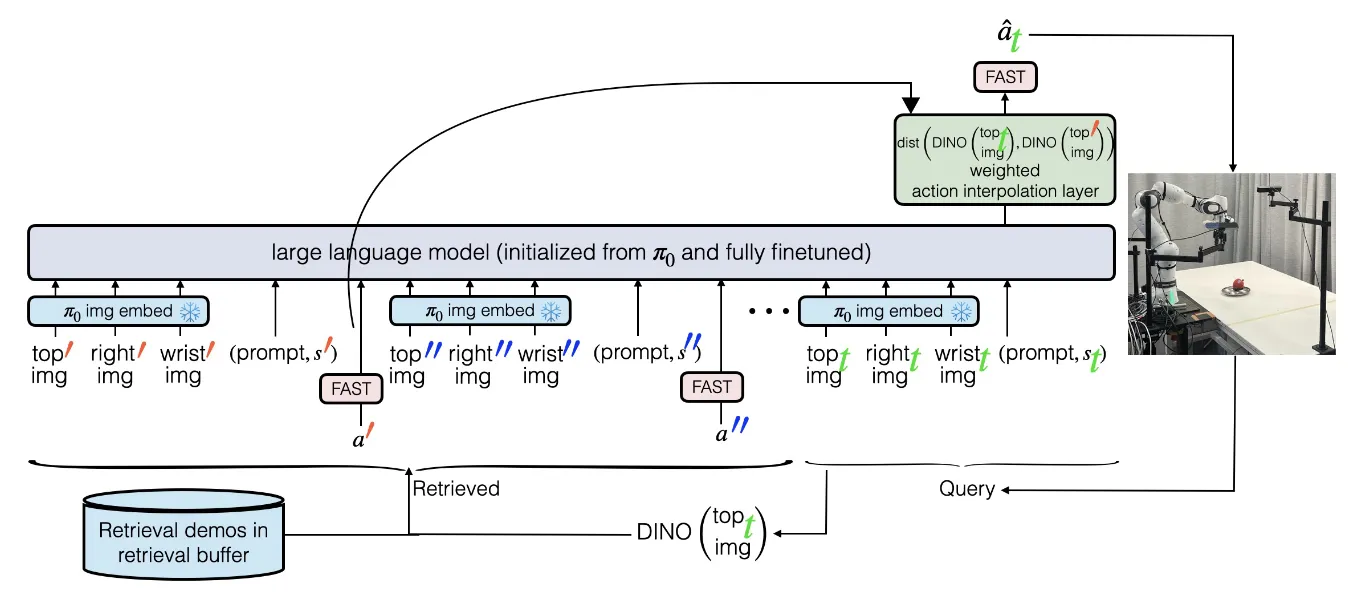
ICL 一直以来都是 Manipulation 领域不温不火的课题,我们认为它很重要,但是却并不是紧急的,一些学界的研究希望通过显式的范式构造来达到这一效果,比较早期的如 RICL。
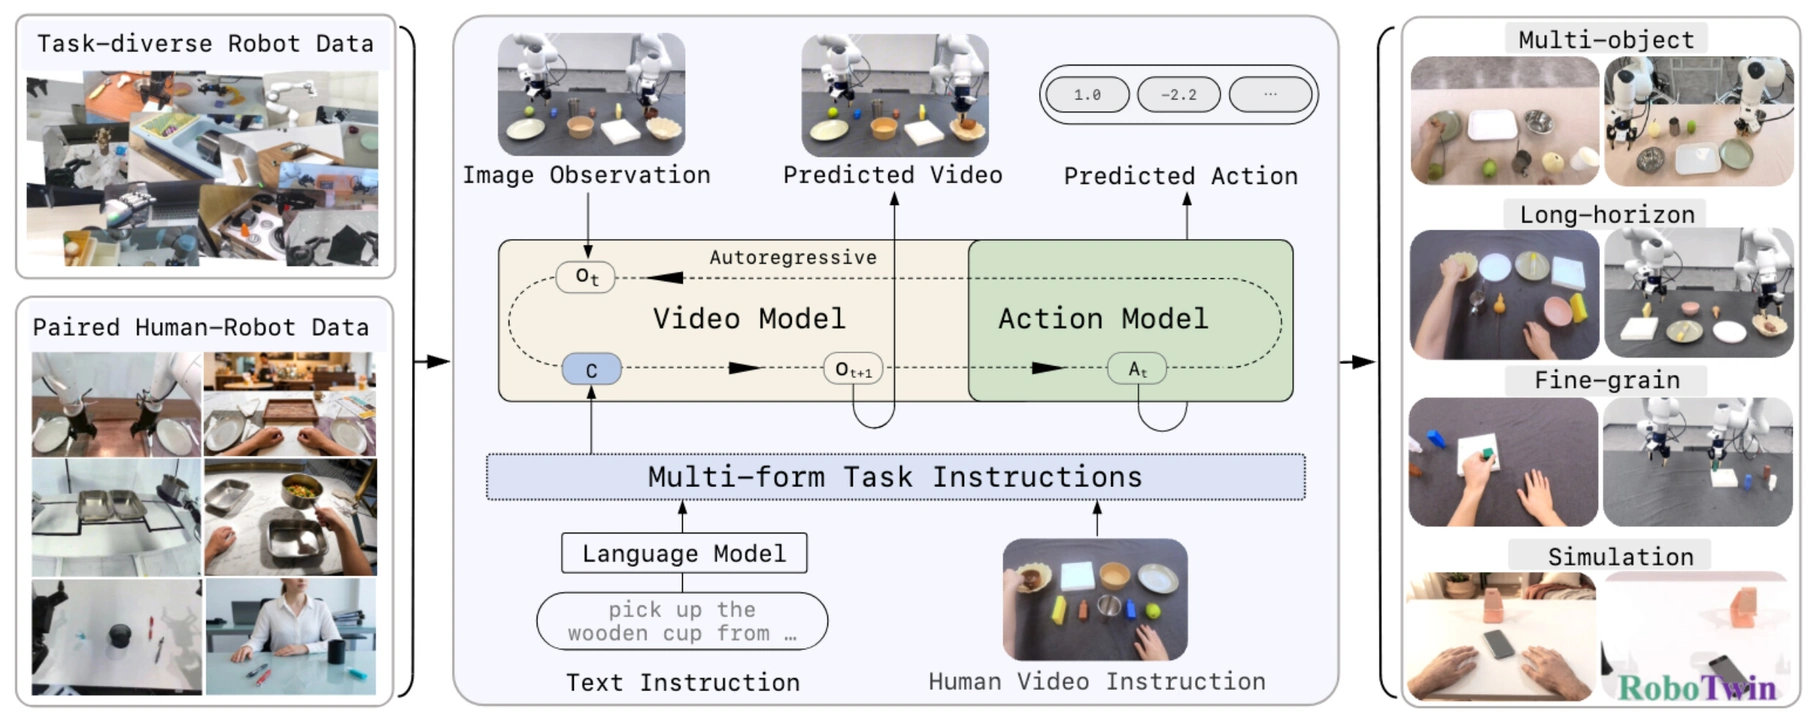
Gen-1.5 则展示了从模型学习过程中自然涌现的这一能力(或者至少是构建了某一种 recipe,依然足够了)。之后的 Skild S1 显著构造了一些 ICL 的范式并且着重强化了这一能力,可以比较笨拙且一定成功下,仅通过 UMI 示教来完成诸如 cook pancake 以及盆栽移植这样的长程且 fancy 的任务。S1 通过分钟级的 ICL 带火了 ICL 这一范式,就像曾经 Generalist 以及 Sunday 之于 UMI。
这方面的难点主要在于构造一些合理的 ICL pair,我们希望 ICL 不只是简单的背轨迹,而是容忍 pair 之间的差异,从而达到泛化,某种程度上,pair 的 diff 越大,模型越泛化。Zero-WAM 则把人类的 Ego 视频作为 prompt,说是 Zero-shot 实际上是 Human video ICL。用 Ego 或者 UMI 作为 input 来实现 ICL,有概率成为 WAM 之后又一具身流行叙事。
| 论文 | 主要贡献 |
|---|---|
| Gen-1.5 | Generalist 出品的基于 UMI 数据迭代的预训练具身基模,展示 ICL 与工具使用能力的拓展;可与早期 Thousand Hands 展示对照。 |
| Skild S1 | 使用大量数据组成 ICL 范式预训练,UMI 示教可以实现超长程任务 Zero-shot,Demo 效果极好 |
| Zero-WAM | 用视频模型将机器人预训练数据构建对应的 Human Ego Pair 进行预训练,从而支持 Human Video Prompt 输入形式,实现 ICL |
| RICL | 使用 DINO 相似度对于 context action 和 VLA output 插值,较为原始的探讨 |
空间表征#
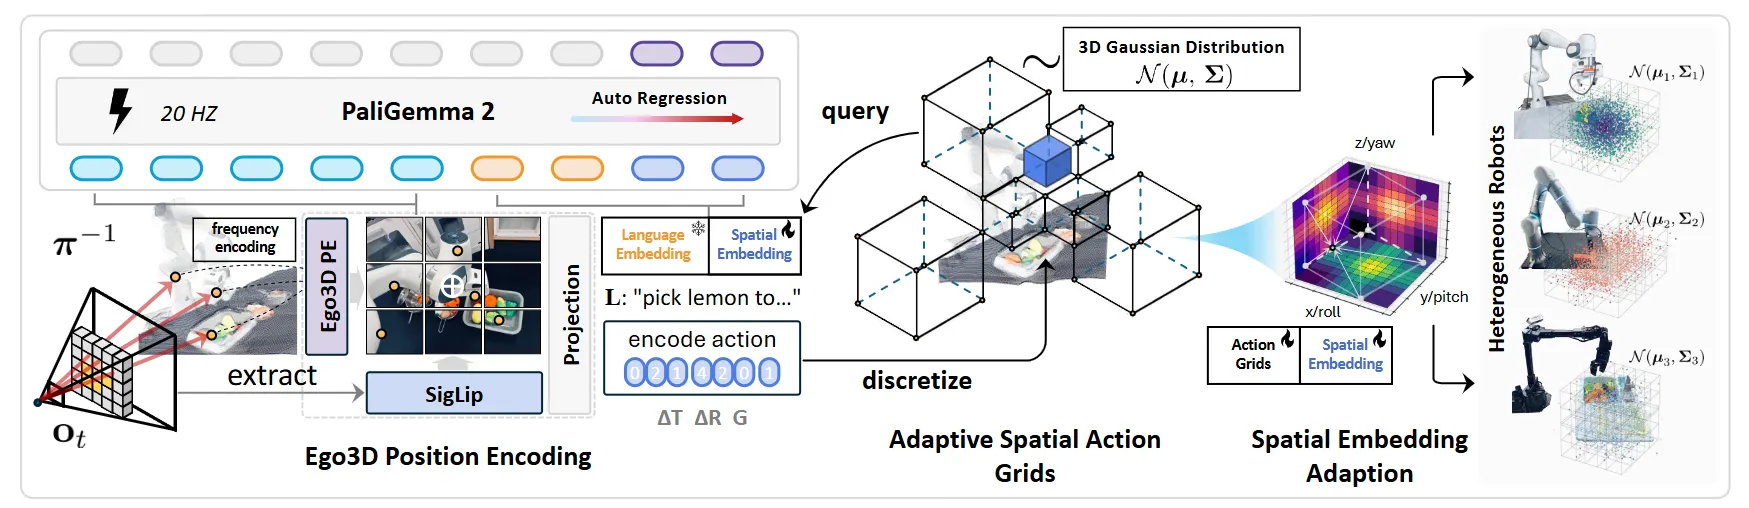
一些论文讨论如何将空间表征加入到 VLA 里面,这对于空间智能这一具身智能的姊妹命题是一种阐释;然而,有必要同样阐述的是,这一思路本质上是一些更加接近于传统 CV 领域,或者说偏科研界的做法。
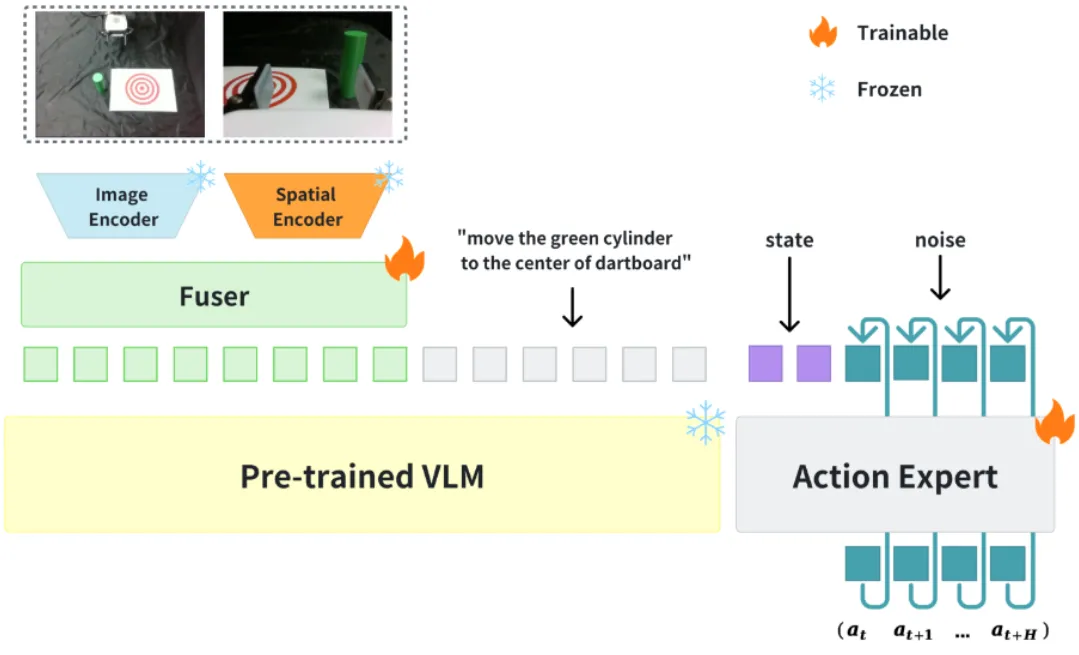
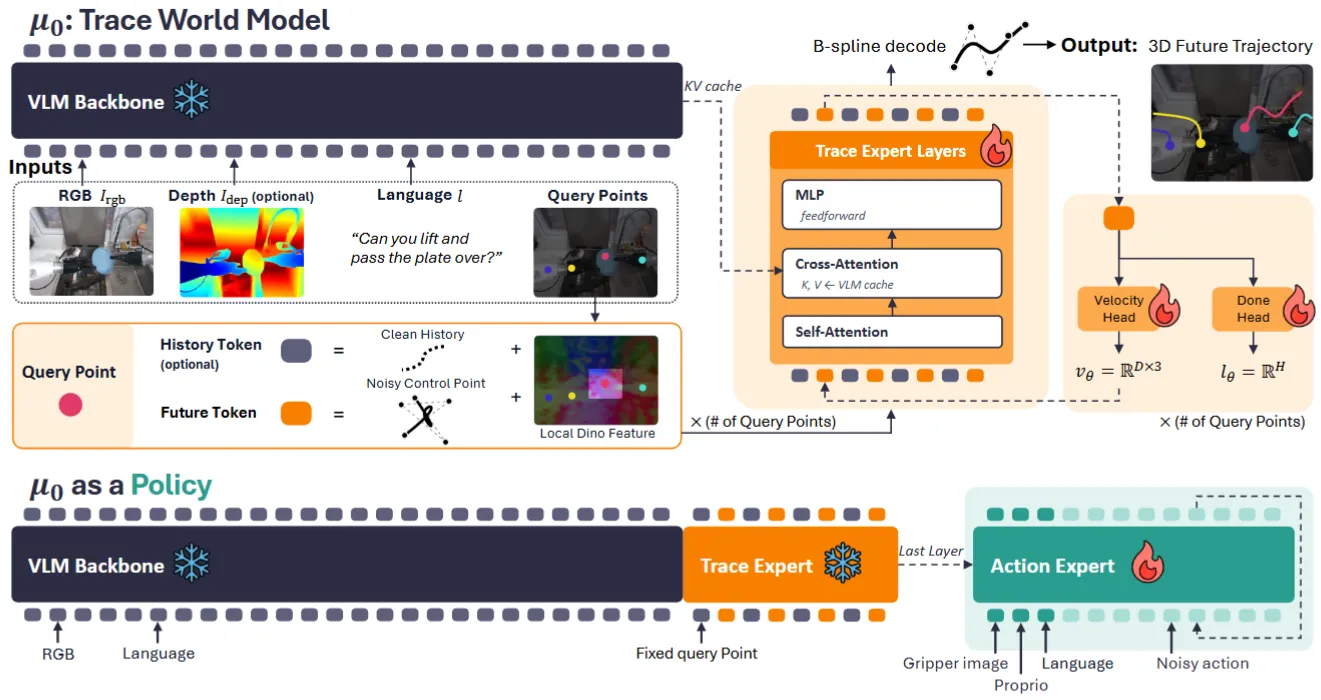
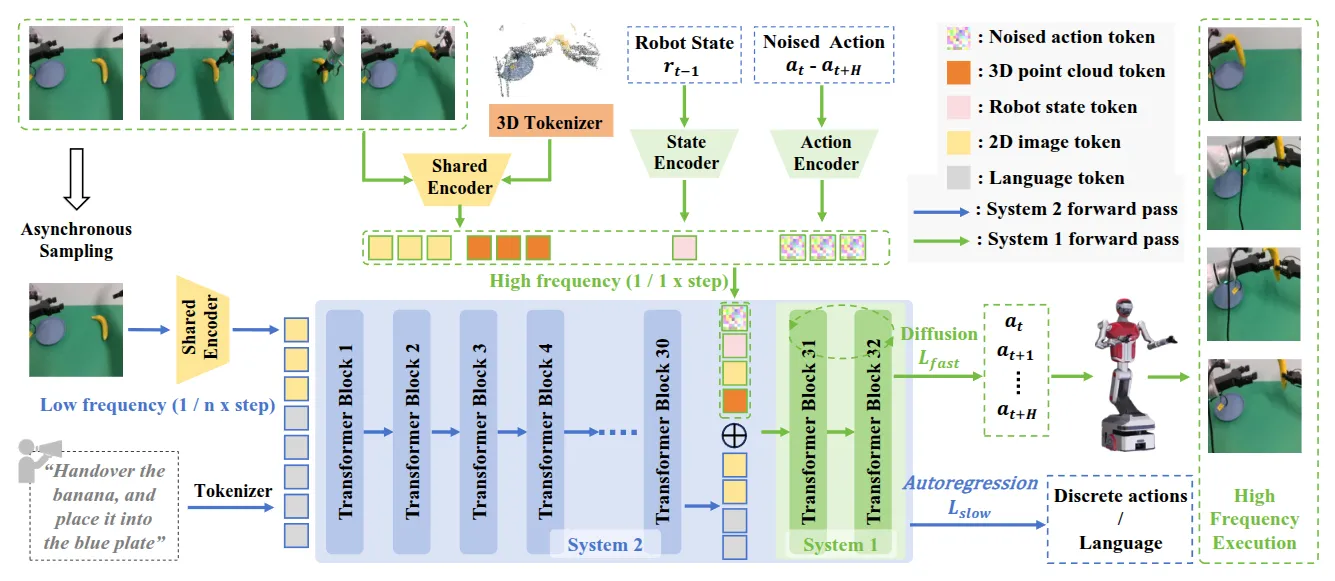
即,使用一些 encoder 或额外的信息注入方式,将经过预训练的 foundation model 得到的 embedding 作为 condition 加入到 VLA 模型中。然而,这并不符合后续 scaling up 的本质期望,从而一定程度上局限于科研界的探索:
| 论文 | 主要贡献 |
|---|---|
| SpatialVLA | 使用 semantic embedding 以及 depth 来投影得到 Spatial Token |
| Evo-0 | Fusion image encoder 以及 VGGT |
| 使用 Trace 作为表征训练 VLM + Trace Expert,之后 VLM + Trace Expert 用 GR00t-like 接到 Actor 上的类 WM 模型 | |
| FiS-VLA | 通过在 Condition Concat 引入 3D Token |
Visual Prompt#
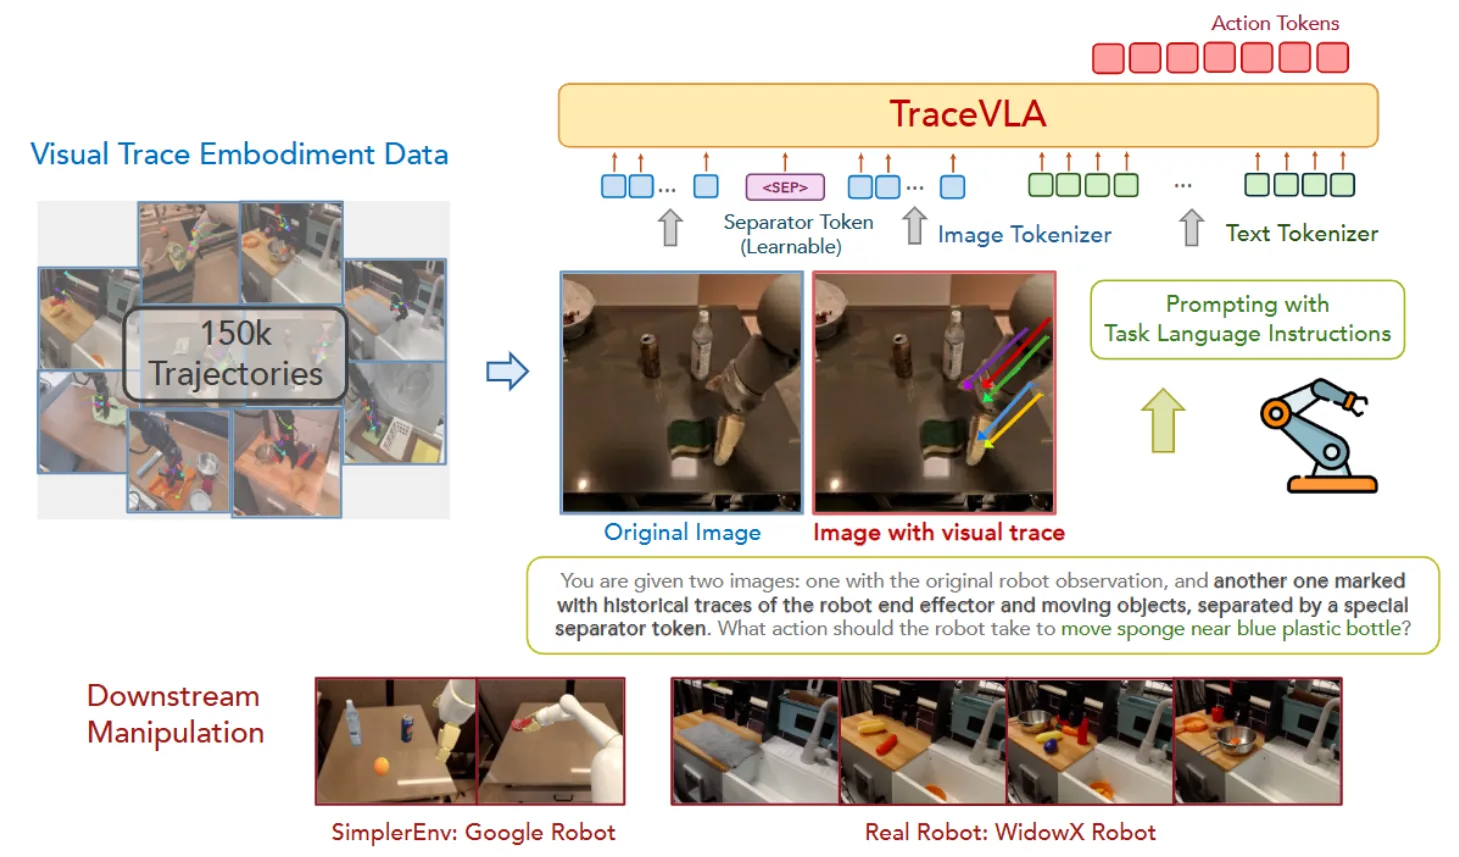
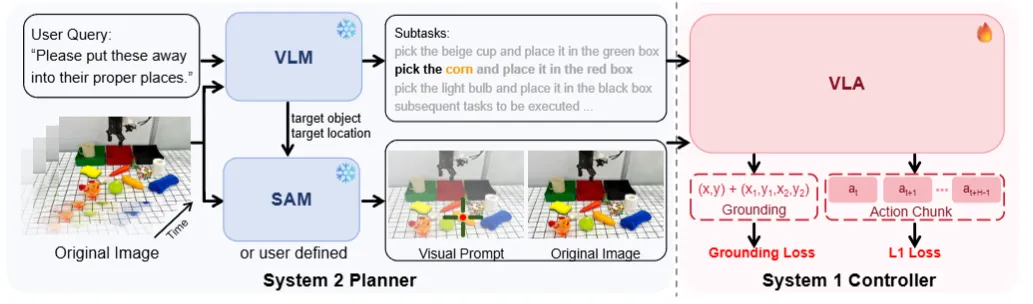
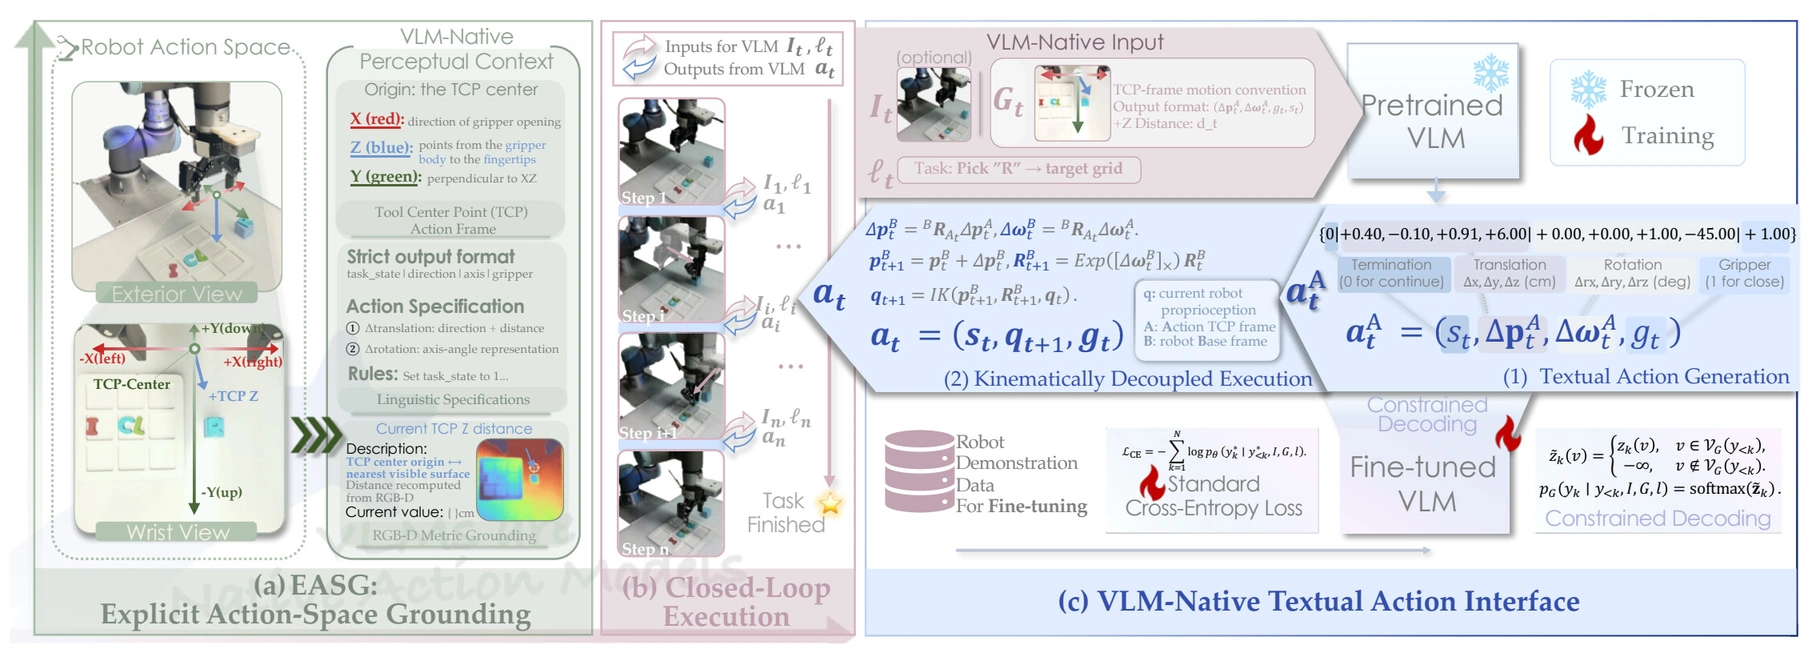
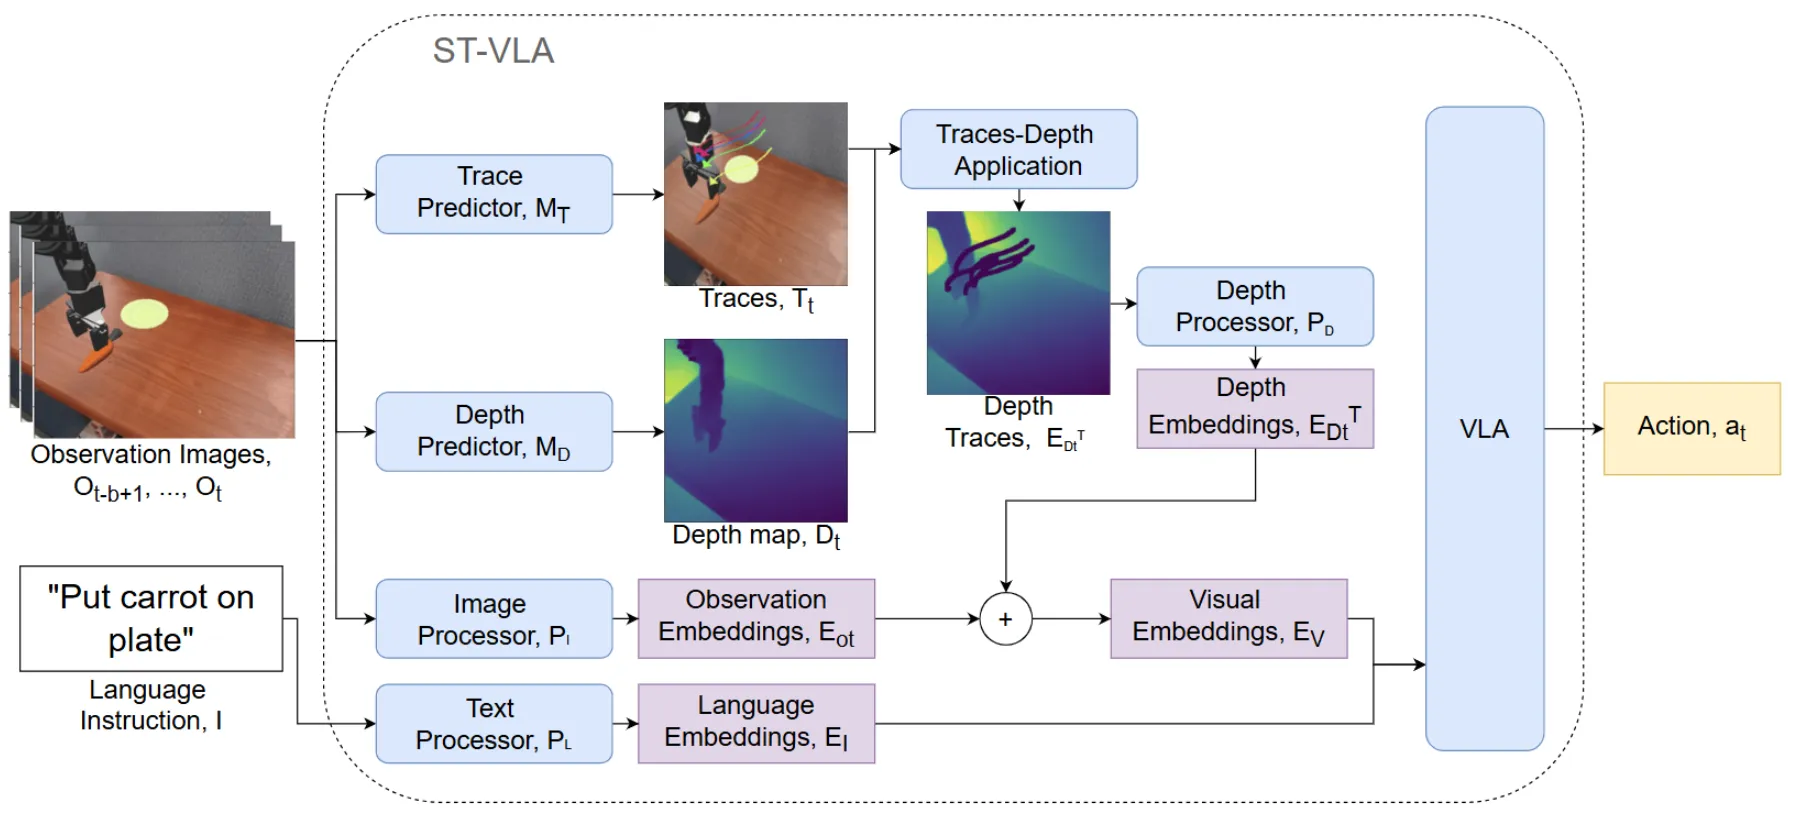
一些工作认为对于 VLA 来说,在图片上标注一些信息,可以帮助模型获得更好的性能,这些信息即 Visual Prompt;通过在图像上增加所谓 visual prompt,一般认为可以增强模型对于图像中信息的感知,从而间接地提升模型的空间能力和泛化能力。然而,这些方法依然具有局限性,仅可以暂时作为一种当模型的空间感知和 grounding 能力无法在 trade-off 中和动作能力一同体现的情况下,所使用的捷径:
| 论文 | 主要贡献 |
|---|---|
| TraceVLA | 在图片上标注历史动作轨迹 |
| VP-VLA | 把目标物体 / 终点 render 成 visual prompt 作为 Obs 输入 |
| EASG | 把 TCP 动作坐标系投到腕部图像,用 VLM 原生文本接口表达连续动作;无需新增 Action Head,也可沿同一接口继续微调。 |
| Spatial Traces | 在深度图上标注历史动作轨迹,即“时空”轨迹 |
快慢系统#
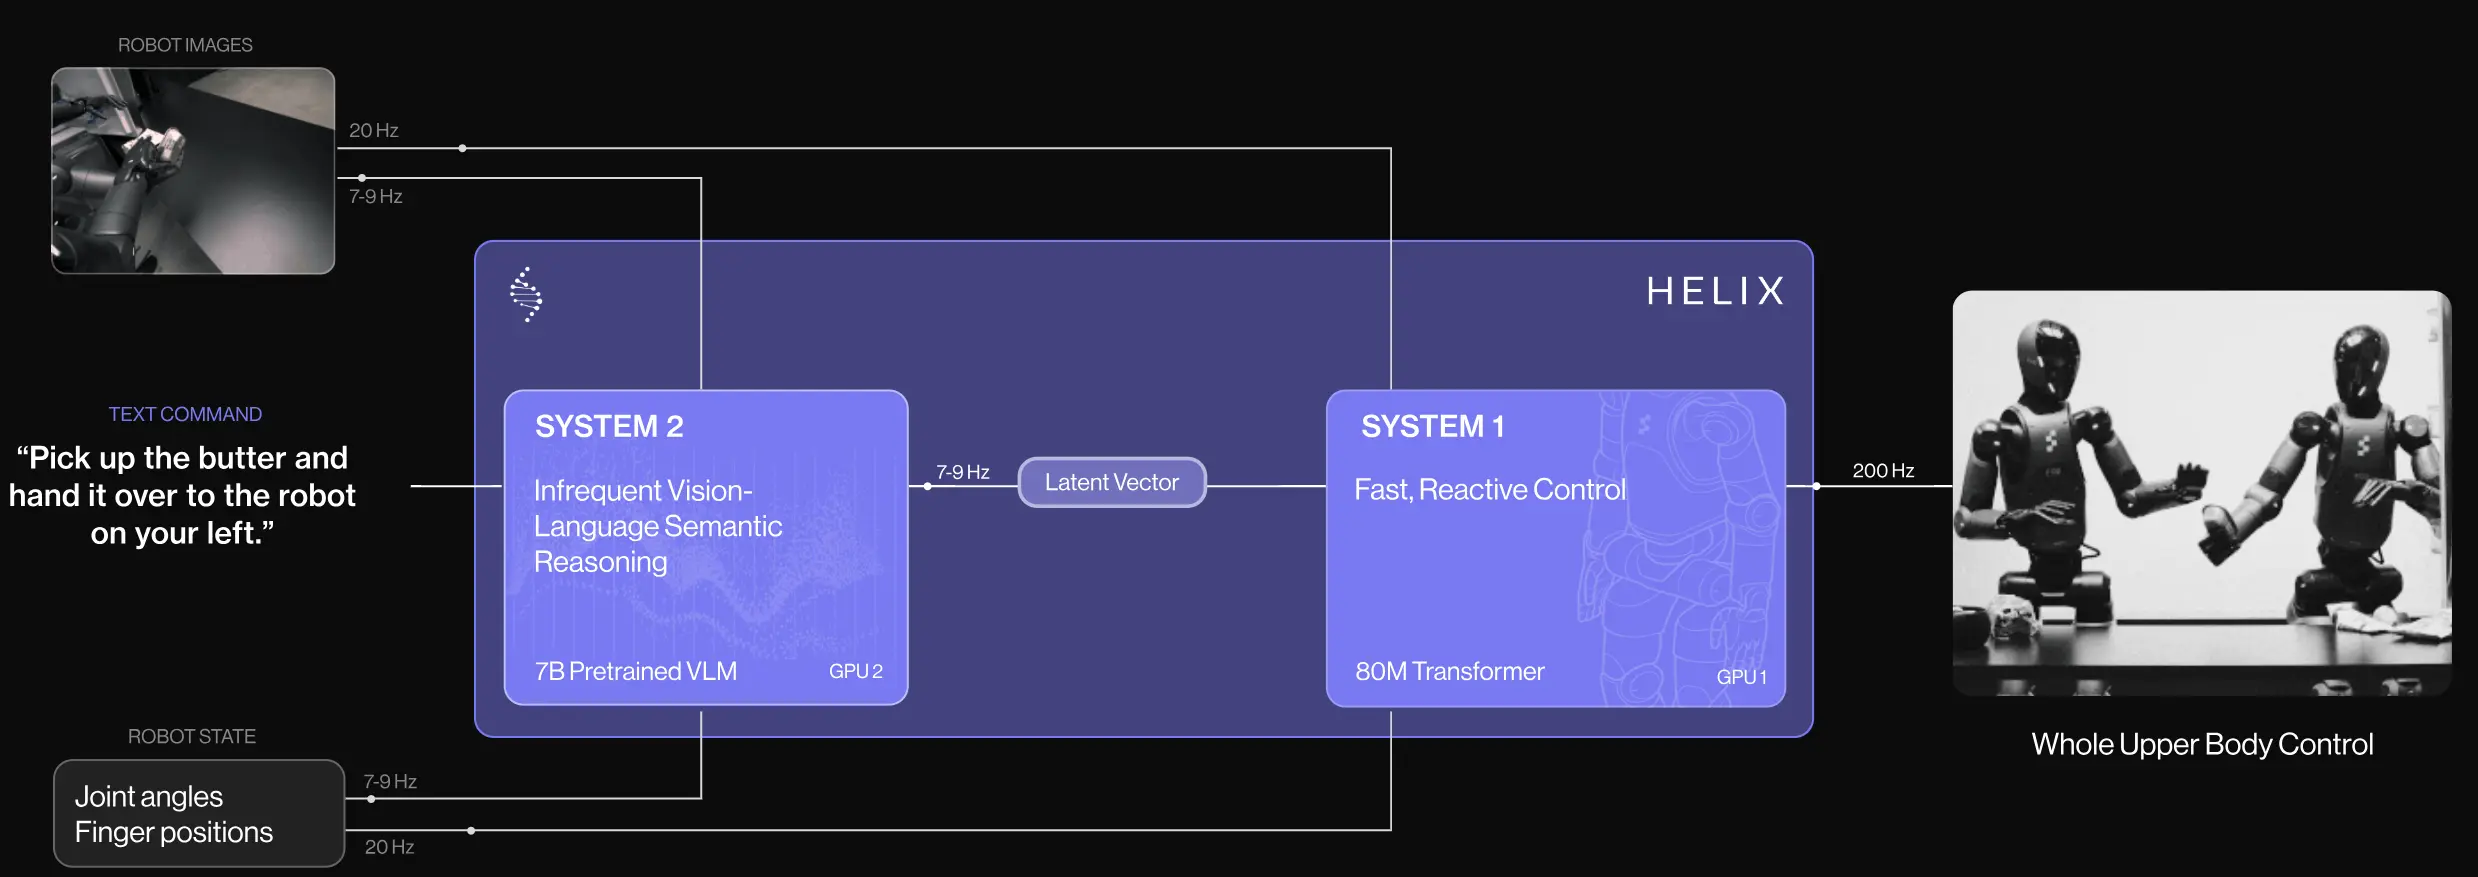
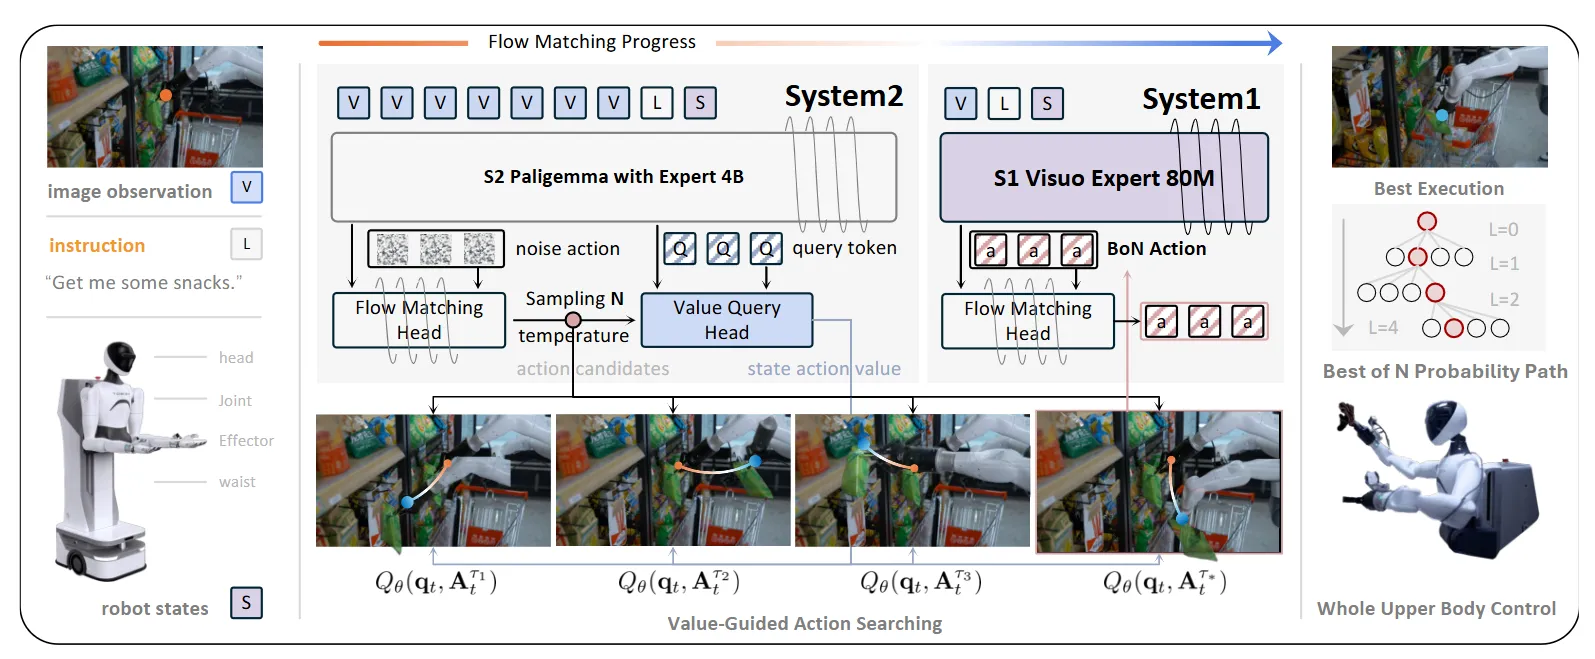
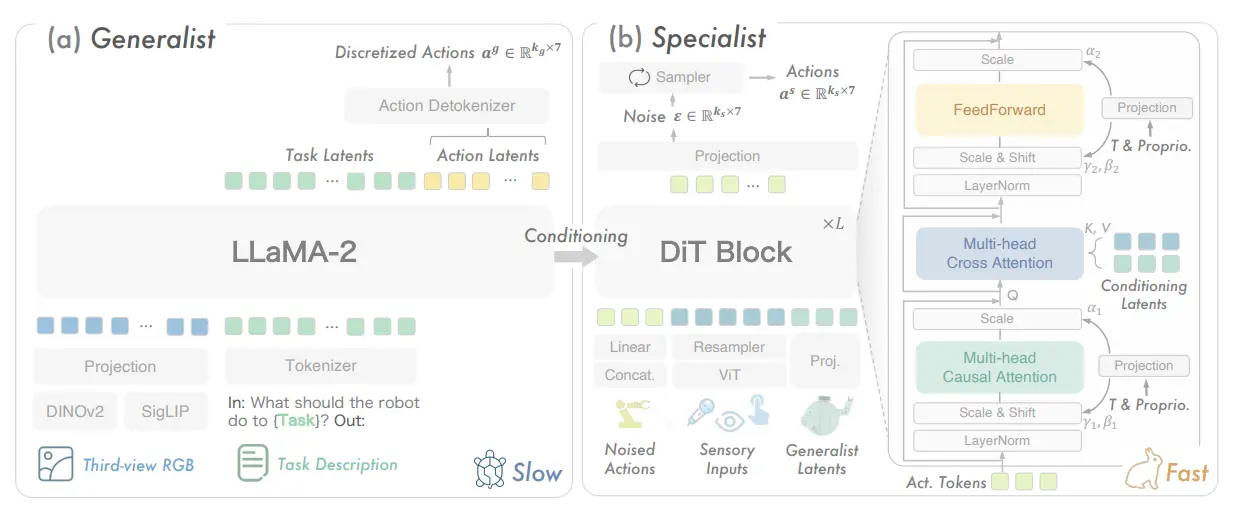
构建一个快慢系统来提高端侧的运行效率也是具身智能比较关心的命题,因为这样可以增加模型的灵活度,进一步提高模型的成功率。比较早的如 RoboDual 就是快慢系统,同时如 以及 GR00t 等模型均因为包含两个桥接的组件,因此可以以不同的频率进行更新,从而形成快慢系统。除此之外还有一些其他工作:
| 论文 | 主要贡献 |
|---|---|
| Helix | 快慢系统的 Demo,无 report |
| Hume | 慢系统生成候选动作,快系统 Corse to Fine |
| RoboDual | 快慢系统设计,慢系统预测离散 Action 作为 Condition |
Agentic Control / Tool Use#
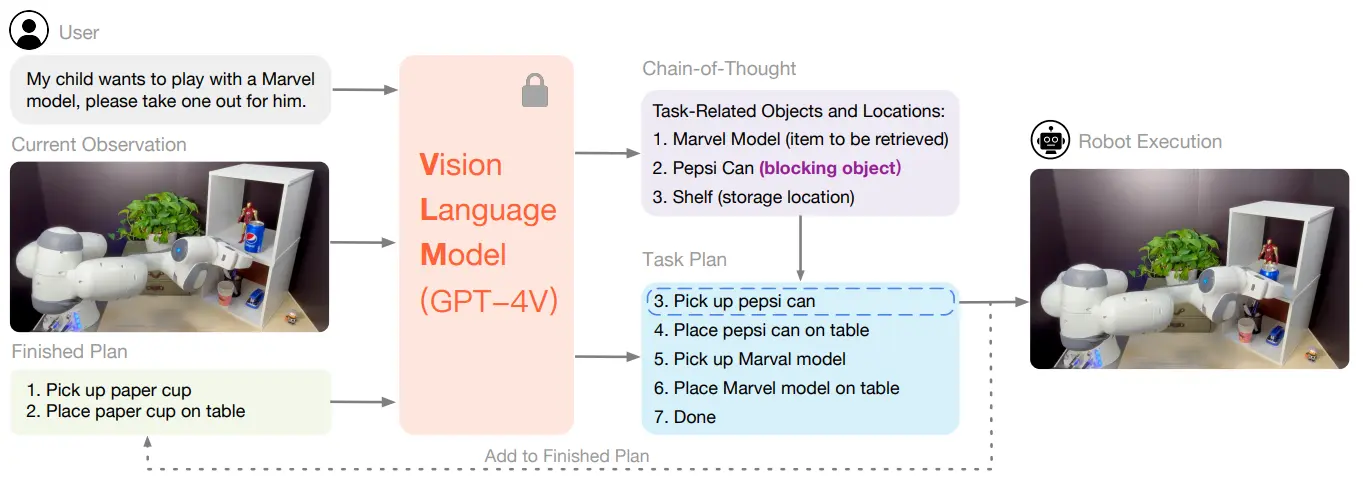
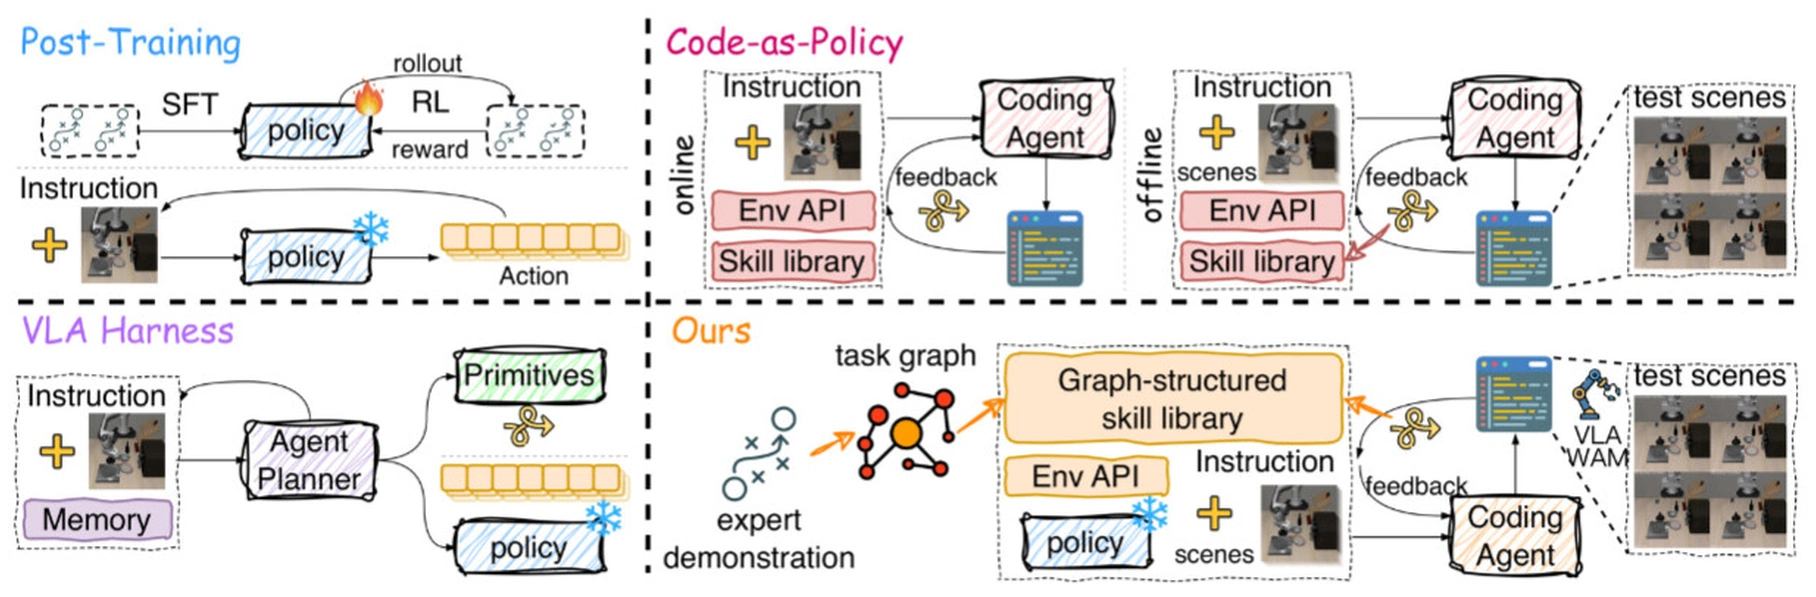
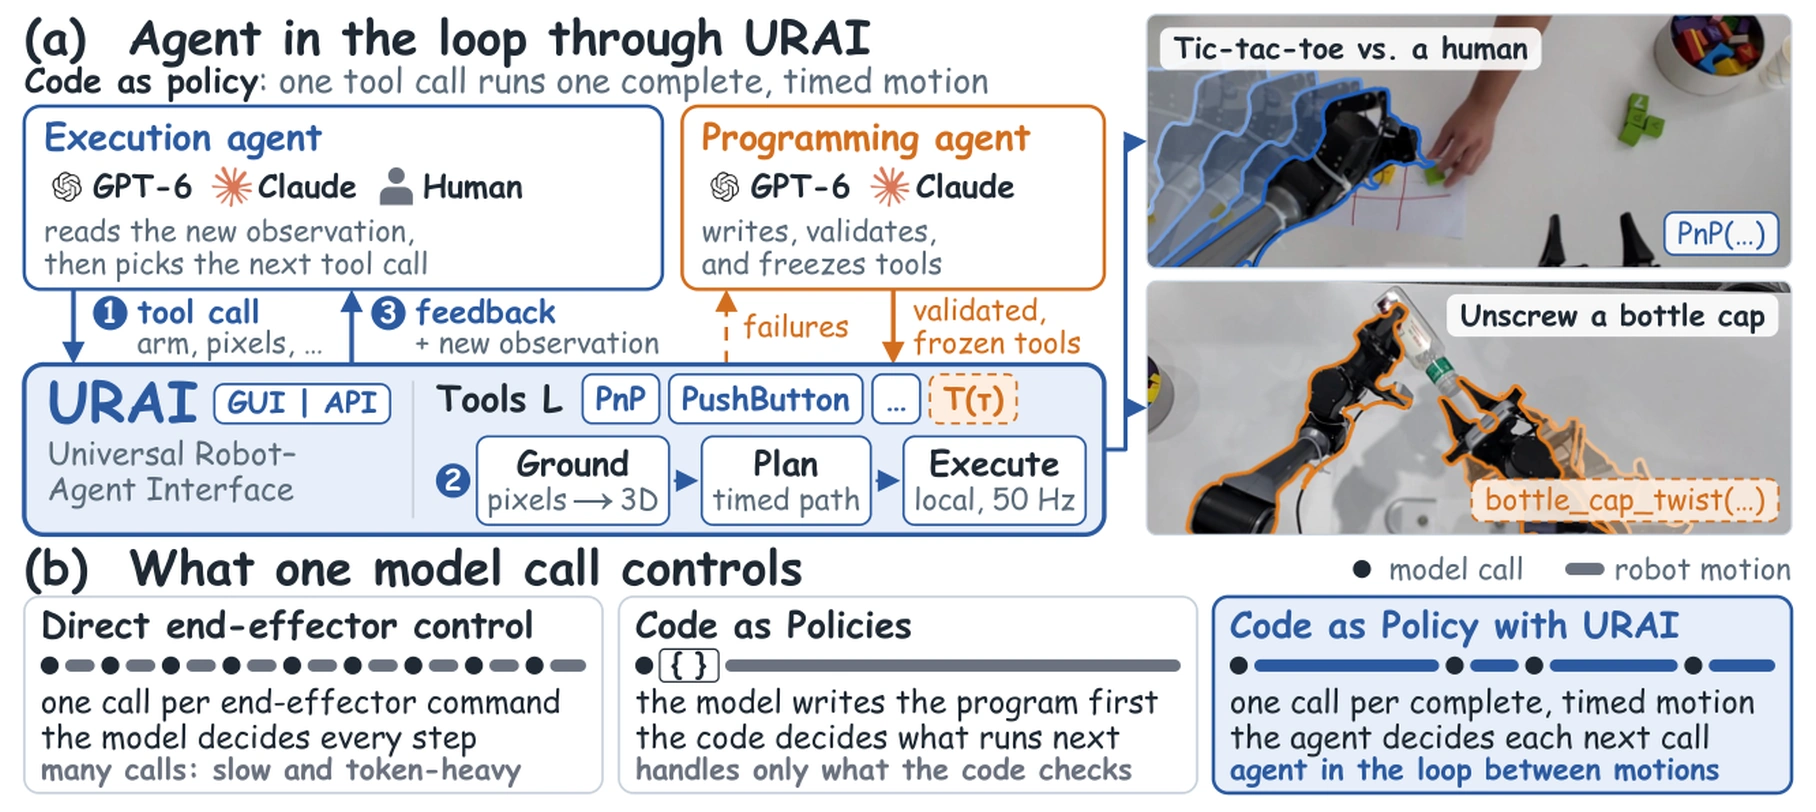
较早的参照包括 Code as Policies、CoPa、MOKA 和 OmniManip。从这些相关论文中可见,在早期的领域发展过程中,研究者依然倾向于自己手动组织一些所谓的 workflow,在其中使用模型进行输出,并解析模型的输出来产生一些对应行为。然而,这一做法本质上是将人类的先验置于模型本身的能力之上。
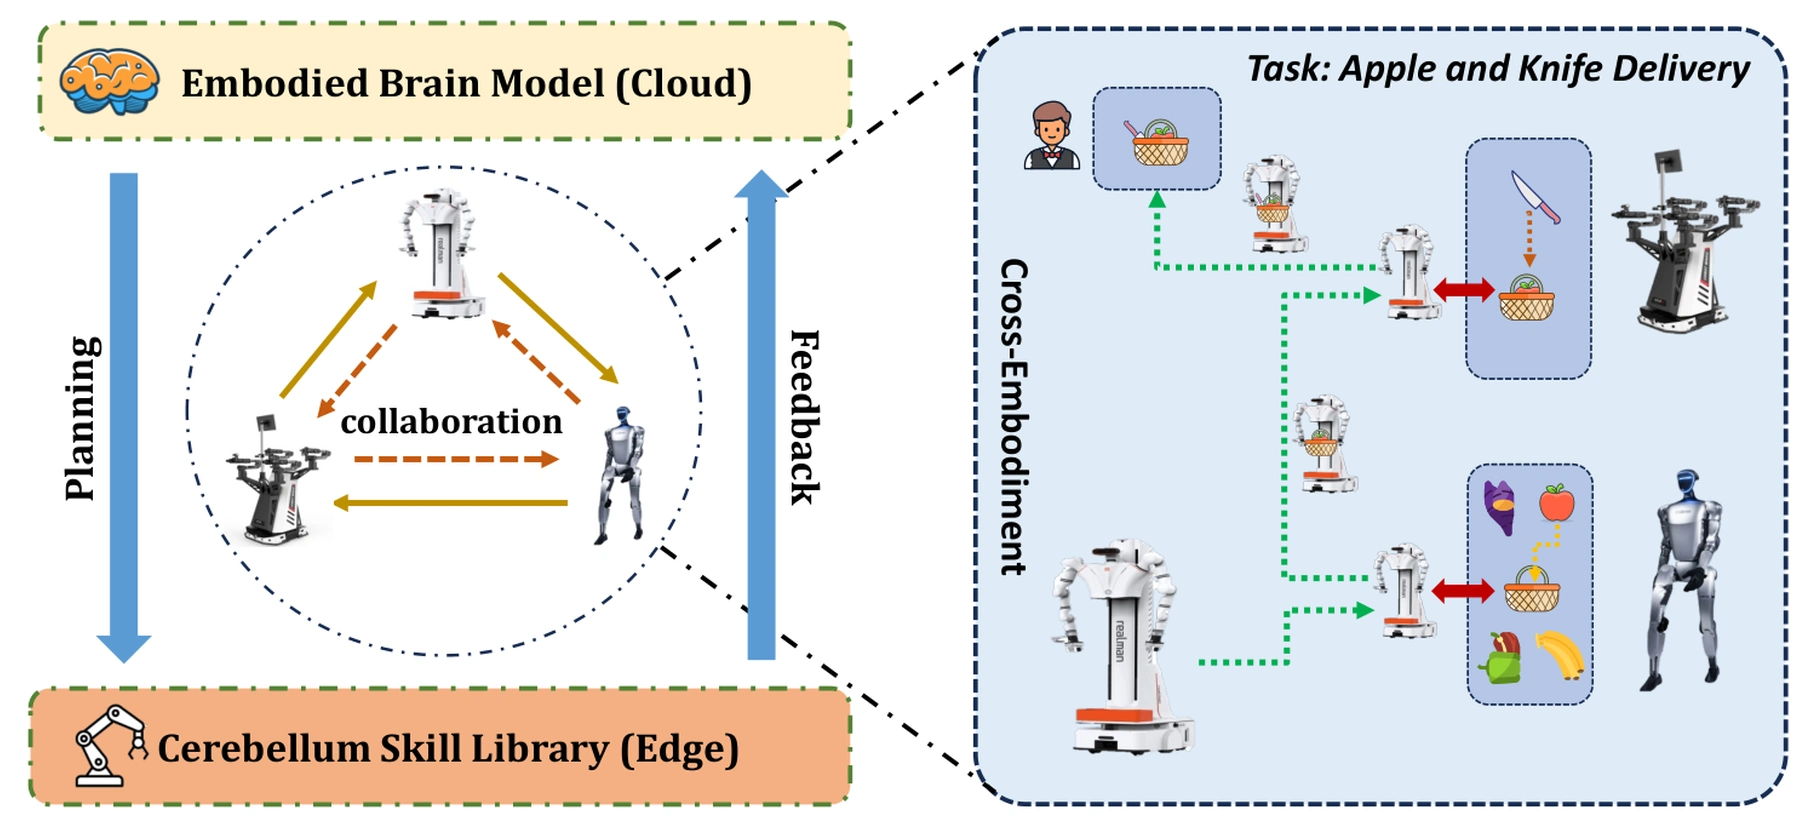
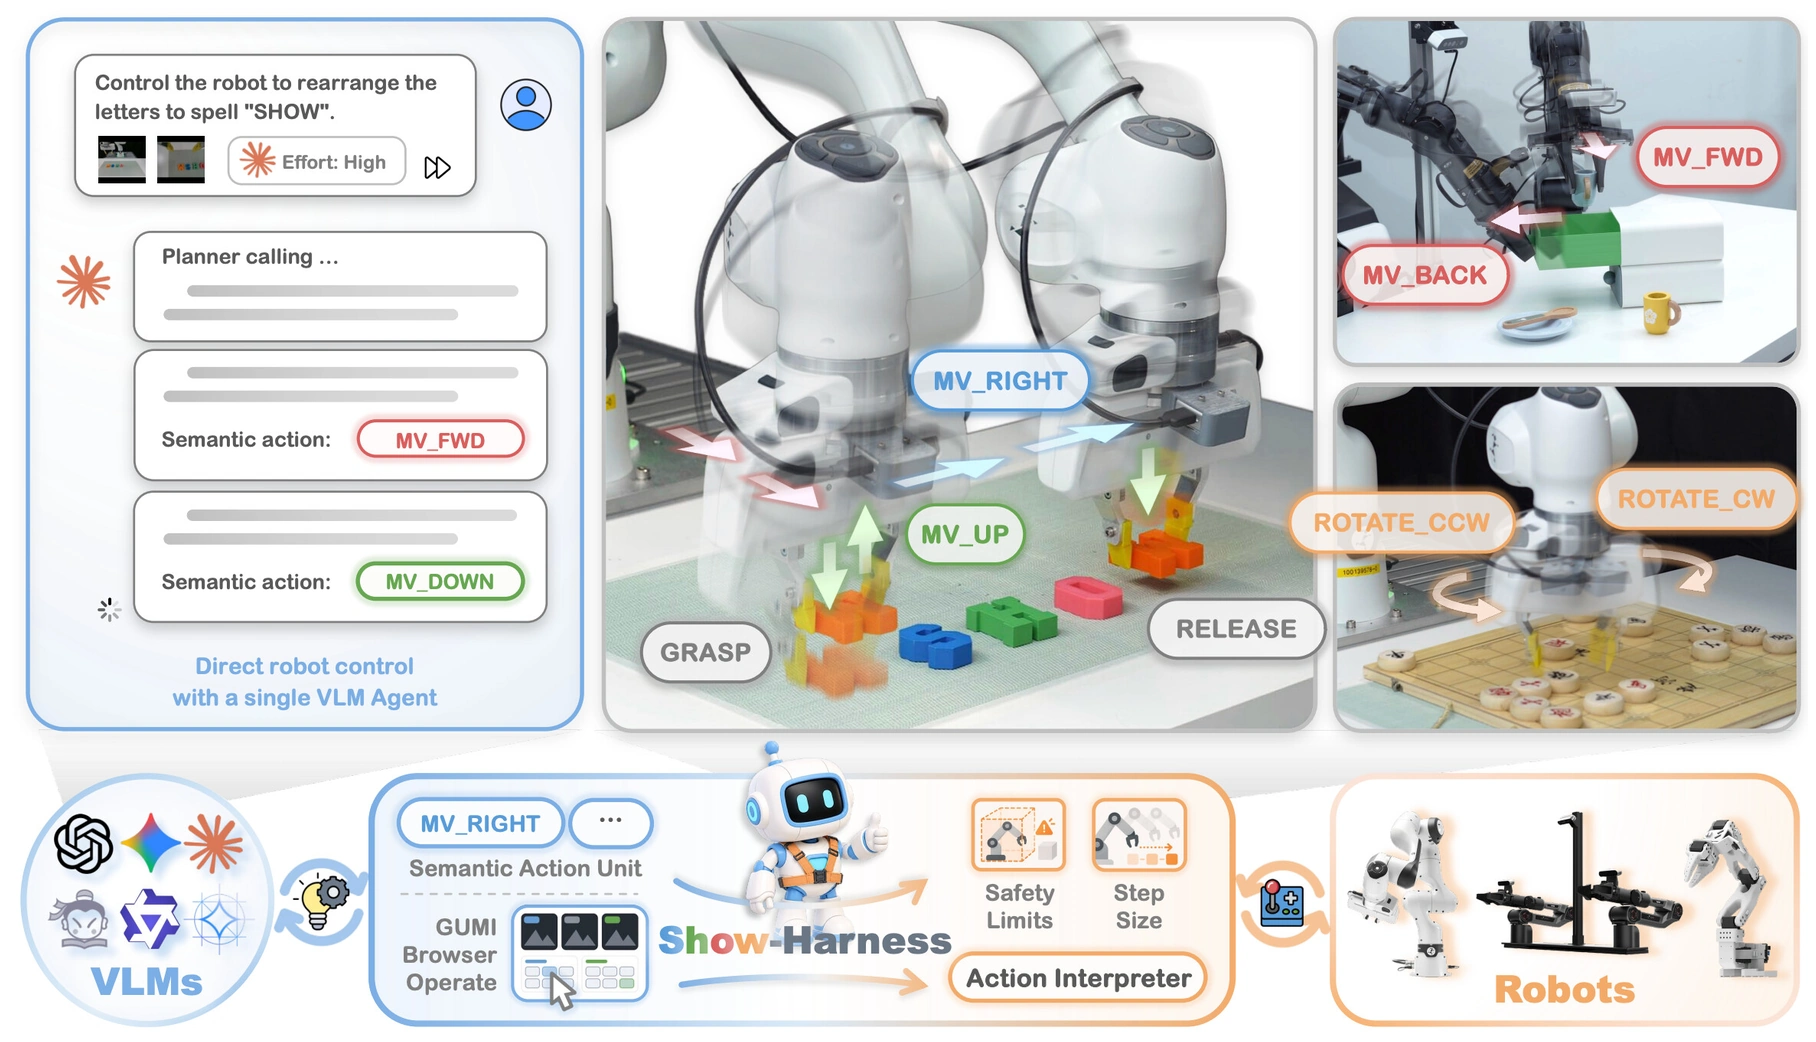
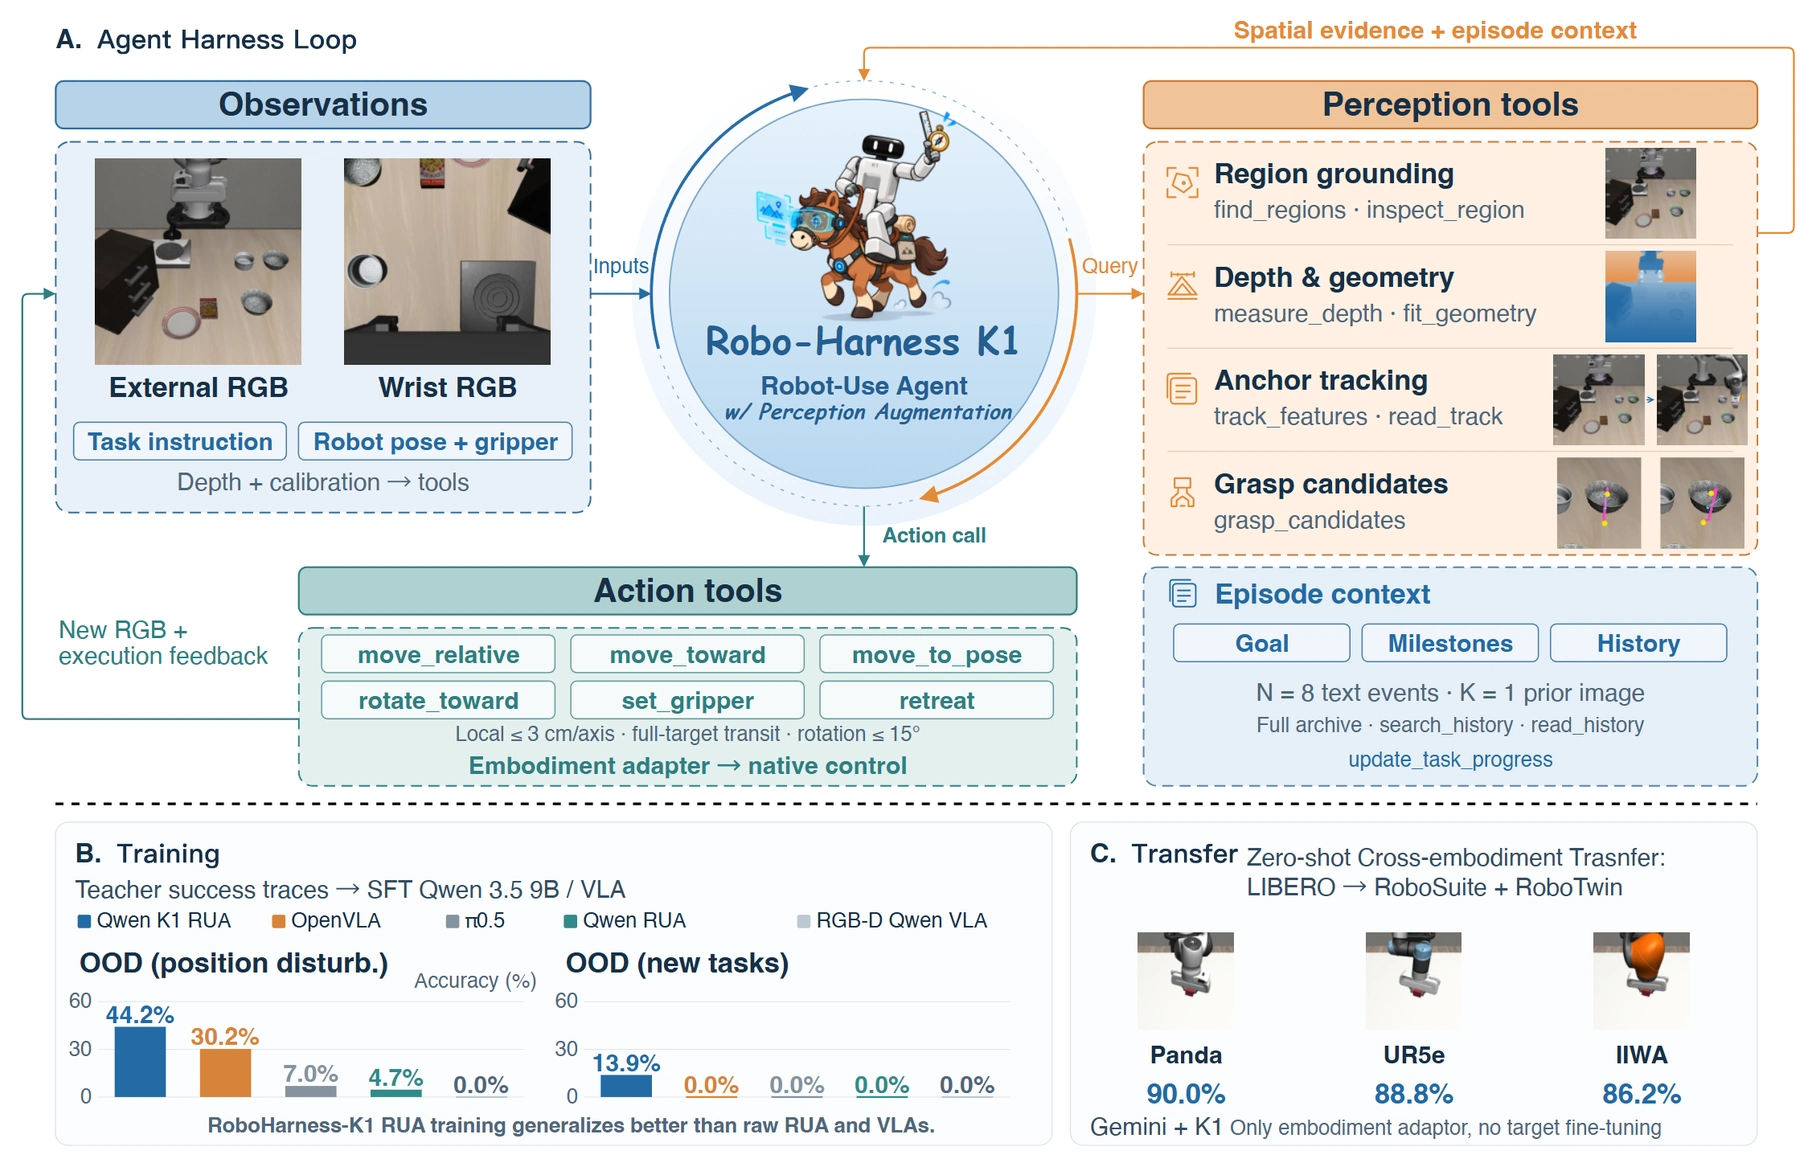
现代的 Agentic VLA 思路,则聚焦于在原生的 Agent 框架中加入 VLA 相关的 extension 或者相关的 tool use,即为 VLM 搭建合理的 Harness 框架以 Fully leverage VLM 的能力,并且在需要搭建 Agentic VLA 的时候,如何妥善组织整个系统。本质上,在正常的如 coding harness 中运行的 VLM 模型更加具备充分的自主能力,并且跨越了人类的先验,从而可以自由地执行一切操作:调用代码并运行以获得足量的观测信息,或者使用一些预先训练好的 VLA 模型来执行连贯的动作。这是一种相对更加合理的解决方案。
| 论文 | 主要贡献 |
|---|---|
| ViLA | 早期 Prompt-based 高层规划框架,用文本记录已完成任务,并随新观测继续规划,可作为后续 Agent Memory 的参照。 |
| RoboOS | 用分层框架组织跨本体与多 Agent 协作,将机器人能力作为可调度的执行接口,是后续 VLA as Tool 路线的较早参照。 |
| Show-Harness | 用 GUMI 接口采集带原生语义的离散遥操作数据,也让通用模型通过同一接口控制机器人,兼顾直接使用与后训练。 |
| HarnessAPI | 将 VLA 作为工具供上层 Agent 调用的机器人控制框架。 |
| Robo-Harness K1 | 给 Robot-Use Agent 加入视觉感知与空间记忆工具,并结合执行轨迹微调,研究已有 VLM 如何更可靠地调用机器人。 |
| URAI | 把决策权保留在模型侧,代码只执行一次多阶段定时运动,而非像早期 CaP 一样完全接管运行时。 |
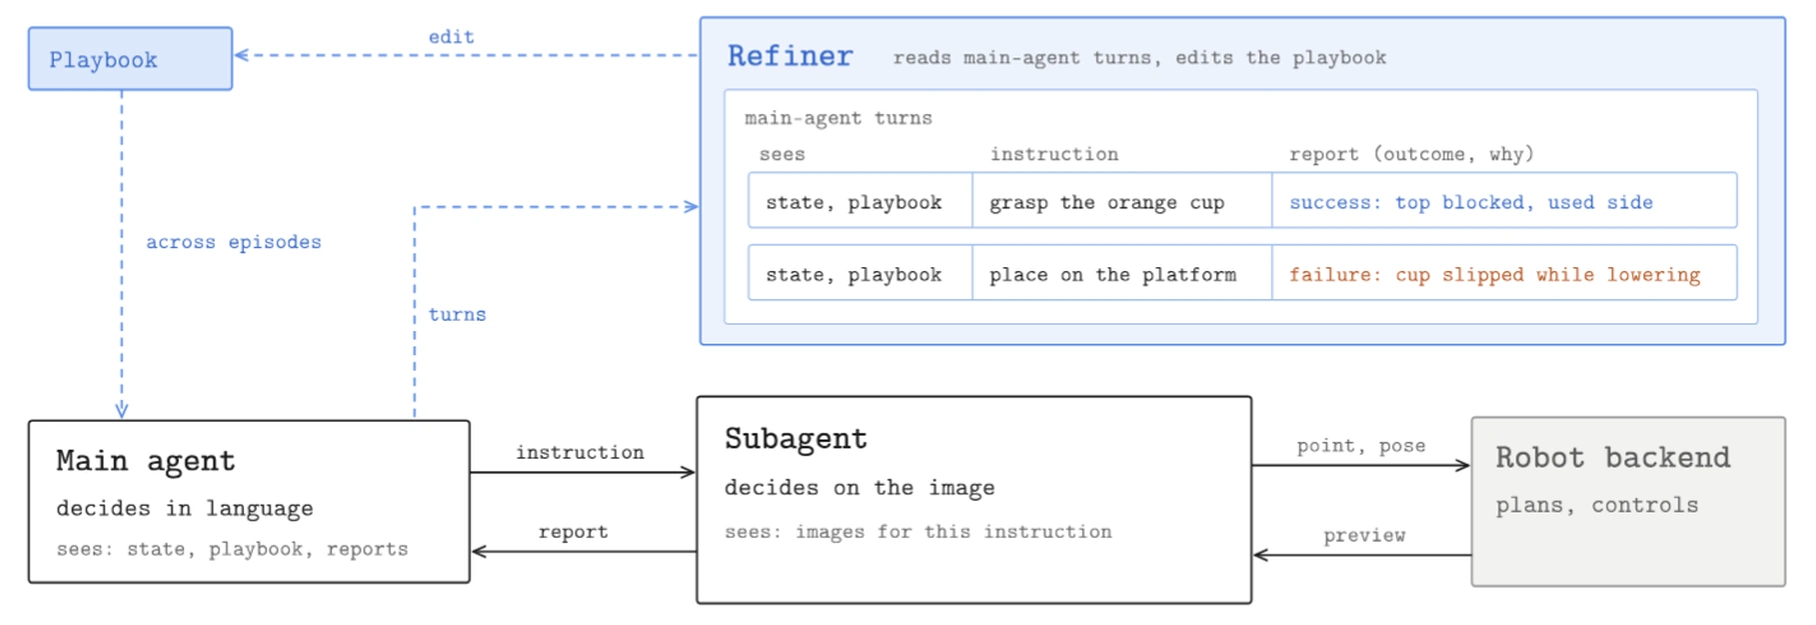
| RobotUse | 主 Agent + 视觉子 Agent + Robot Backend,用 Playbook 与 Refiner 积累执行经验和失败恢复方案。 |
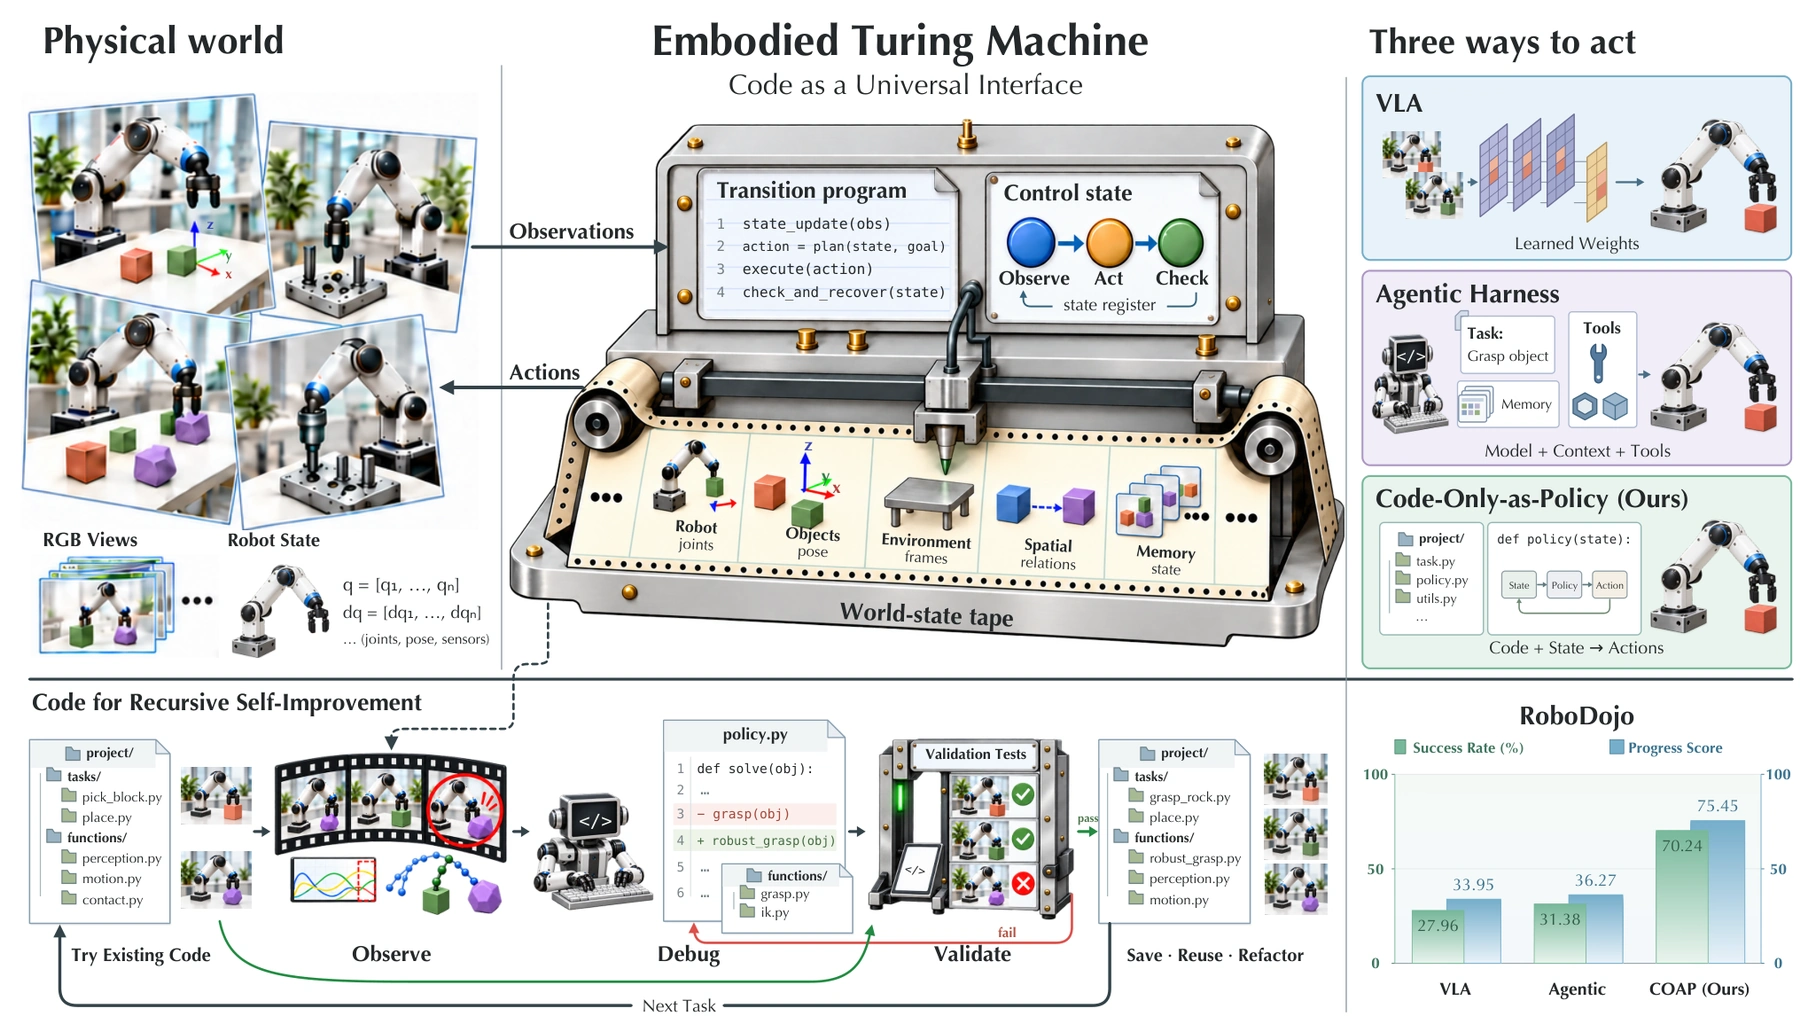
| Embodied Turing Machines | 由 Agent 编写并闭环修改机器人程序,调用工具估计物体状态;将仿真的测评从 OOD 测试变成了纯 In-D 测试,问题是现实永远是 OOD 的。 |
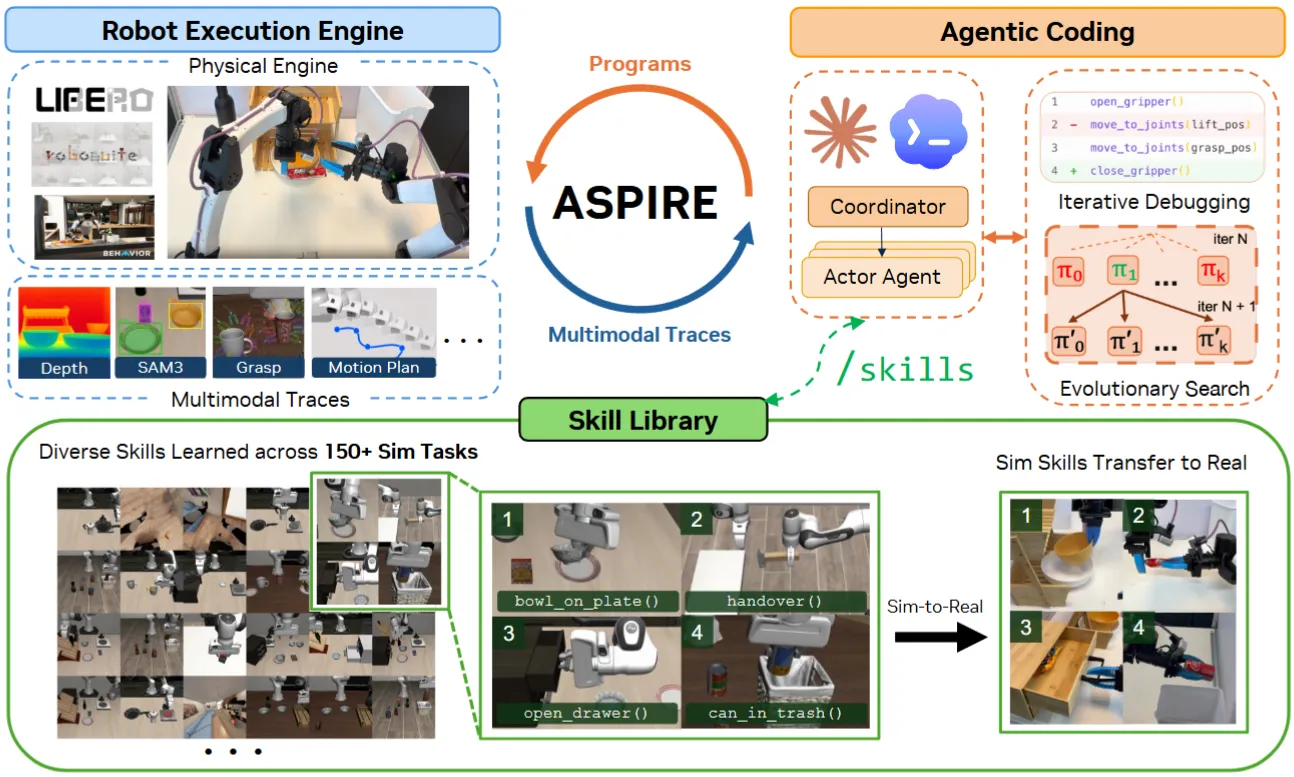
| ASPIRE | 将 Single Skill Policy 作为一个 Skill 加入到现代 Agentic Coding 框架,并且使得其可以不断变强 |
其余的技术报告#
同时还有一些初创公司、实验室或者正常企业的 VLA 技术报告,这些内容在当时可能较为同质,没有代表性,因此单独列出。在研究预训练以及数据组合的时候或许具有一些参考价值:
| 论文 | 主要贡献 |
|---|---|
| GR-3 | Seed Robotics 出品的 Qwen + Pi |
| Motus2 | 生数科技出品的在 VLM、WM 与 Actor 的 MoT 中加入触觉联合预测,利用大量灵巧手 UMI 数据预训练;真机展示较丰富,触觉必要性的展示与价值学习实验仍较有限。 |
| Dyna-2 | Dyna-Robotics 出品的 1M 小时人类视频 + 手部伪动作监督的 WAM,研究数据量到 human-to-robot transfer 的 scaling,并验证后训练后的真机收益。 |
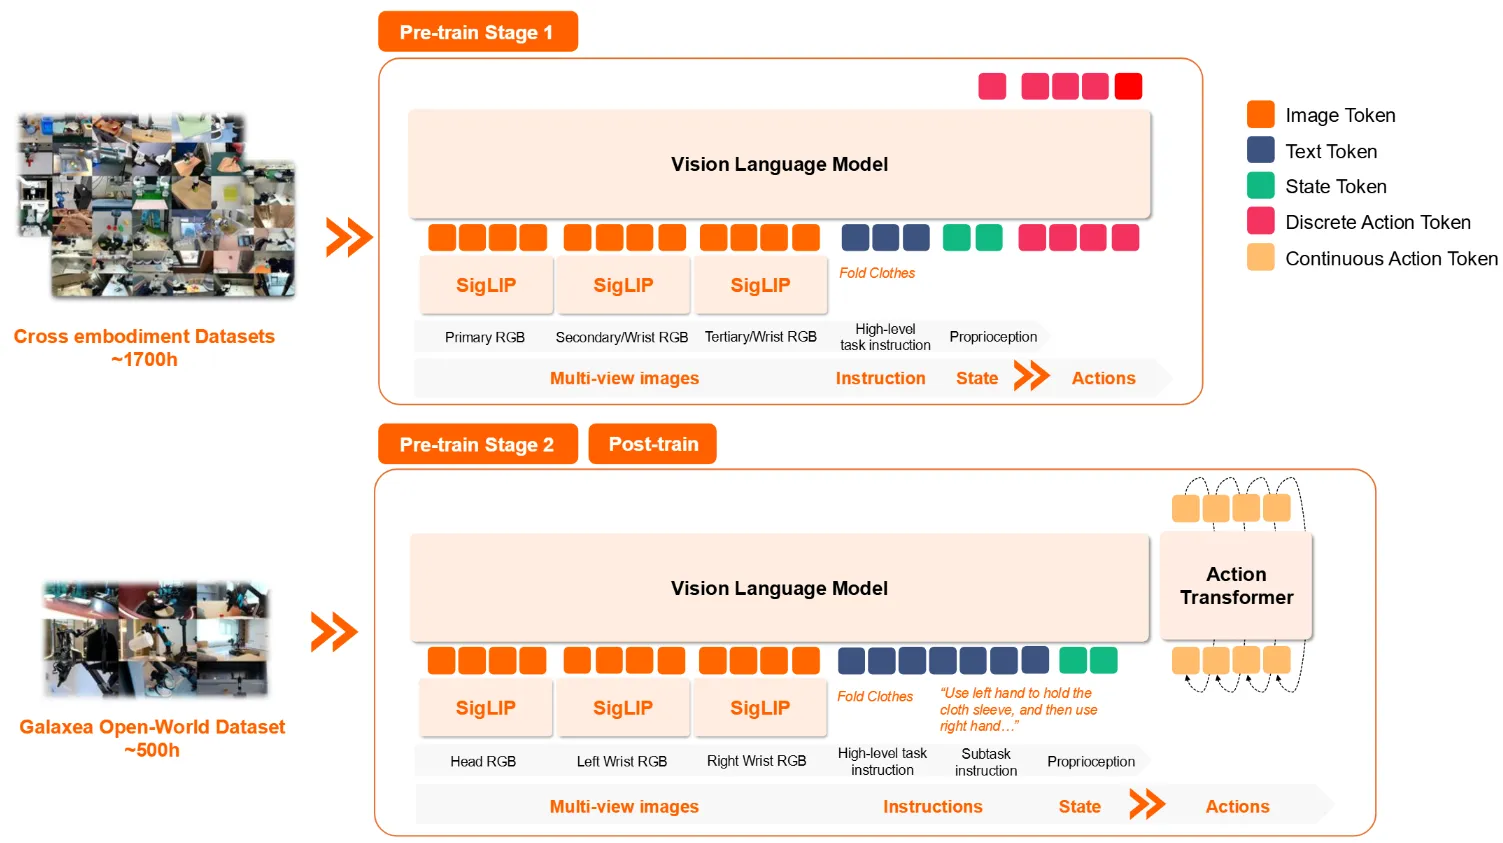
| G0 | Galaxea 出品的 Qwen 2.5 VL + Pi |
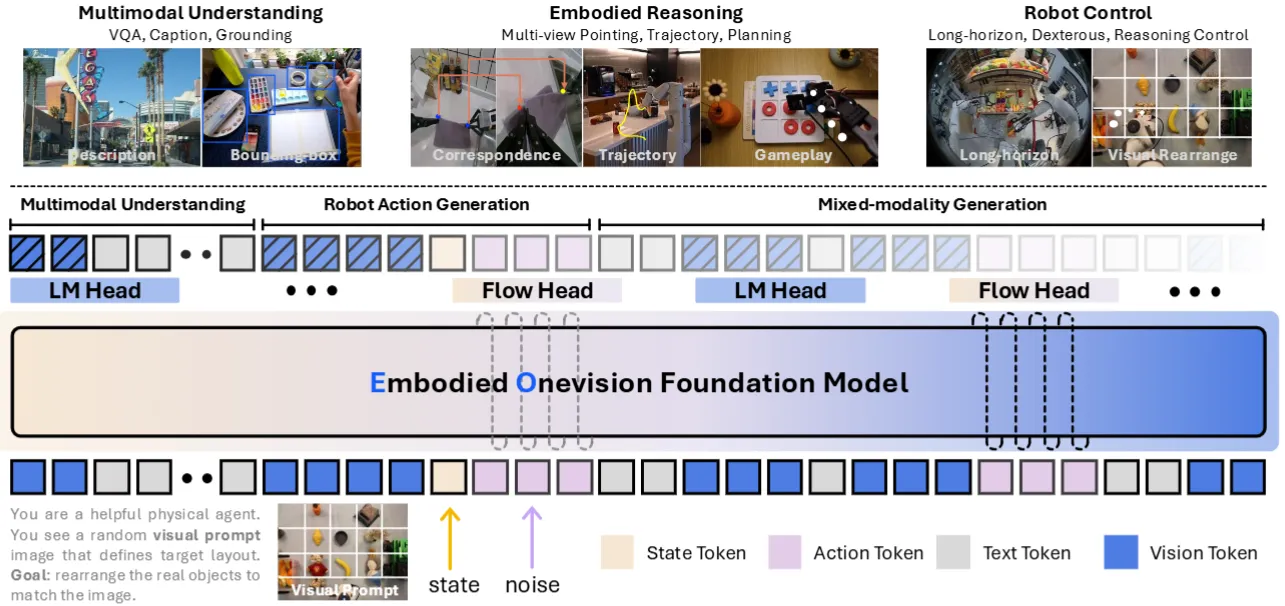
| EO-1 | Interleave 预测 Language & Action 的 co-training VQA 模型 |
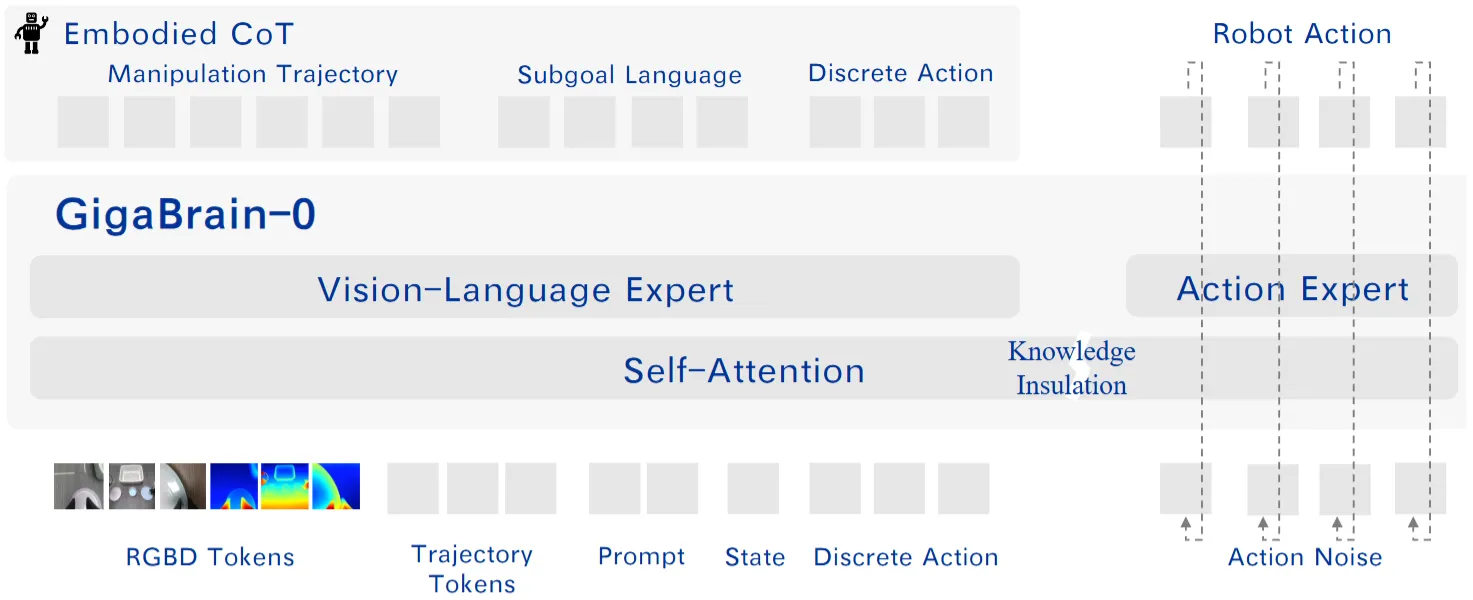
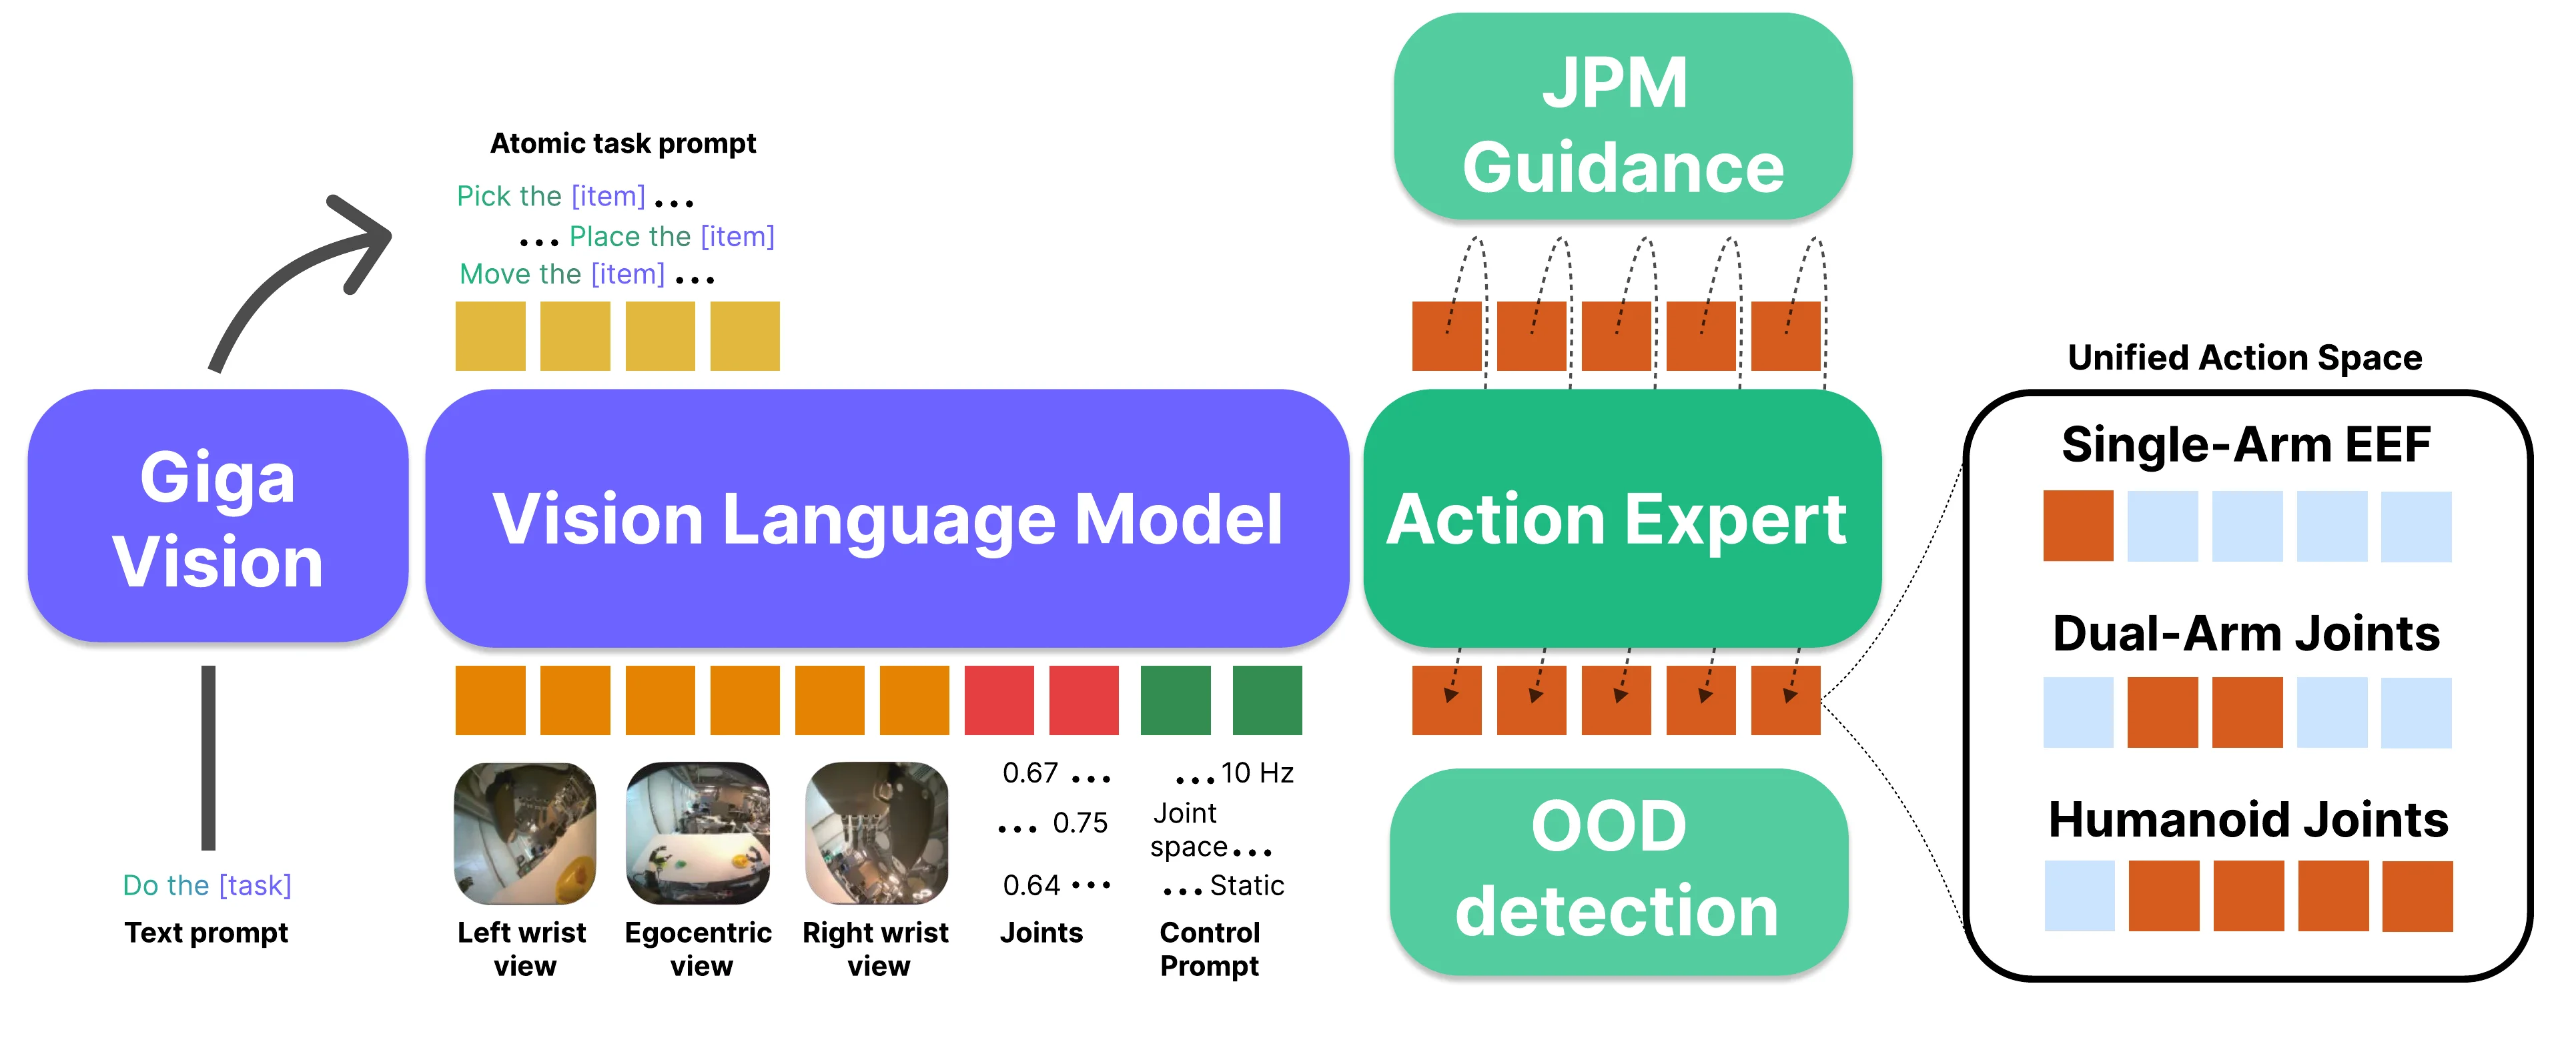
| GigaBrain-0 | GigaAI 出品的使用 World Model 合成的数据一起训练,KI Pi |
| iFlyBot-VLA | 讯飞出品的 Latent Action + FAST + MoT Actor |
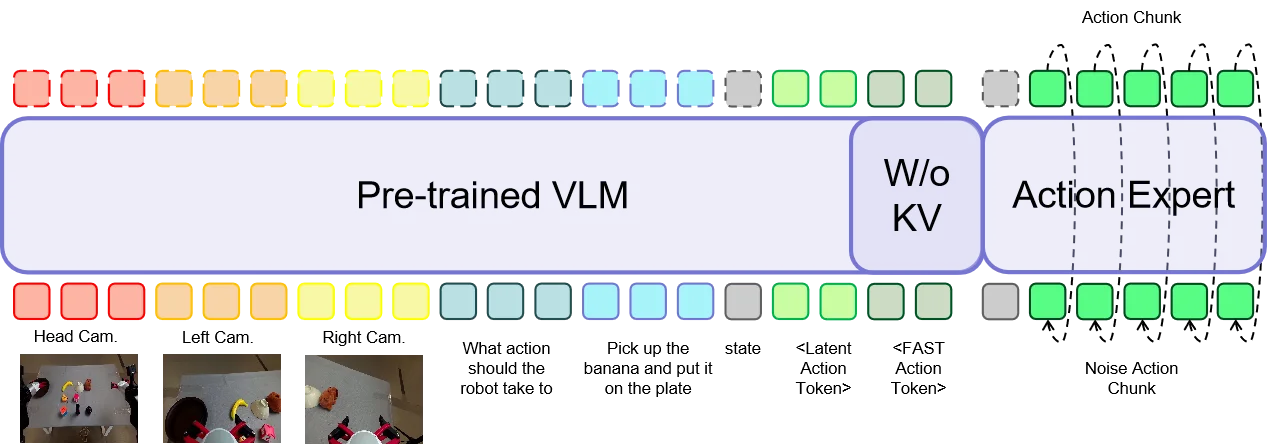
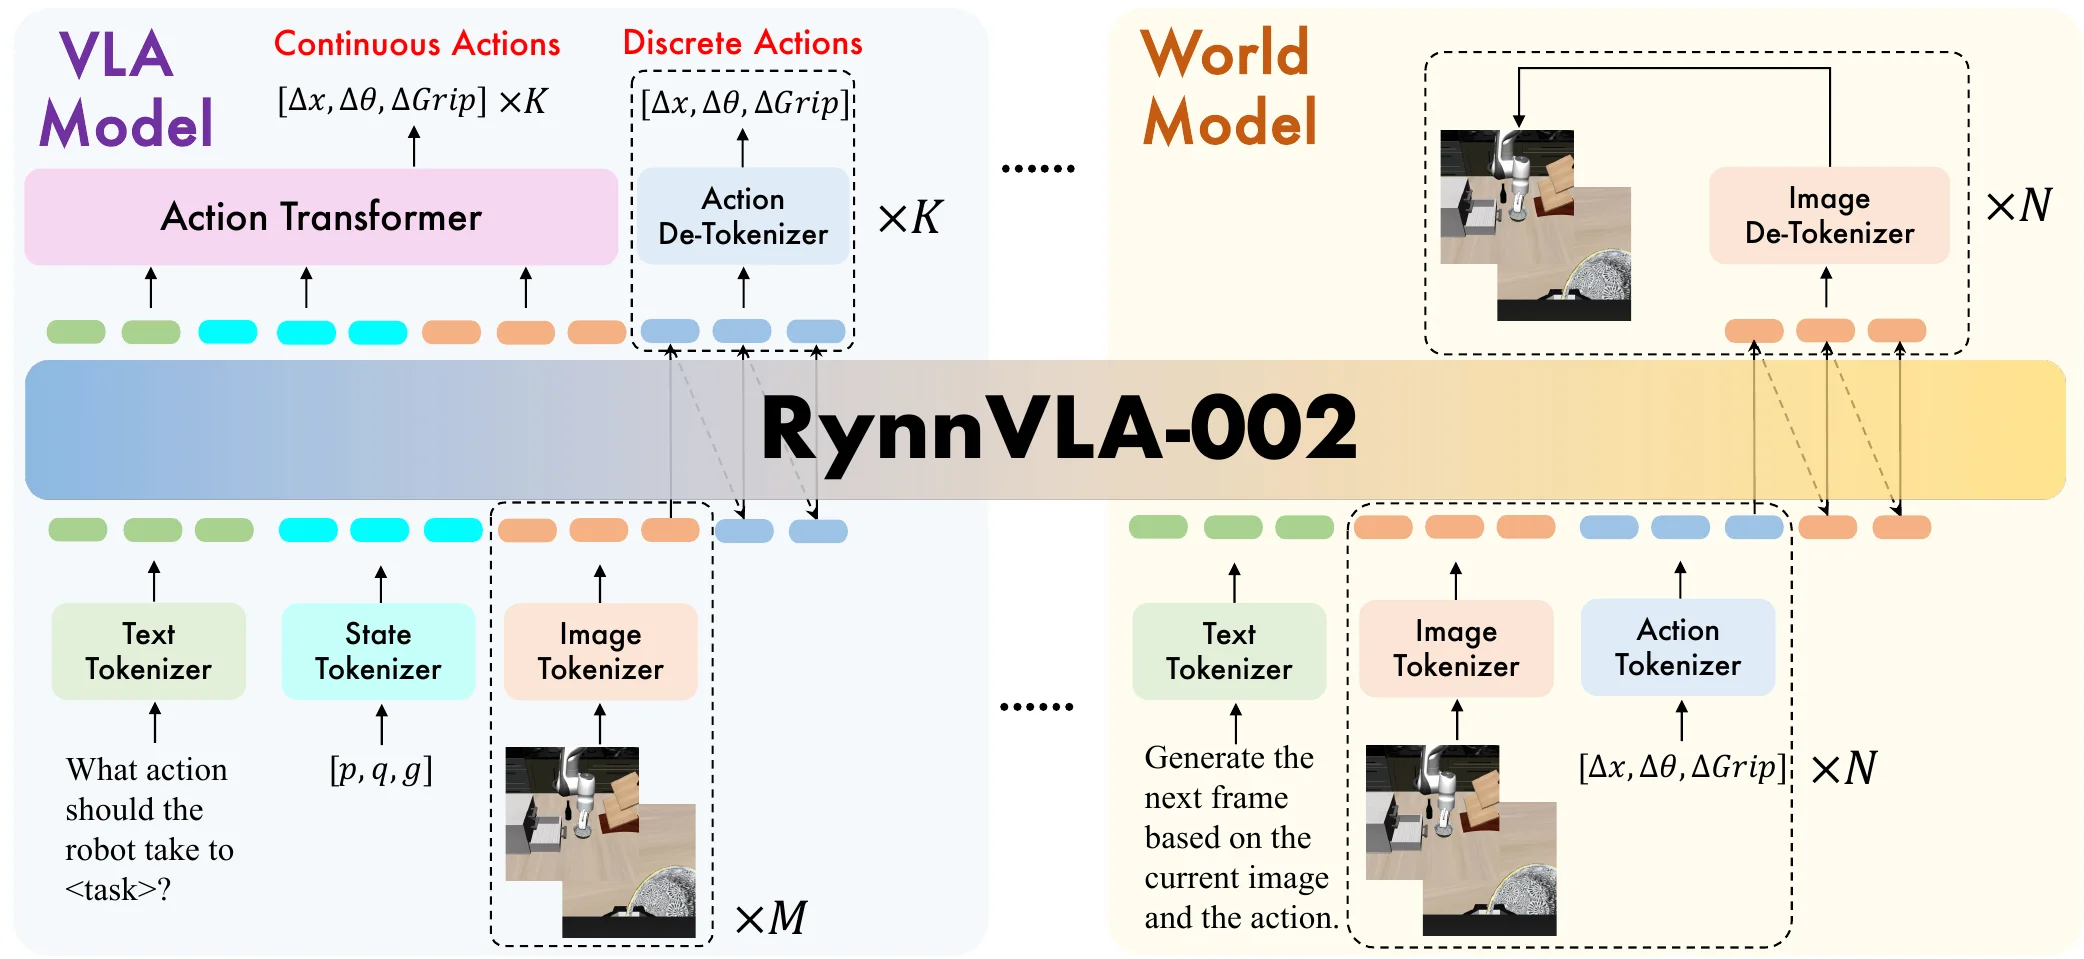
| RynnVLA-002 | 达摩院出品的 UMM-based 同时预测 Future + 离散动作 + DiT Actor |
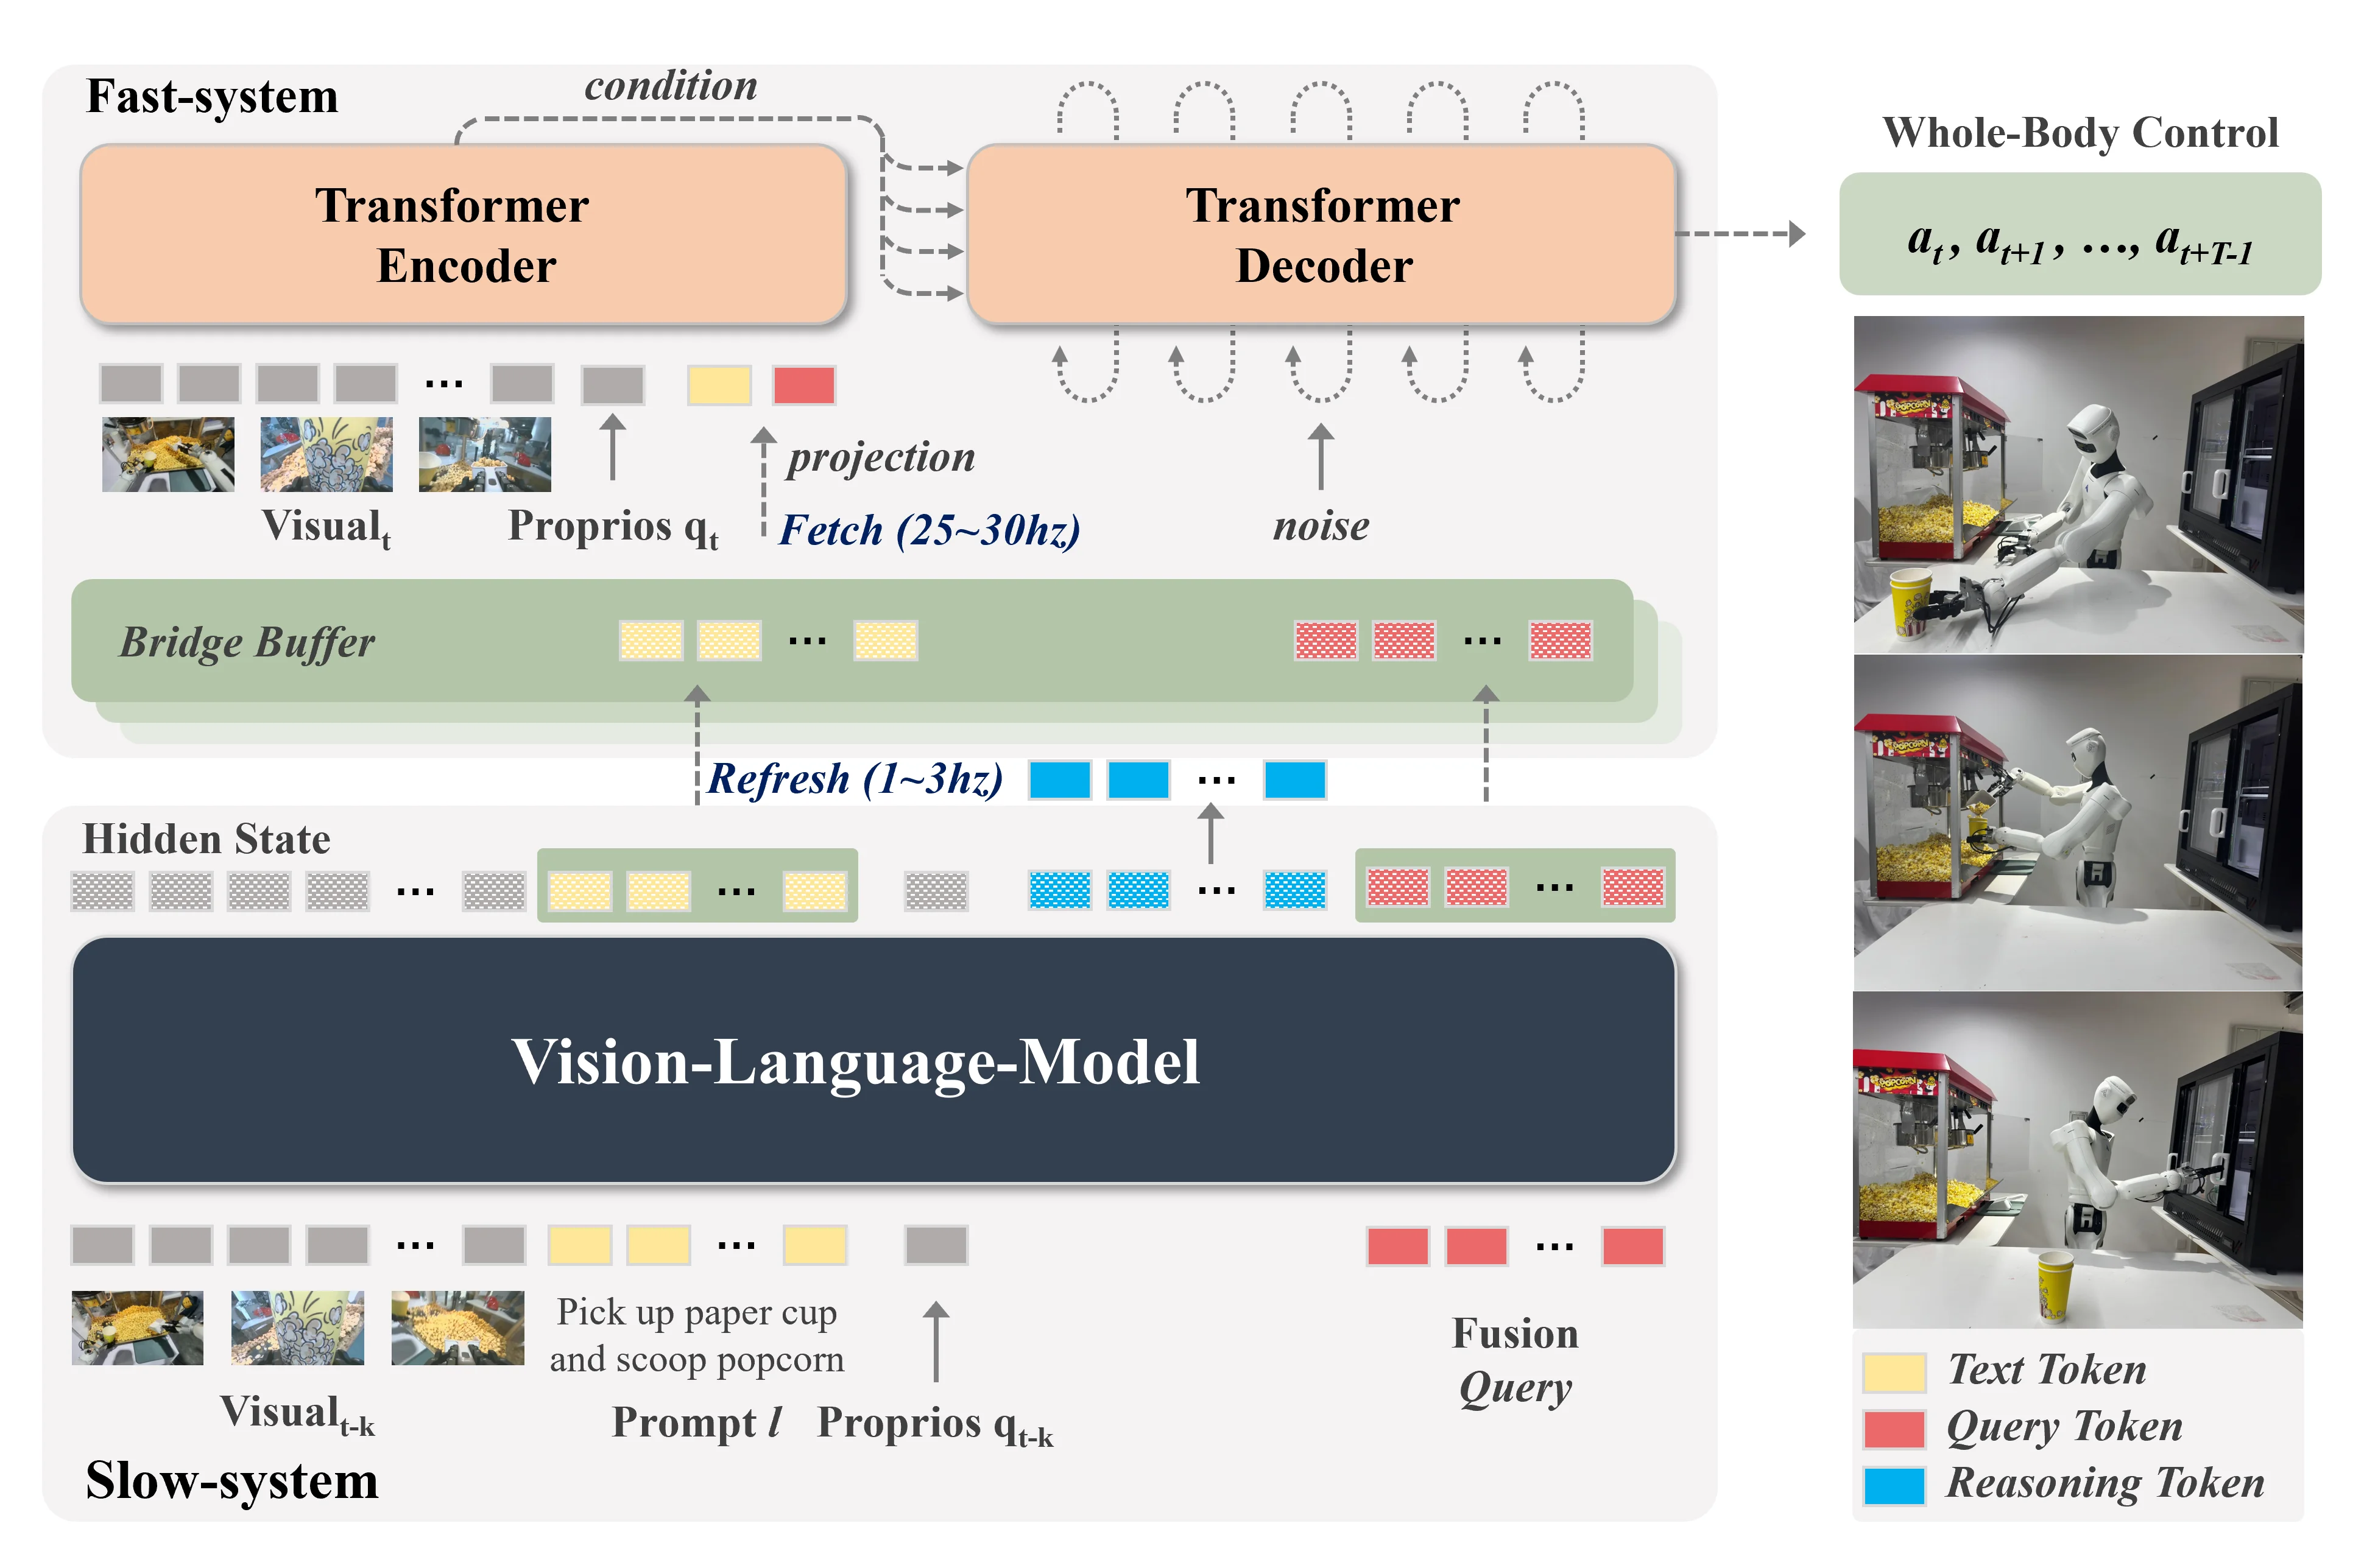
| DuoCore-FS | Astribot 出品的 VLM + Transformer Fusion + Actor |
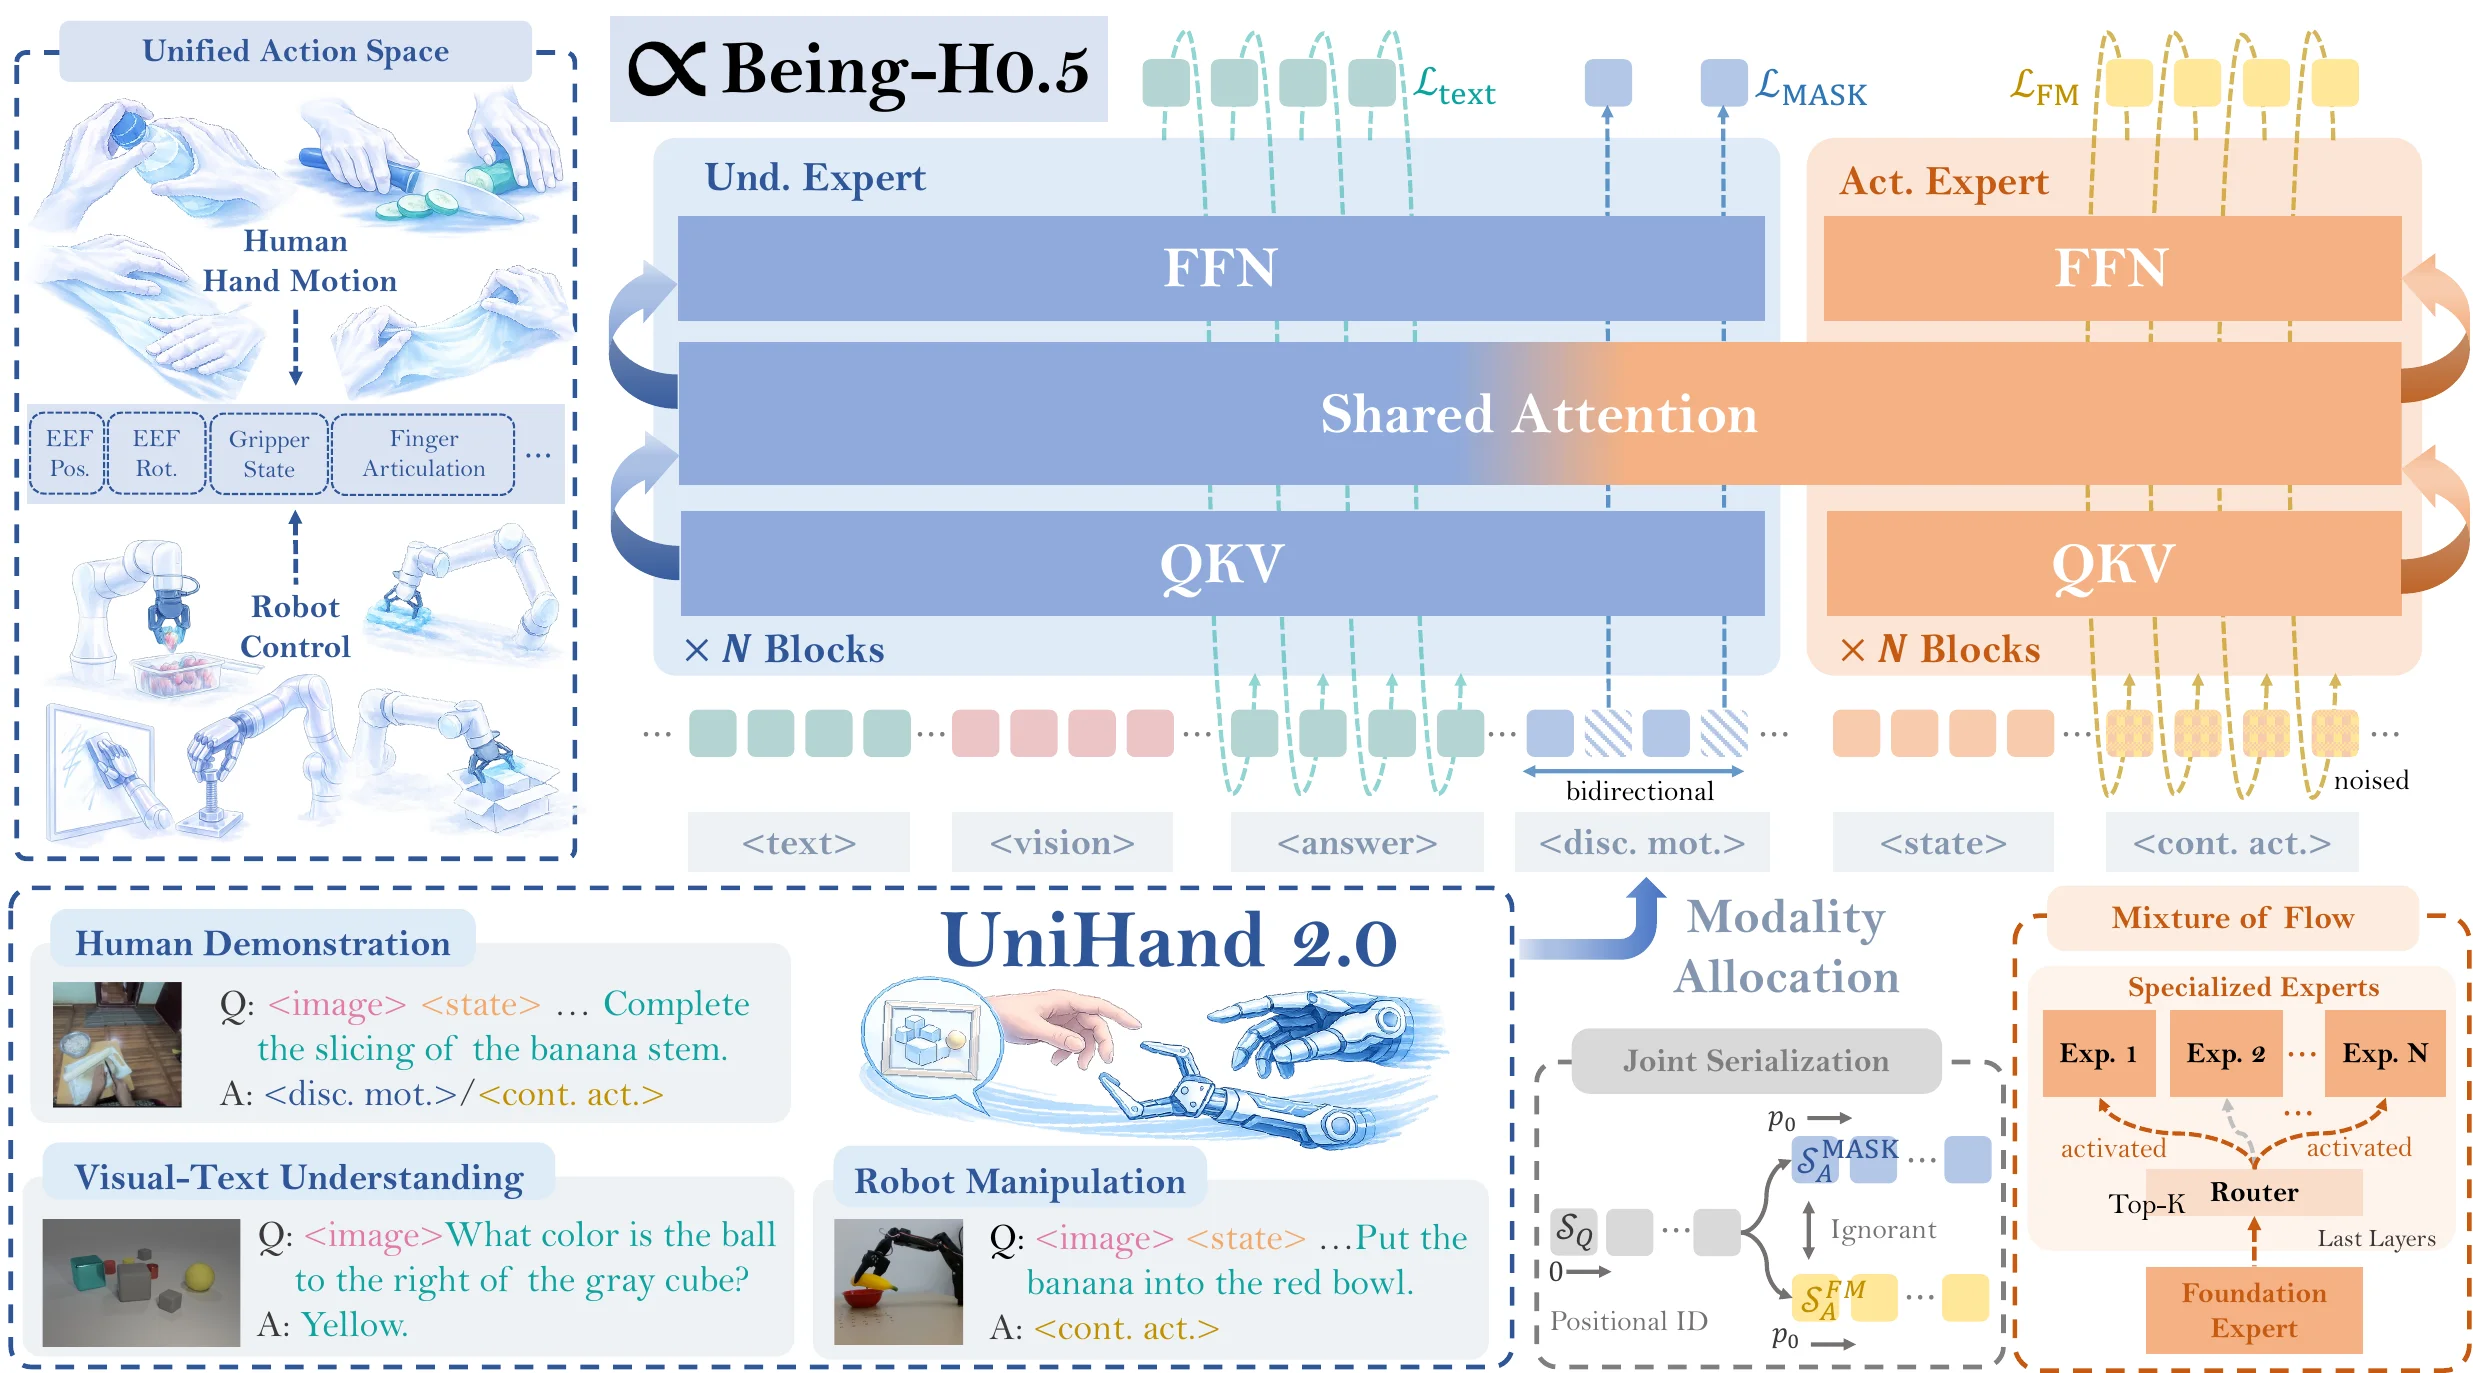
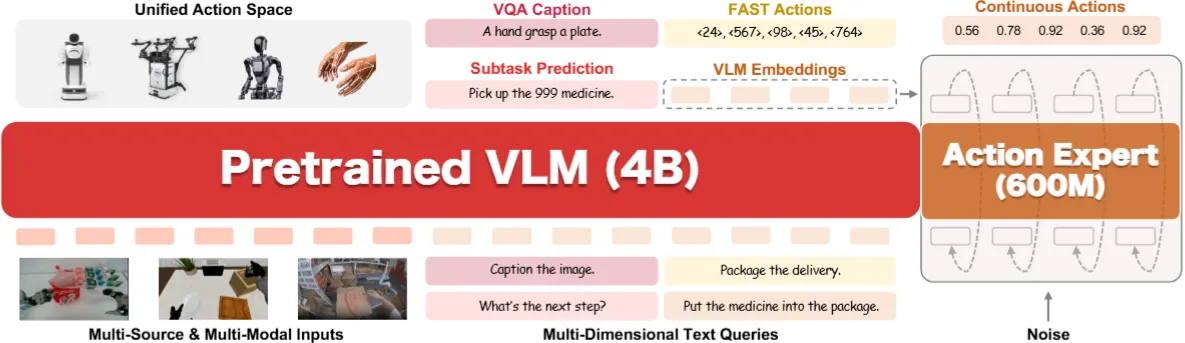
| Being-H0.5 | BeingBeyond 出品的使用 United Action Space 来混训不同本体数据 + VQA 的 Pi |
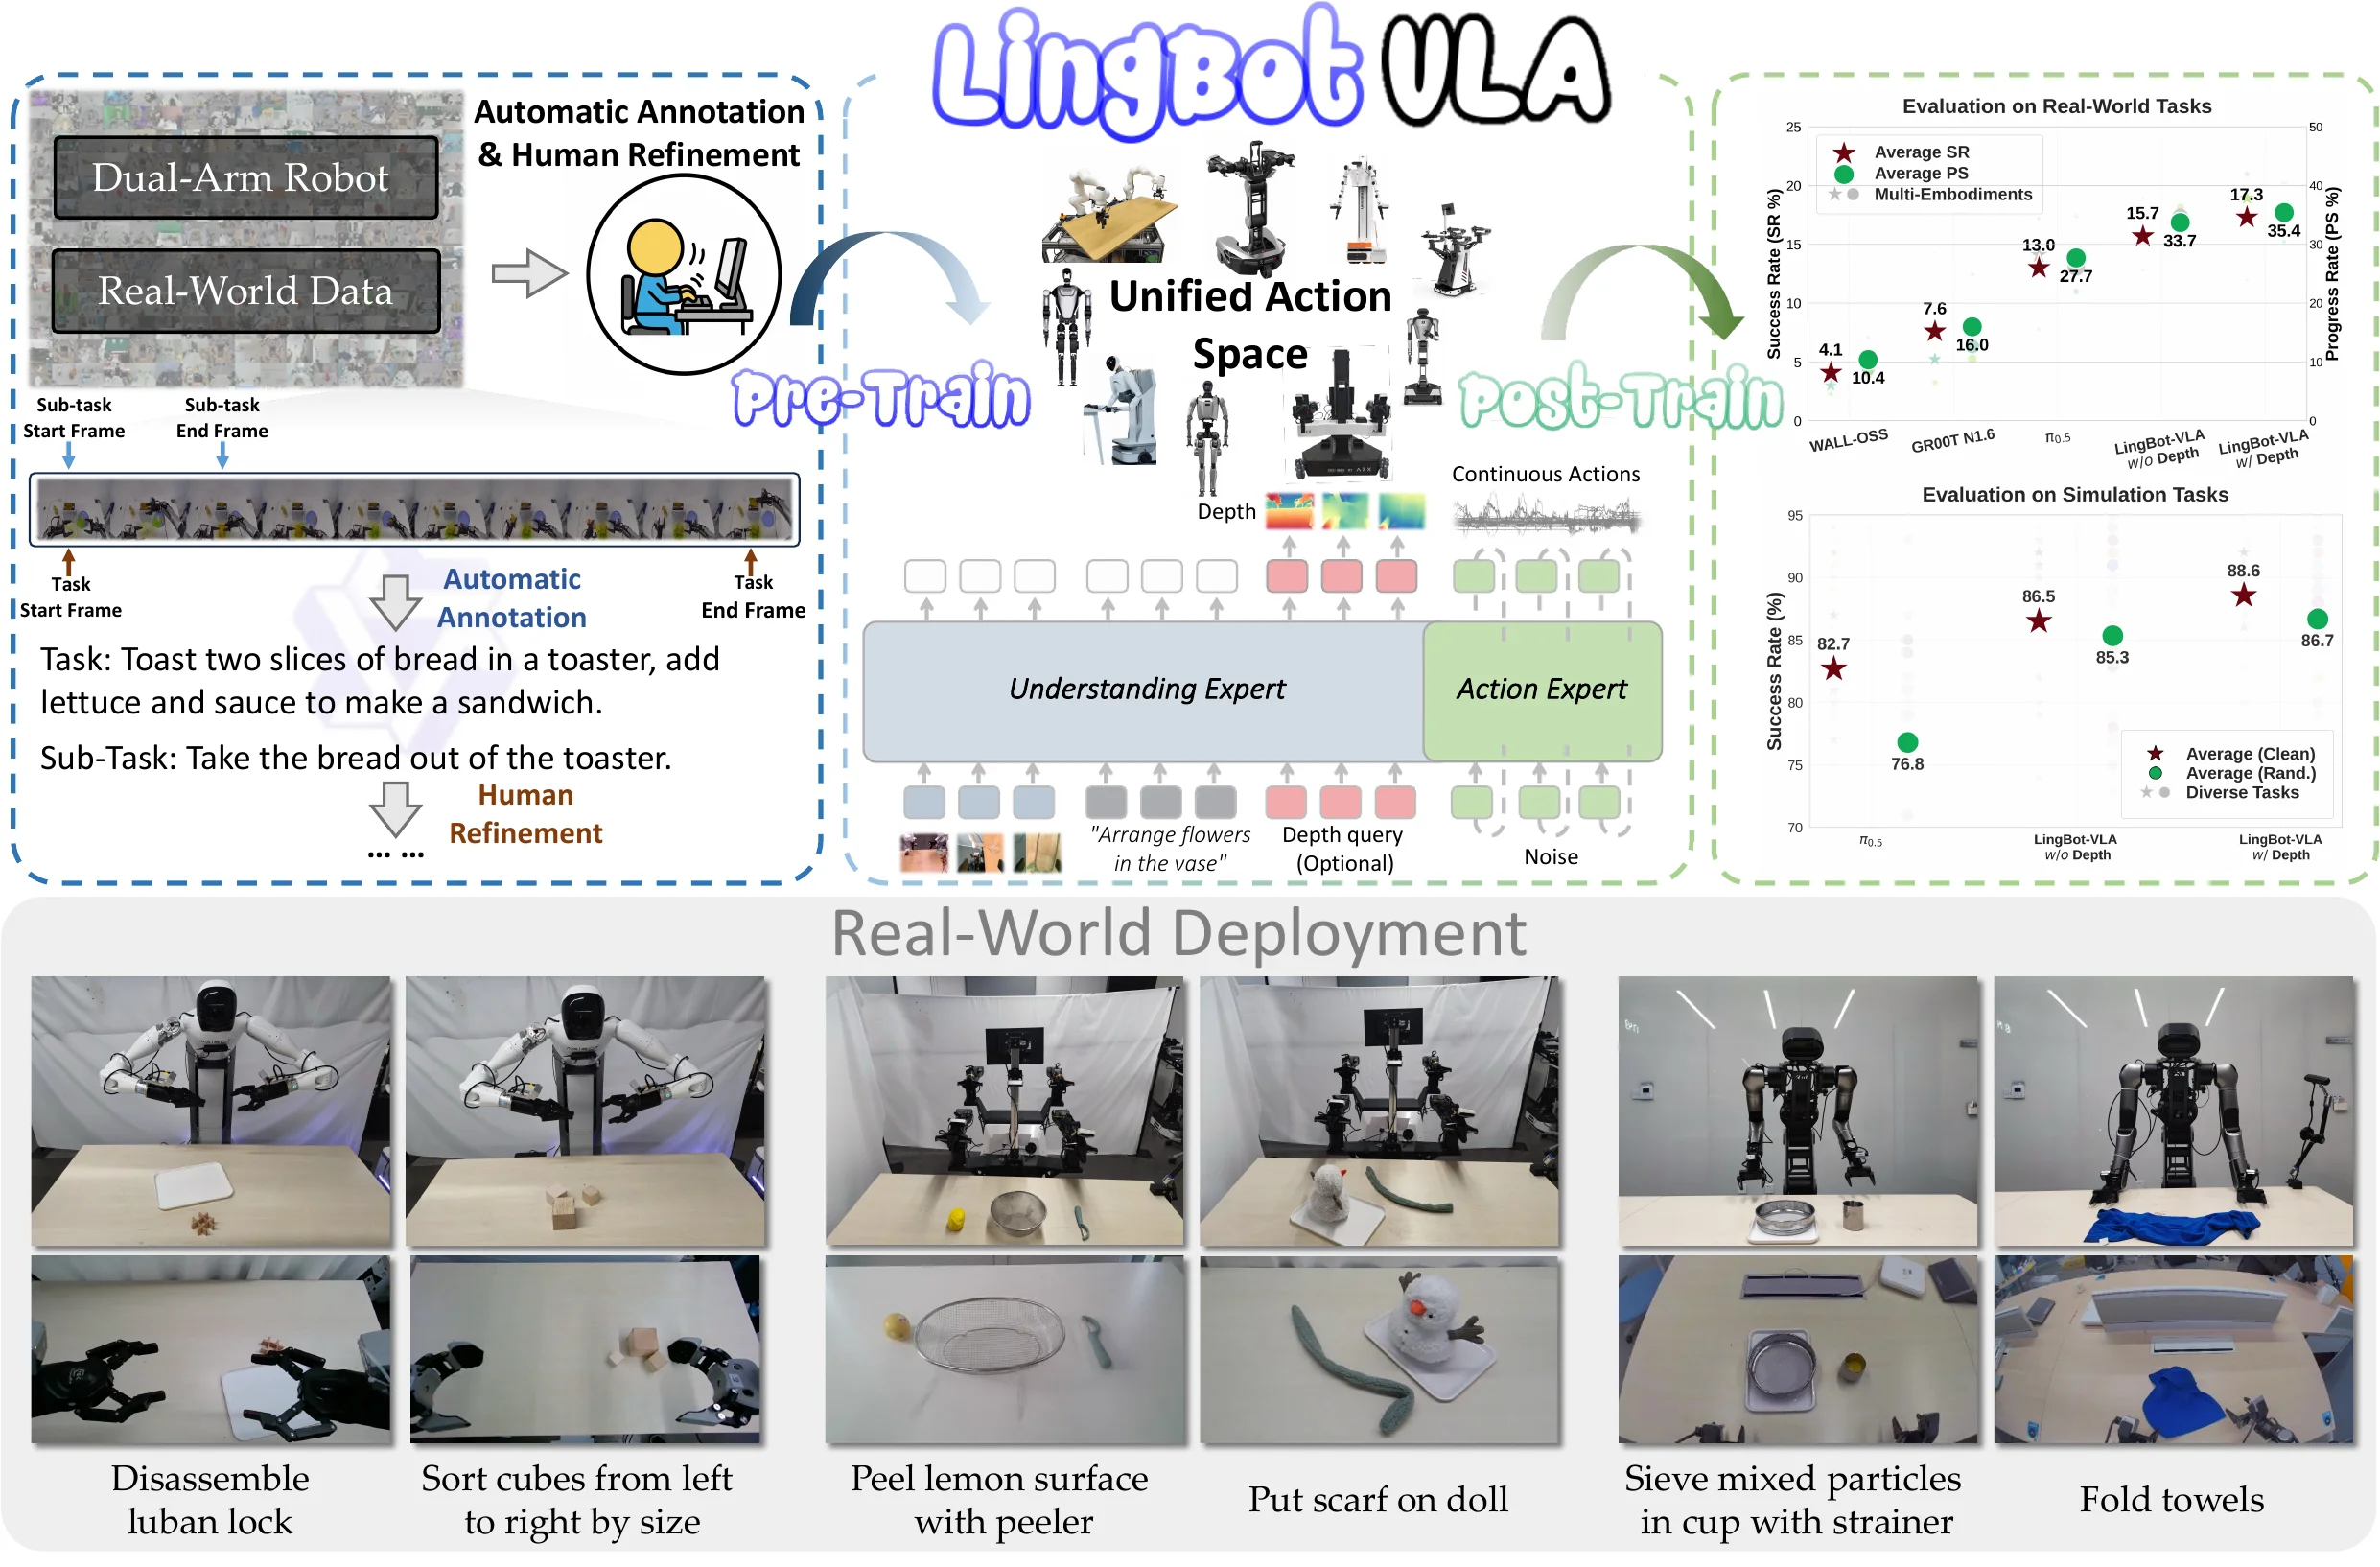
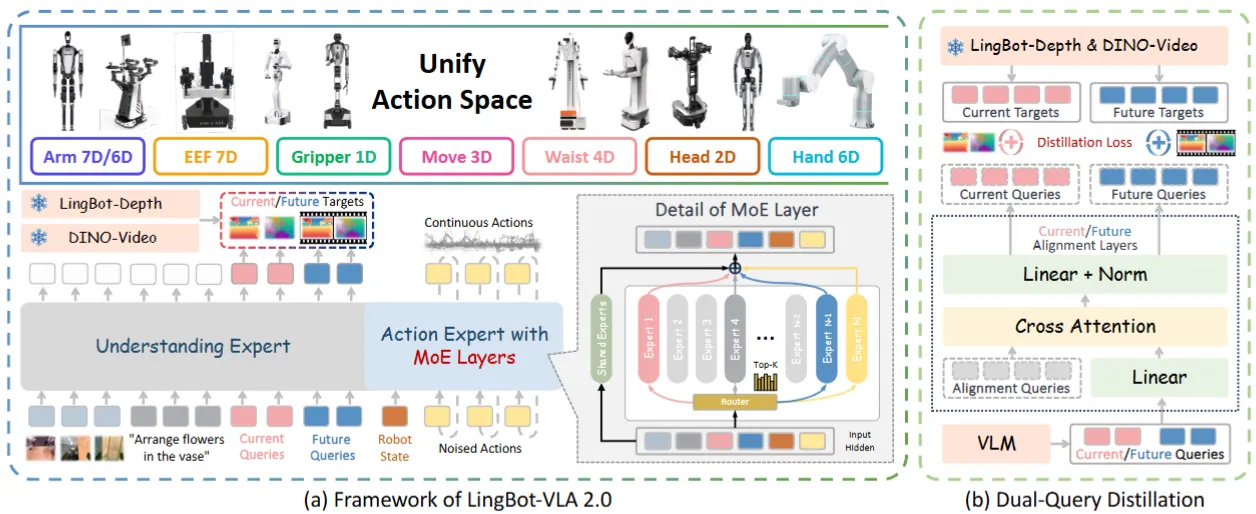
| LingBot-VLA | LingBot 出品的使用自研 LingBot-Depth 添加深度表征,优化 Infra 的跨不同本体 Pi |
| Green-VLA | Sber Robotics Team 出品的 VLM + VLA + RL 全栈的 VLA report,做法中规中矩 |
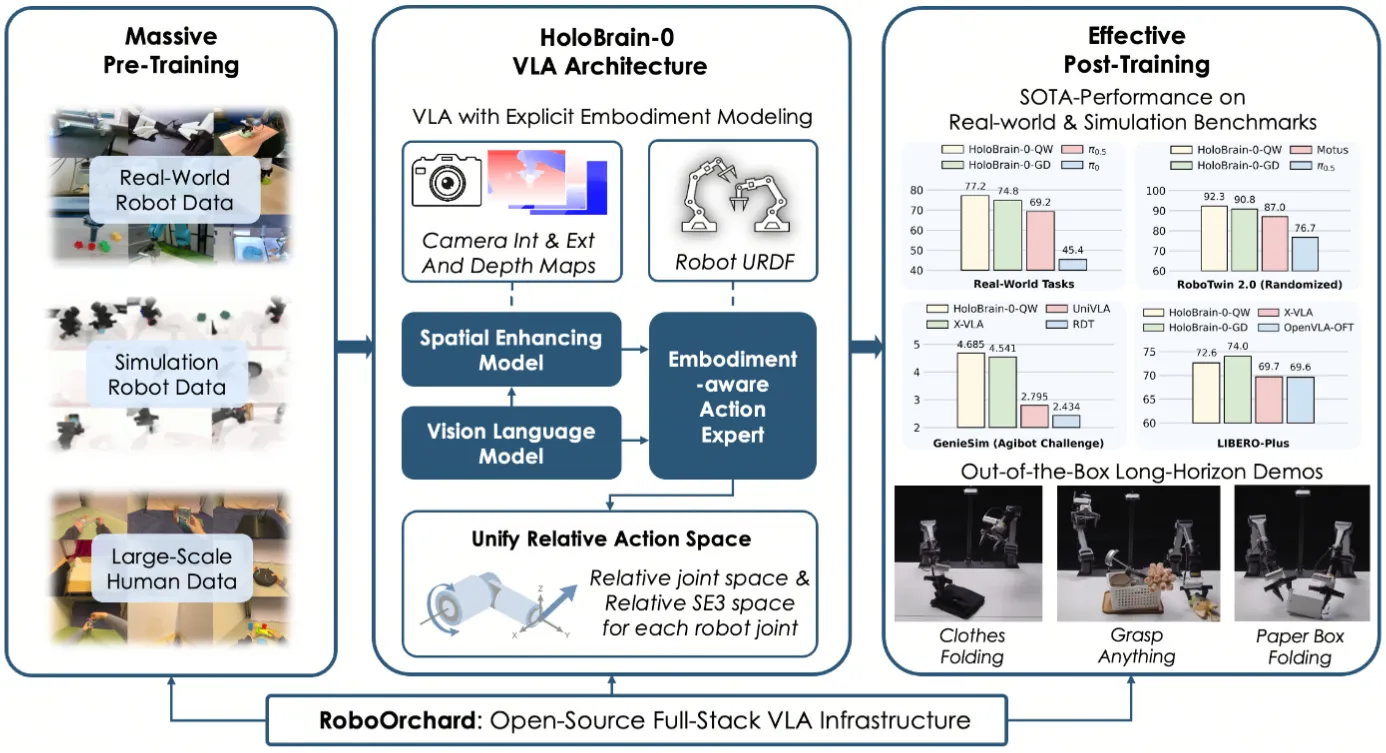
| HoloBrain-0 | 地平线出品的在 Action DiT 里面用 URDF 硬编码一些计算模式的 Pi like VLA |
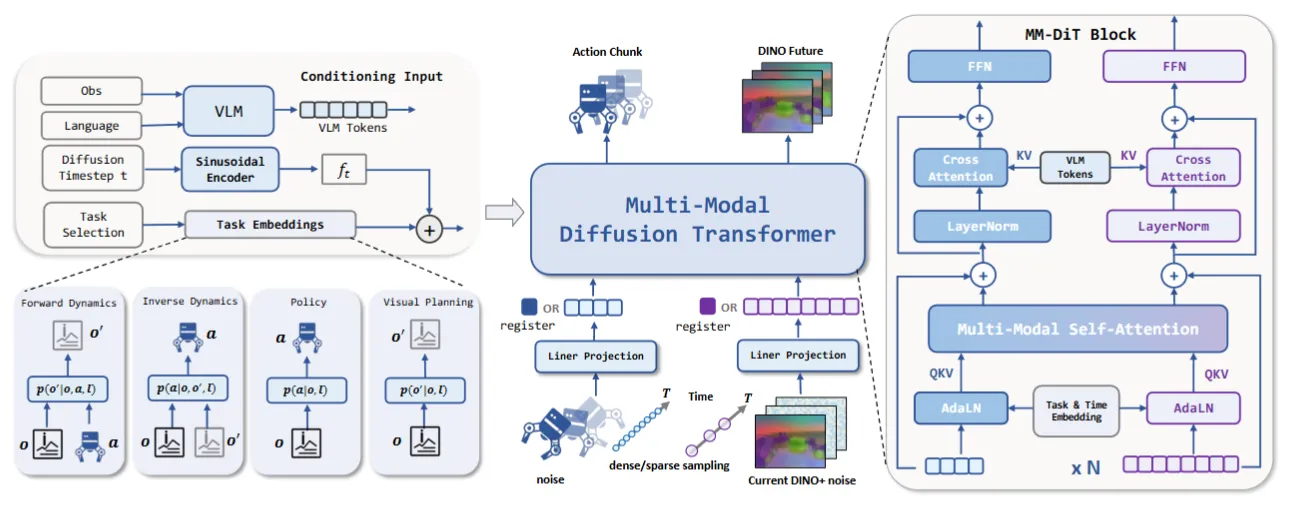
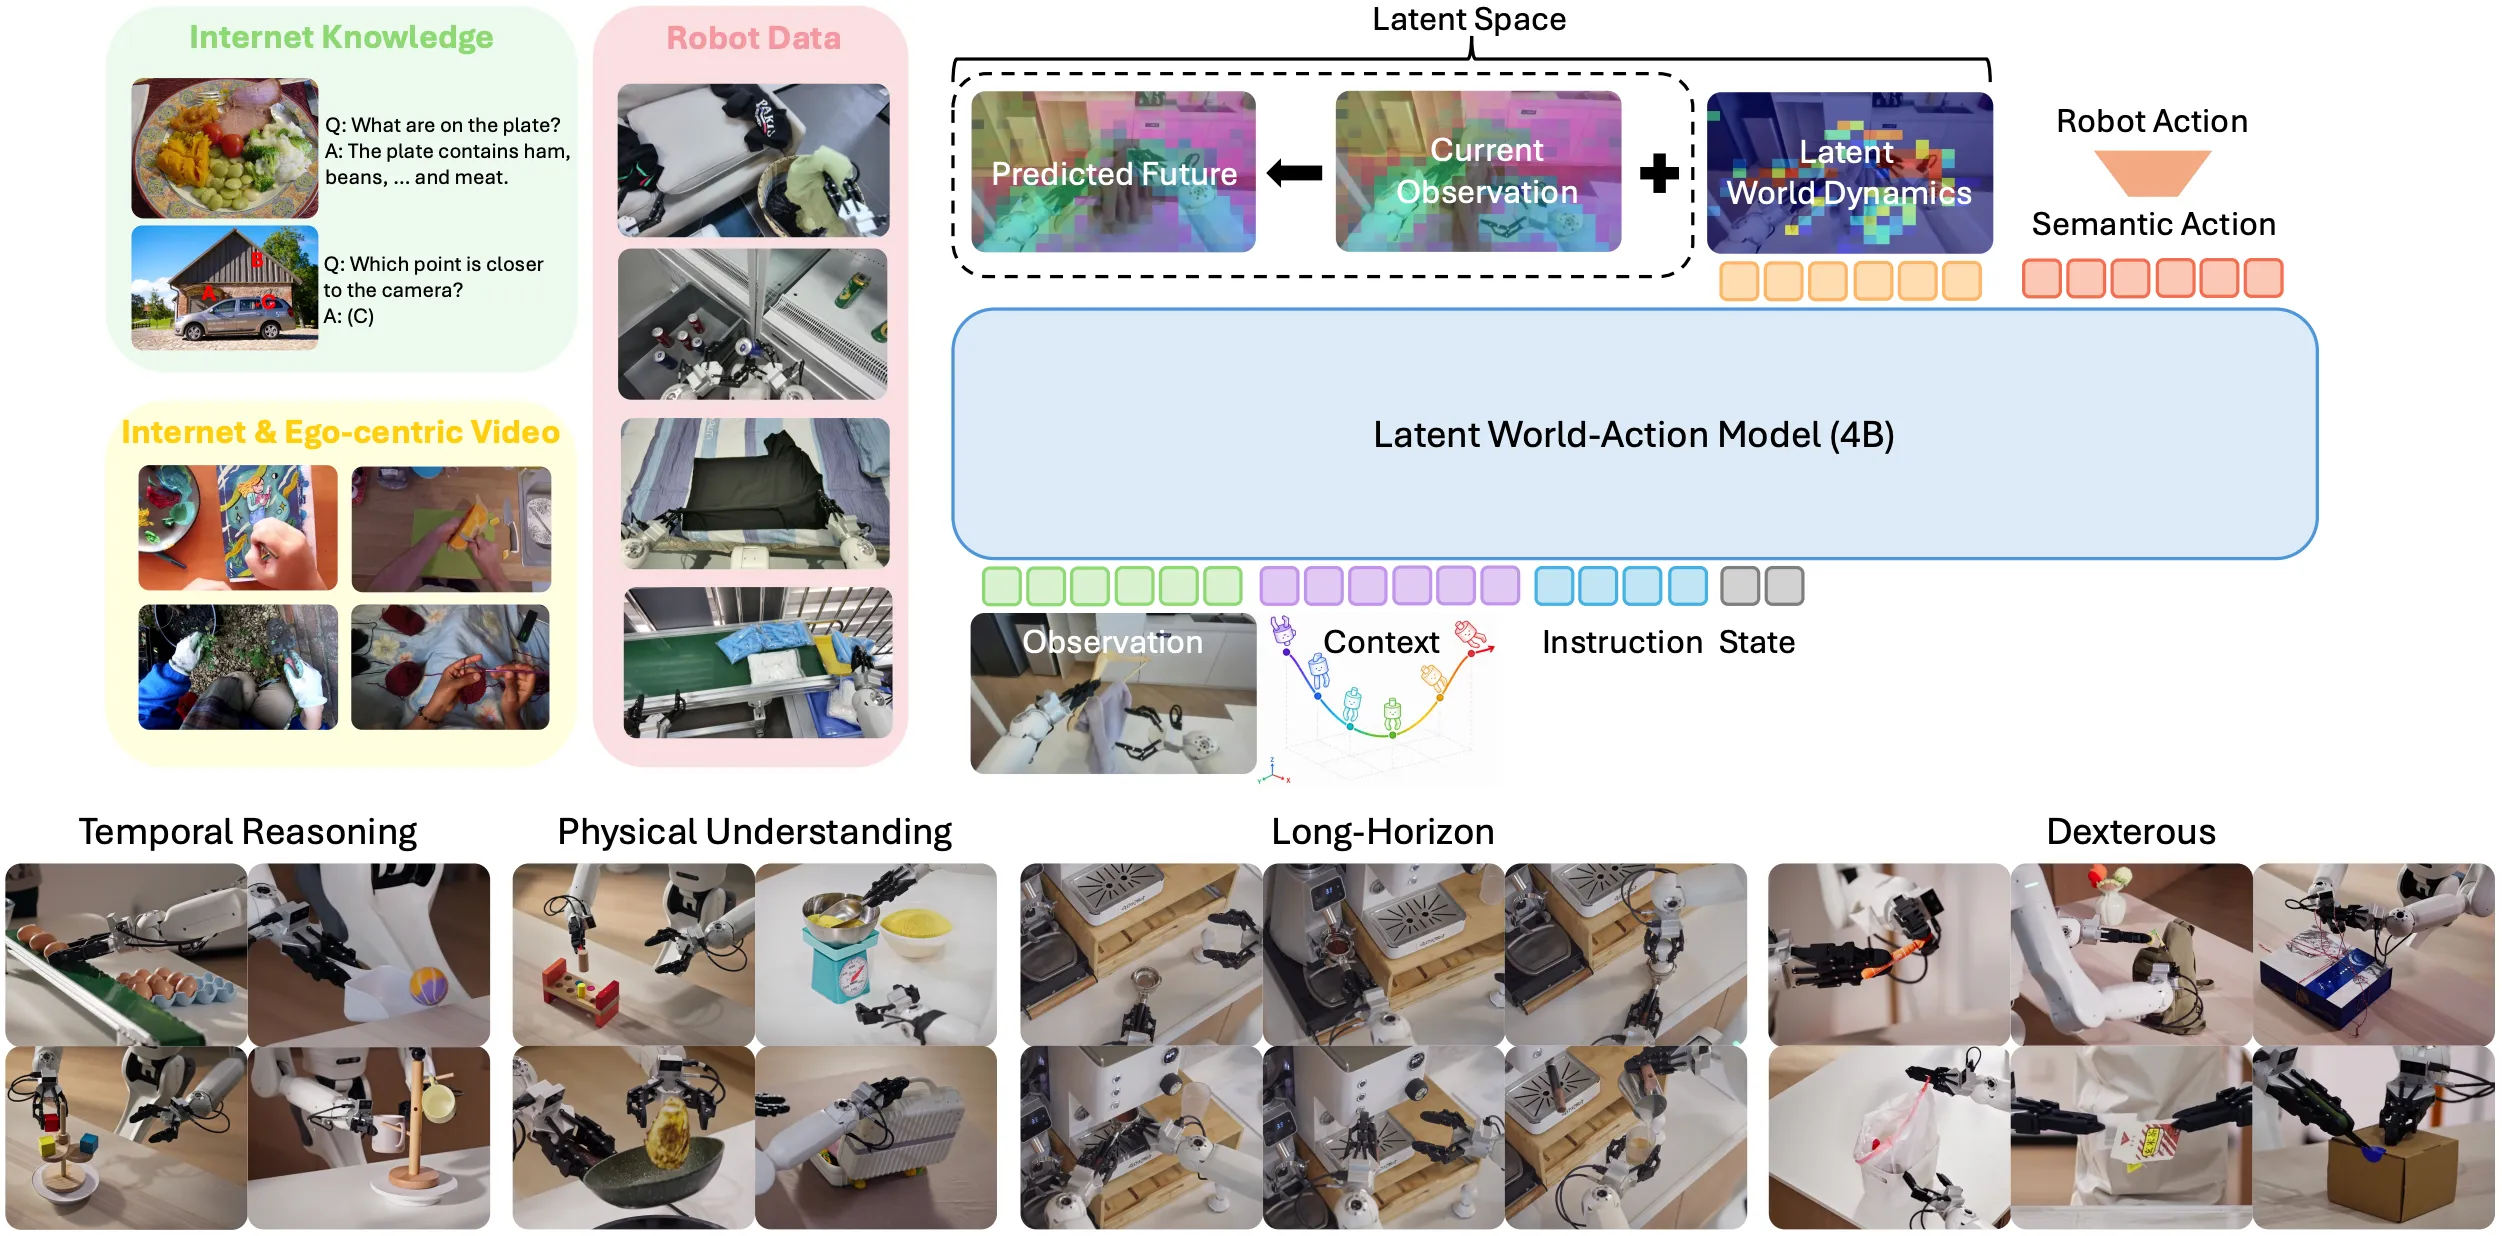
| LDA-1B | Galbot 出品的在 DINO 潜空间里联合预测动力学 / 策略 / 视觉的 MM-DiT 基模 |
| Xiaomi-Robotics-0 | 小米的 Choice Policy 训 VLM Action + Pi like VLA + 异步适配 Training RTC |
| DM0 | Dexmal 出品的 VLA,VL 输入之后进行多轮推理,然后之后输出 Action,以及不推理模式,包含可观经验以及预训练 |
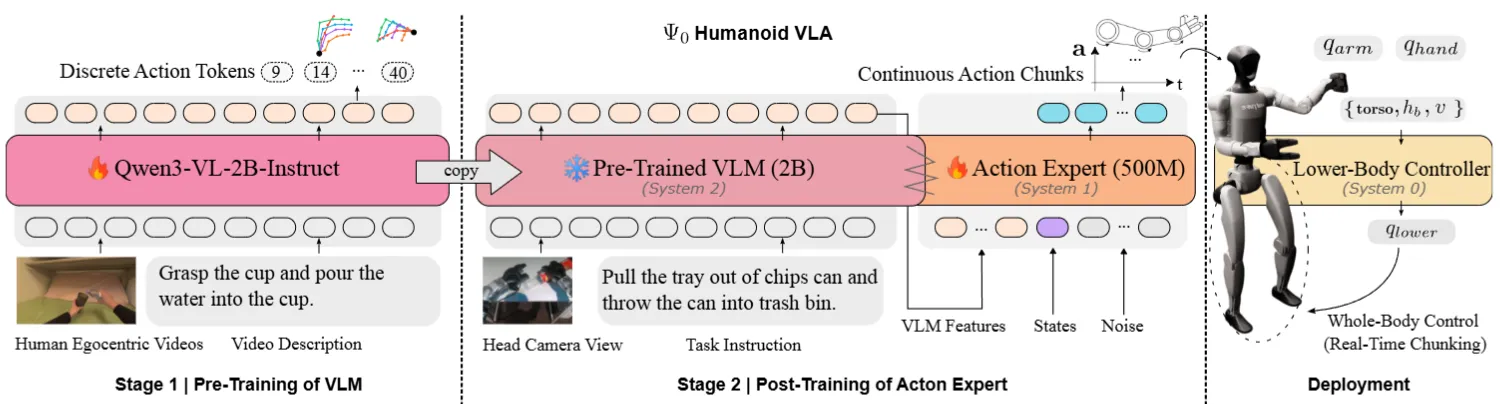
| PSI Lab 出品的 Ego 视频预训 + 机器人后训 + AMO 底层控制的三层 Humanoid VLA | |
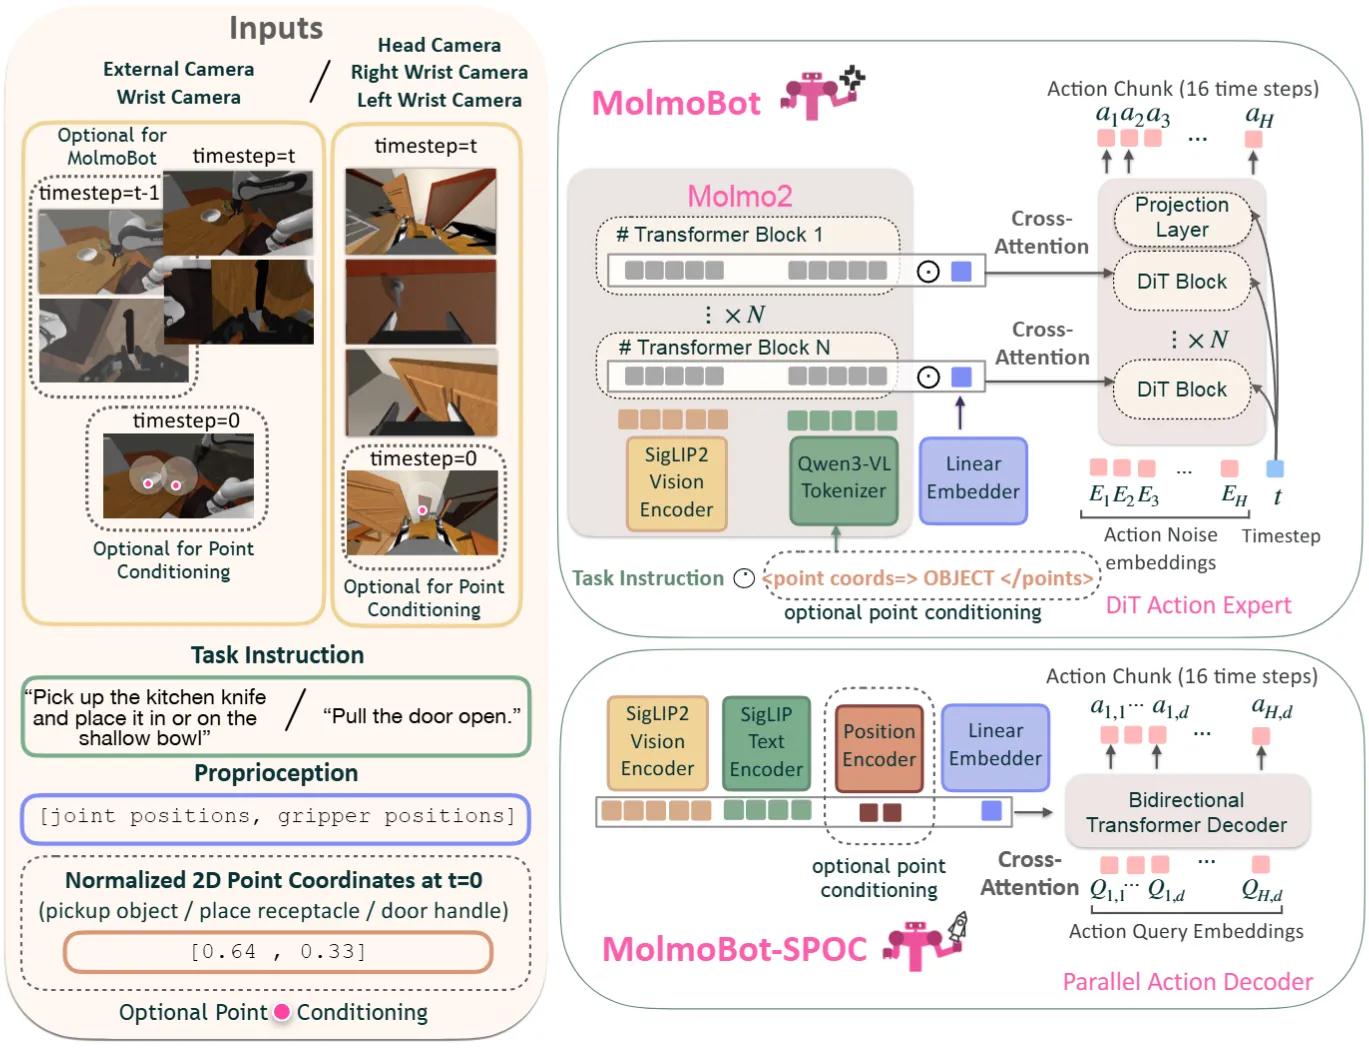
| MolmoB0T | AllenAI 出品的 Molmo2 + 1.7M 纯合成数据零样本到真机,cross-attn 接 VLM 中间 hidden state |
| JoyAI-RA 0.1 | JD 出品的 VLM + Fast Token + Actor Pi-like MoT 模型 |
| MotuBrain | 生数出品的更完善的 Motus-like MoT 模型,以及一些细节优化,如使用 H-bridge attn |
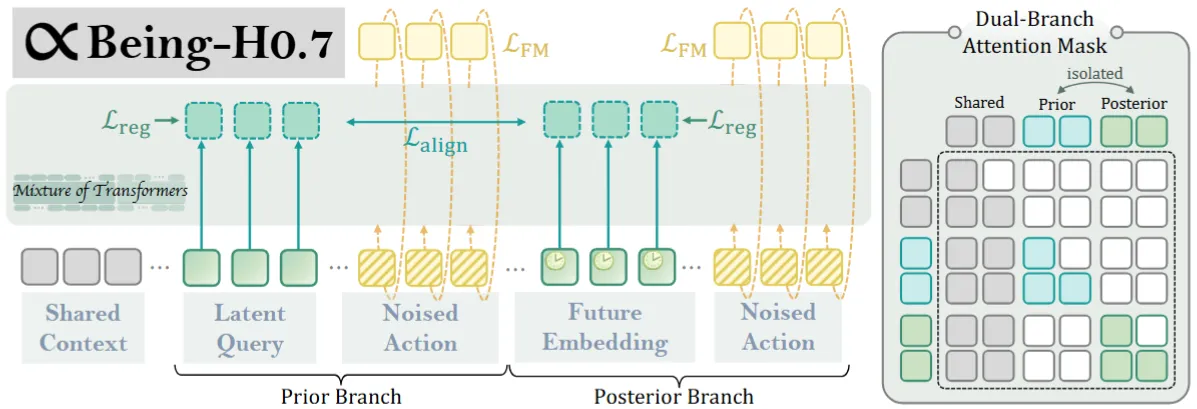
| Being-H0.7 | BeingBeyond 出品的使用 Latent Query 以及 Future Embedding,最后预测 Action 的 MoT |
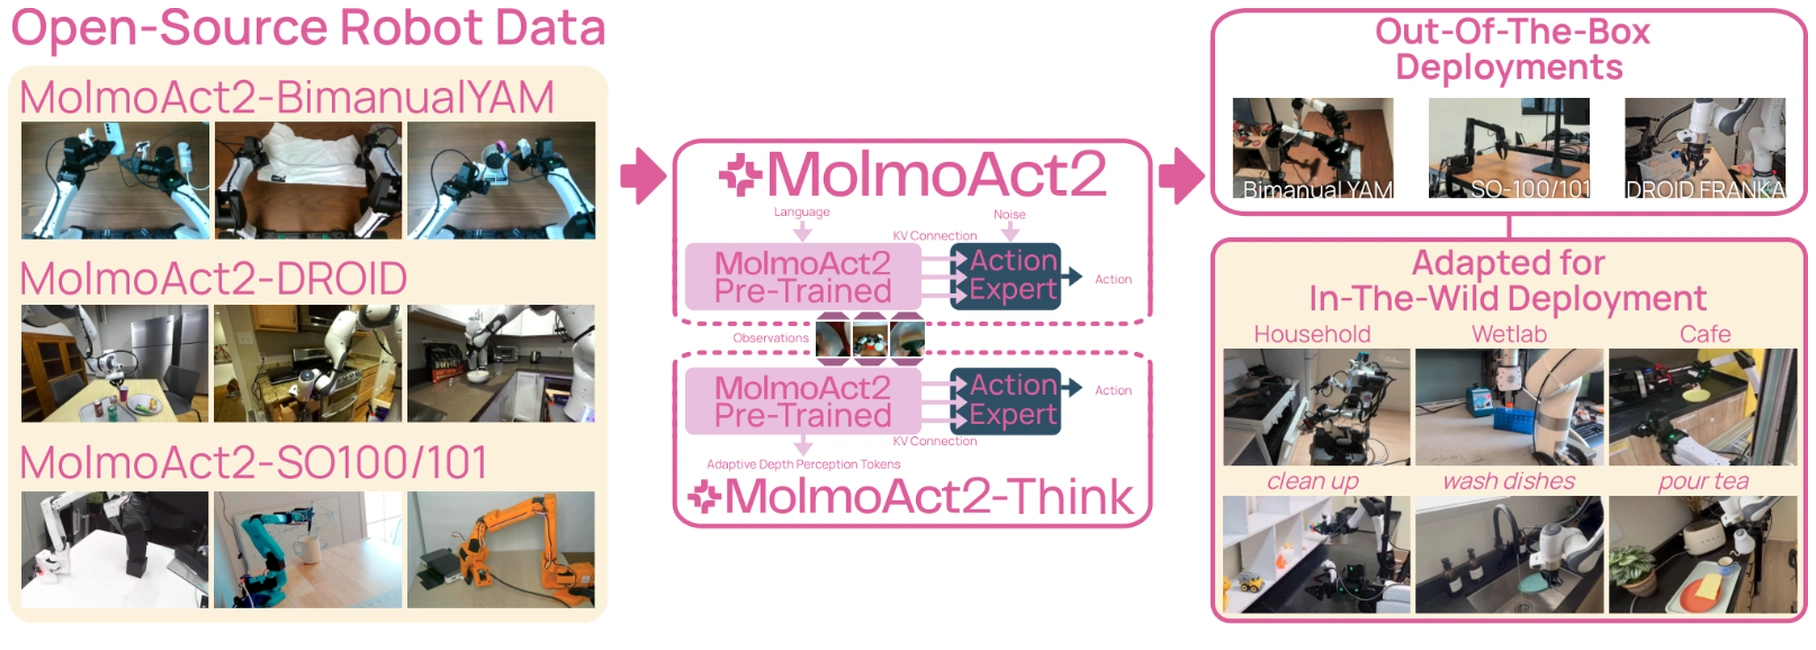
| MolmoAct2 | AllenAI 出品的 Molmo2ER VLM + 预训练 Pi-like MoT 模型 |
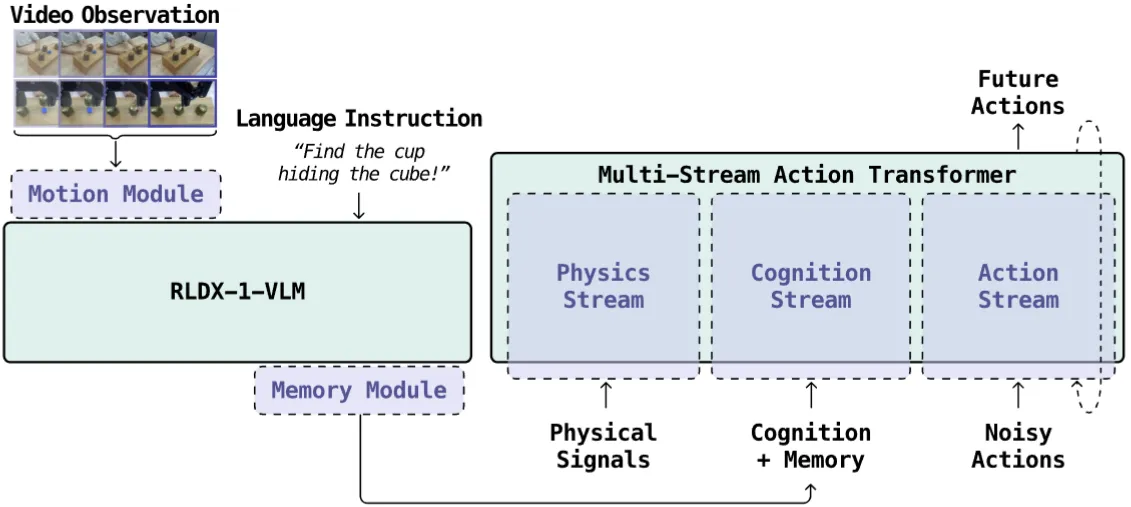
| RLDX-1 | RLWRLD 出品的 VLM 预训练 + VLM 中训练 + Actor 后训练的支持记忆以及触觉的 GR00t-like 模型 |
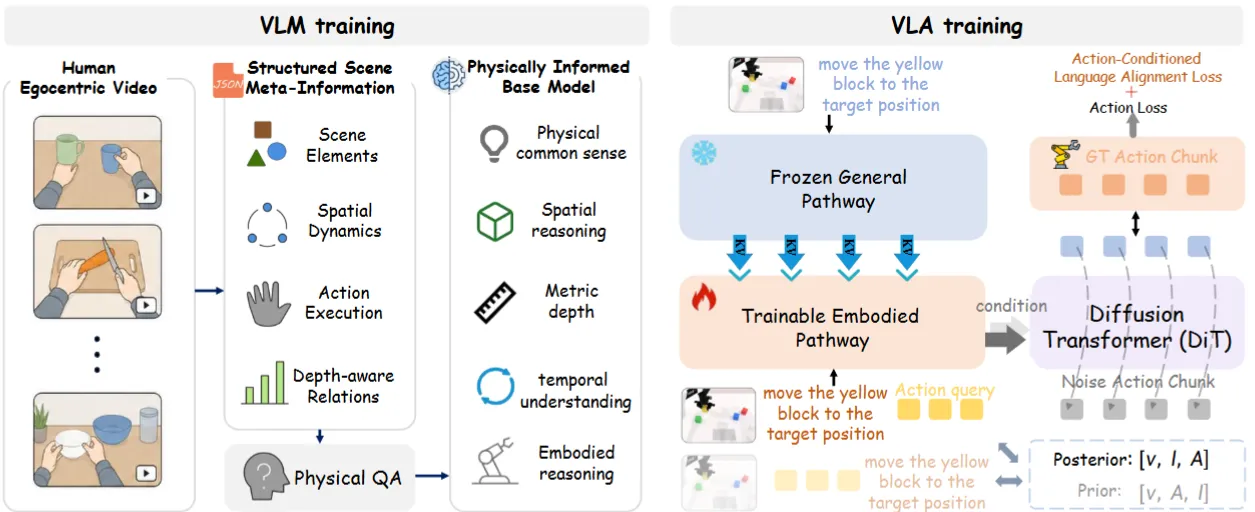
| PhysBrain 1.0 | 中关村学院出品的 LangForce 在 VLM + VLA 流程的技术报告,用 VLA 和 VAL 顺序输入数据并对齐 L |
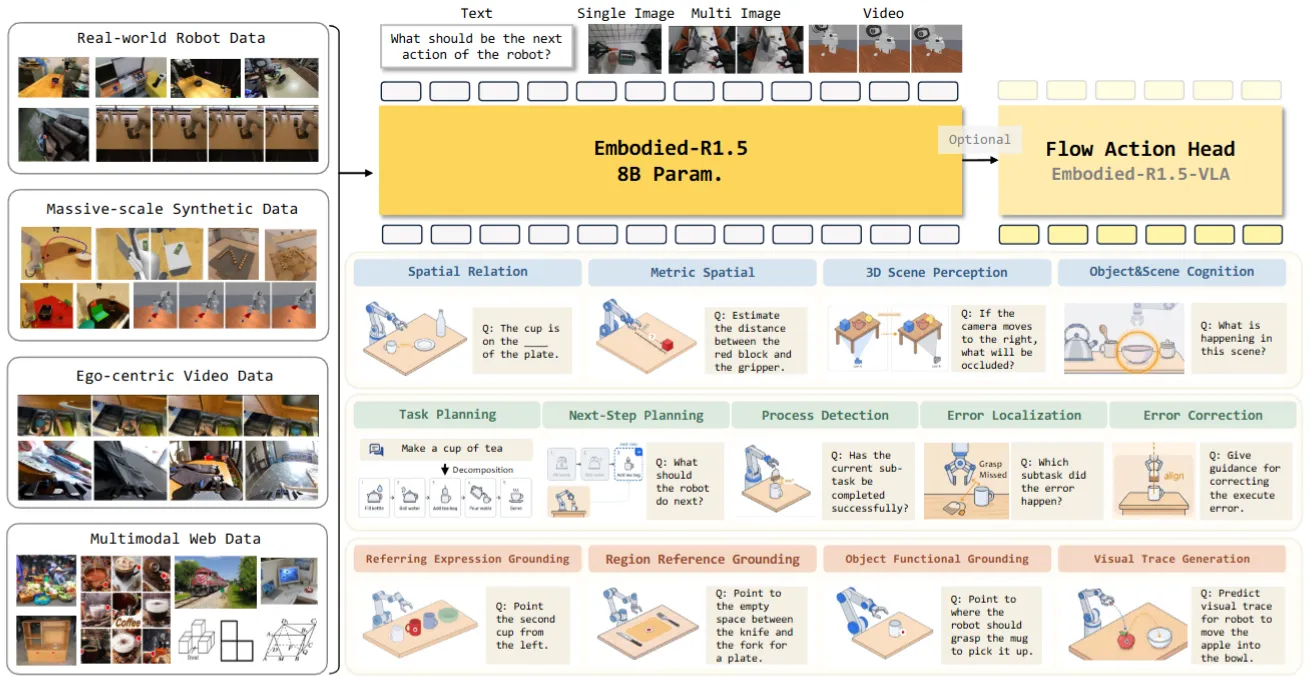
| Embodied-R1.5 | Hunyuan 出品的预训练具身 VLM + 可后训练 VLA |
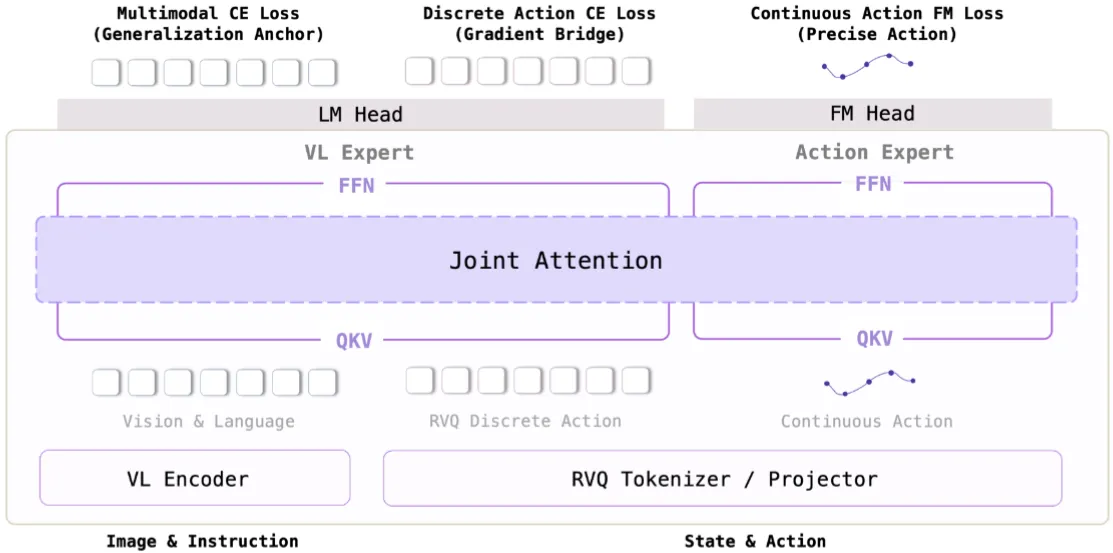
| Wall-OSS-0.5 | 自变量机器人出品的预训练 Pi-like MoT |
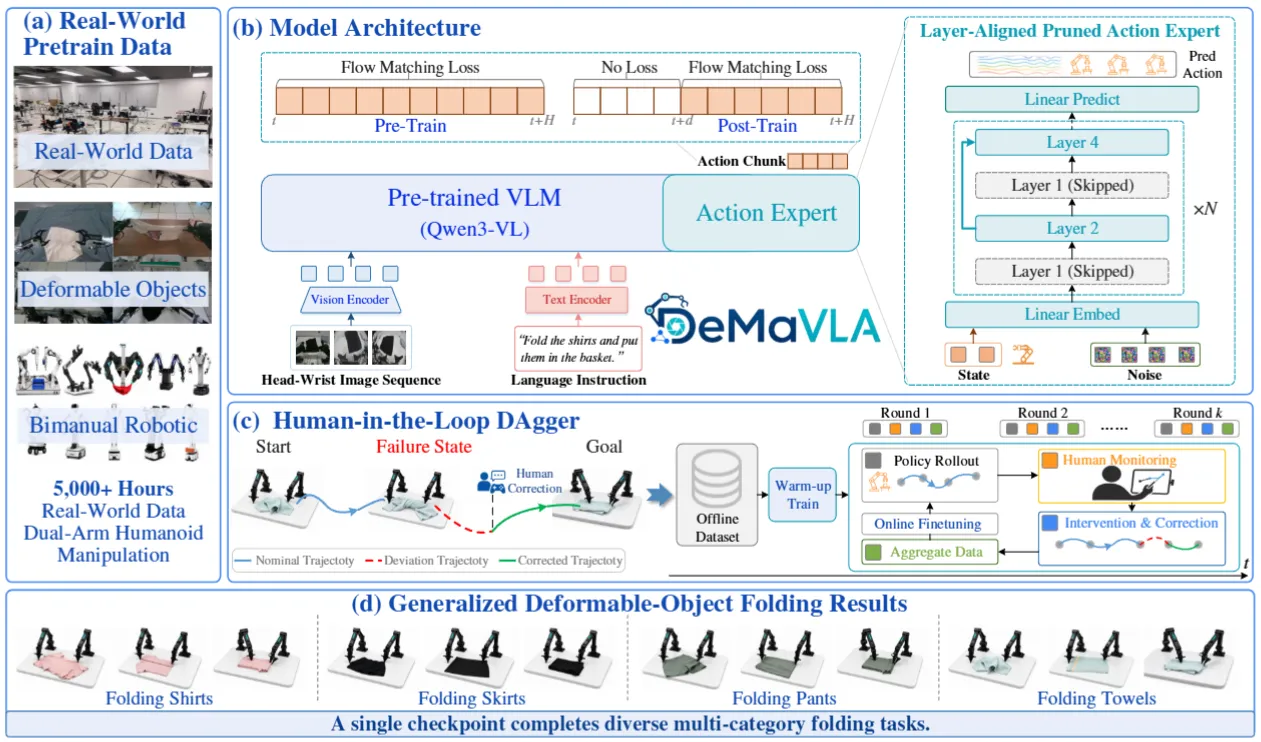
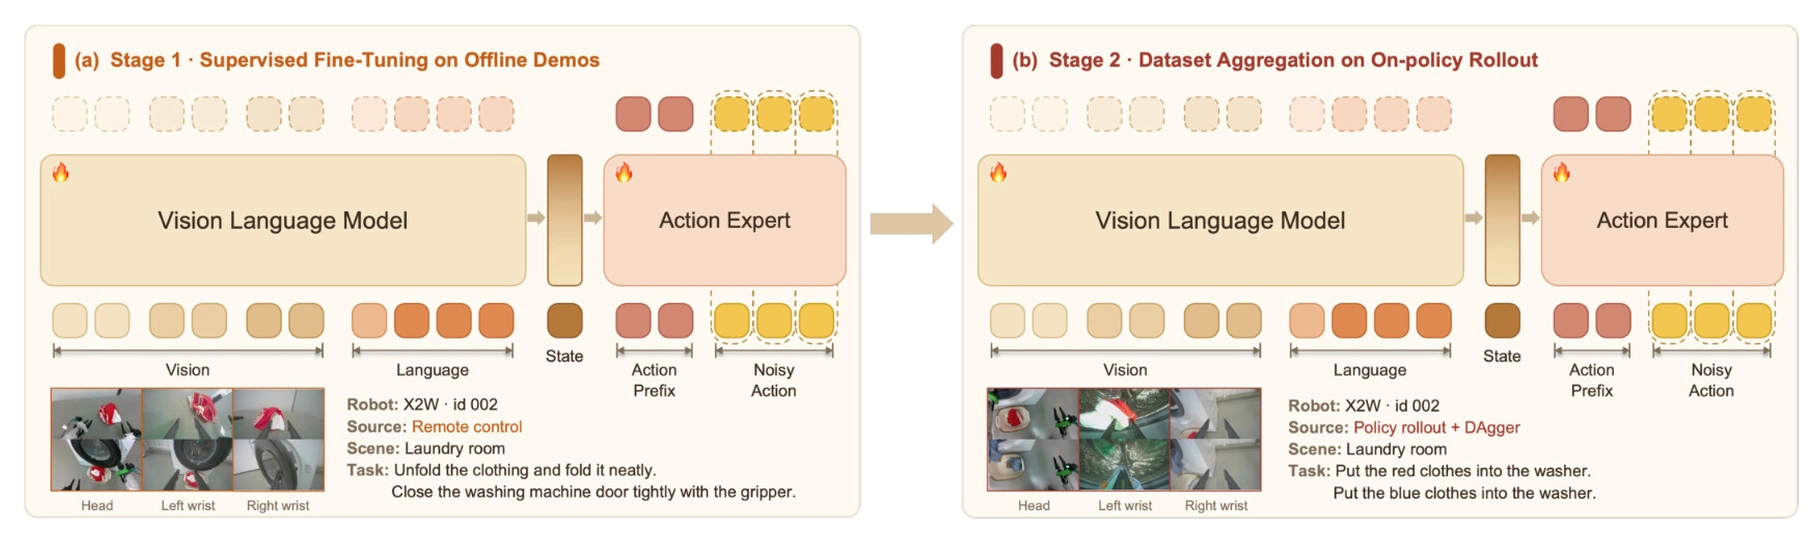
| DeMaVLA | 美的出品的预训练 Pi-like MoT + Training RTC + DAgger |
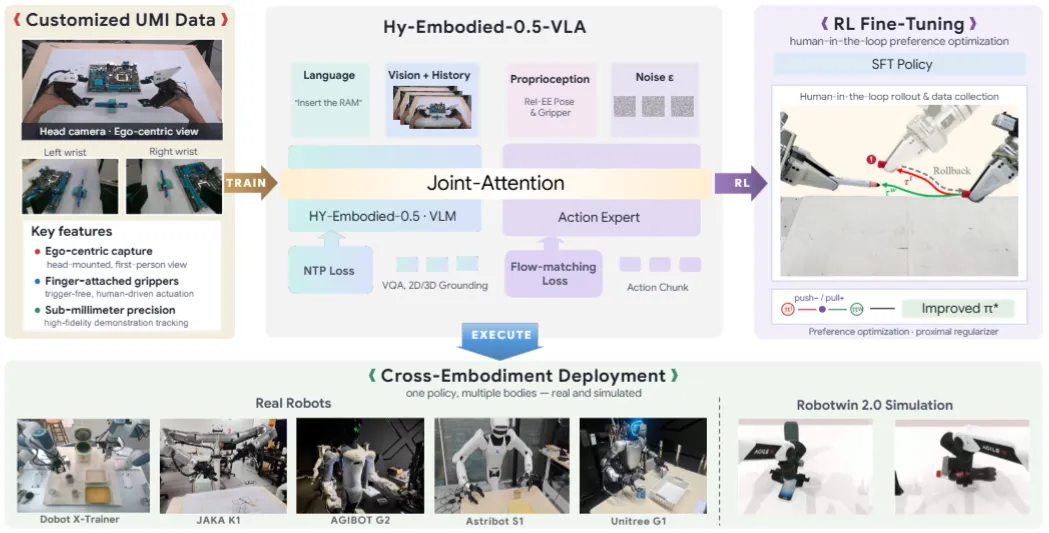
| Hy-Embodied-0.5-VLA | Hunyuan 出品的基于 Hunyuan VLM + Actor MoT 的预训练模型 + RL 后训练 |
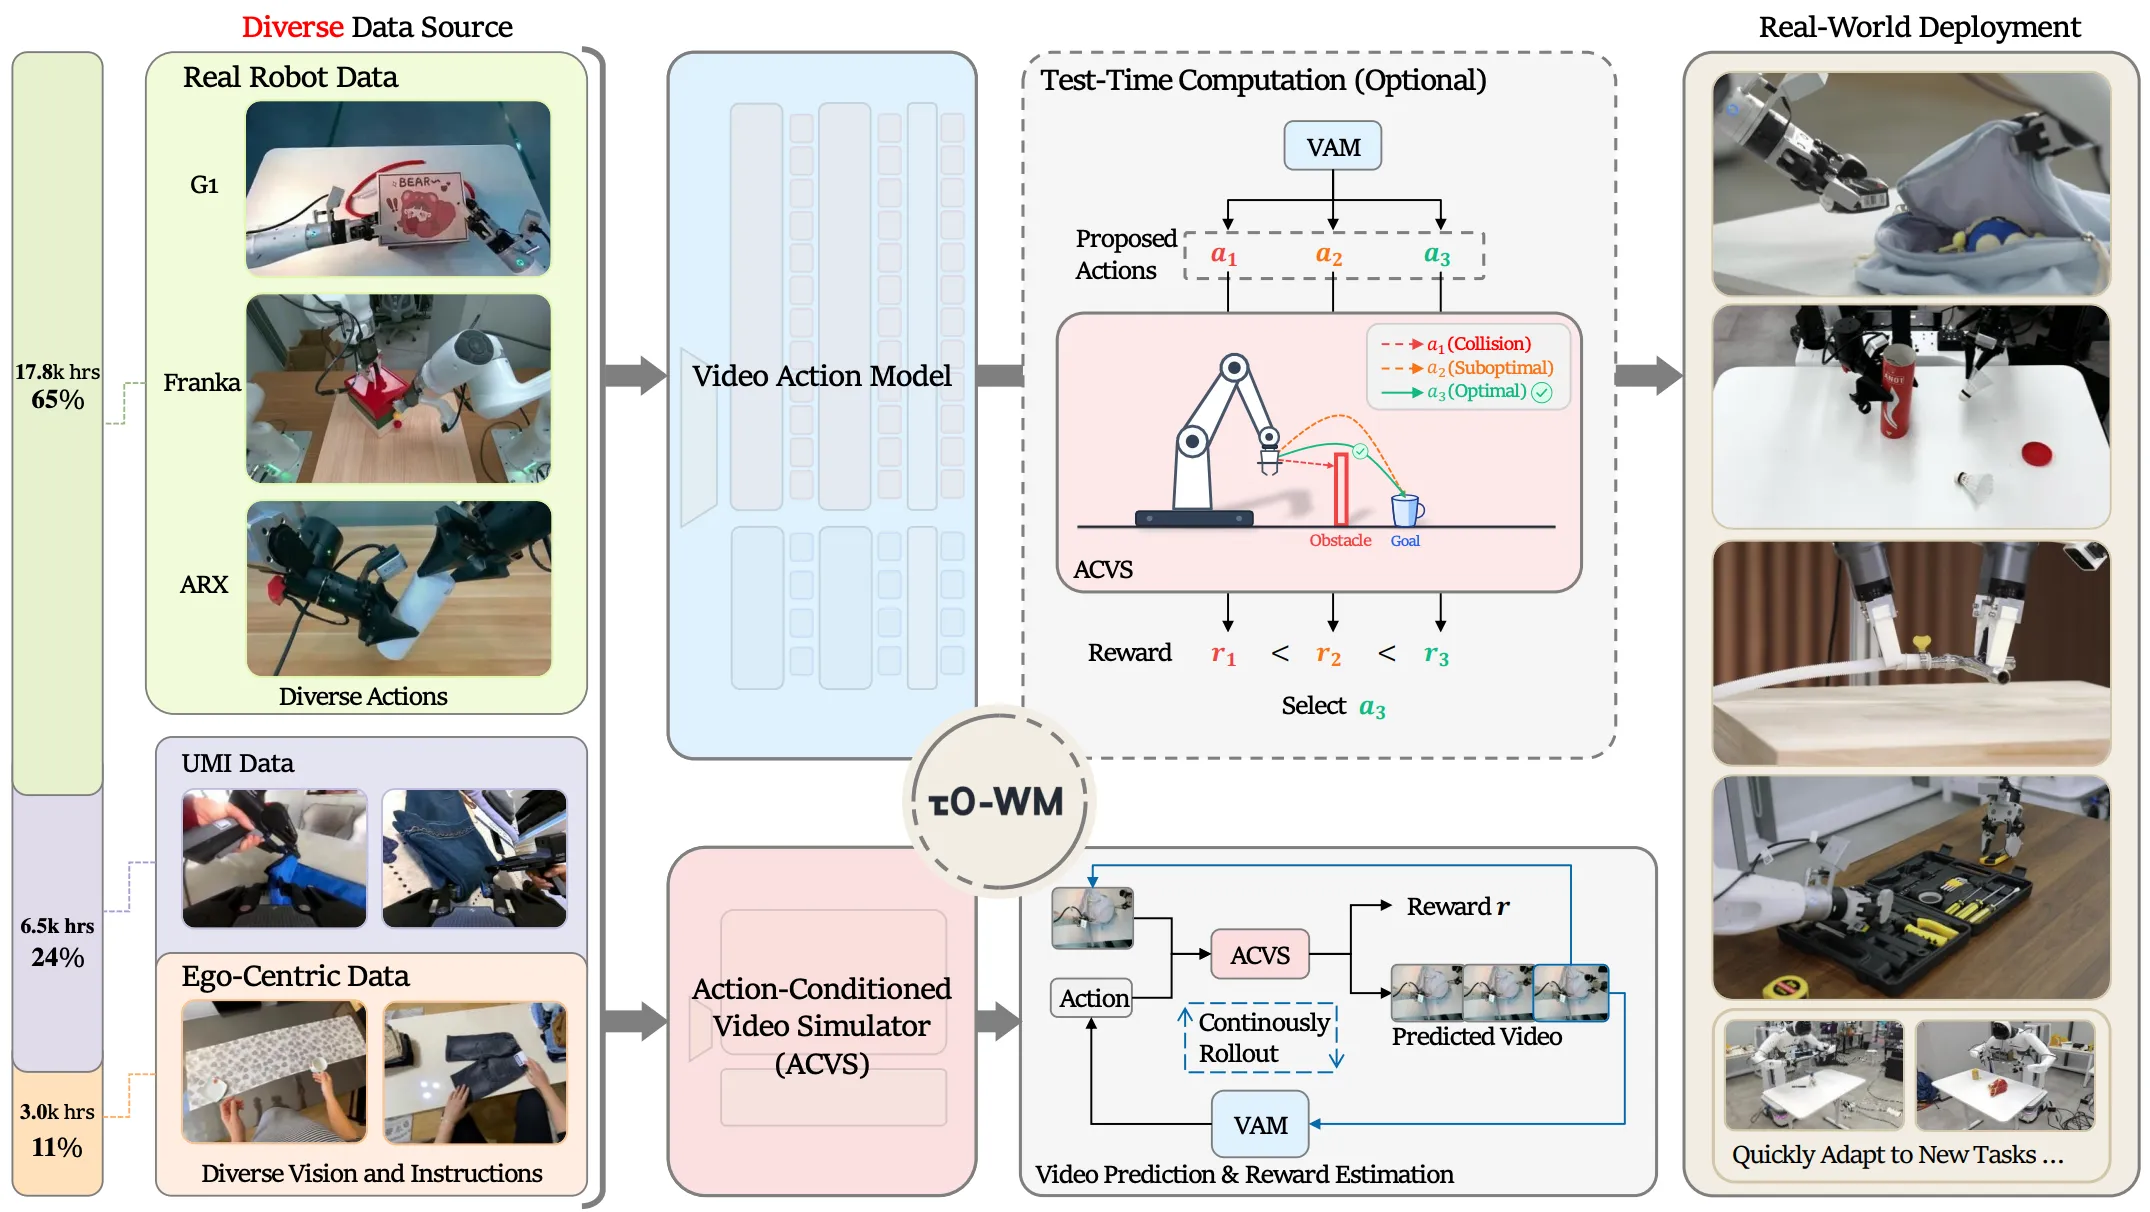
| -WM | AGIBOT Finch 出品的 WM 进行 Action-condition WM 以及 WAM 训练 |
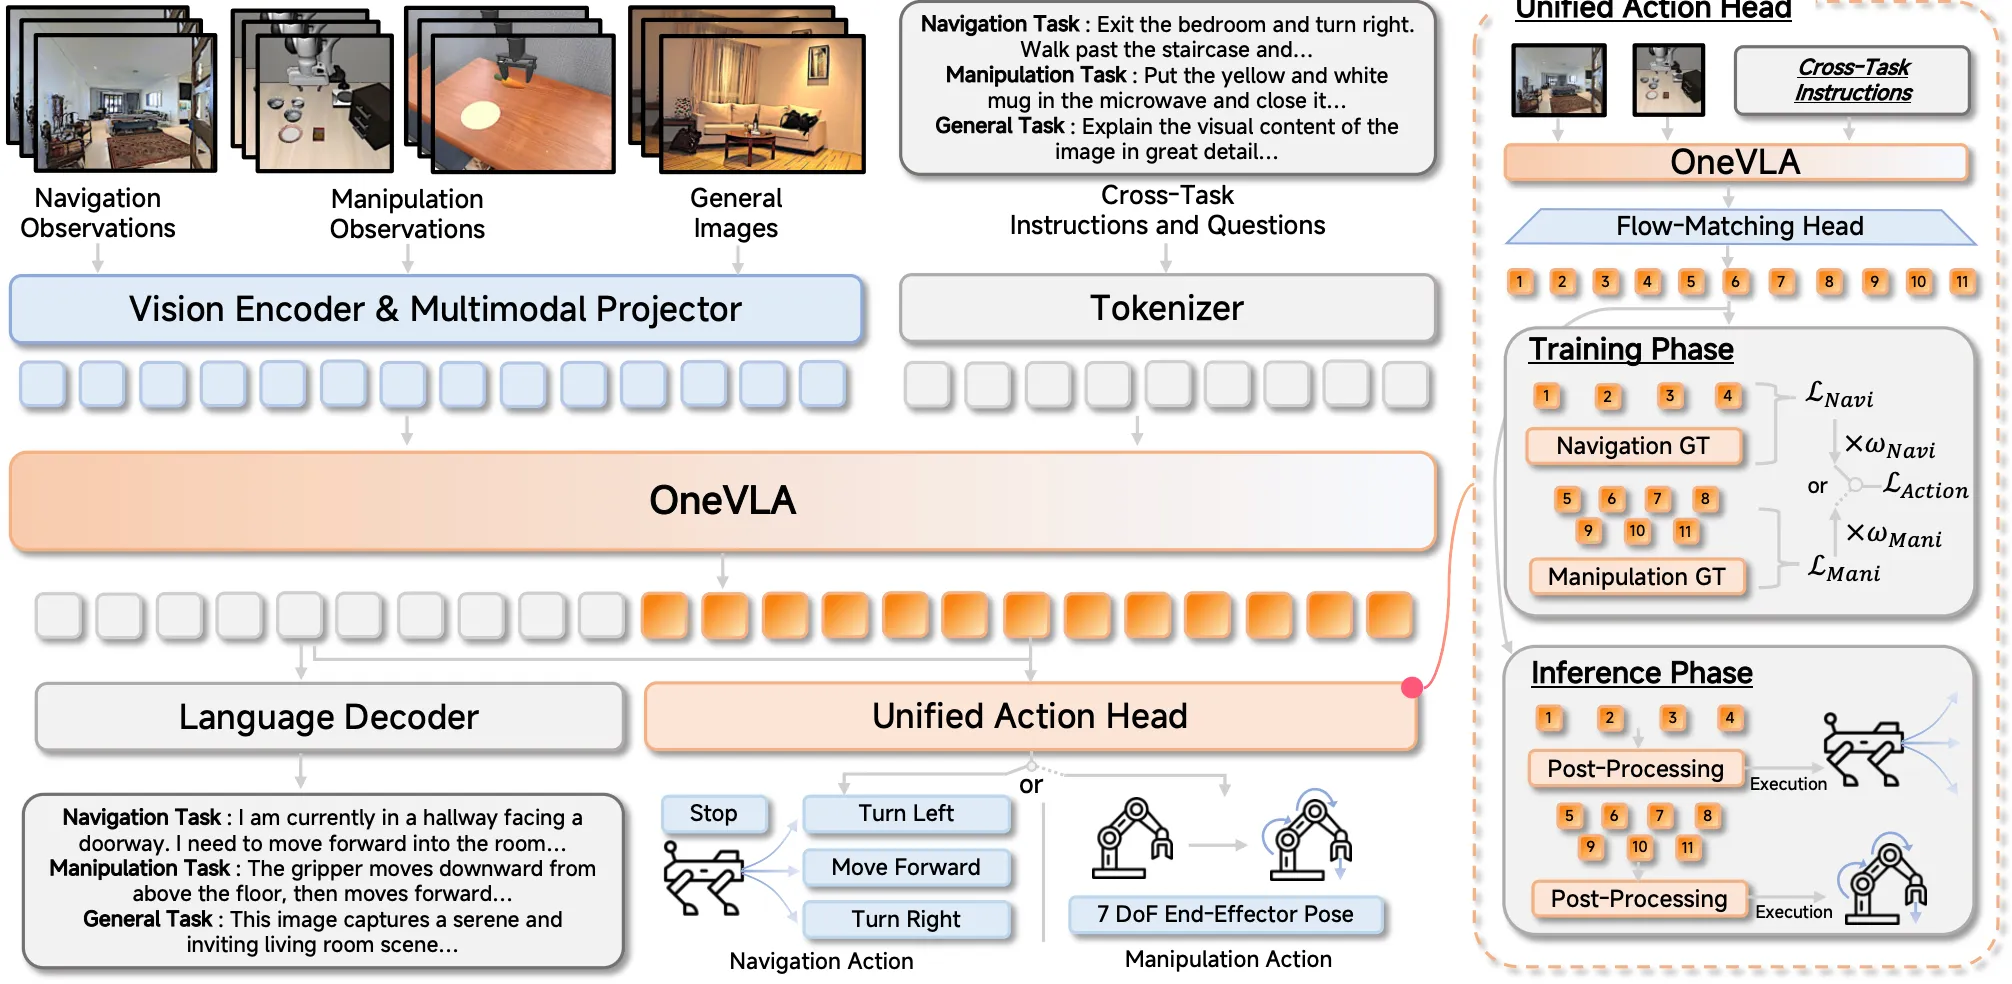
| OneVLA | 小米出品的 concat VLN VLA space 来实现统一框架的 GR00t-like VLA |
| WALL-WM | 自变量出品的 High Level VLM 指令输出 + 下游预训练 WM + Actor 框架 |
| ABot-M1.5 | 高德出品的 Video + Latent Action + Action MoT 的 VLA |
| InternVLA-A1.5 | SHAILAB 出品的 VLM + Actor 的 MoT,并且预测 WM 的 Condition 但是在推理时不接 WM |
| DSWAM | 美的出品的 VLM + WM-VLA 的双系统框架 |
| LingBot-VLA 2.0 | LingBot 出品的比较系统的 VLA,同时预测 DINO 以及 Depth 的特征,MoE 的 Actor,以及一些数据清洗的说明 |
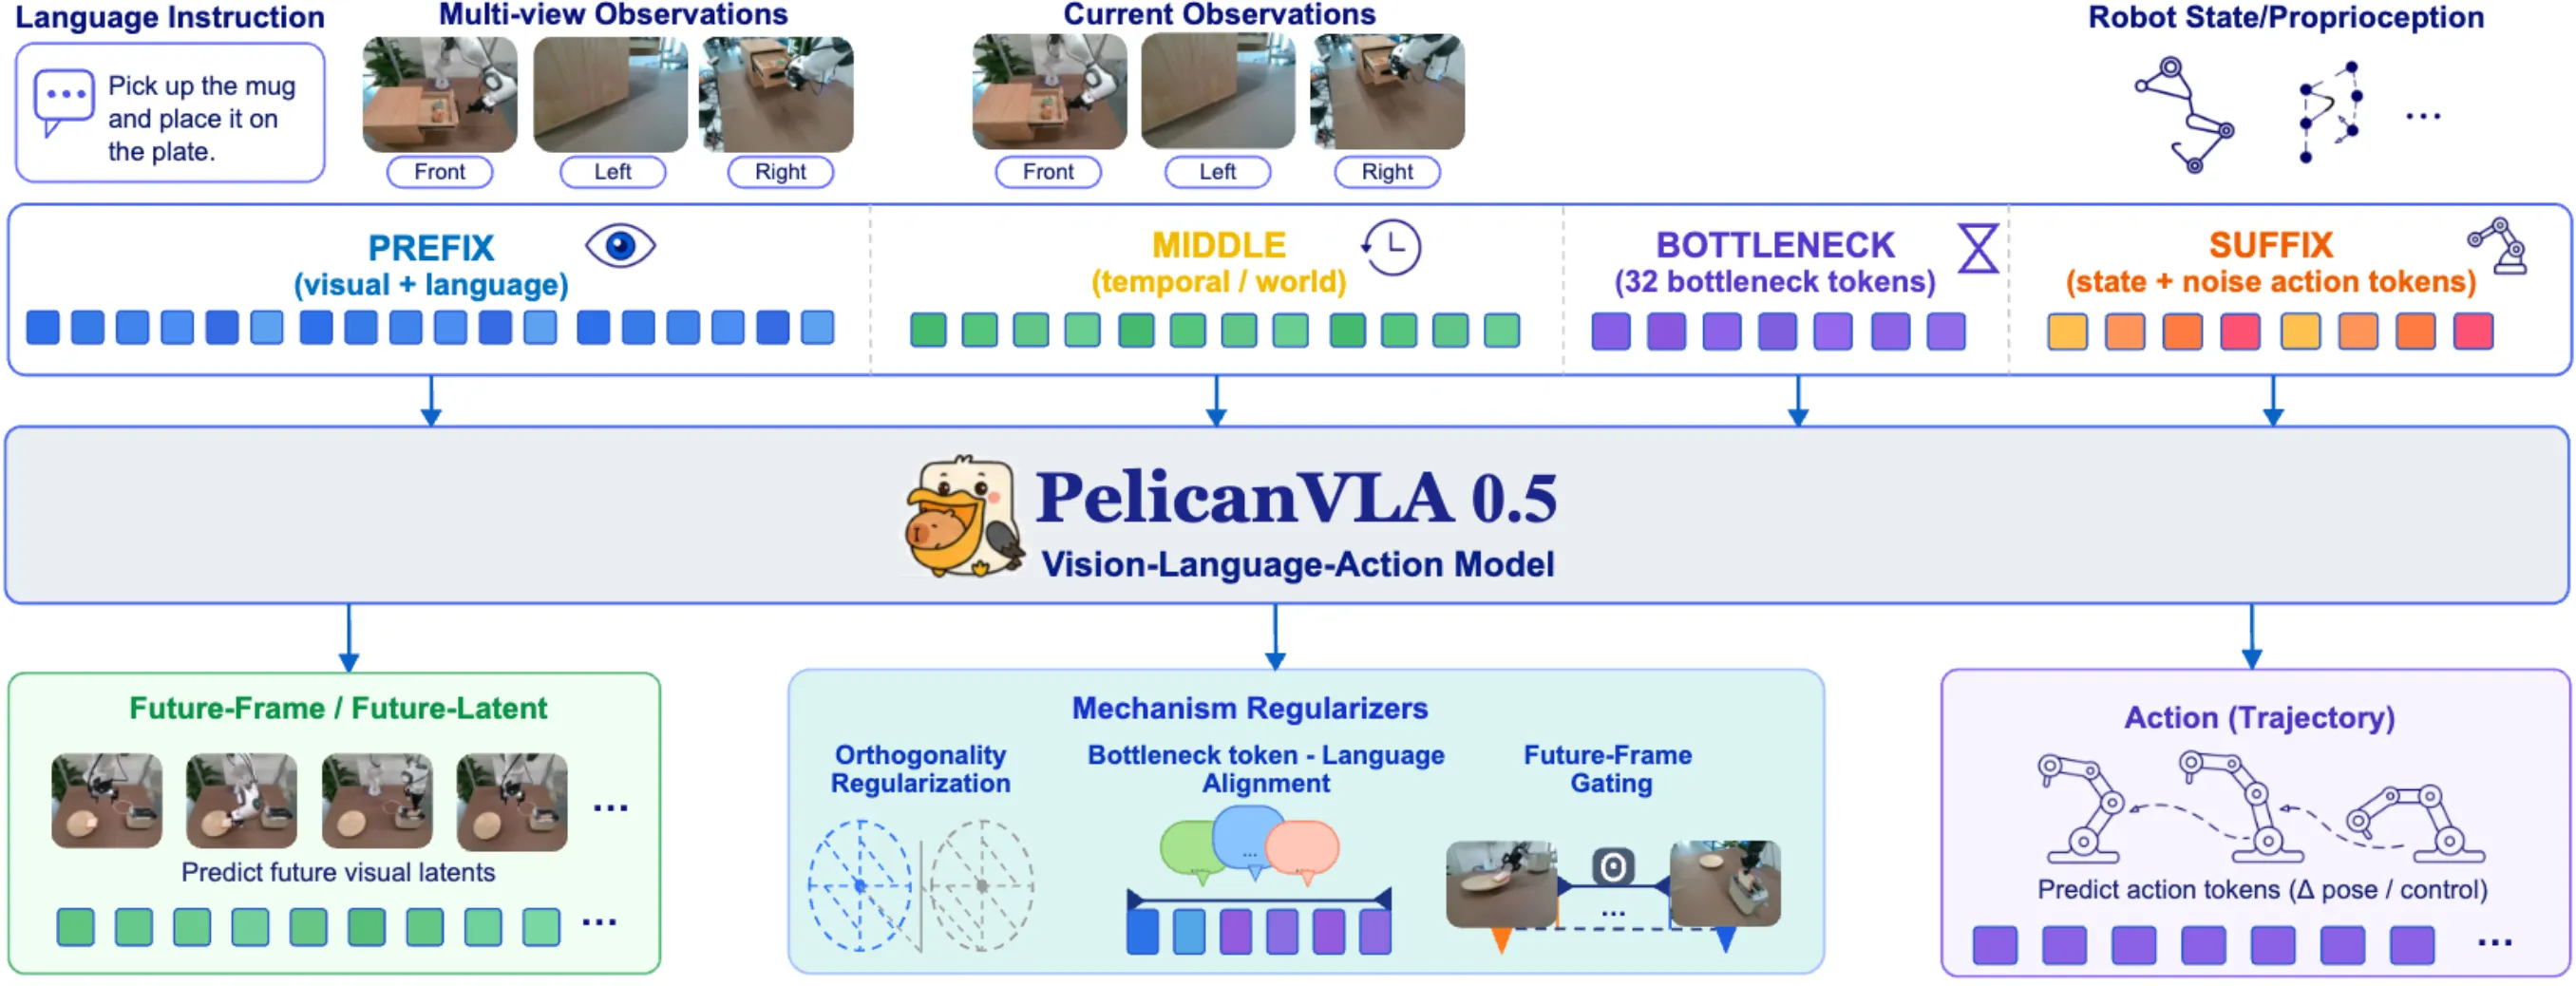
| Pelican-VLA 0.5 | 北京人型出品的统一的 Transformer 预测 future token + BotToken(可学习的 Token,包含若干约束) + 噪声动作块 |
| Lumo-2 | AstriBot 出品的 Qwen 预测 Dynamic Token 并以此仅一步预测 Action Token,然后转为连续 Action Chunk |
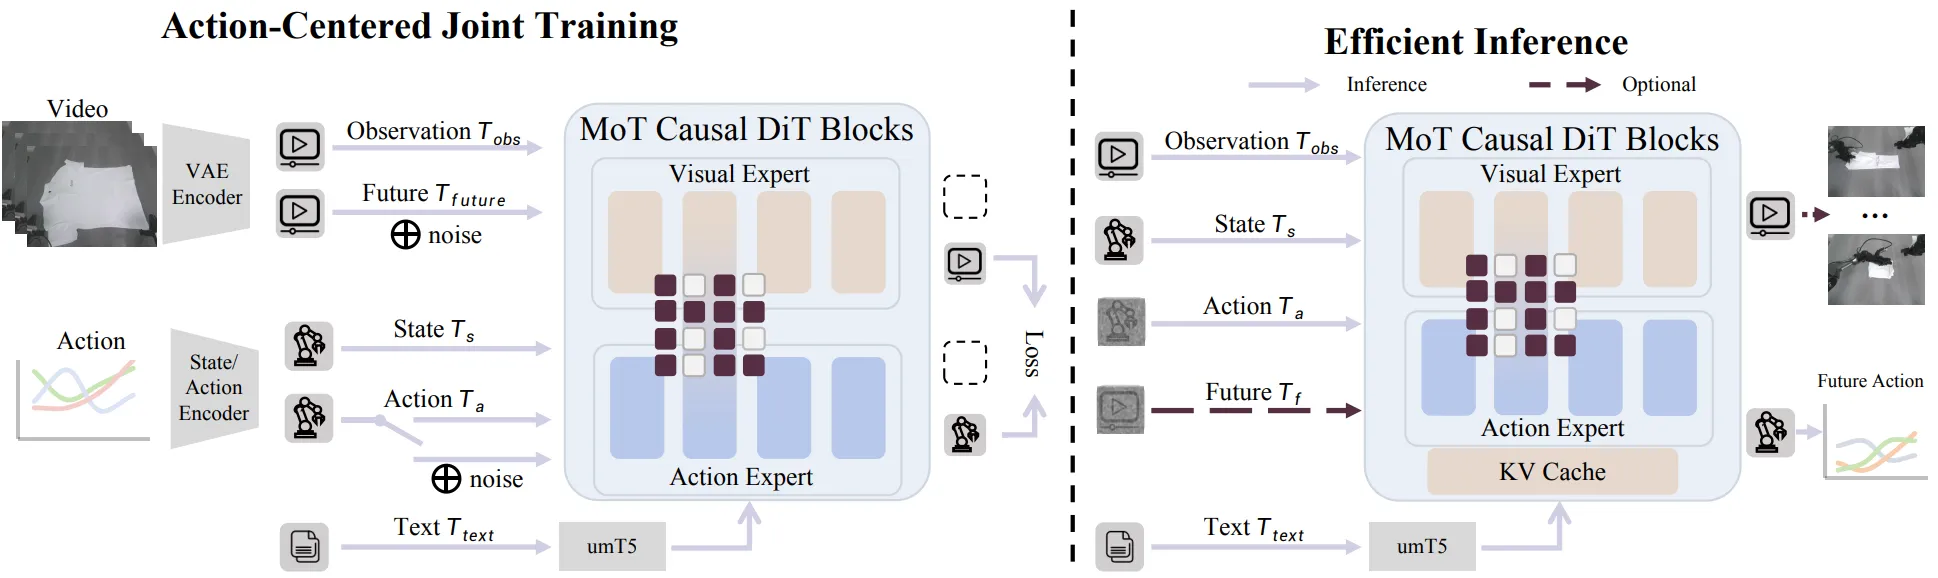
| GigaWorld-Policy-0.5 | GigaAI 出品的 MoT WAM,推理时可不预测 Visual |
| Xiaomi-Robotics-1 | 小米出品的 Choice Policy 训 VLM Action + Pi like VLA,并且 Scaling 真机以及 UMI 数据进行预训练和后训练 |
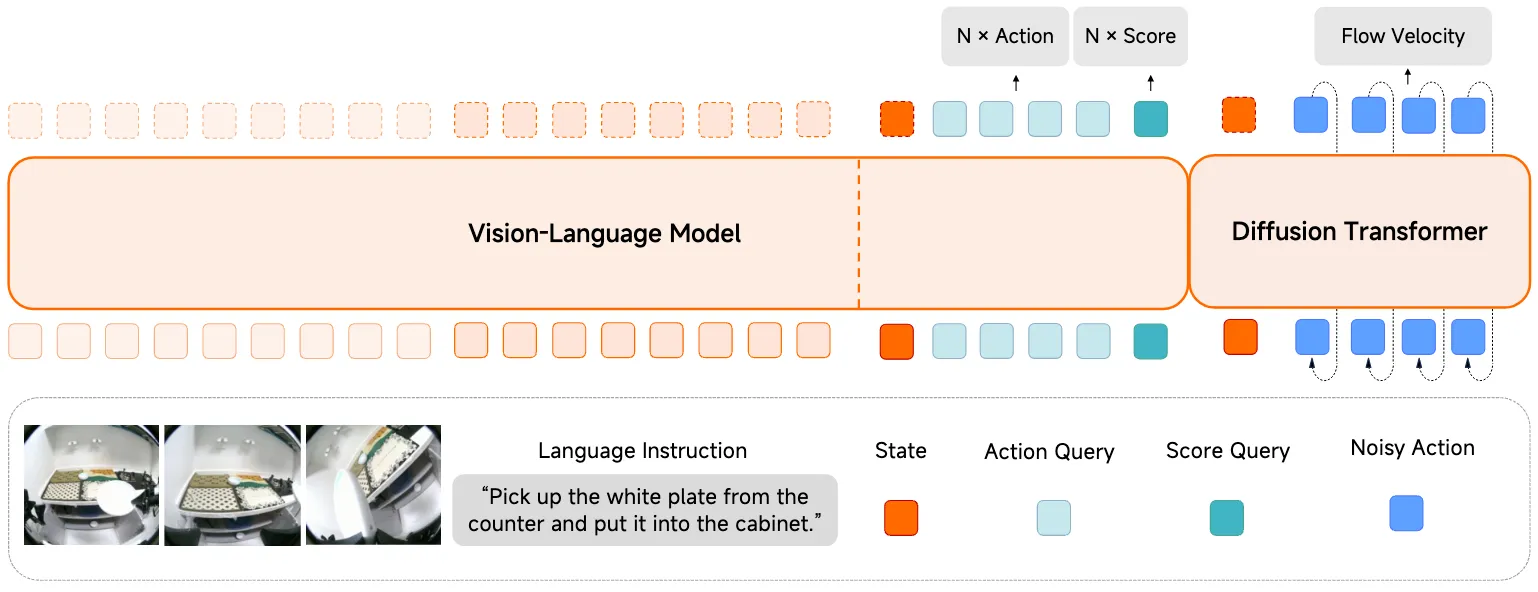
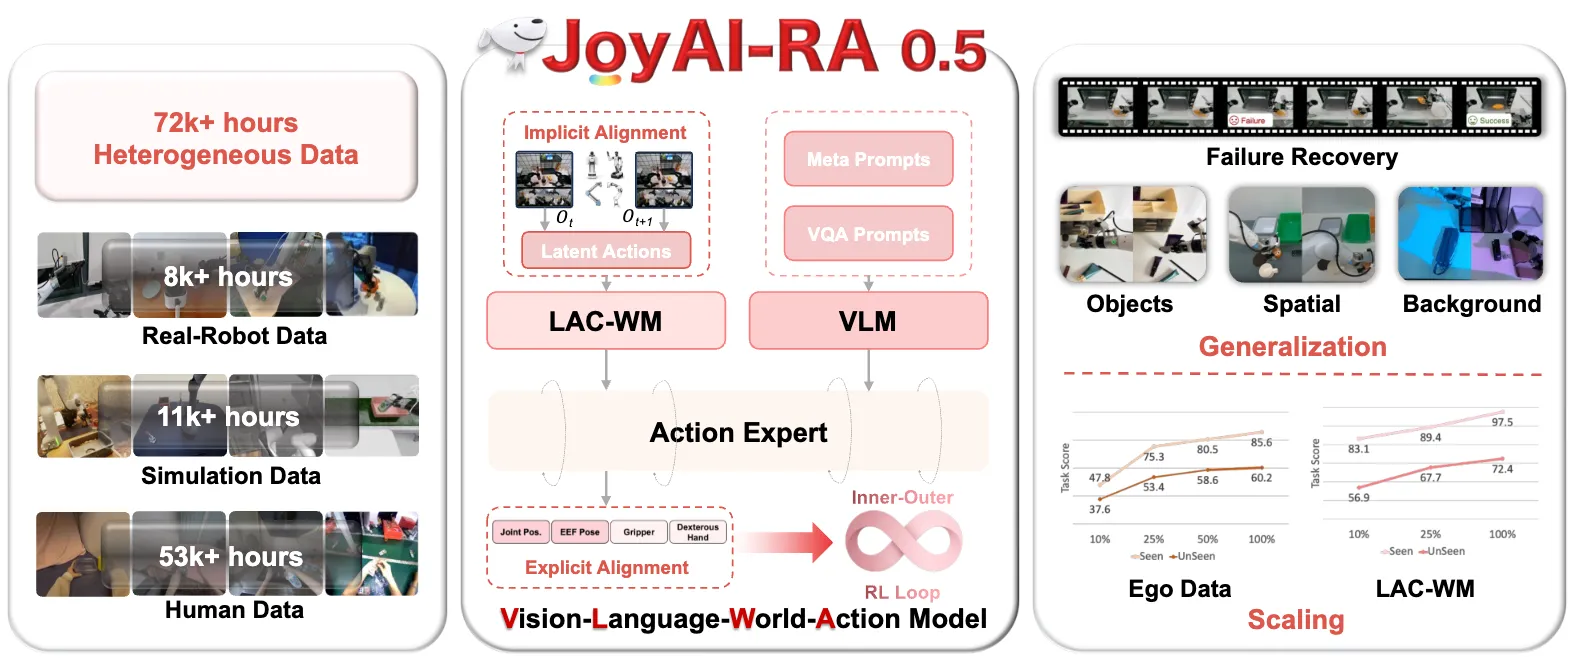
| JoyAI-RA 0.5 | JD 出品的 WM + VLM 一同提供 Condition 给 Action Expert 的框架进行预训练,以及数据清洗管线 |
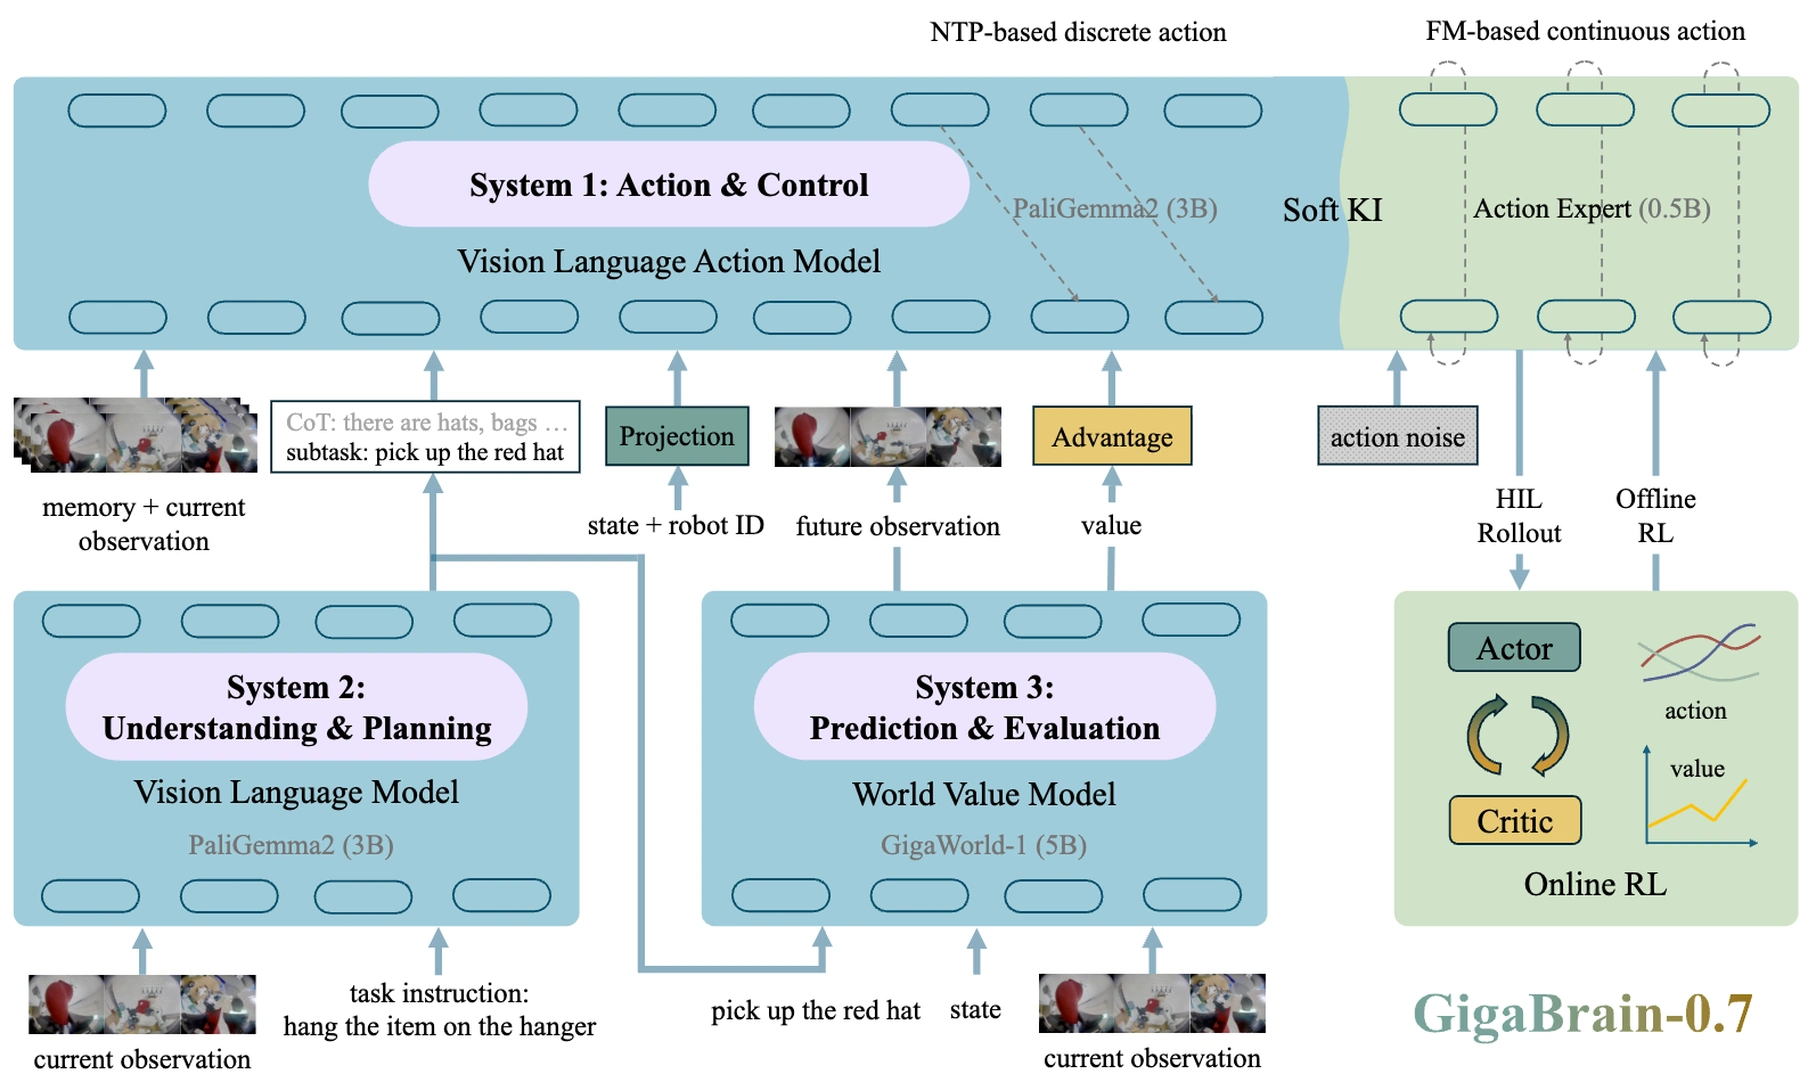
| GigaBrain-0.7 | Giga 出品的 Pi 0.7 Like,MoT System1 + System2 + WM as System3 进行未来预测的框架 |
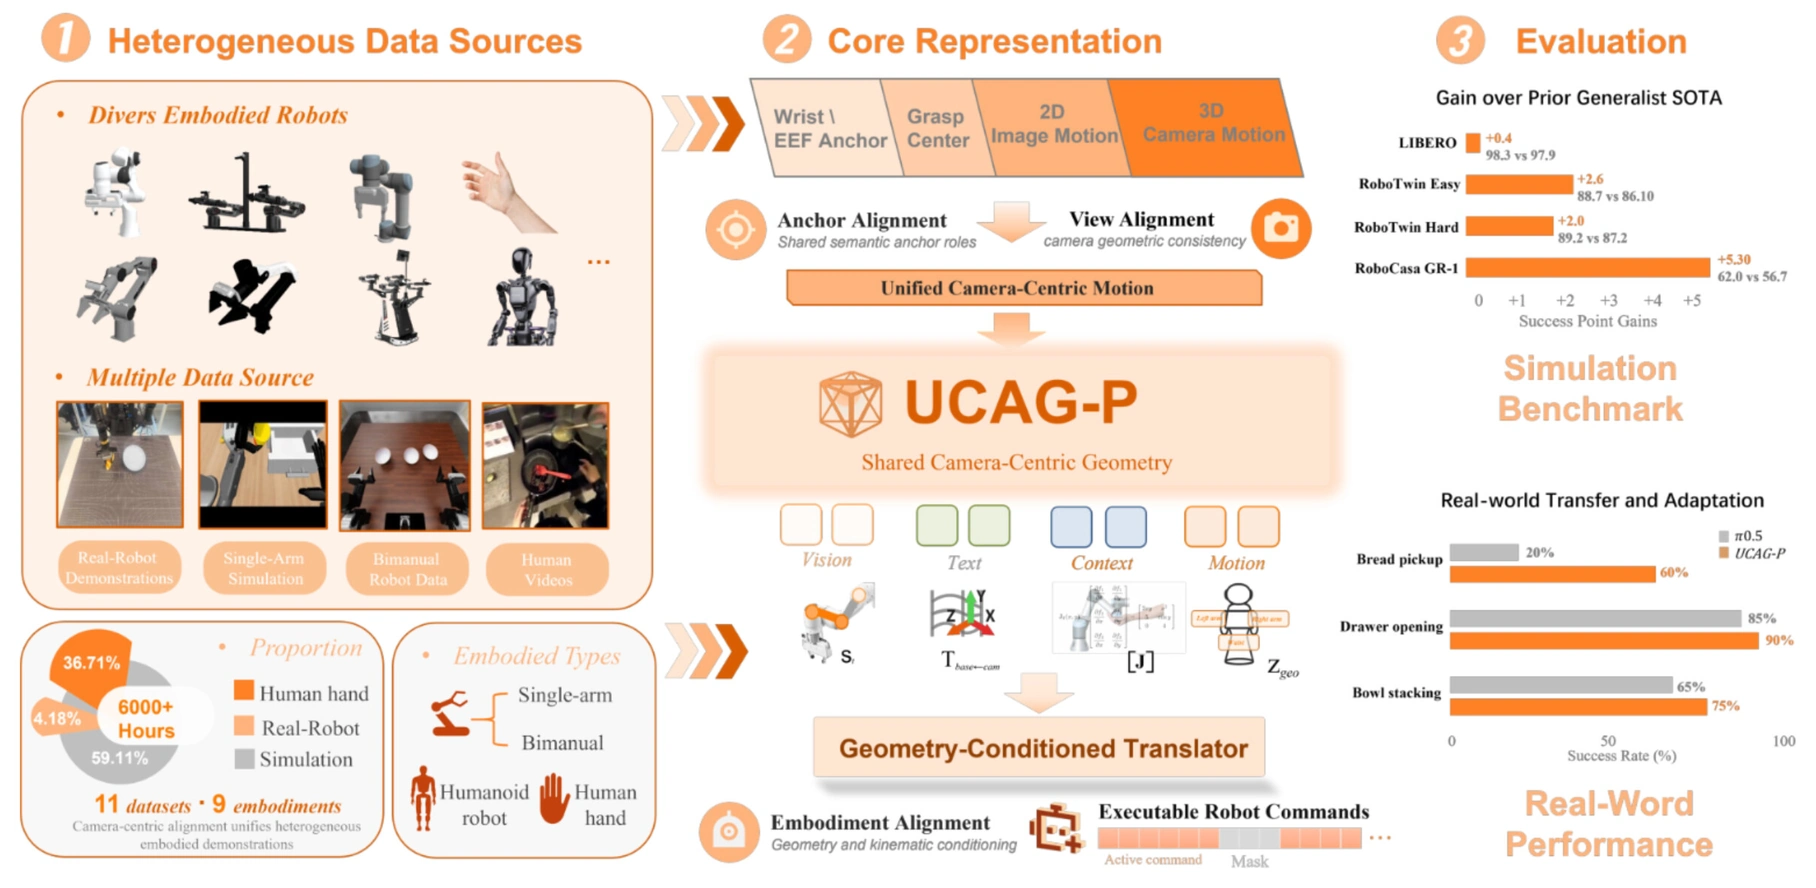
| UCAG-P | Xiaomi 出品的 Qwen 初始化,使用 Unifed Action Space,加入轨迹预测的监督目标,并且多 stage 预训练,可利用 Human data |
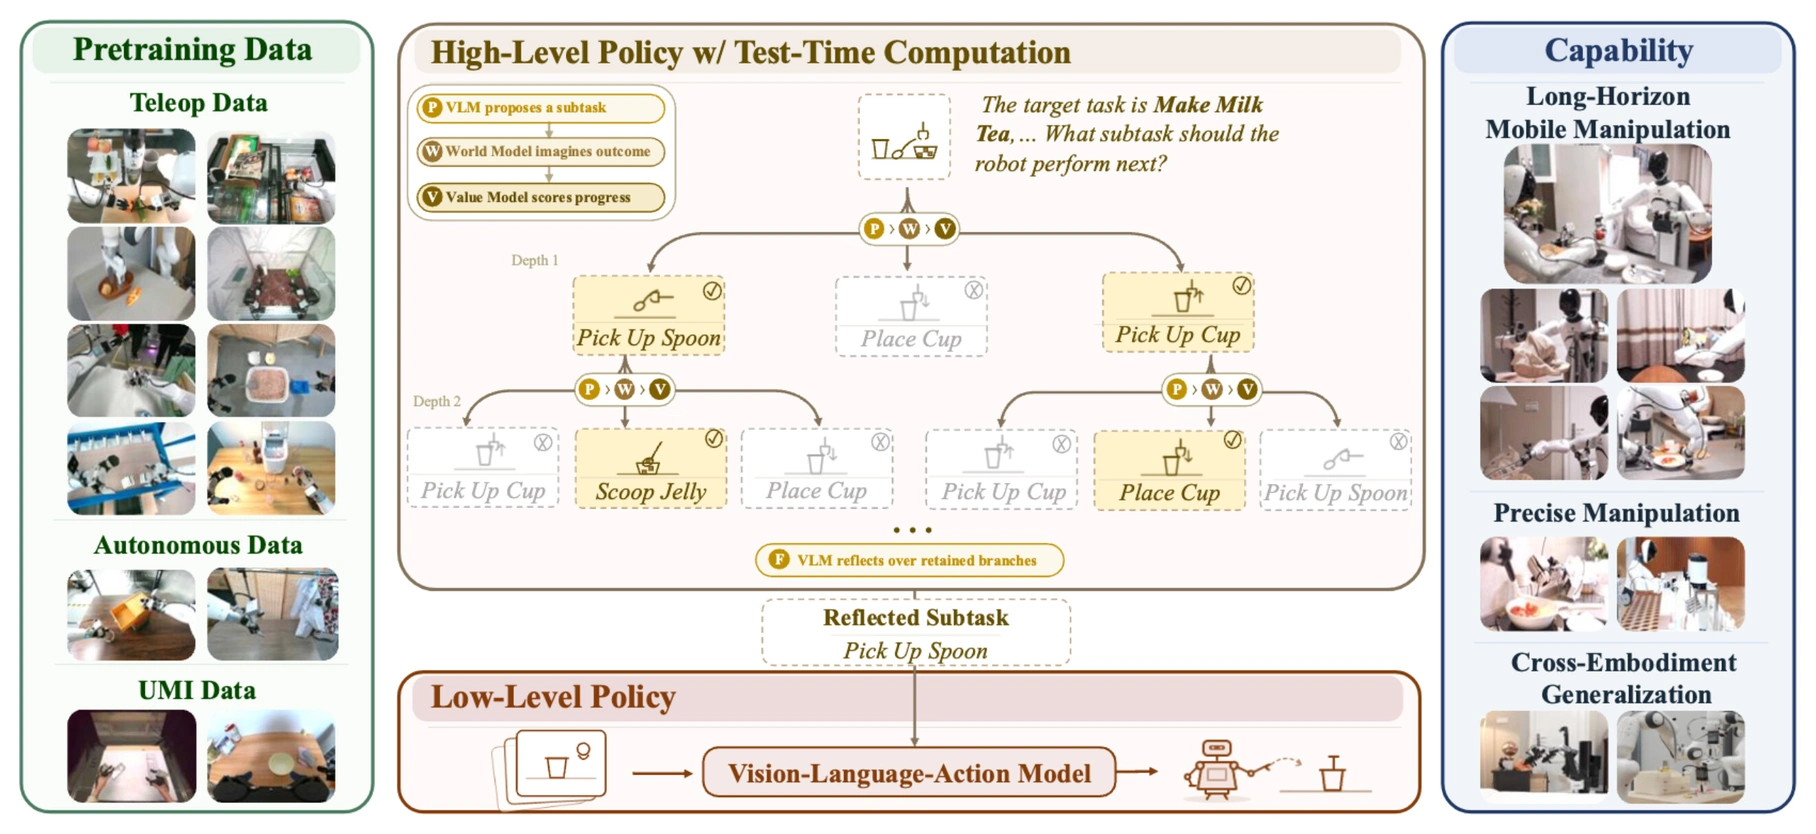
| -VLA | SII + AgiBot 出品的双层模型,上层 VLM + Memory + Subtask 预测,并且用 WM 预测未来并且 VM 打分,来找到合理 Subtask,下游预训练 MoT VLA |
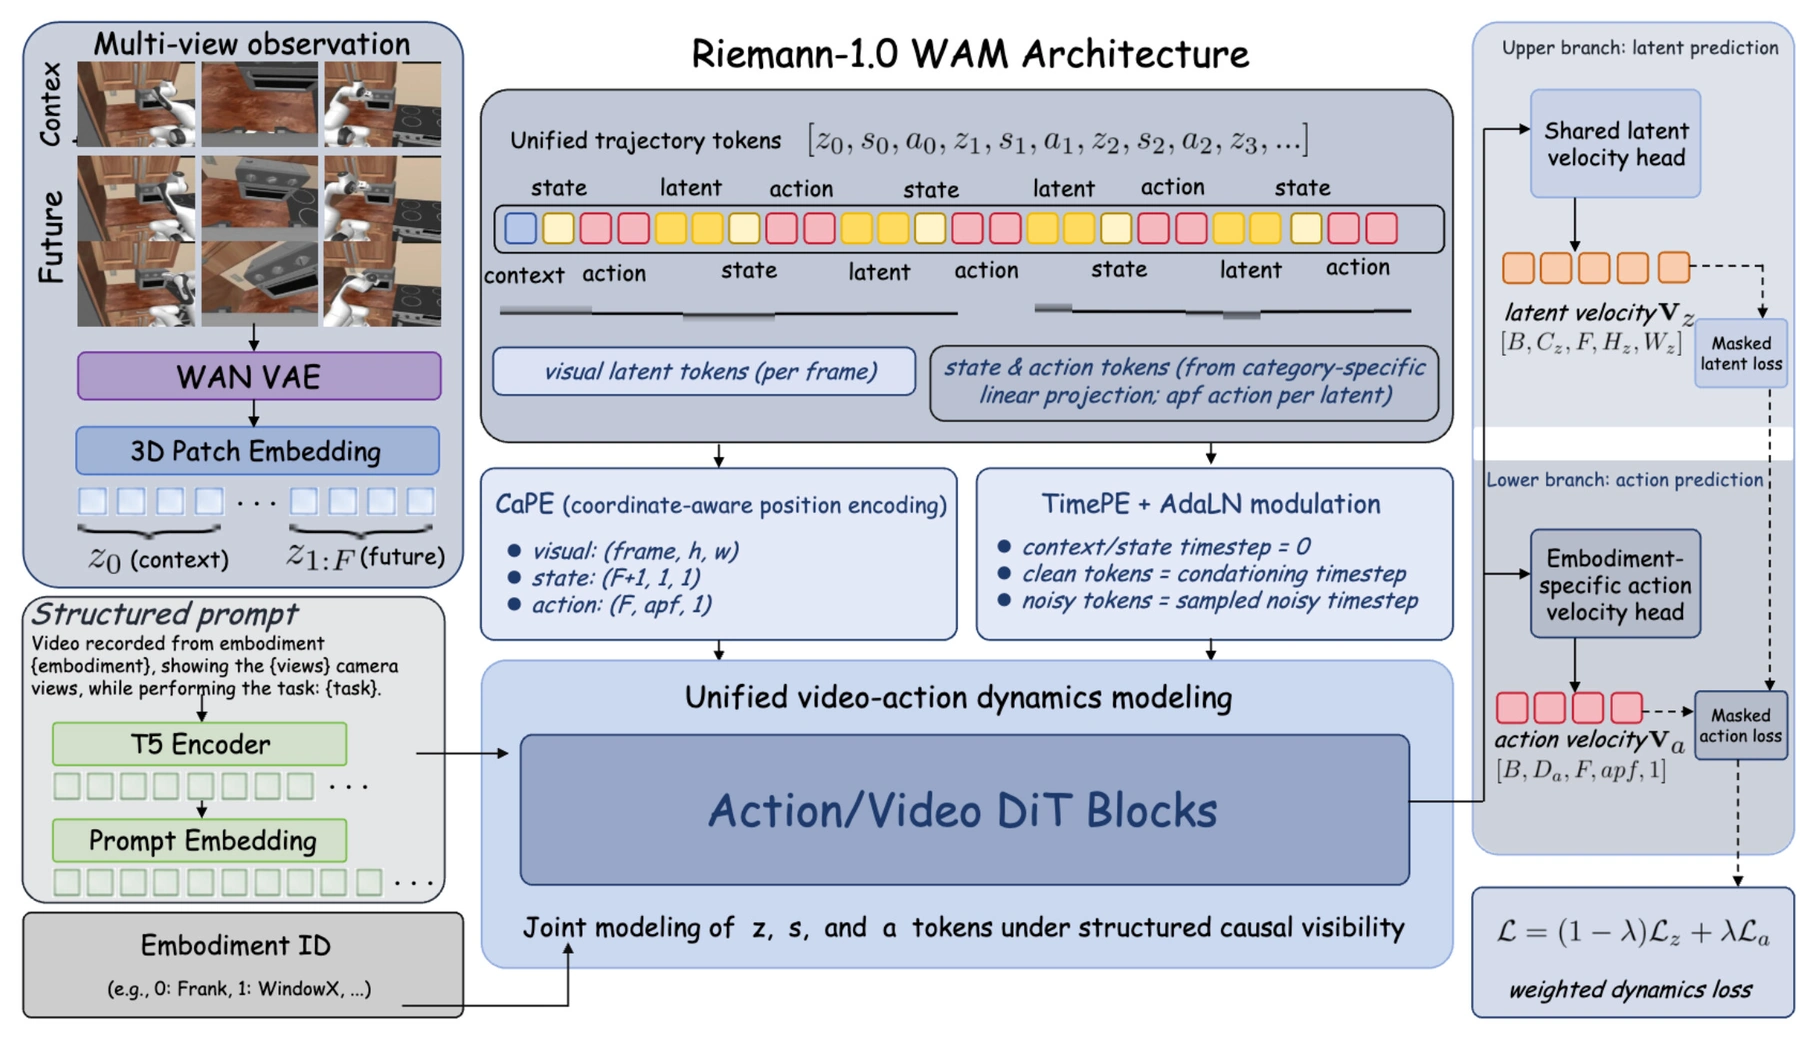
| Riemann-1.0 | Riemann 出品的 Casual WAM,预测 Latent 以及 Action Velocity,在不同阶段的预训练给不同的 Loss weight |
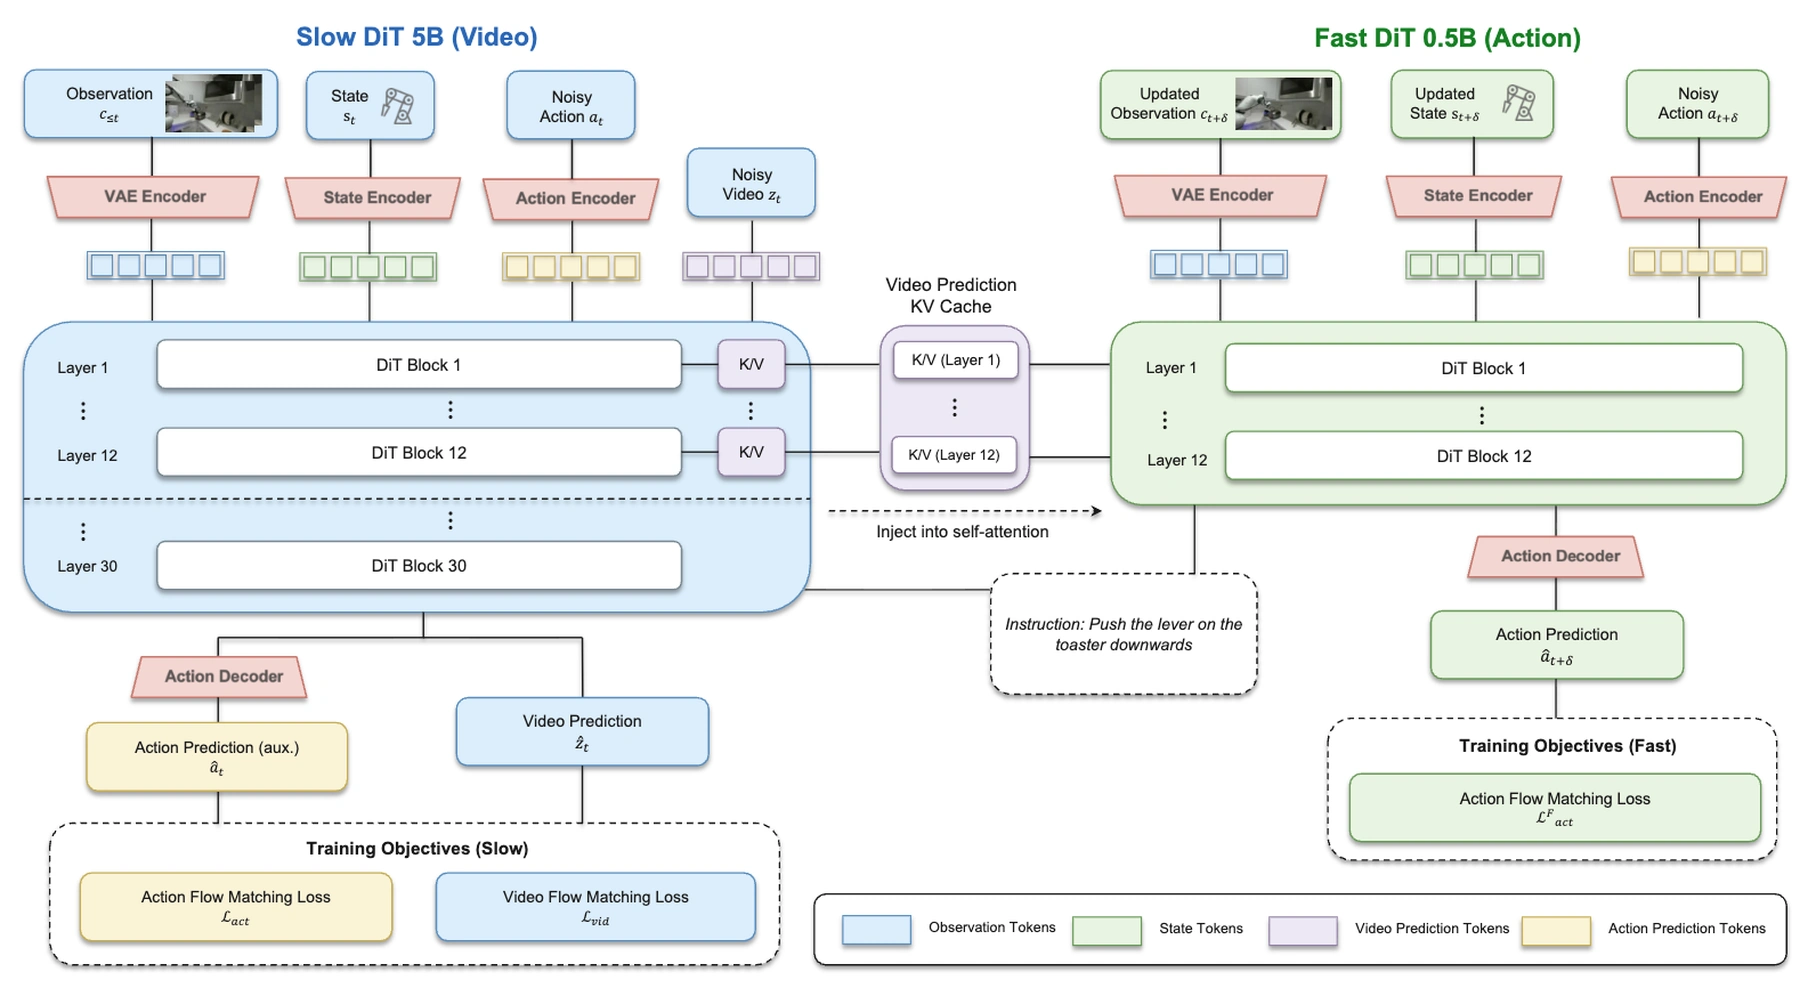
| ZimaBlue | JD 探索研究院出品的视频预训练 → 多本体 video-action mid-training → 目标本体后训练;Slow–Fast DiT 共享 KV,并做蒸馏和部署加速。 |
| XR-2 | 启元机器人出品的,使用 1500 小时自采家居数据,包含真机与部分 UMI;模型结构接近 π 系列,主要观察到数据扩展带来的成功率提升。 |
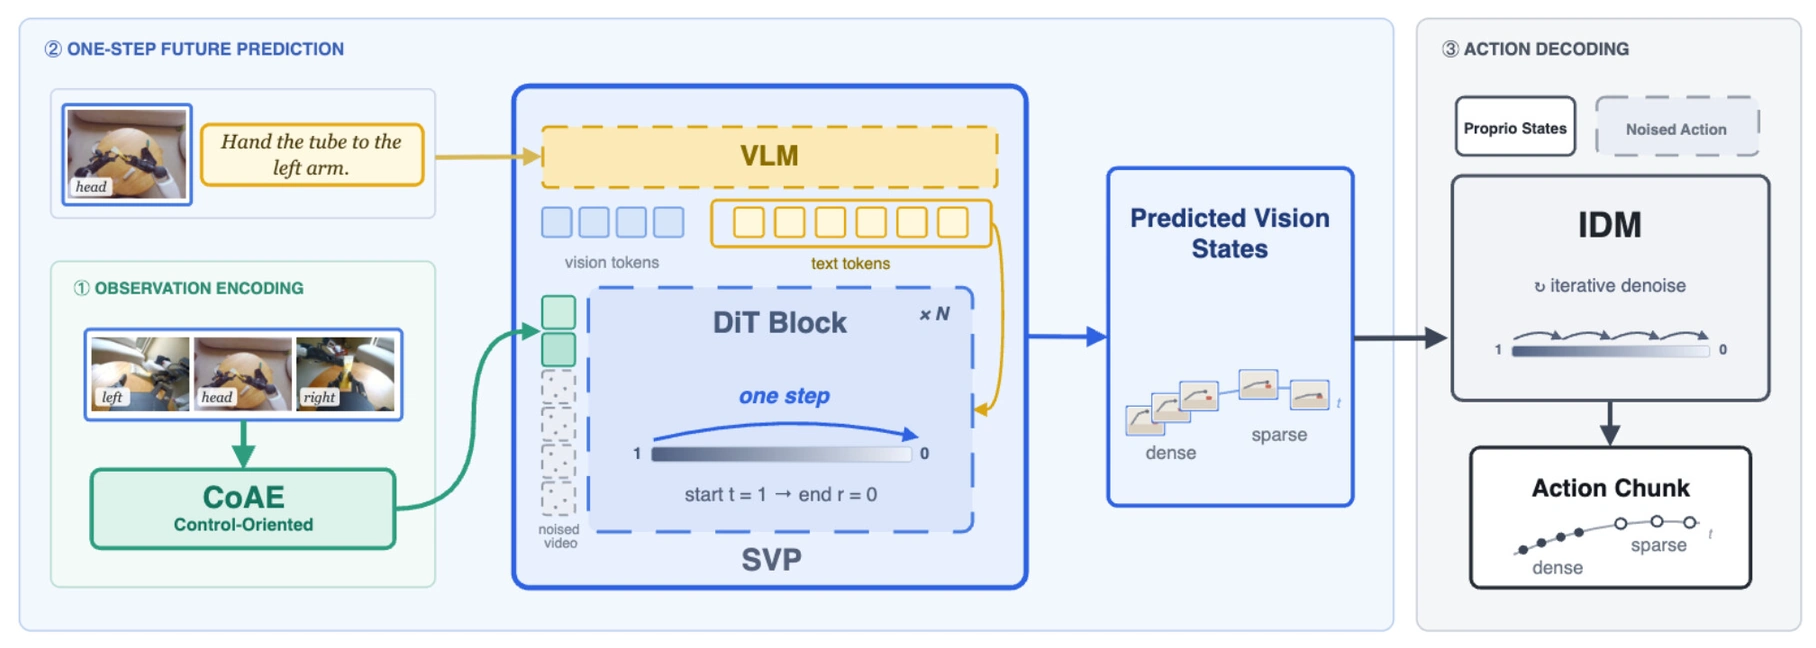
| GE-Act 2.0 | AGIBOT 出品的带显式 IDM 的世界模型,使用自研 CoAE 编码器与单步解码,主要以 GO 系列数据预训练,辅以仿真和开源数据;泛化展示主要在物体层面。 |
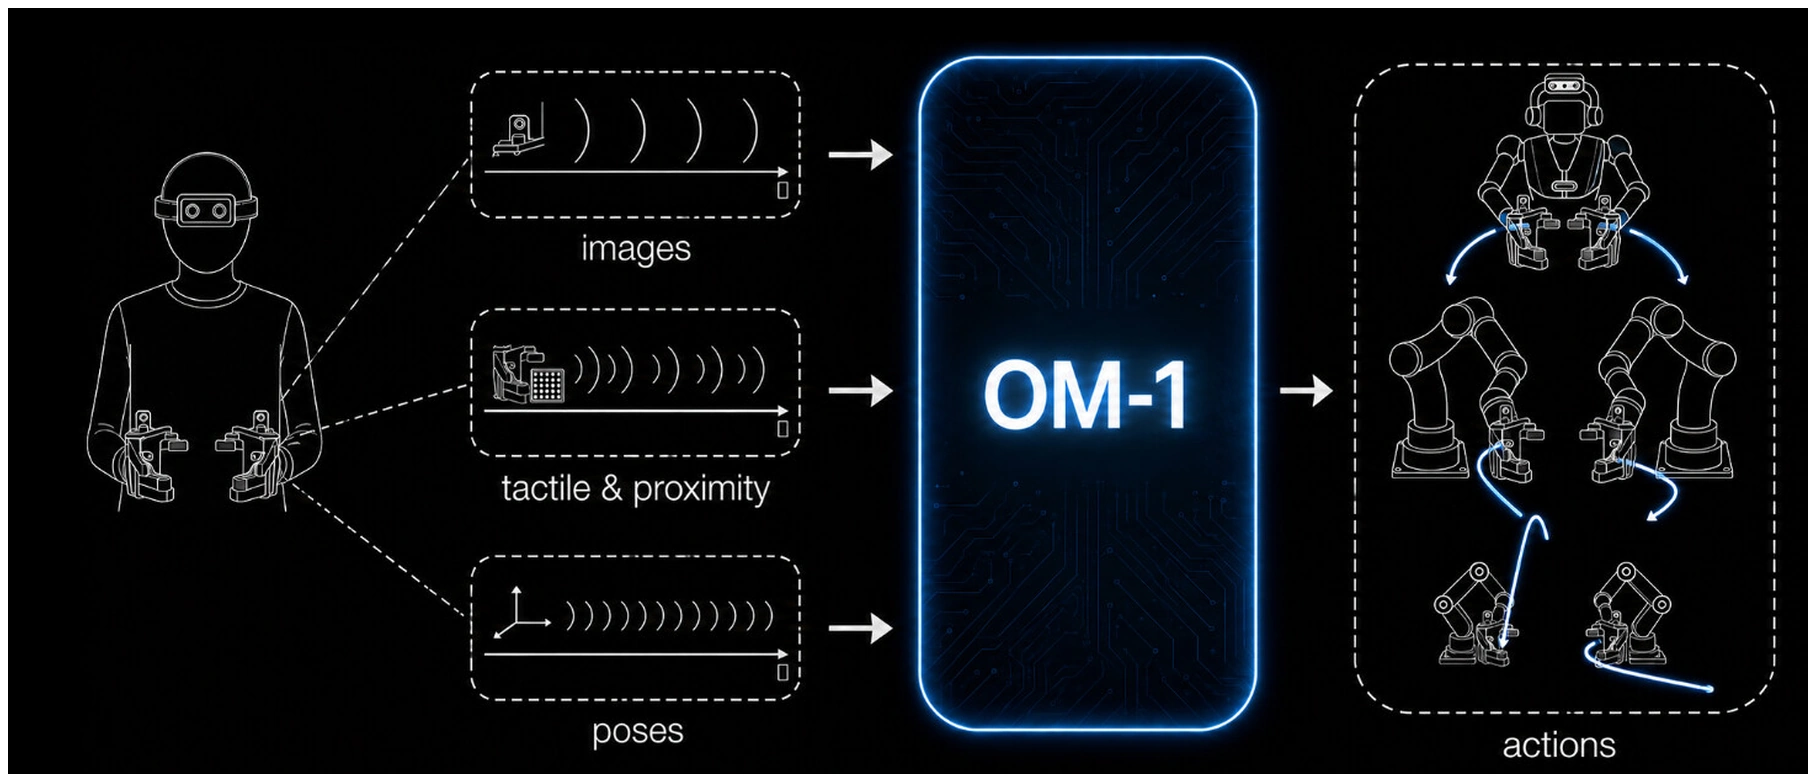
| OM-1 | Reward AI 出品的,以 Omnibody Hand 手持接口采集力、视觉与动作数据的机器人模型;数据规模未披露,展示侧重跨本体迁移与较快的长程操作。 |
| Helix 2.5 | Figure AI 出品的以人类数据预训练的人形移动操作模型,展示收床、捡玩具和叠毛巾;泛化测评主要针对环境、背景与物体变化。 |
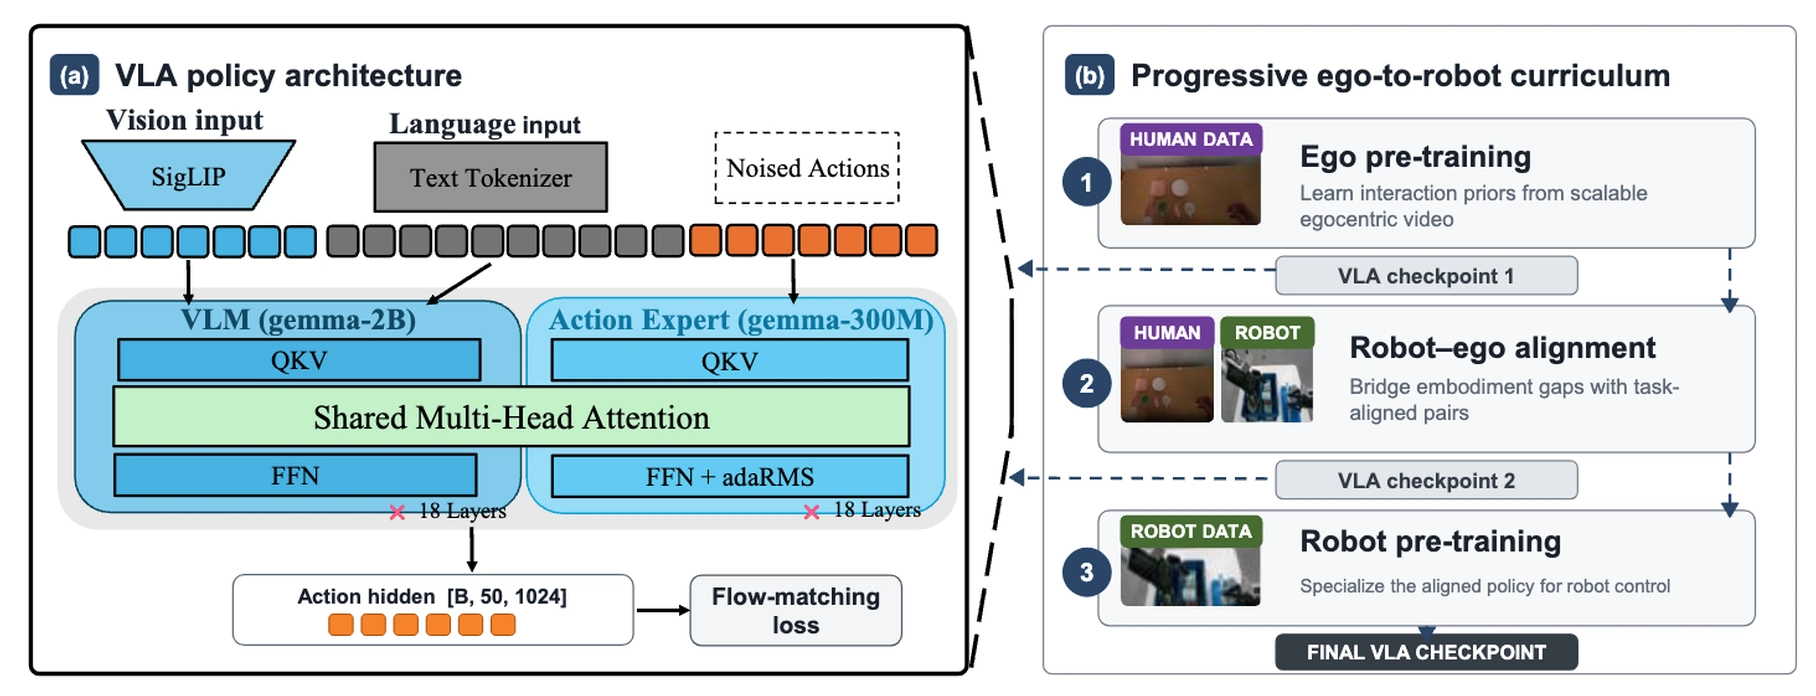
| AtomEgo | Agentic Intelligence Lab 出品的三阶段预训练 VLA,Ego 数据占比不到 20%,在 Flow Matching 中用不同 MLP 处理人类与机器人数据;这一设计缺少单独消融。 |
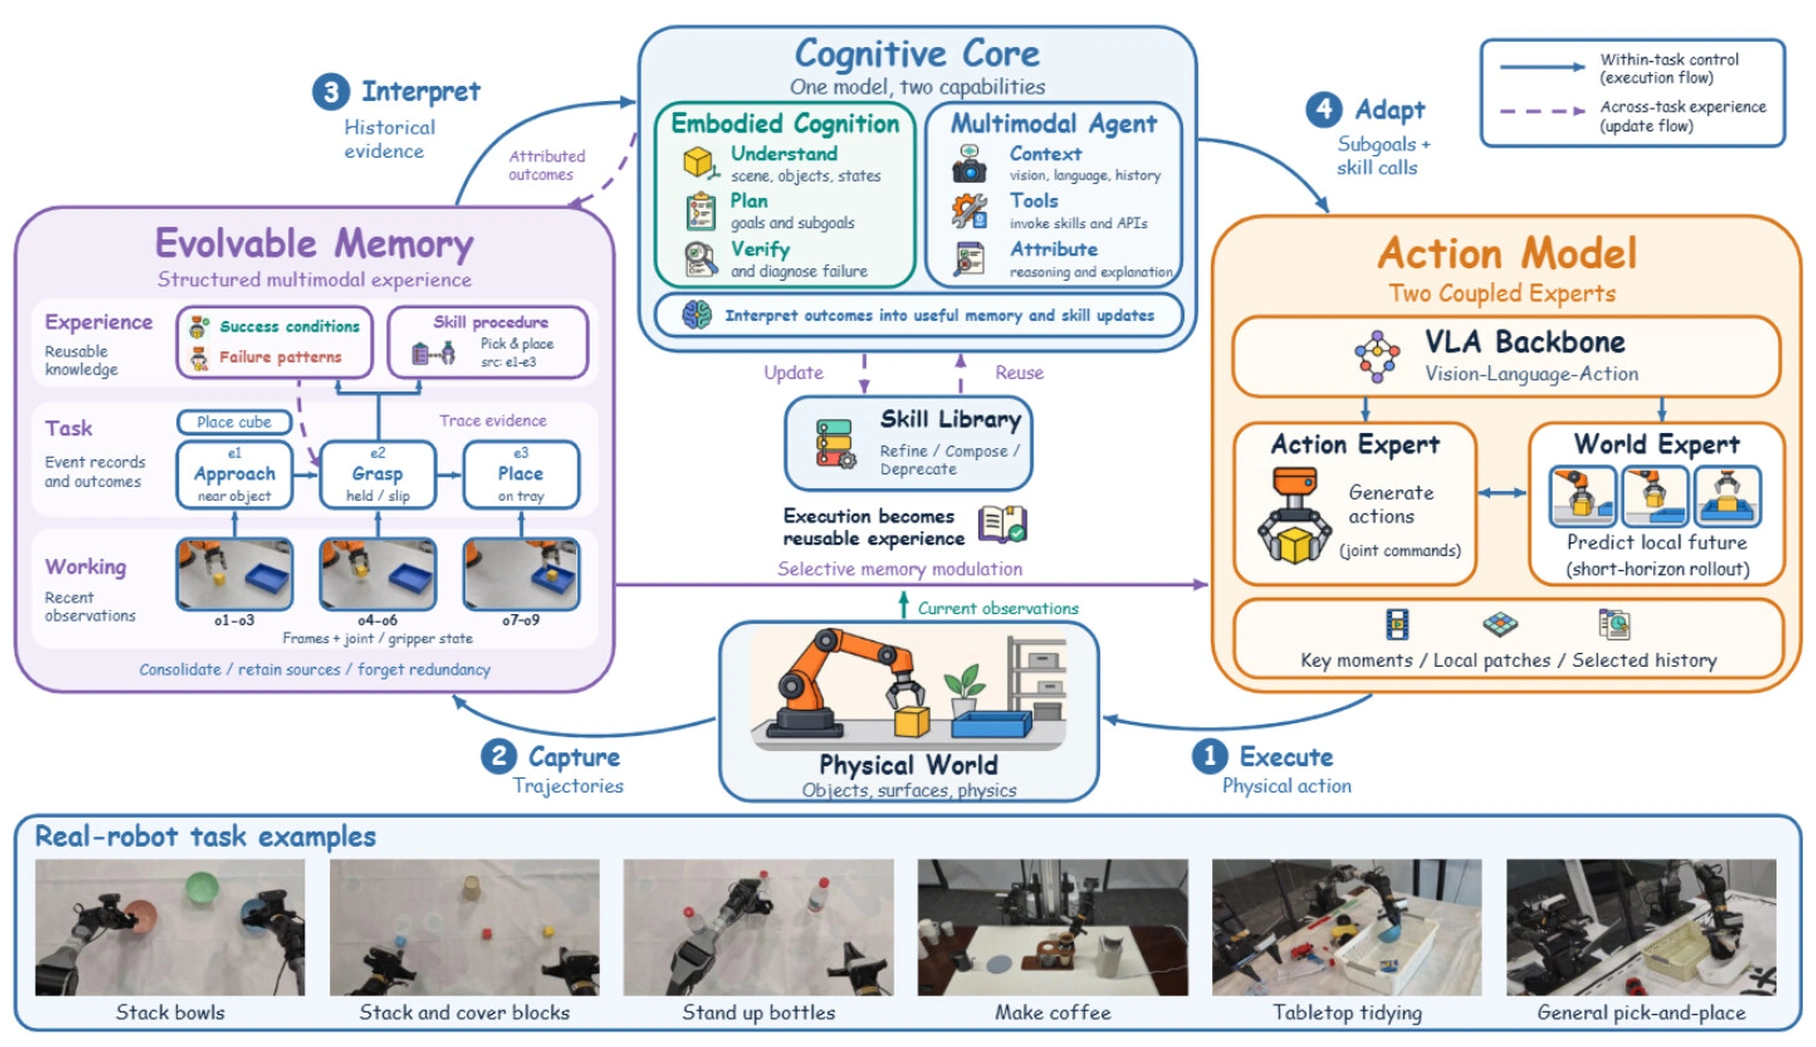
| ME-Brain-1.0 | 理想出品的 VLM、Memory Harness 与动作模型组成双系统,并按关节/夹爪变化选取动作关键帧;没有对关键帧采样做消融。 |
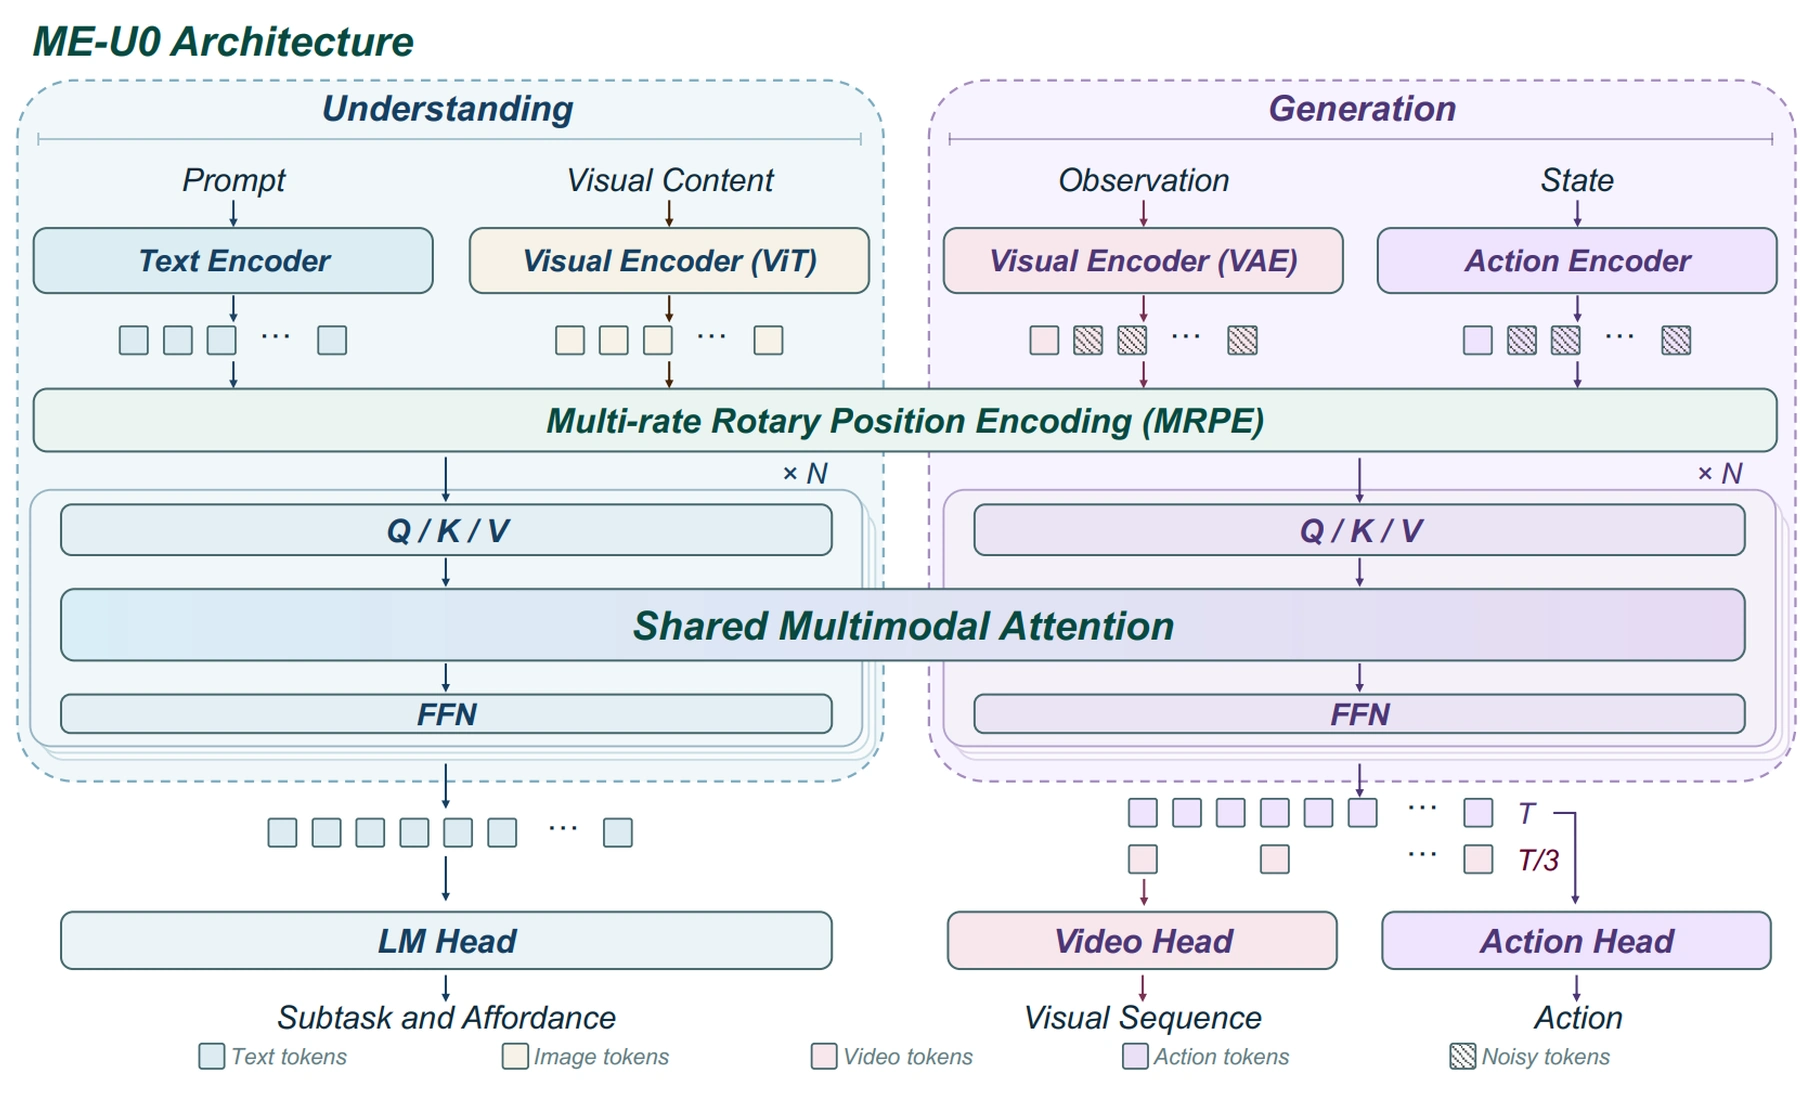
| MachEmbodied-U0 | 理想出品的 VLM + WM + Actor 的三重 MoT,混合多模态、多频率数据与 Ego2Robot,联合预测视觉、深度、法向、光流和子任务;没有有效的消融,协同监督只有定性展示。 |
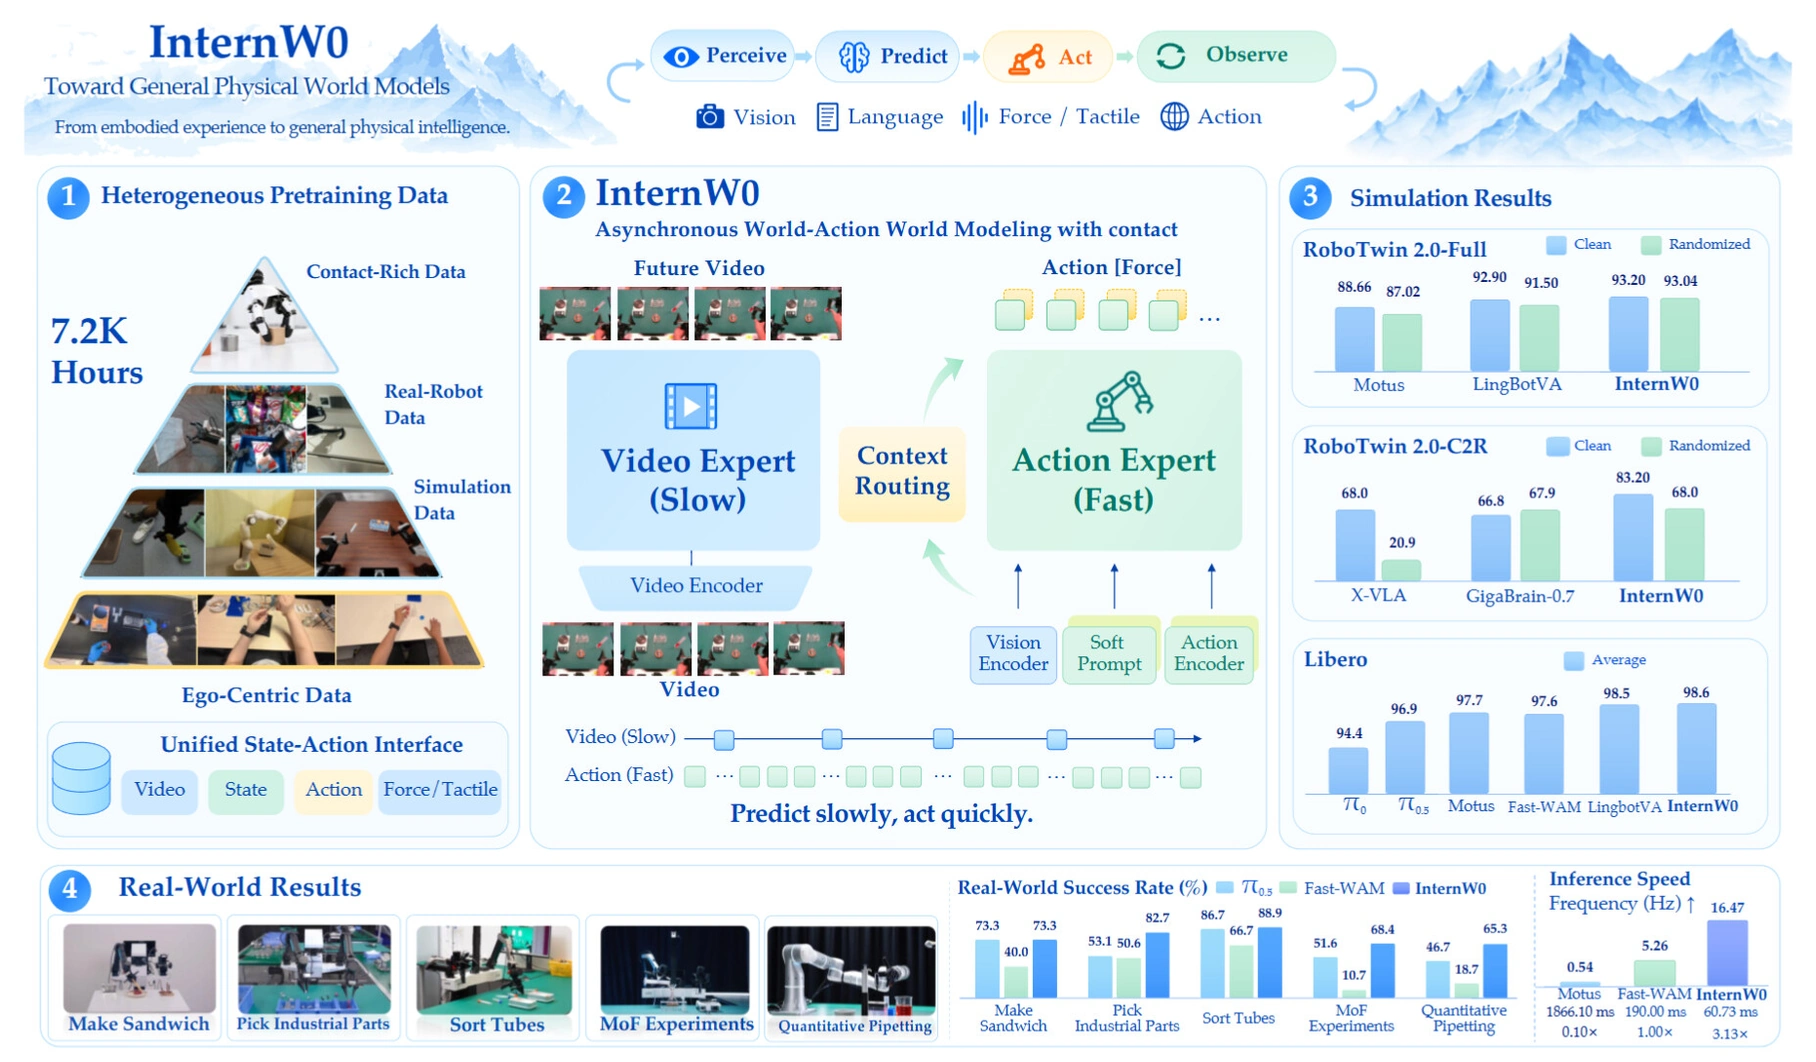
| InternW0 | SHAILAB 出品的 WM + Actor 结构,沿用 AHA-WAM 的部分设计,用清理后的真机、仿真和 Ego 开源数据及统一动作空间预训练。 |
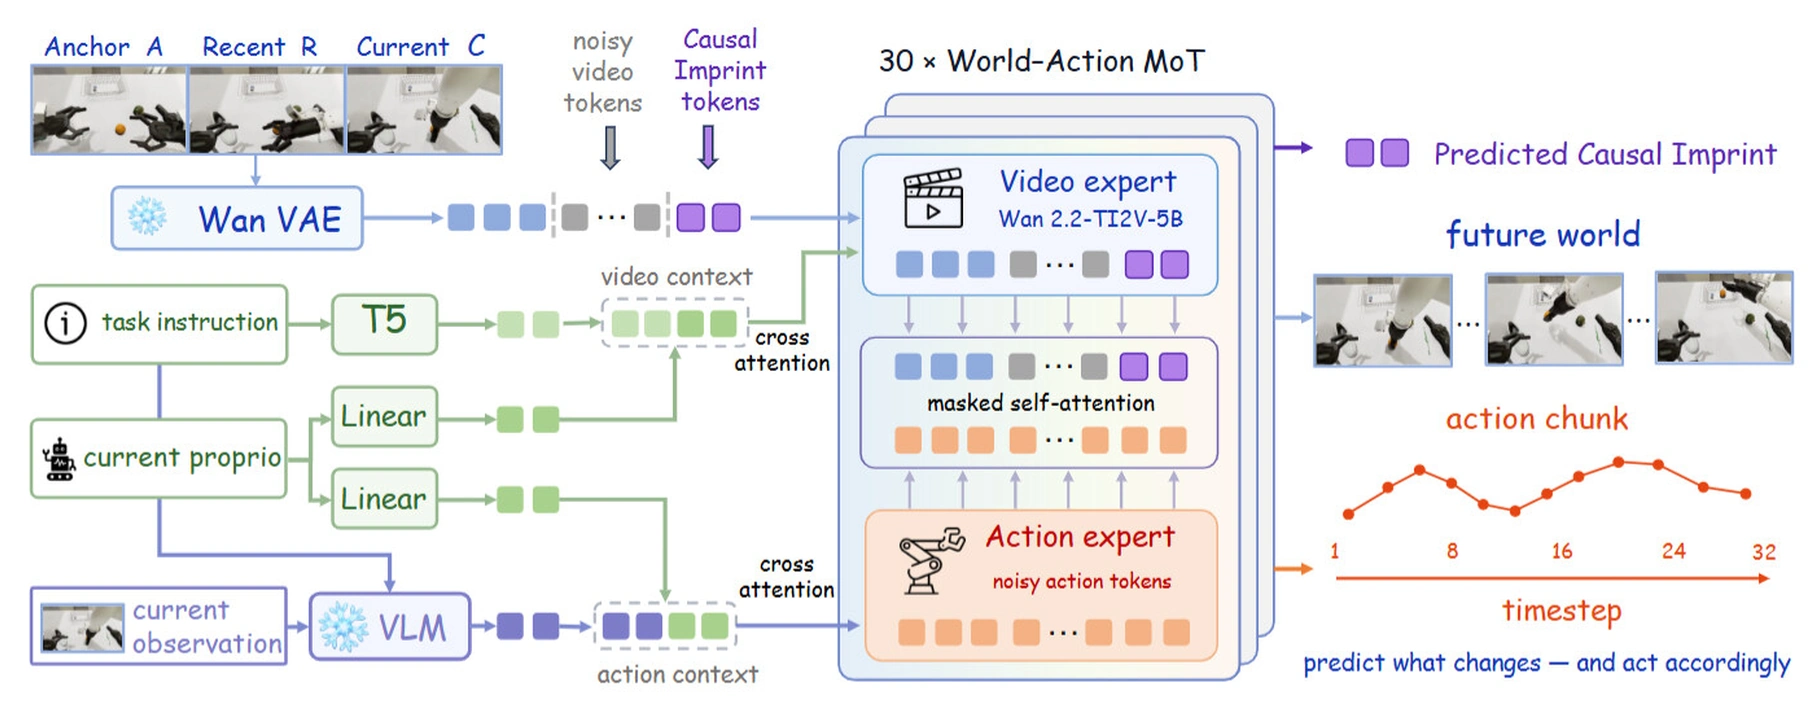
| InternW0-∆ | SHAILAB 出品的用开源数据与 Human2Robot 数据预训练的 WAM,采用统一动作空间;设计消融主要在 LIBERO-Plus、RoboTwin 等单一仿真测评中完成。 |
| Rho | 微软出品的分别围绕三个机器人本体预训练模型,再验证各自的后训练效果。 |
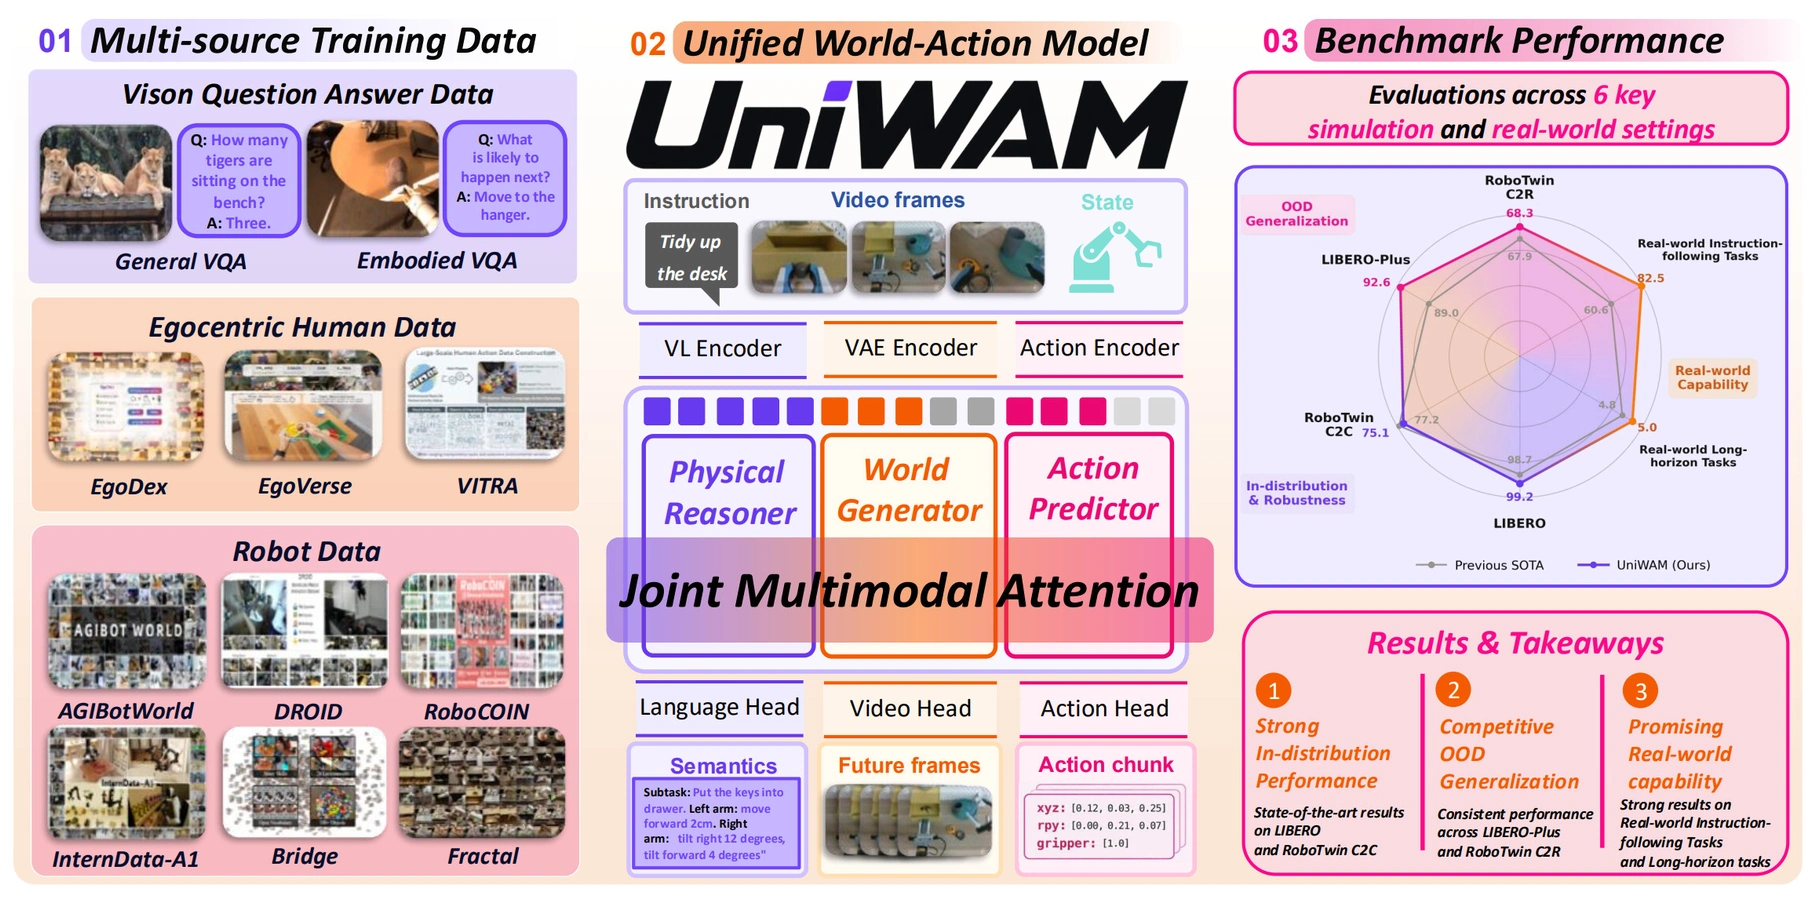
| UniWAM | UniWAM Team 出品的 VLM、WM 与 Actor 联合建模,混合机器人、Ego 和 VQA 数据,增加语言轨迹监督;VQA 分支在其消融中未显示提点。 |
| IronMind | 小鹏机器人出品的沿用 VLM + Actor 与训练期 WM 未来监督,以对齐坐标系的 10K 小时 Ego 数据预训练,再在人形机器人上后训练;开环与闭环表现并不一致。 |
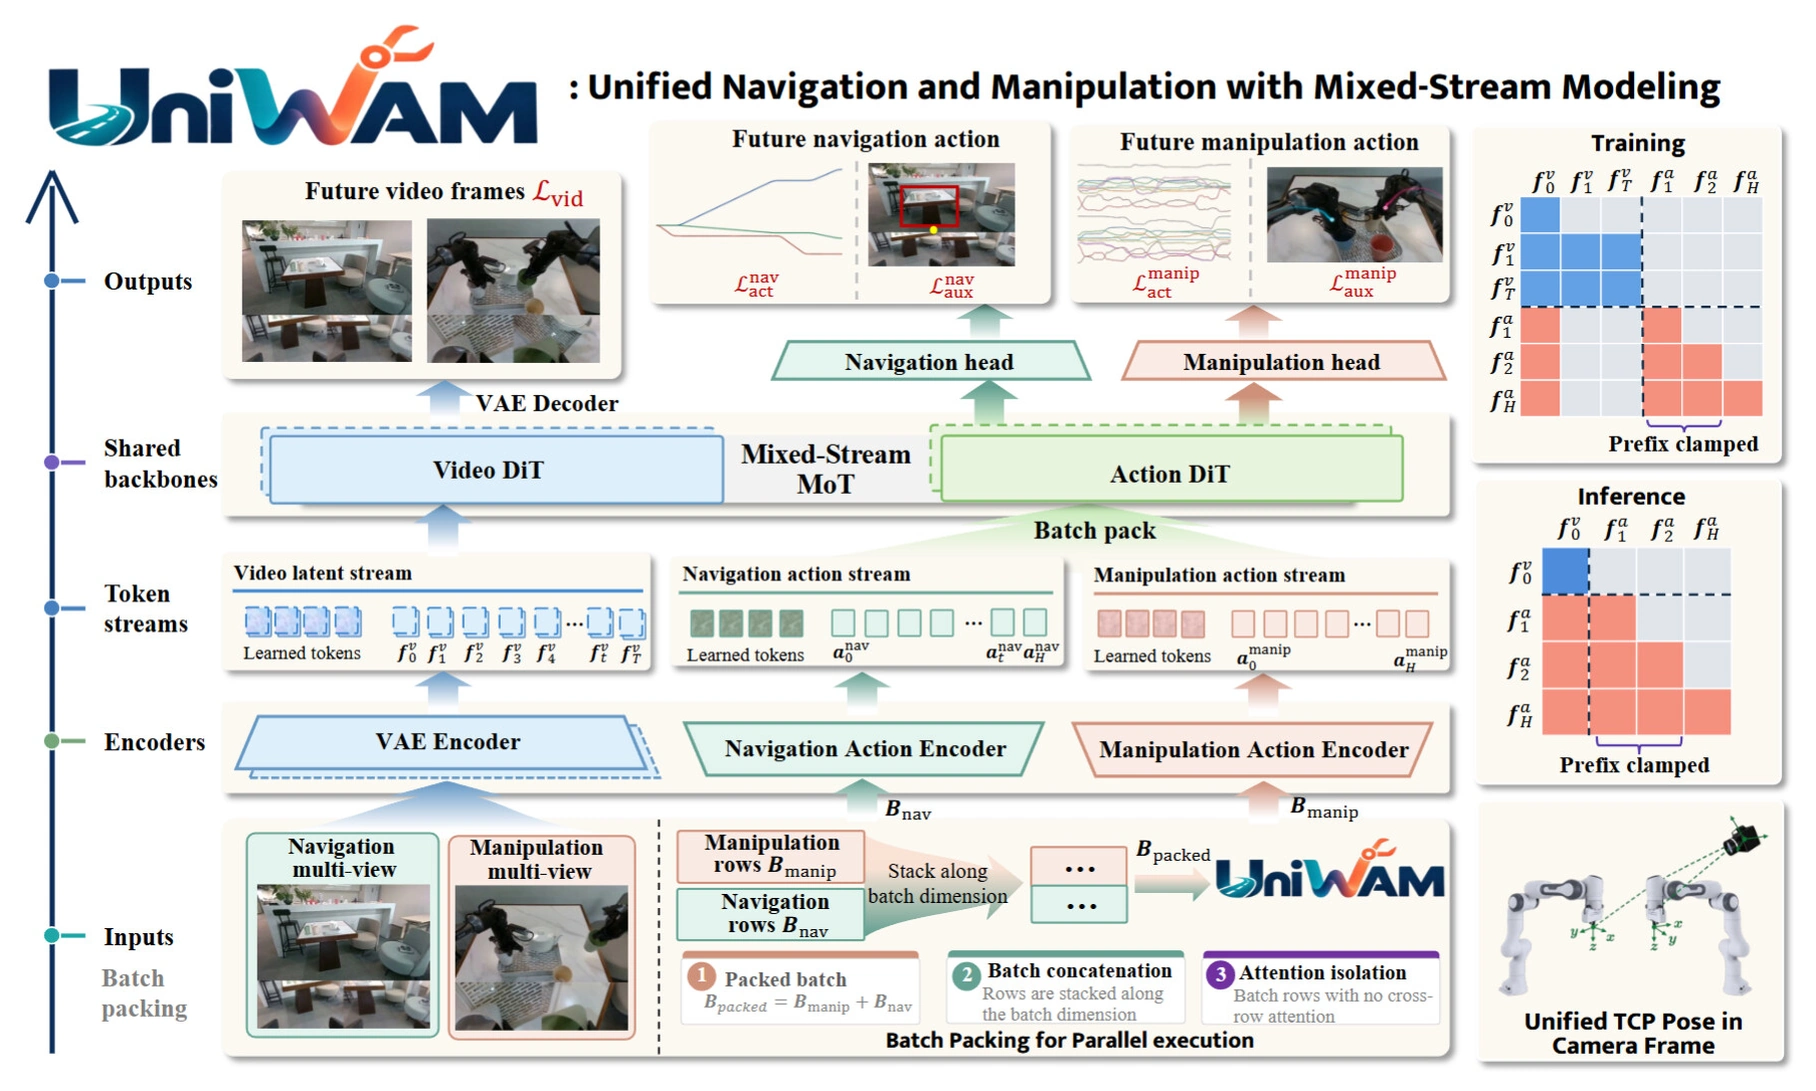
| UniWAM | Fysics AI 出品的用 Mixed-Stream MoT 与 Flow Matching 统一导航和操作,配套 MAP Bench 与真机测评 |
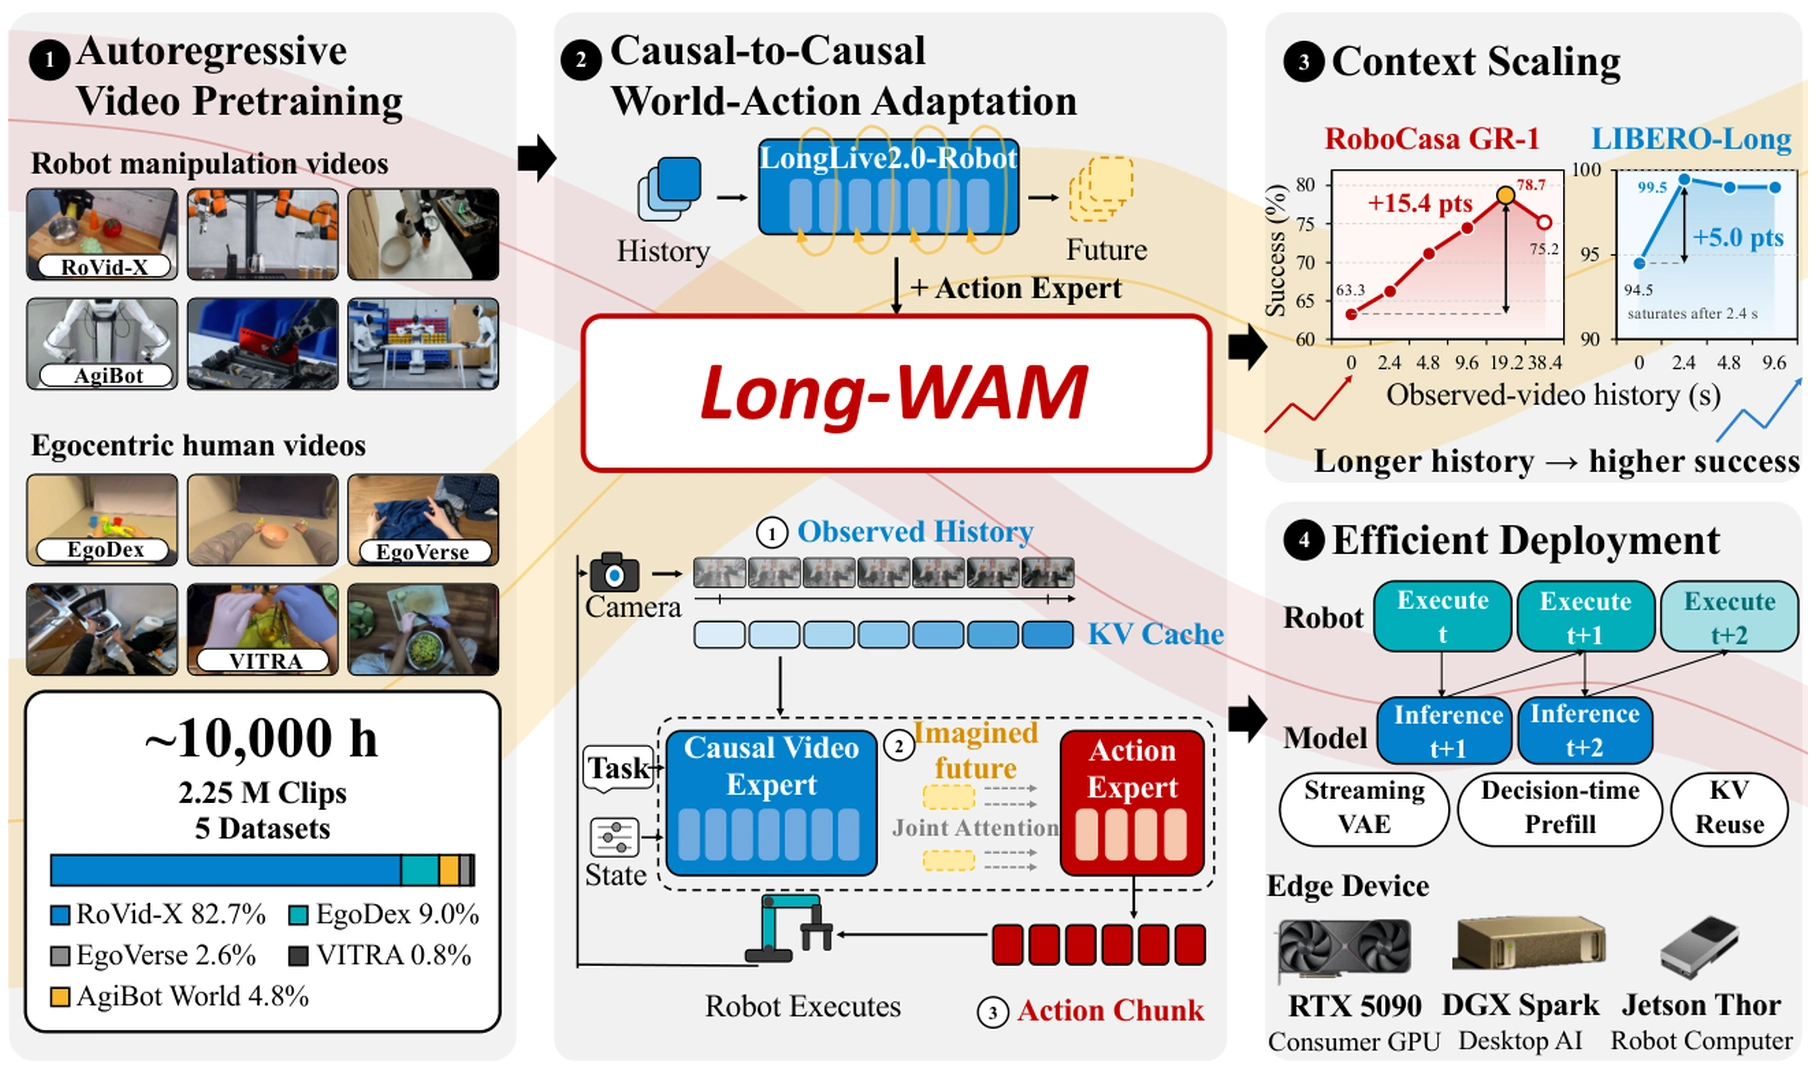
| Long-WAM | Nvidia 出品的自回归视频预训练的 WAM,以 KV cache 保留历史,先视频 latent 后动作,配合部分去噪、流式 VAE 与异步执行降低推理开销。 |
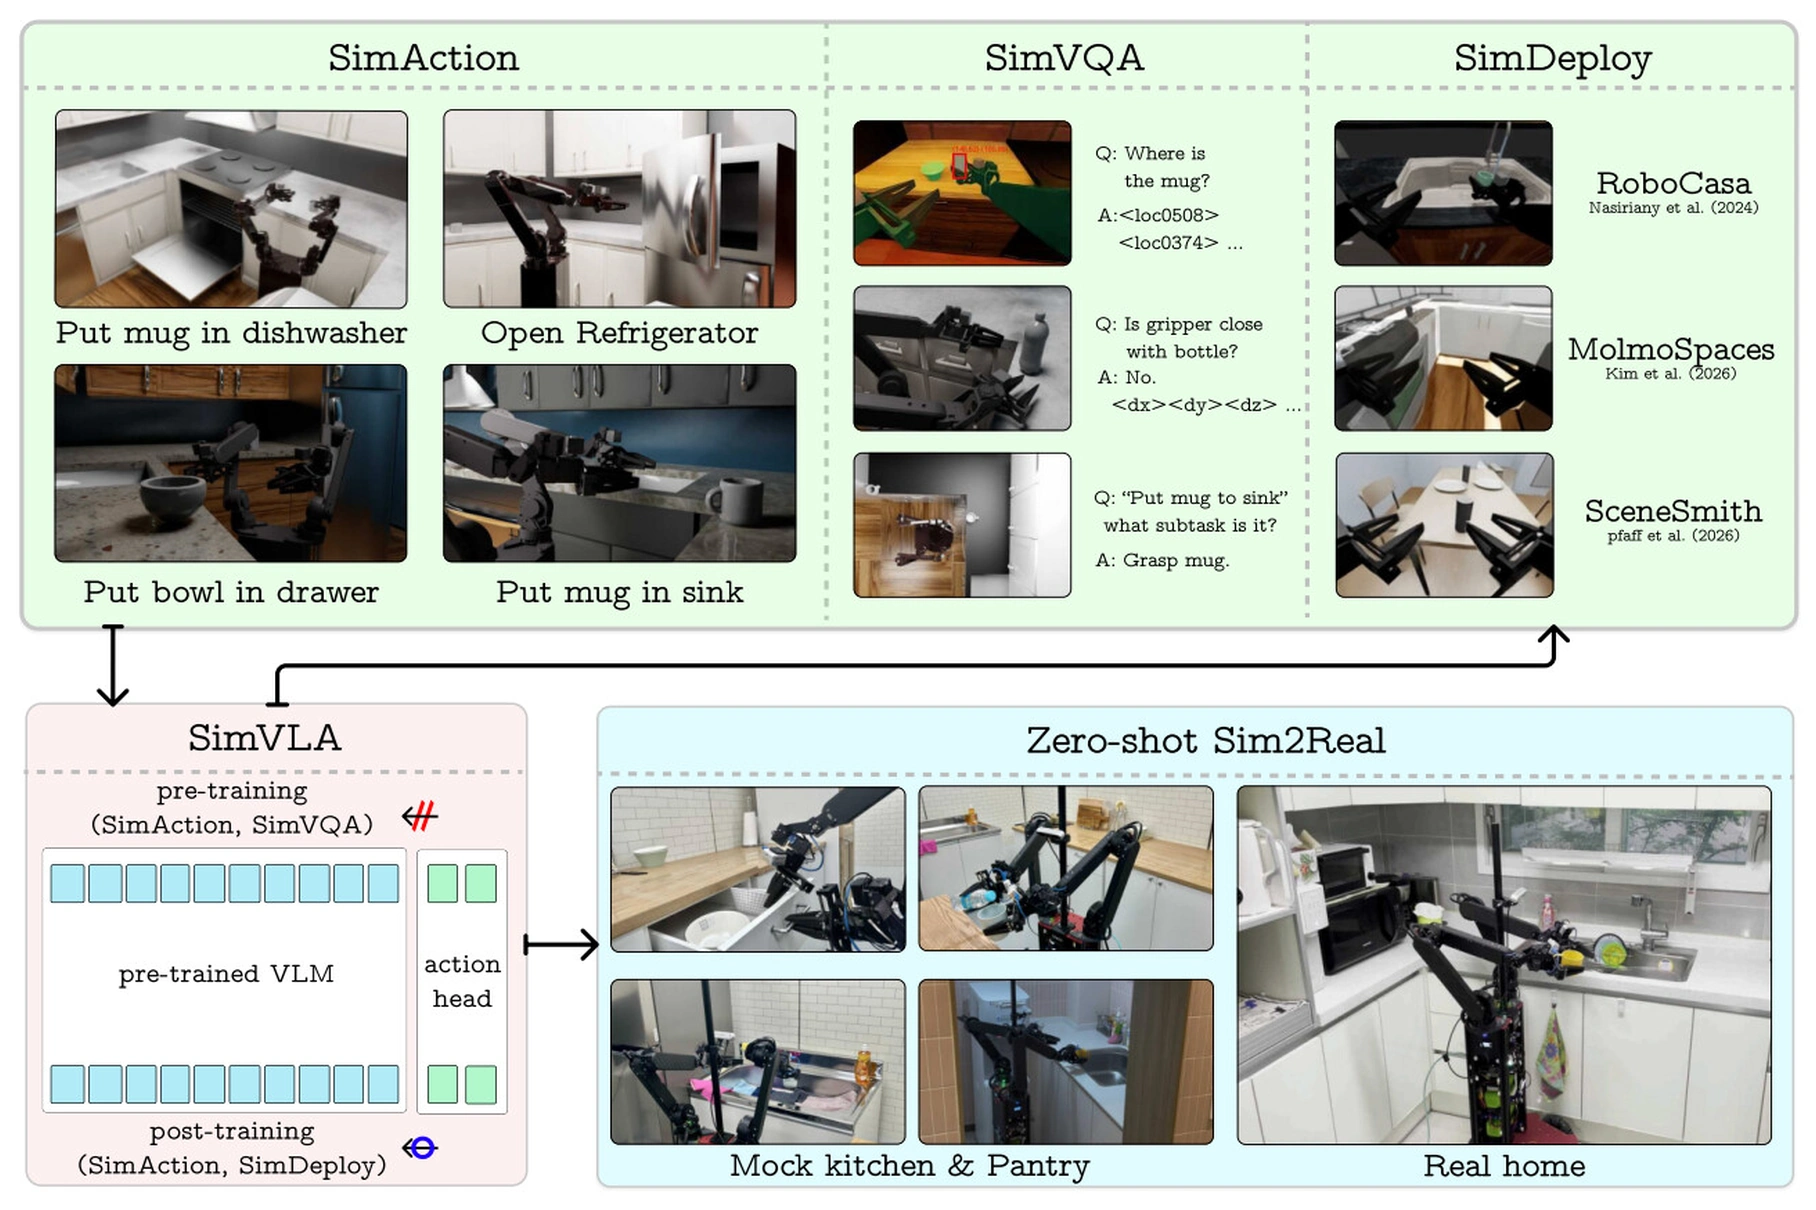
| SimVLA | 韩国两名研究者出品的扩展 SimAction、SimVQA 与 SimDeploy 数据,联合训练动作和视觉语言能力,再以仿真后训练验证移动操作的 Sim2Real。 |
| VPP2 | 星动纪元出品的三阶段训练 WAM:机器人视频续训练、单步蒸馏并固定预测时域、加入 MoT 做机器人预训练;数据混合开源、自产 Ego 与双臂示范。 |
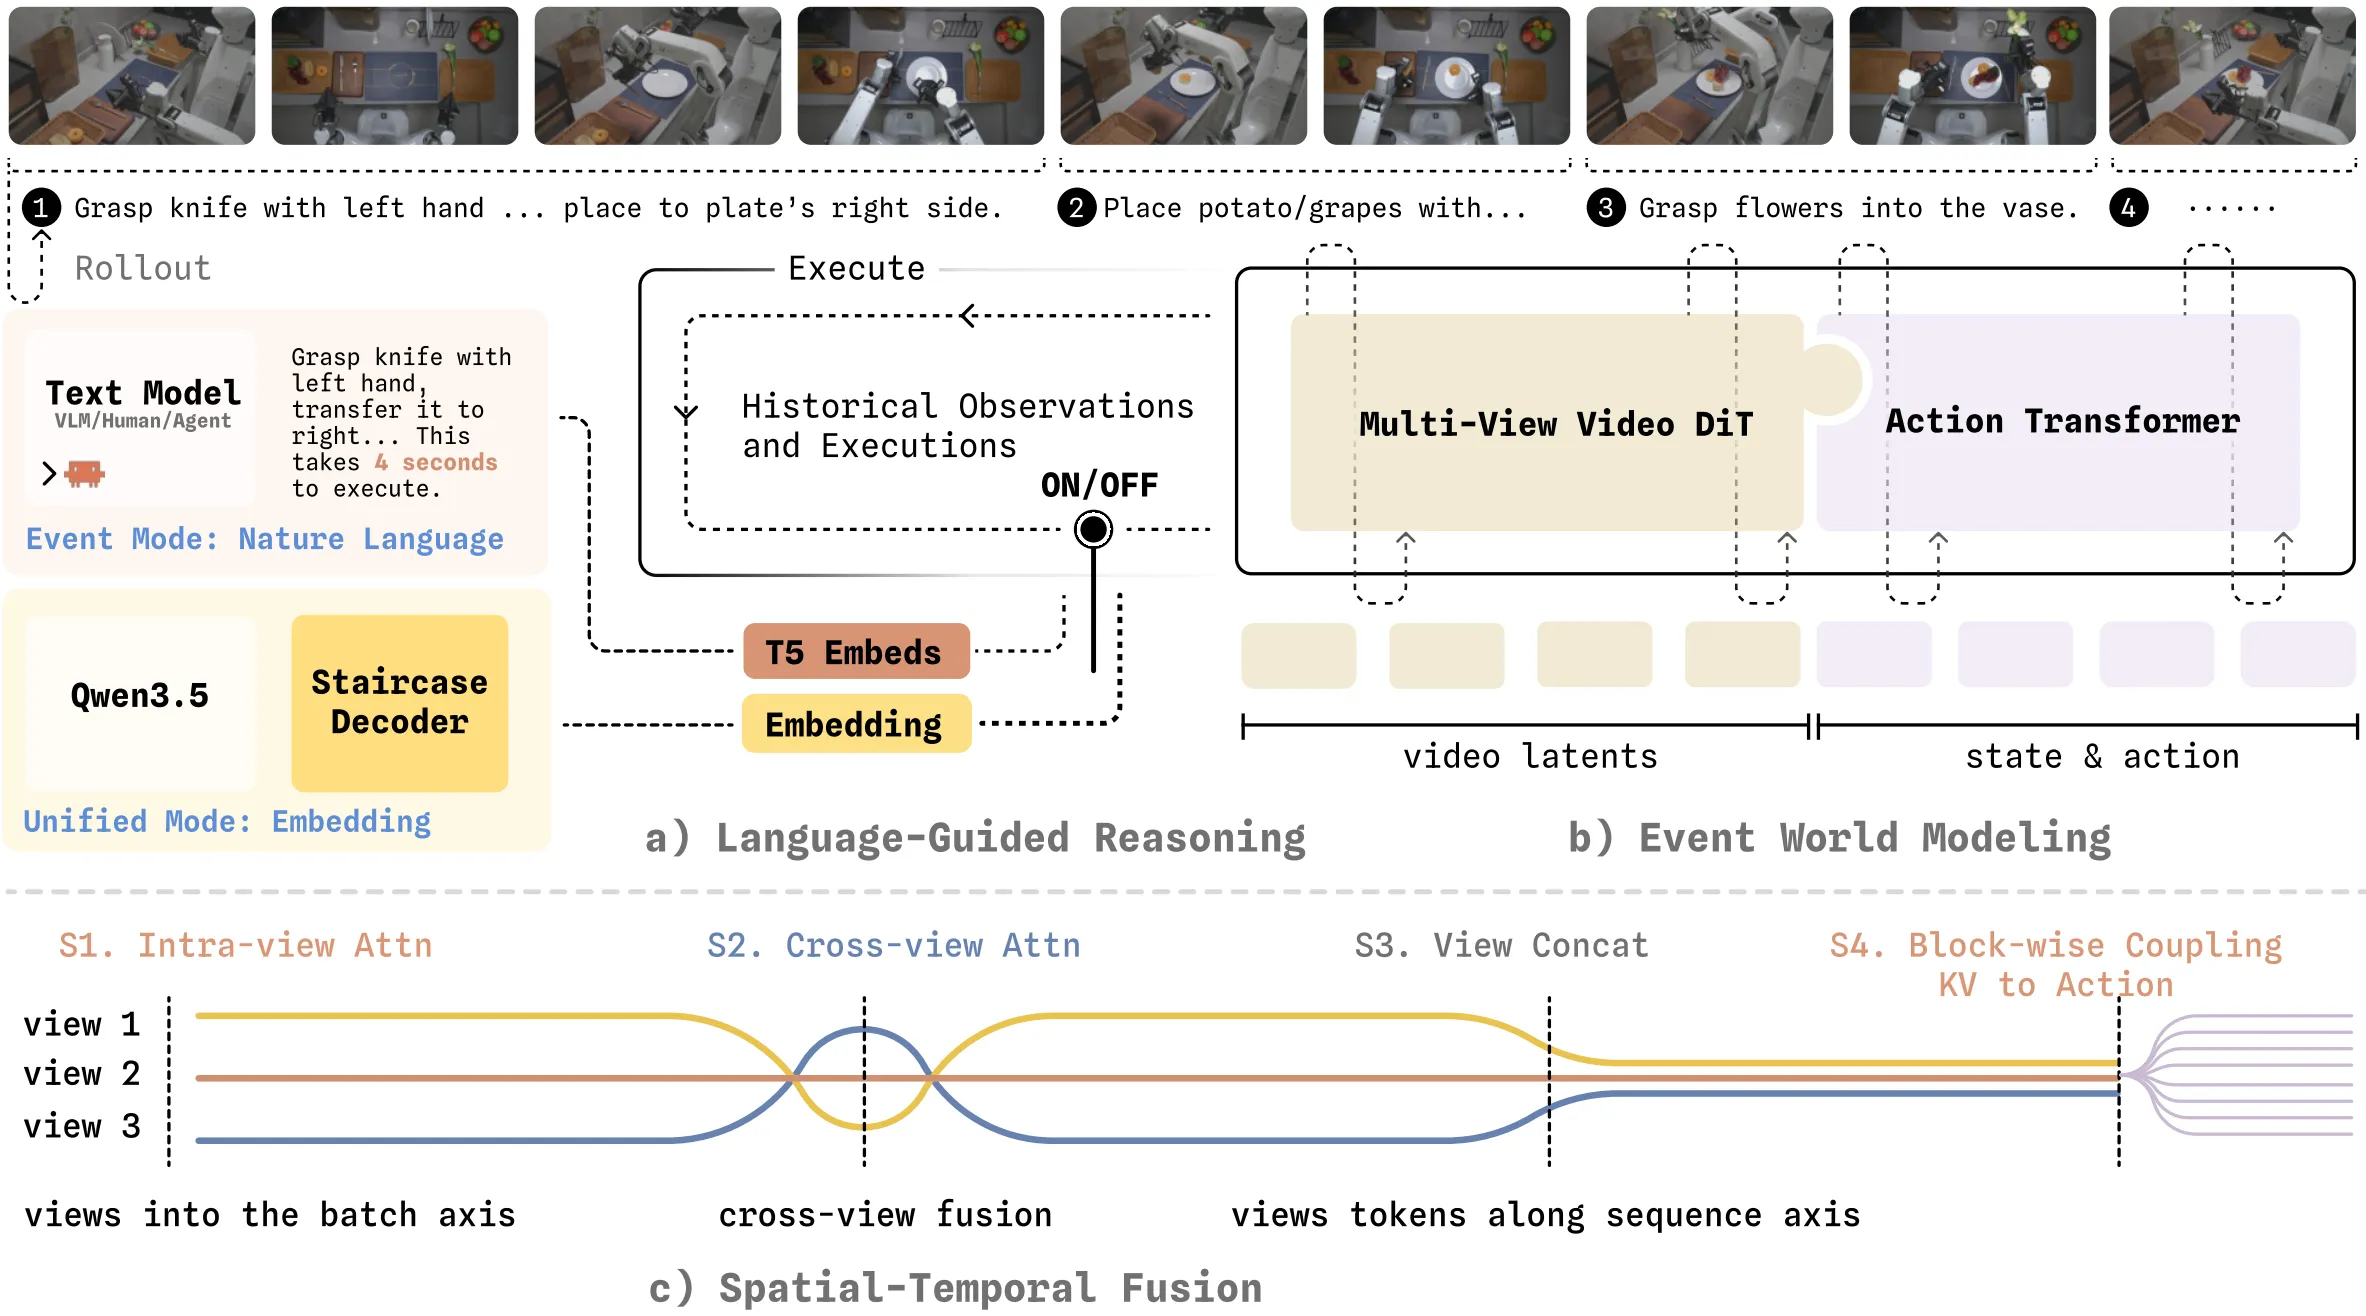
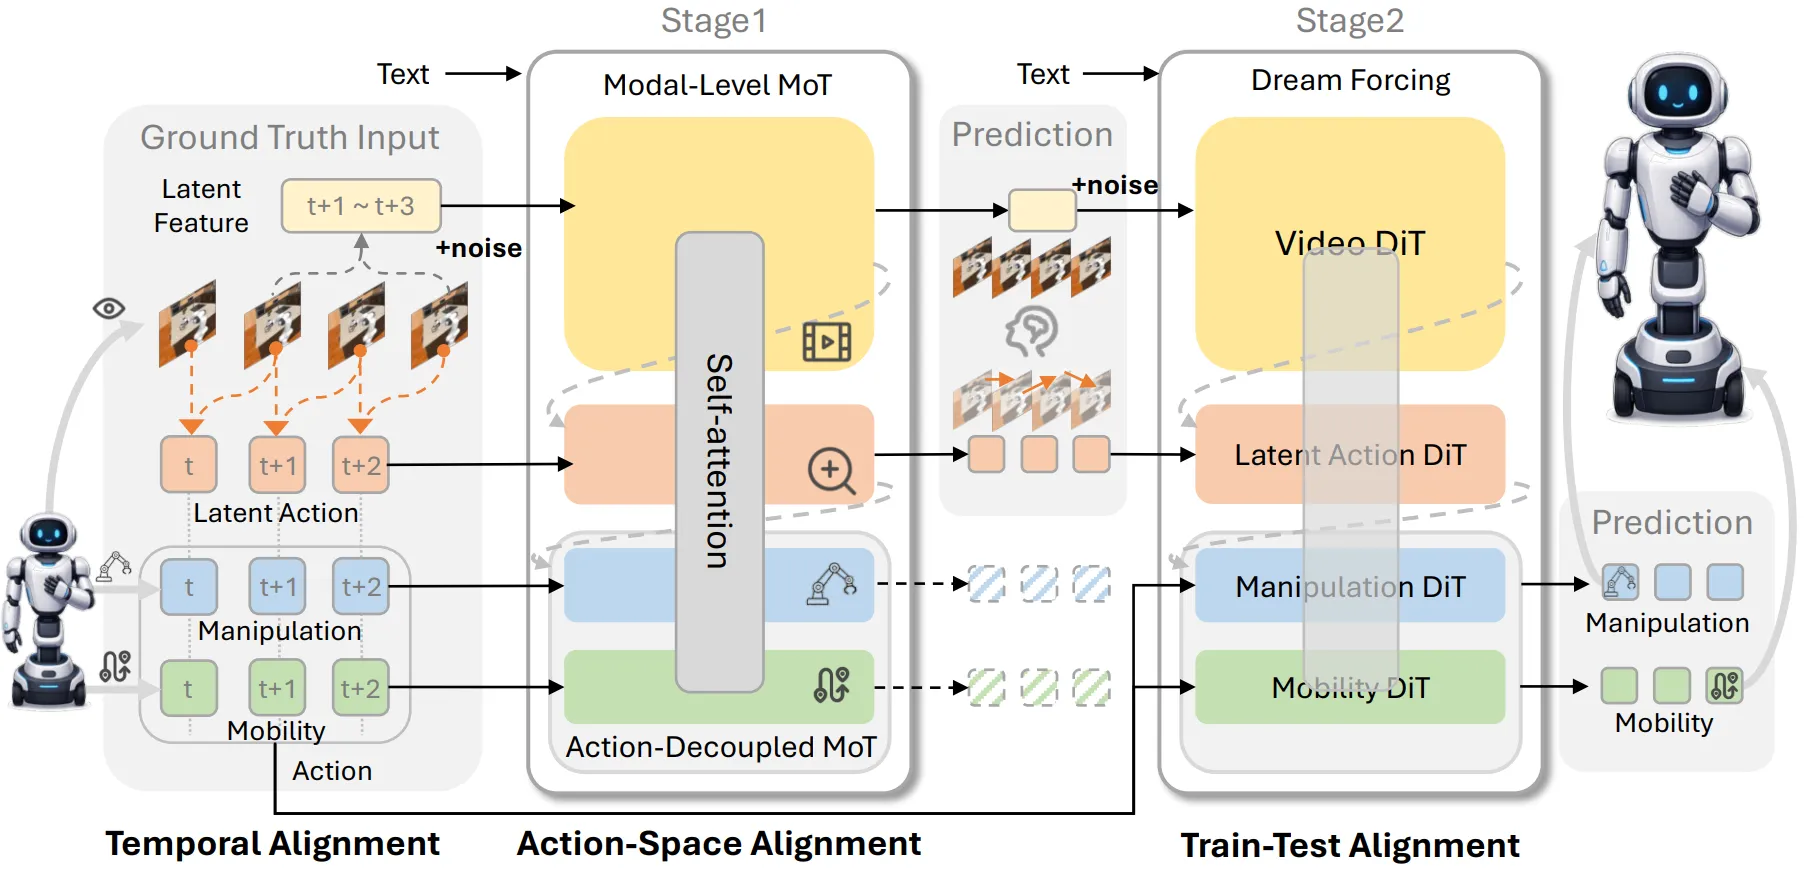
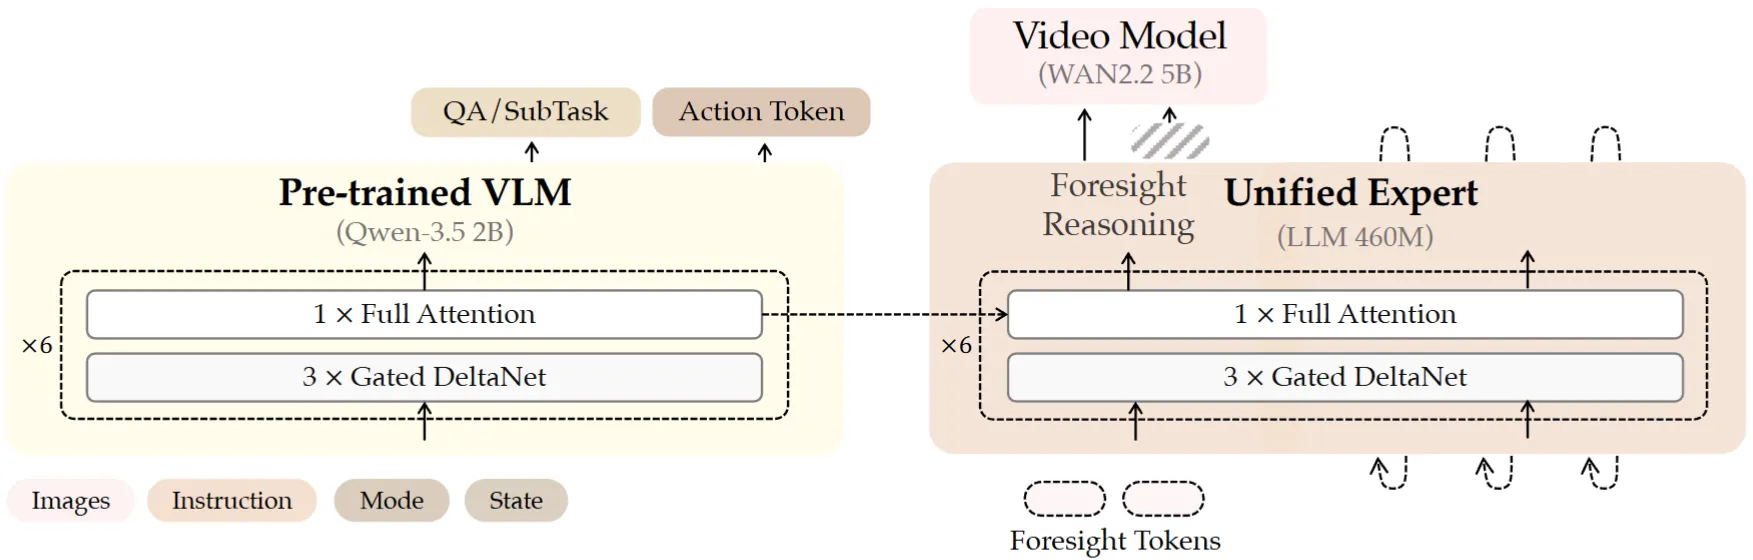
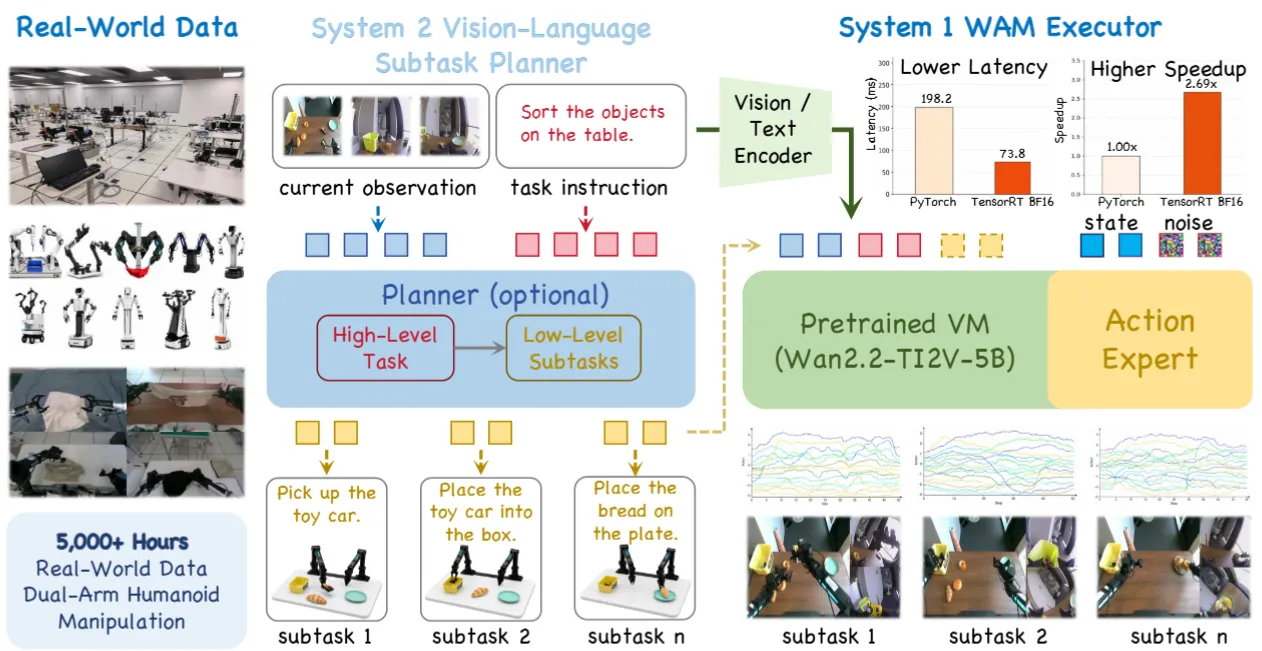
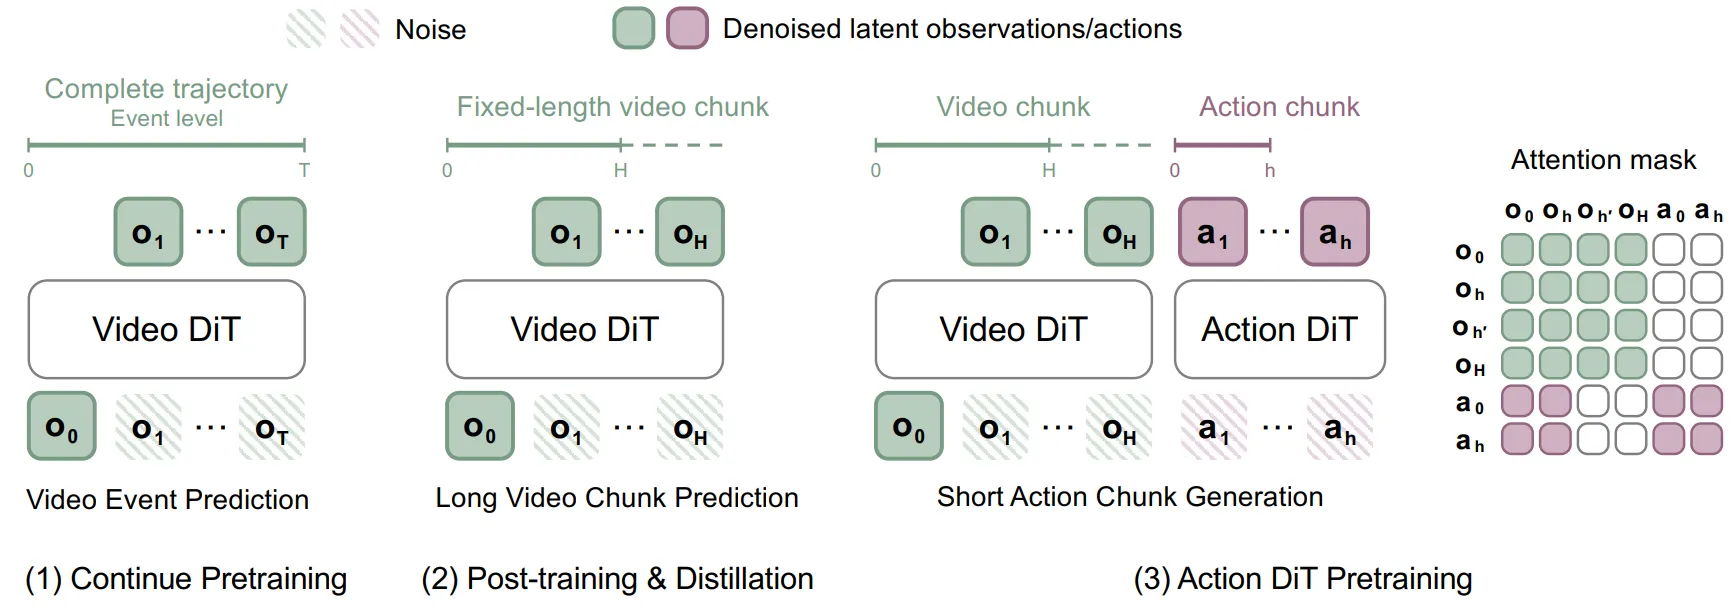
新架构探索/其他#
一些不足以作为代表性,但是相对有一些值得一提的点的论文将被放在这里,但是总体上它们依然遵循 VLA 的任务范式:
dVLA#
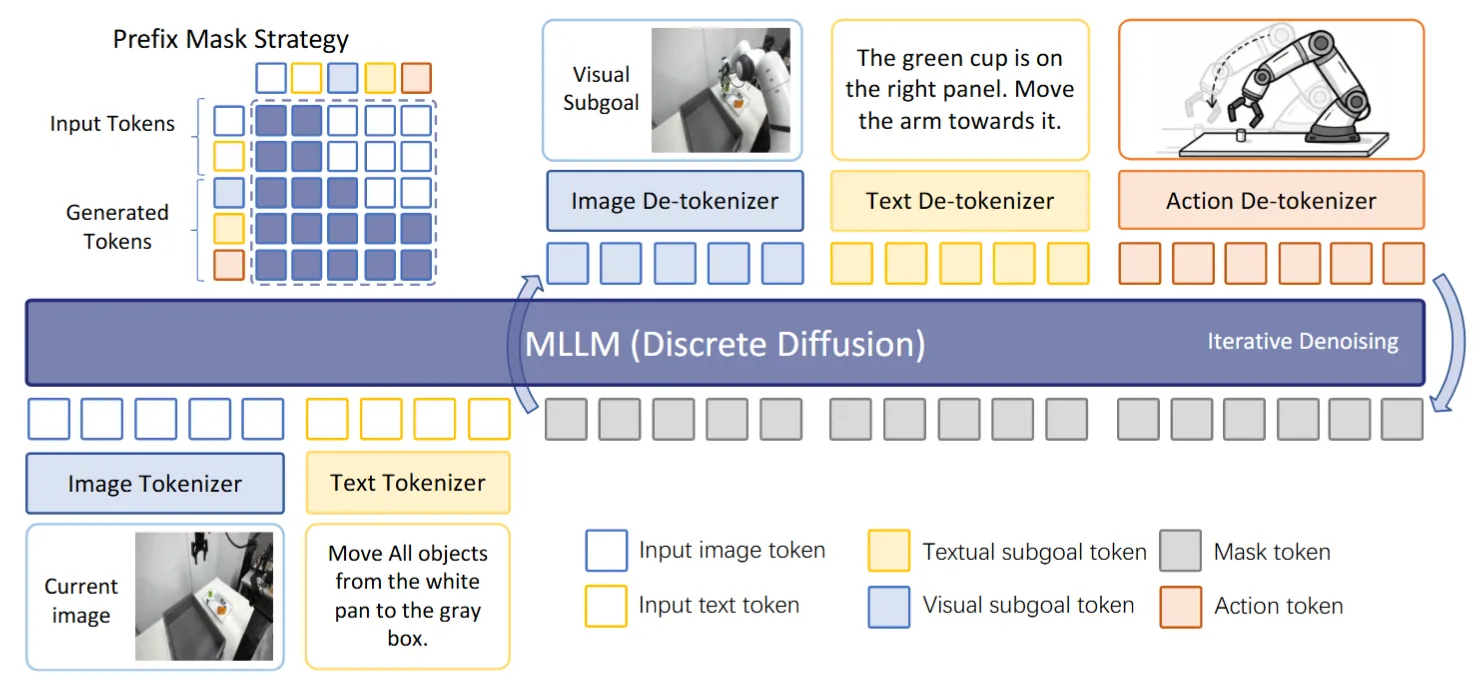
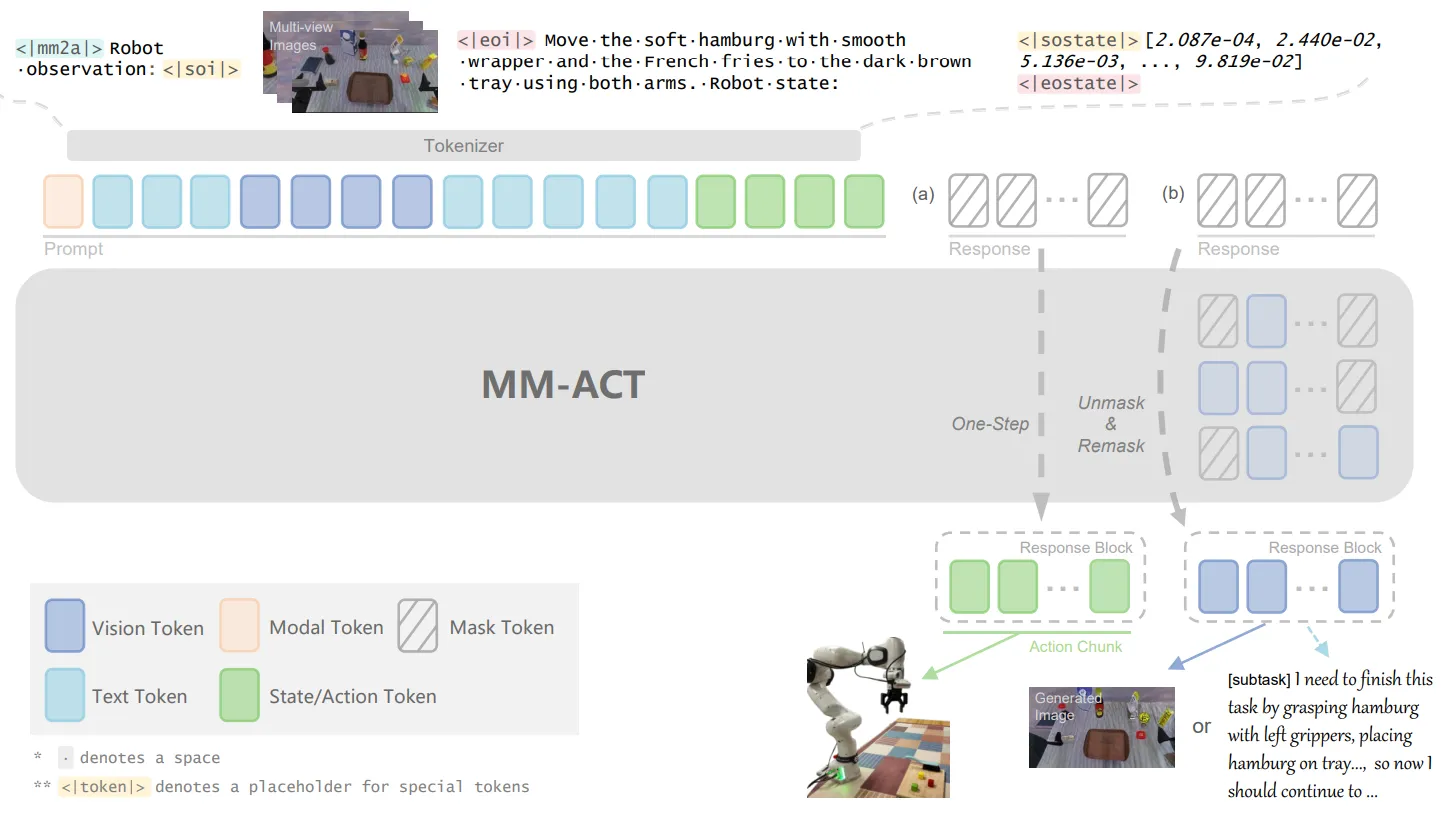
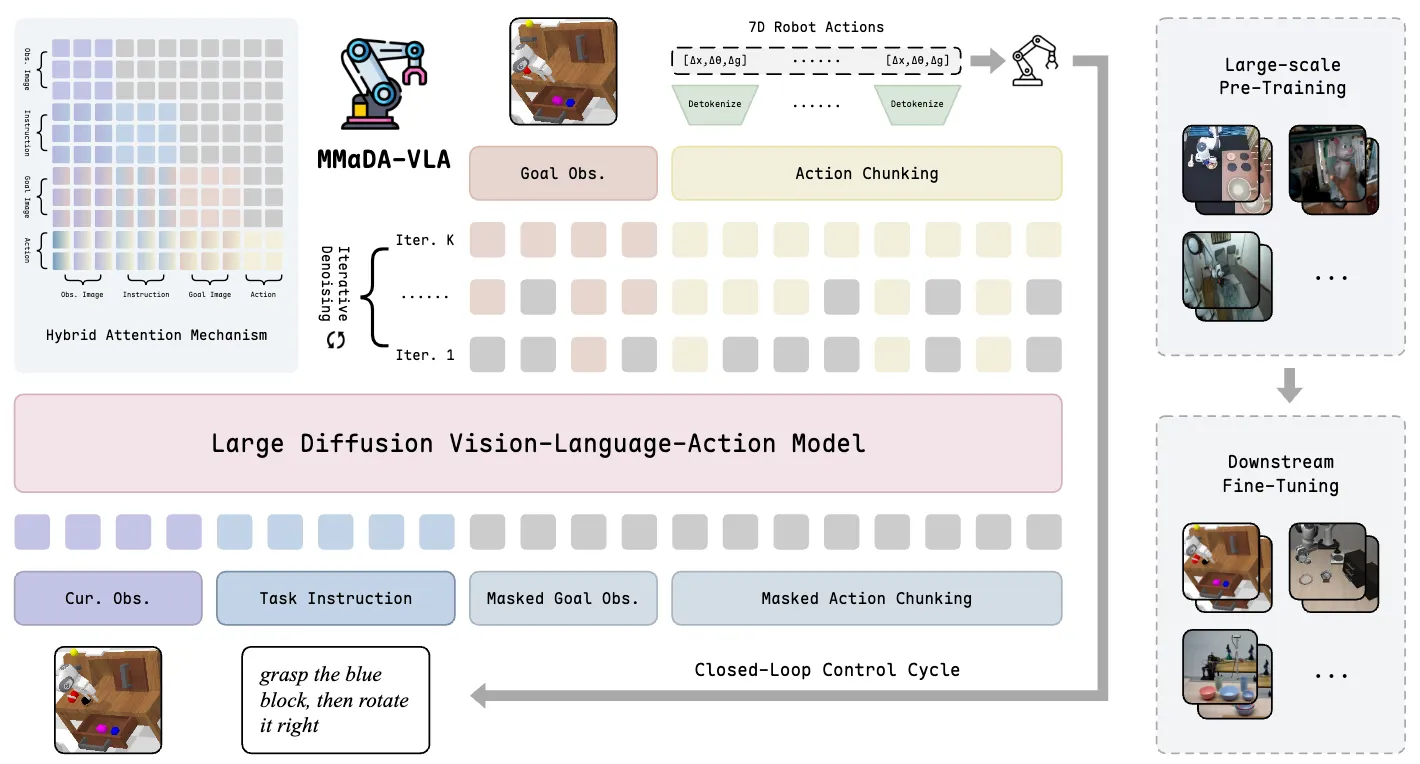
dVLA 即基于 Diffusion LM 或者 VLM 搭建的 VLA 模型,依然保持 Unified 的 training objective。本质上,dVLA 的出发点其实源自于“AR action token 之于 VLM”的思路。既然我们希望输出连贯的动作信息,而这些动作信息多半是通过类似 flow matching 的形式得到的,那么在无法抛弃 action 的 flow matching 监督的情况下,想要去 fully leverage VLM 的能力,另一个自然的思路就是:使用通过 flow matching 等方式进行学习的 VLM 模型进行后续的训练,即 Diffusion VLM。
| 论文 | 主要贡献 |
|---|---|
| dVLA | 比较规整的 dLLM 用 diffusion 同时预测 image、language 以及 action |
| MM-ACT | 基于 LLaDA 的 dVLA,可同时预测 Visual Language Action 三种表征。 |
| MMaDA-VLA | 基于 MMaDa 的 dVLA,预测 Goal Image 以及 Action |
其他架构#
在这里,我们简单列举一些使用其他模型结构进行简要探索的相关工作:
| 论文 | 主要贡献 |
|---|---|
| HALO | 文本 CoT / 视觉 subgoal / 动作三专家 MoT VLA |
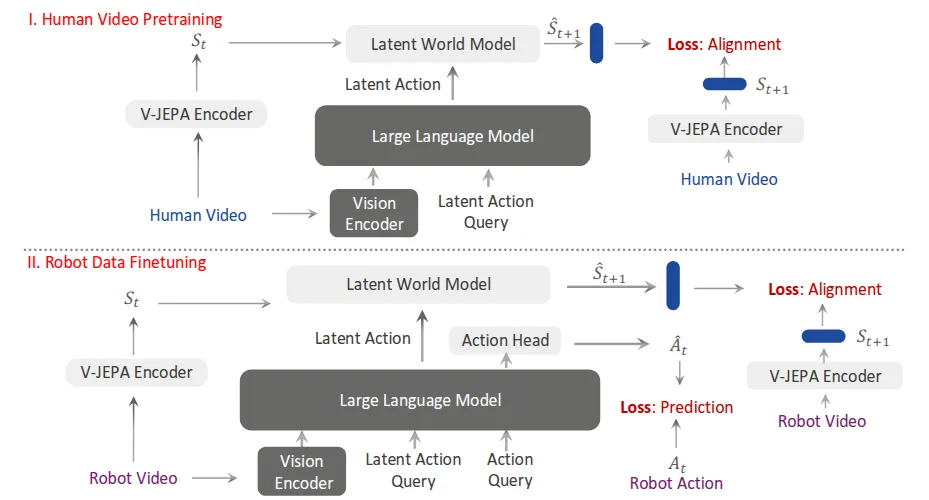
| VLA-JEPA | JEPA 风格的 latent 未来预测作为协同监督从而可以 Leverage Human Data |
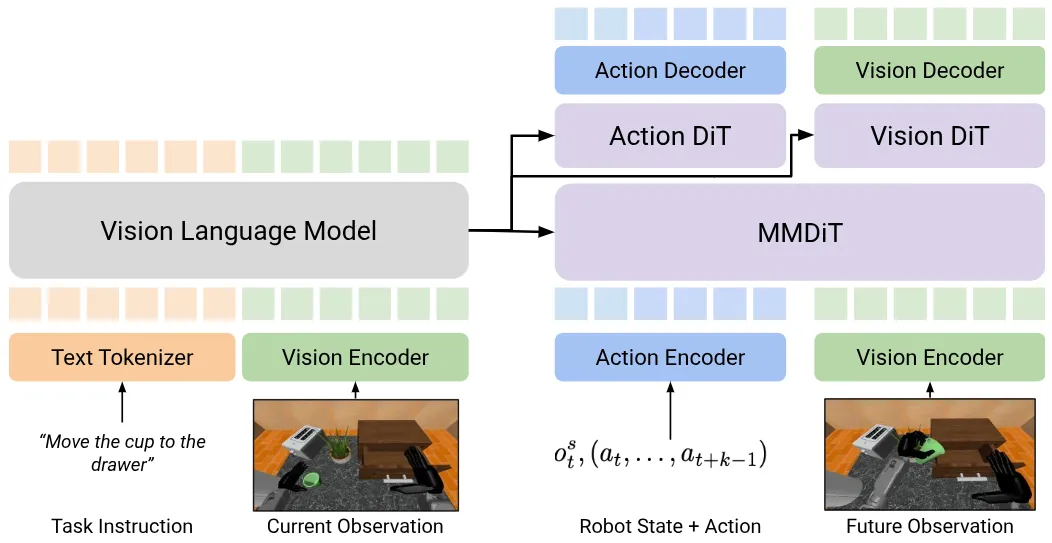
| DUST | 在 Actor 部分使用 MMDiT + Joint Diffusion |
| BagelVLA | 使用 Babel 的 VLM + VLA + Actor MoT,同时探索了桥接的不同降噪策略 |
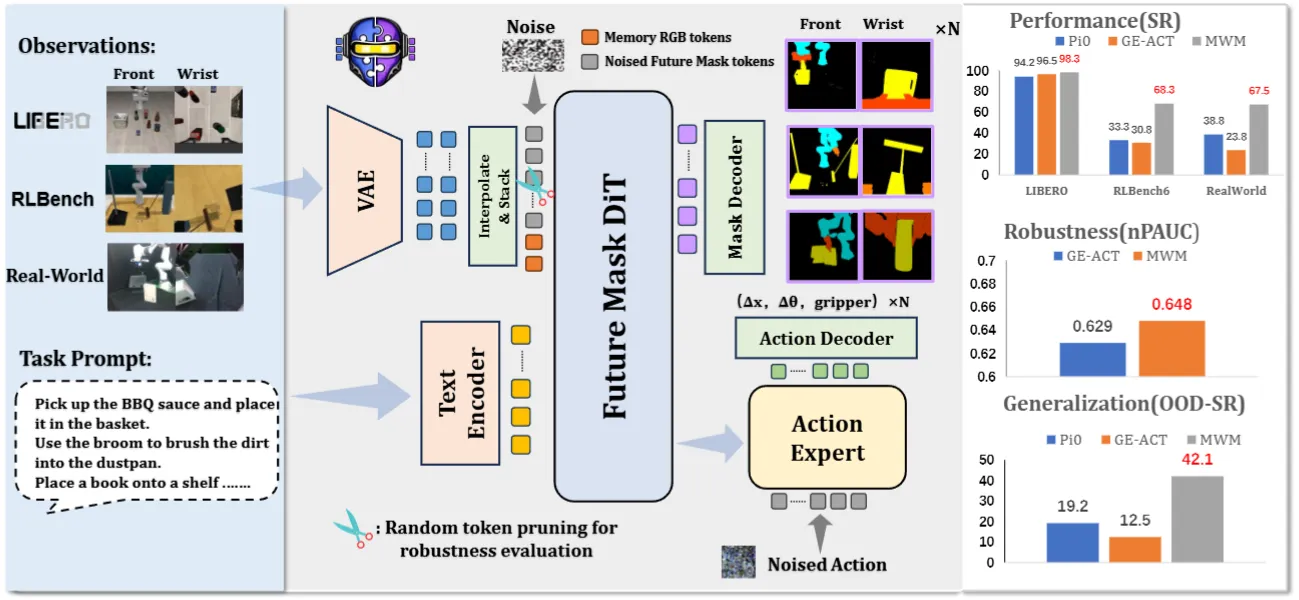
| MWM | 预测未来的 Mask 的 WM + Actor DiT 的 WAM |
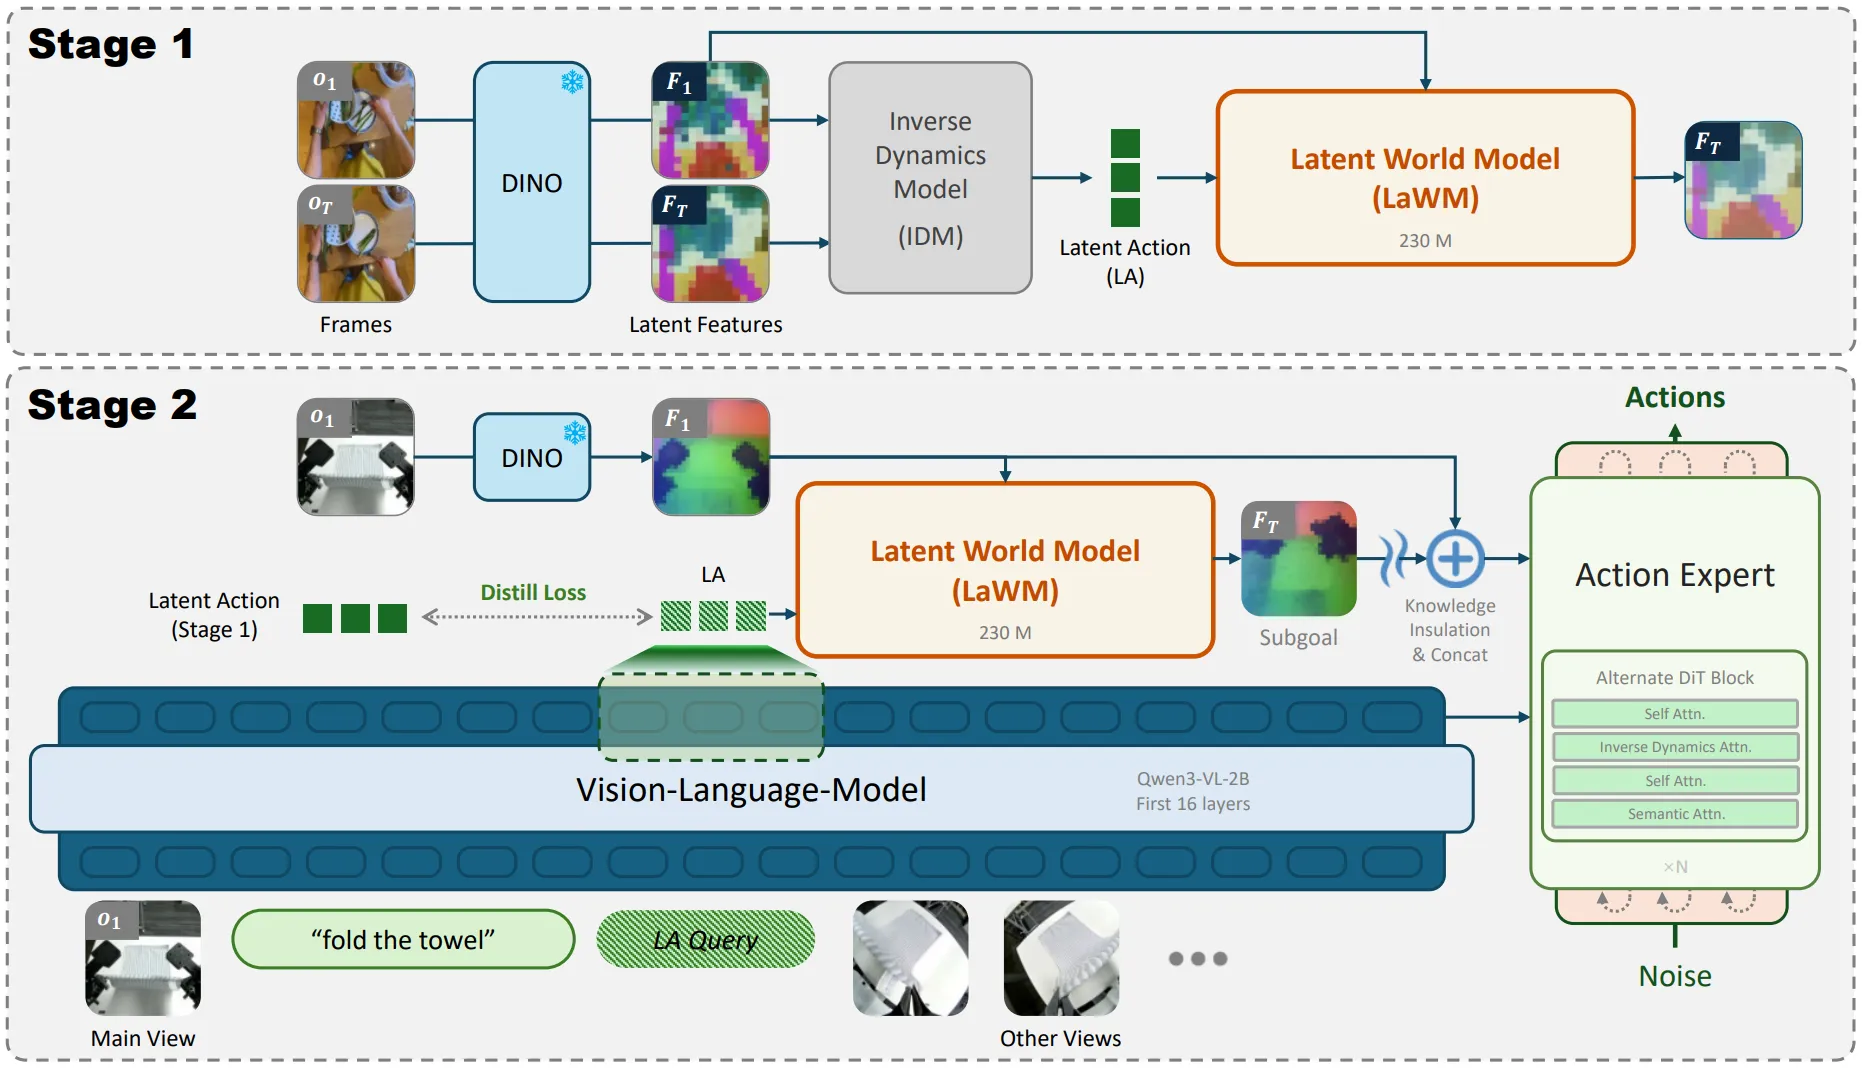
| LaWAM | 训练 Latent WM,VLM 预测 Latent Action 输入给 LaWM 预测 Latent Feature 然后输入给 Actor |
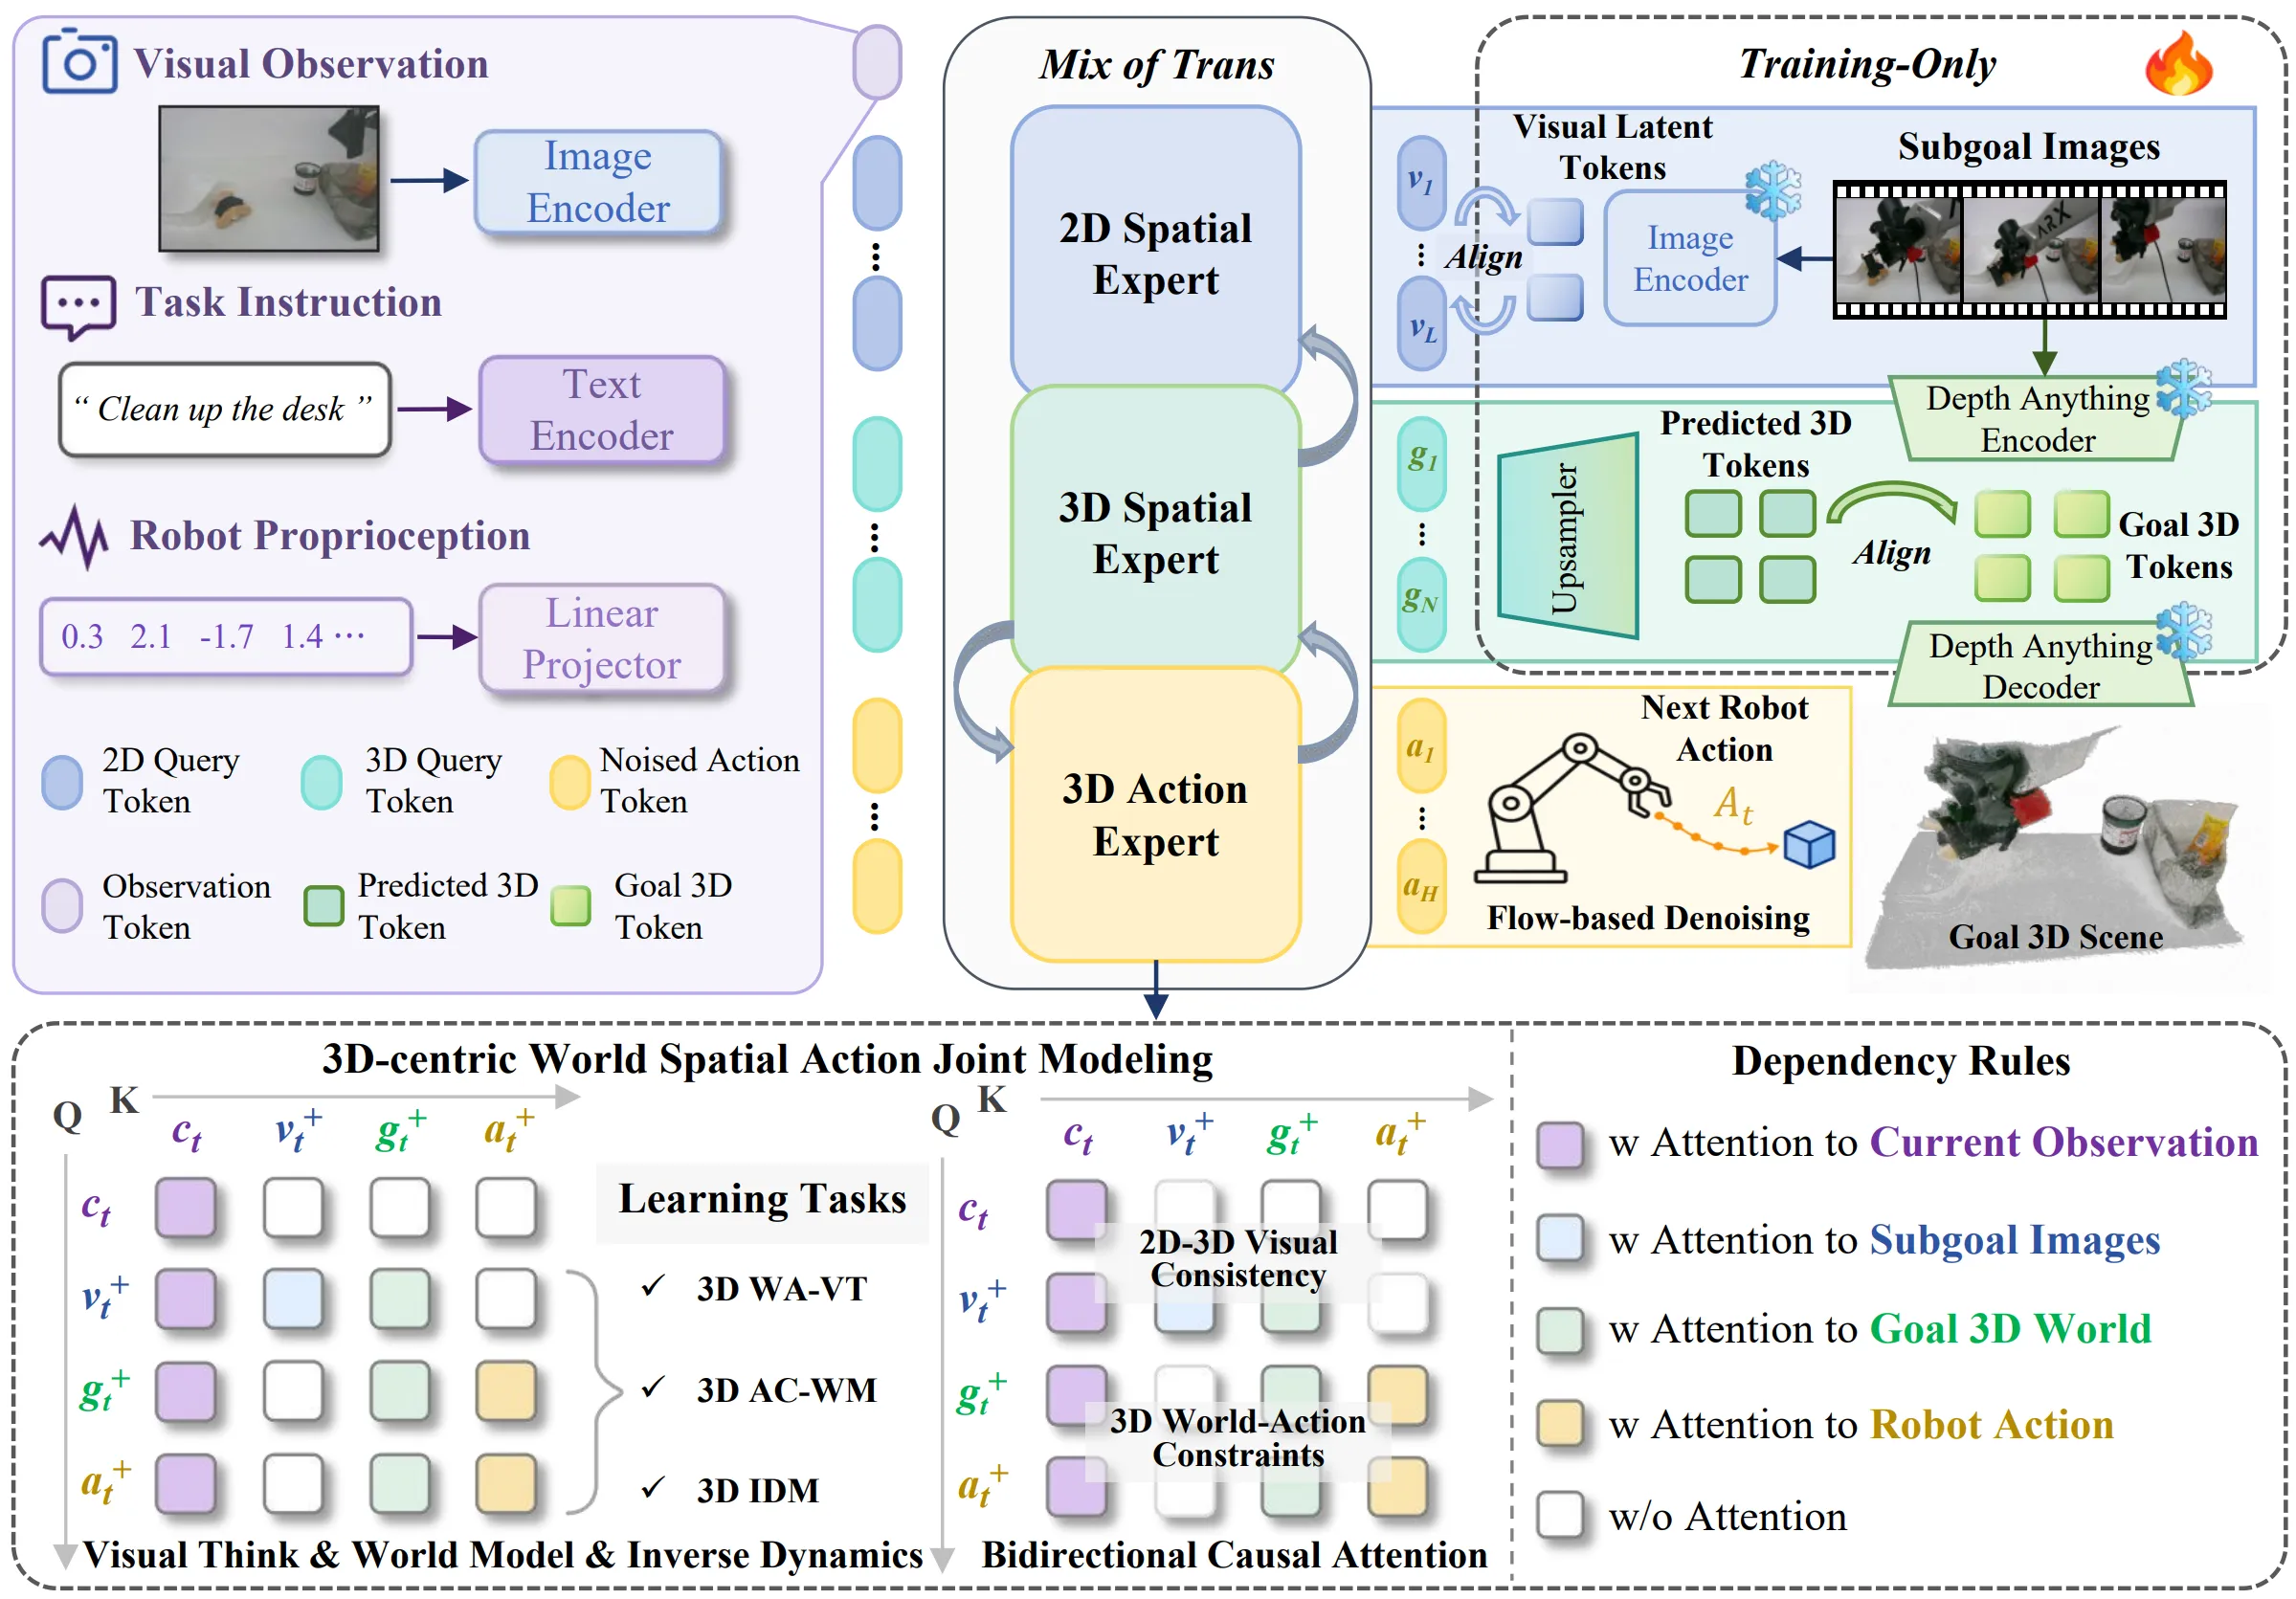
| 2D Thinking + 3D Modeling + Action 的 MoT VLA | |
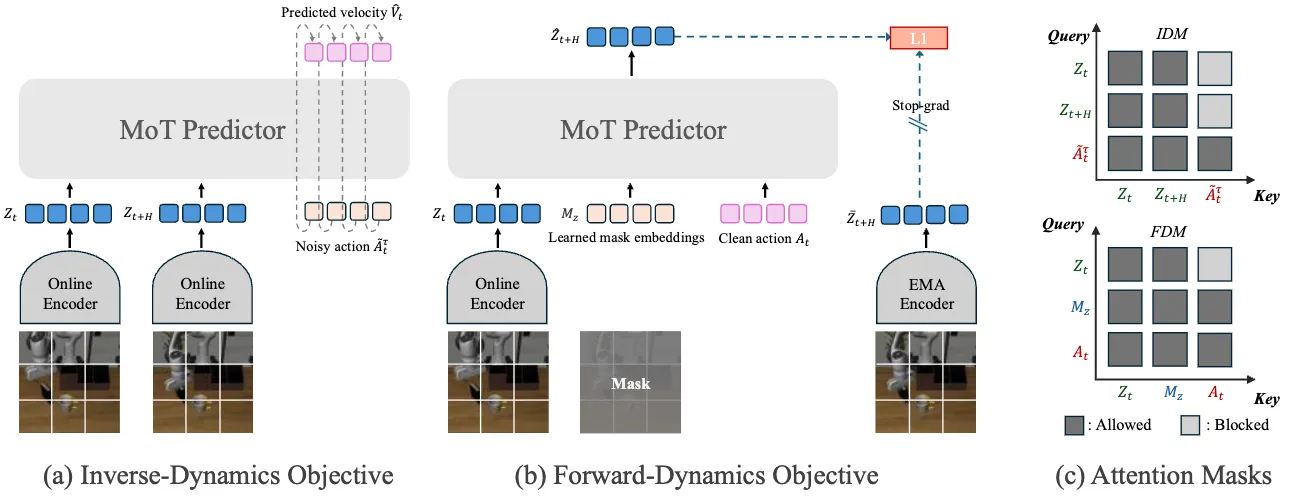
| SLIM-0.5B | Stage 1 训练 FDM 以及 IDM 的 MoT,之后在 Stage 2 训练纯 FM |
| LAWA | 用紧凑的 Latent Action 表达未来意图,桥接视频与动作专家,减少完整未来视频生成;主要验证后训练阶段的收益。 |
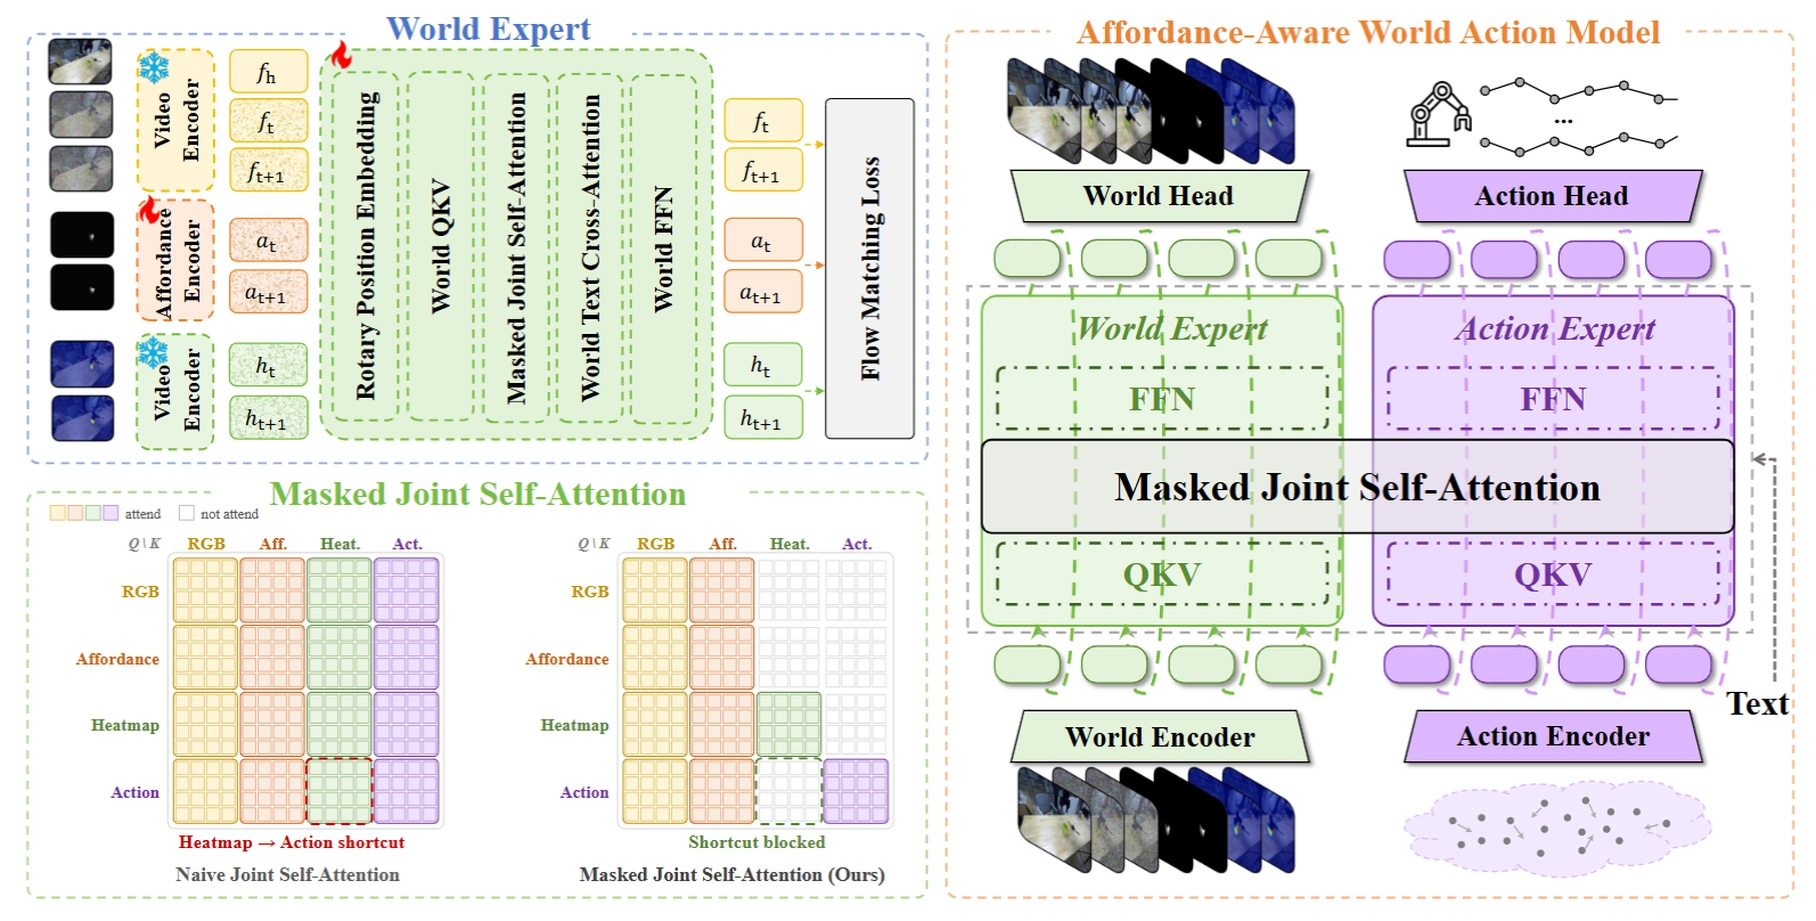
| AffordanceWAM | 在 MoT WAM 中加入 affordance 热力图的学习与预测,为未来建模和动作生成增加空间监督。 |
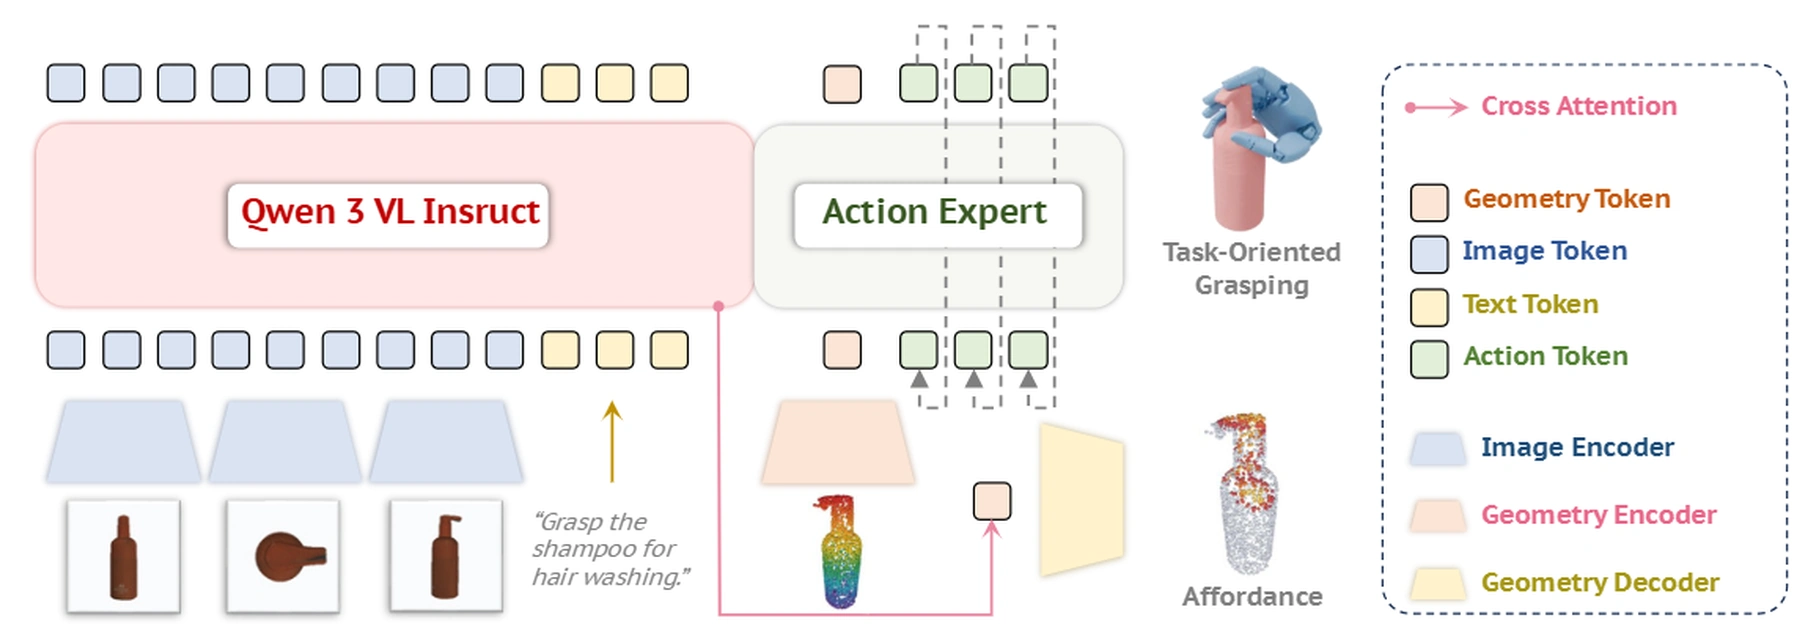
| OpenDexGrasp | 采用 Qwen + Actor 输出动作,以构建数据训练模型,并加入 affordance 等中间信息。 |
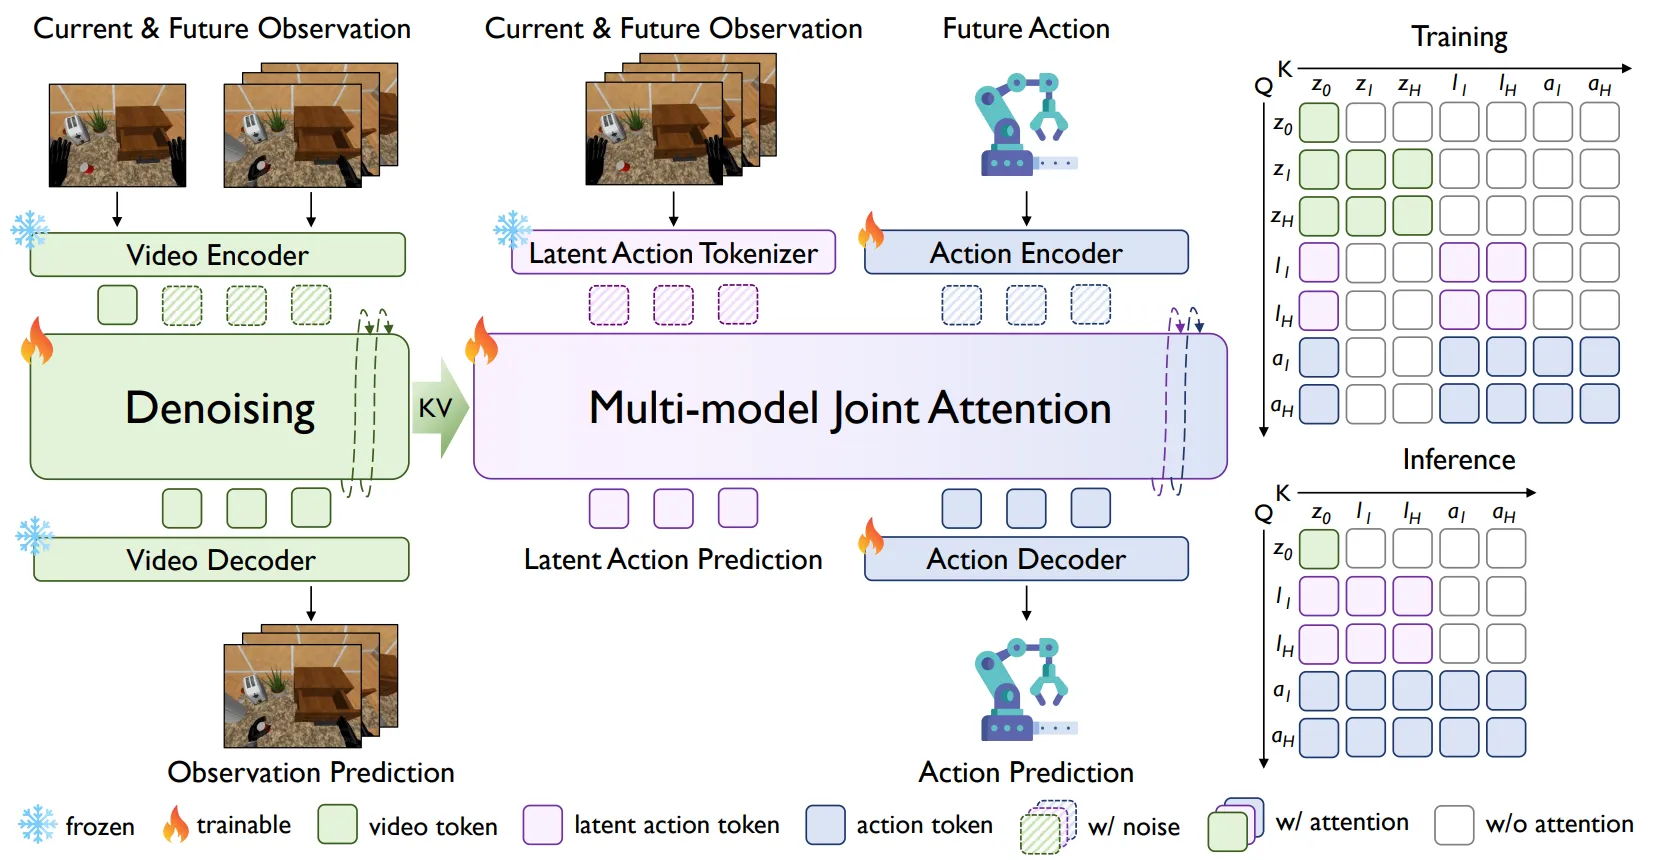
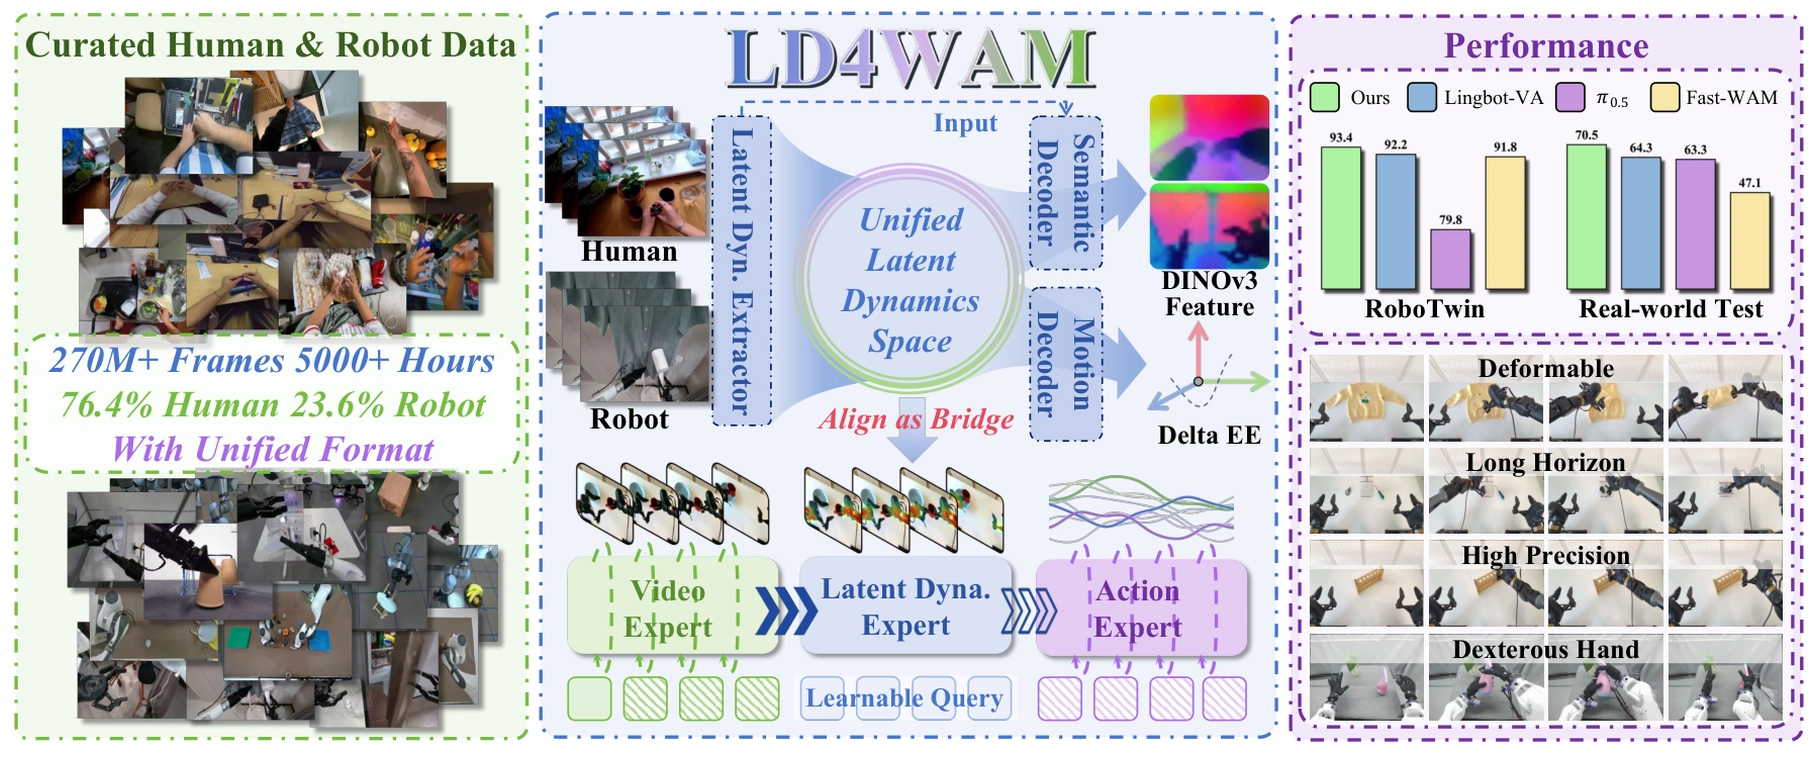
| LD4WAM | Video、Latent 与 Action 三专家混训,以人类视频为主要数据来源,并用 EEF 与语义监督 Latent;没有对数据本身做消融。 |
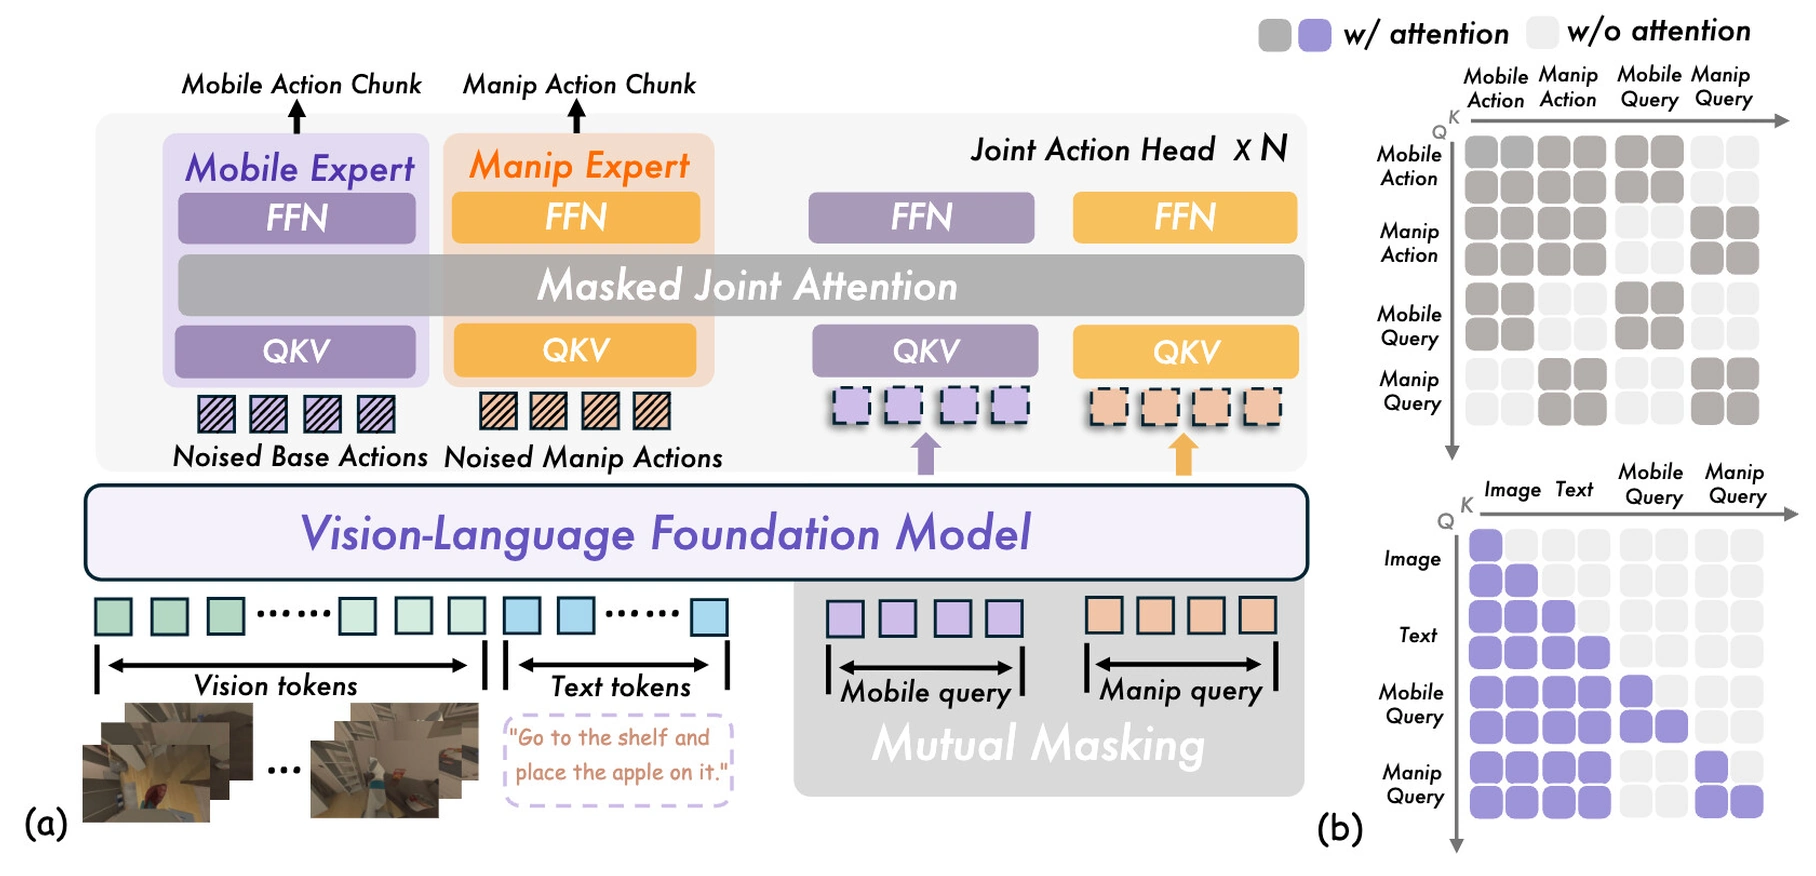
| MoPA | 用 Joint Attention 联合输出移动与操作动作,并引入 query 输入的 VLA。 |
Tricks#
在这里包括一些在训练或者部署上的细节设计,这些设计并不是方法级别的,或者易于迁移到已有的方法上,从而达到不错的效果,可以在后续的模型调优中参考:
| 论文 | 主要贡献 |
|---|---|
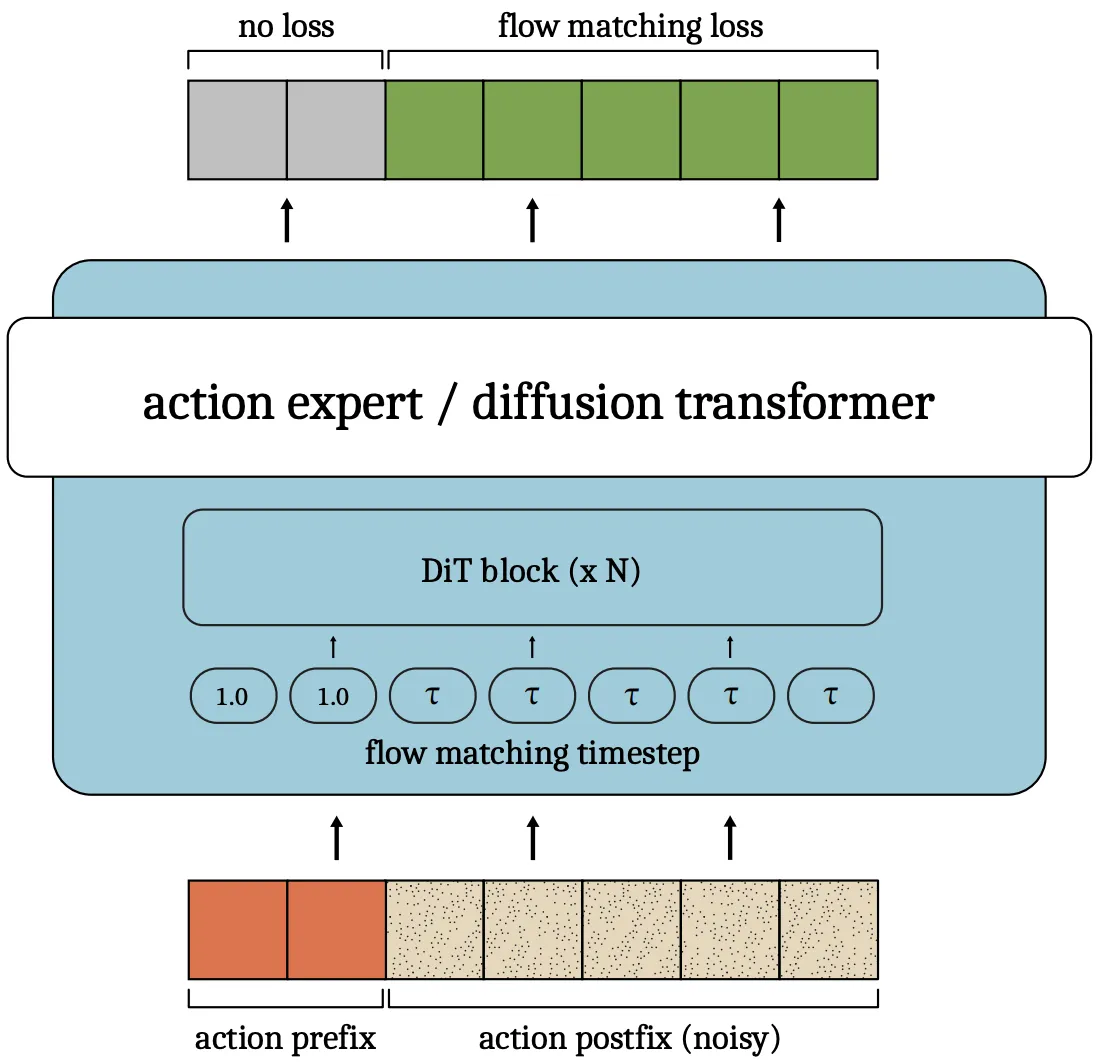
| Training-time RTC | 在 Denoise 前面加一段 Action prefix |
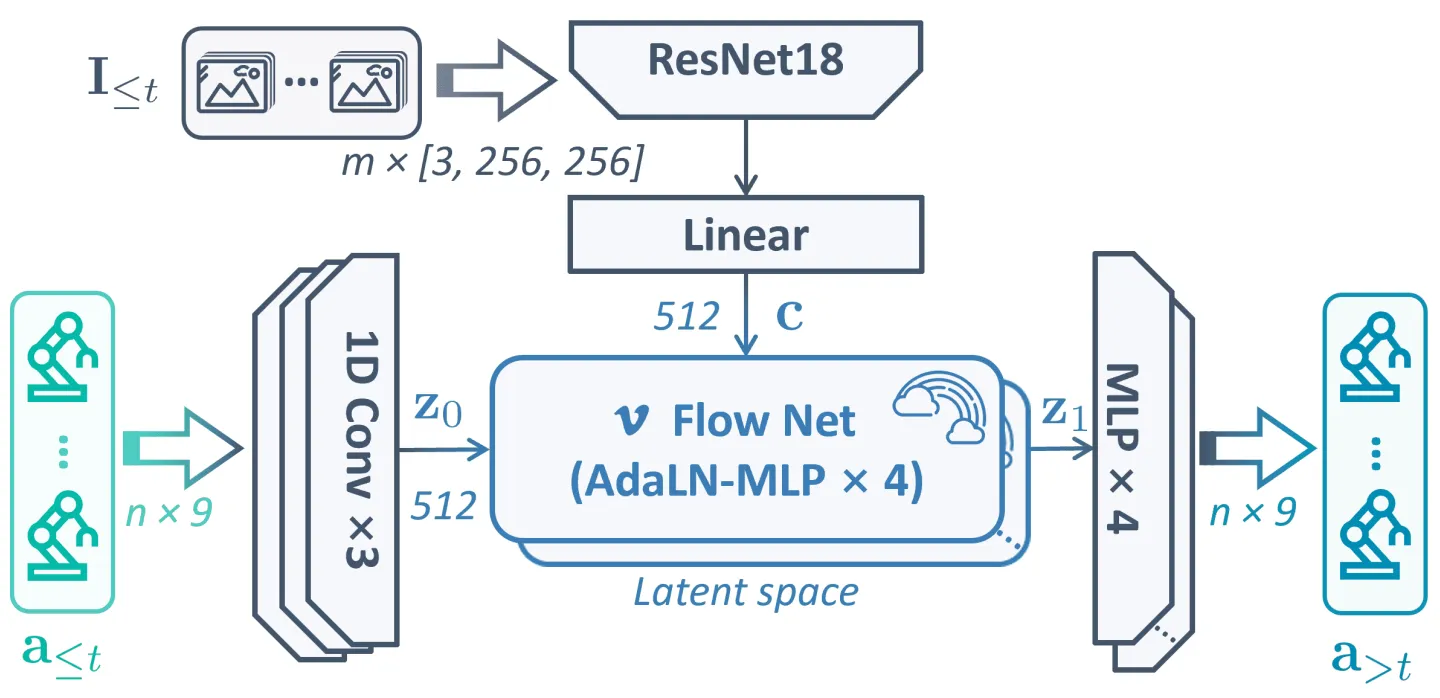
| Action2Action | 对于 Flow Matching 不采样 noise 而是使用之前的 Action |
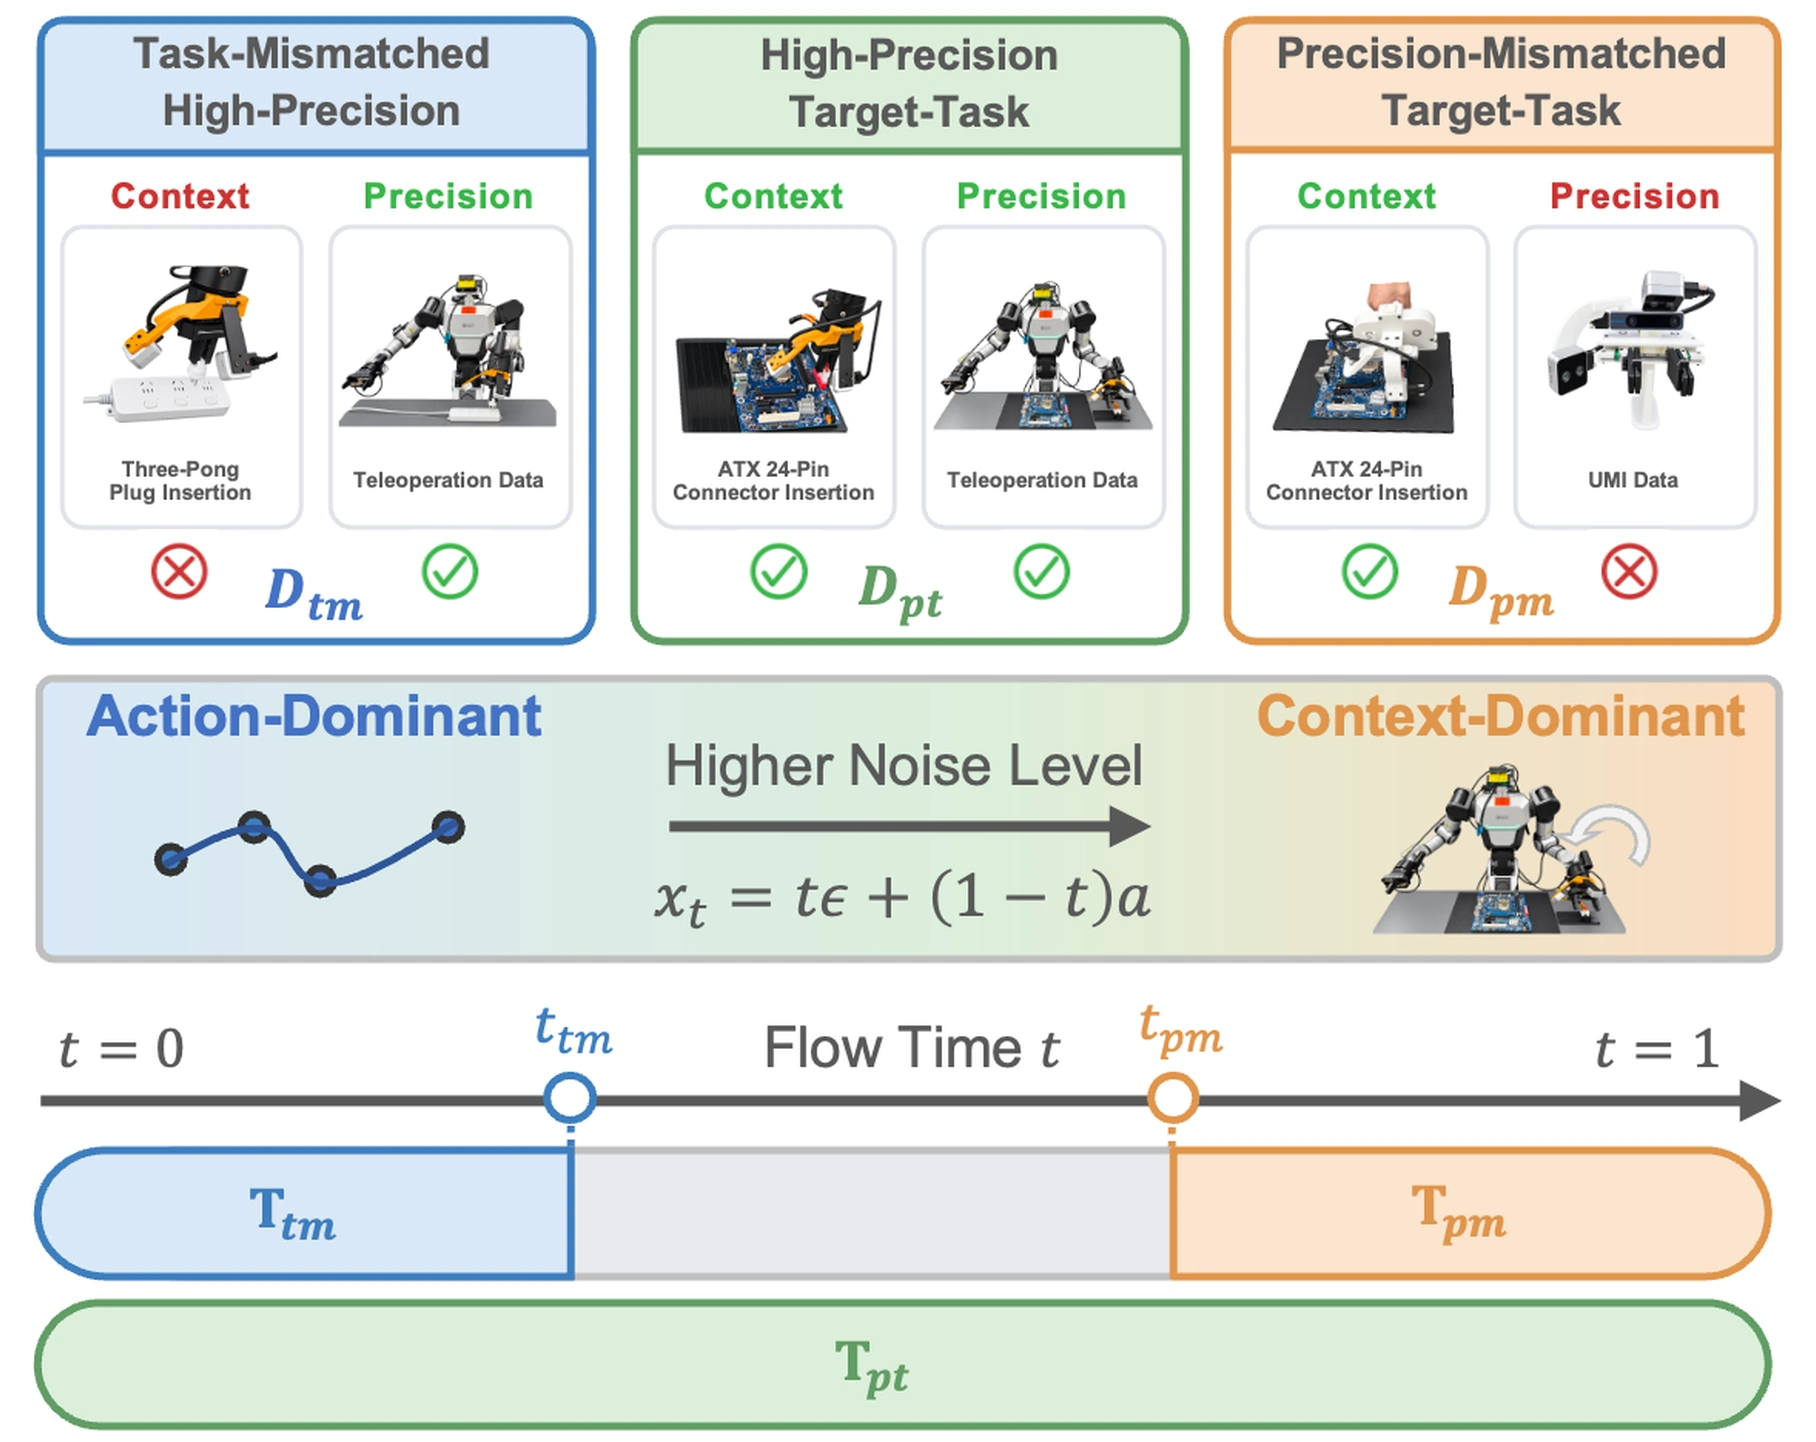
| ε4P | 按 FM 噪声阶段分配数据:高质量目标数据全程用,粗糙但任务匹配的数据用于高噪声,精确的异任务数据用于低噪声。 |
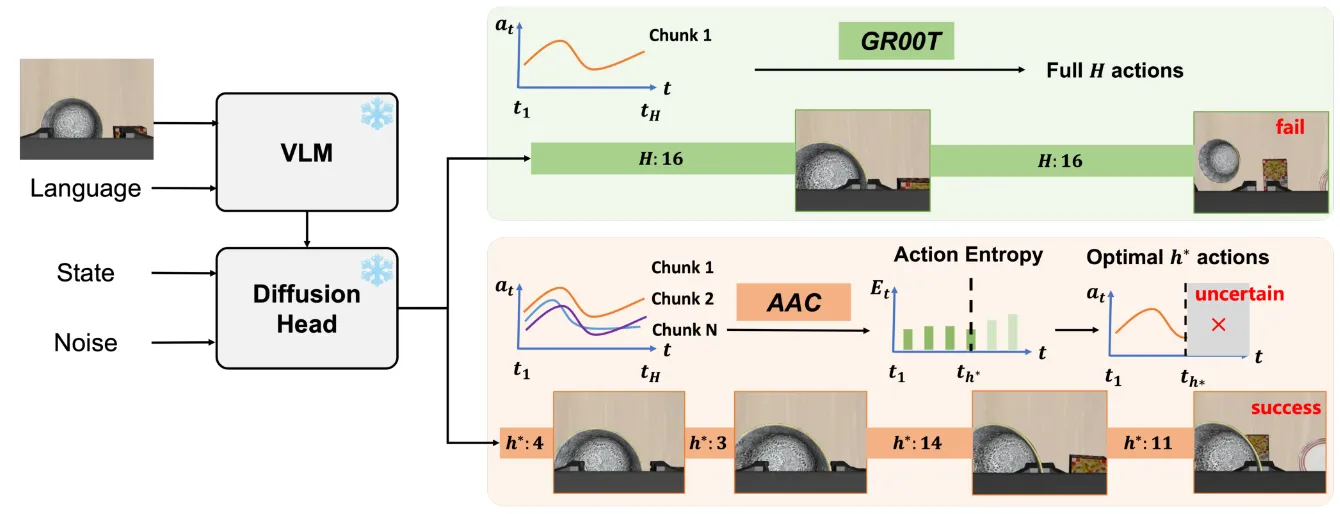
| AAC | 使用动作熵,在推理时动态选择 Action Chunk 大小 |
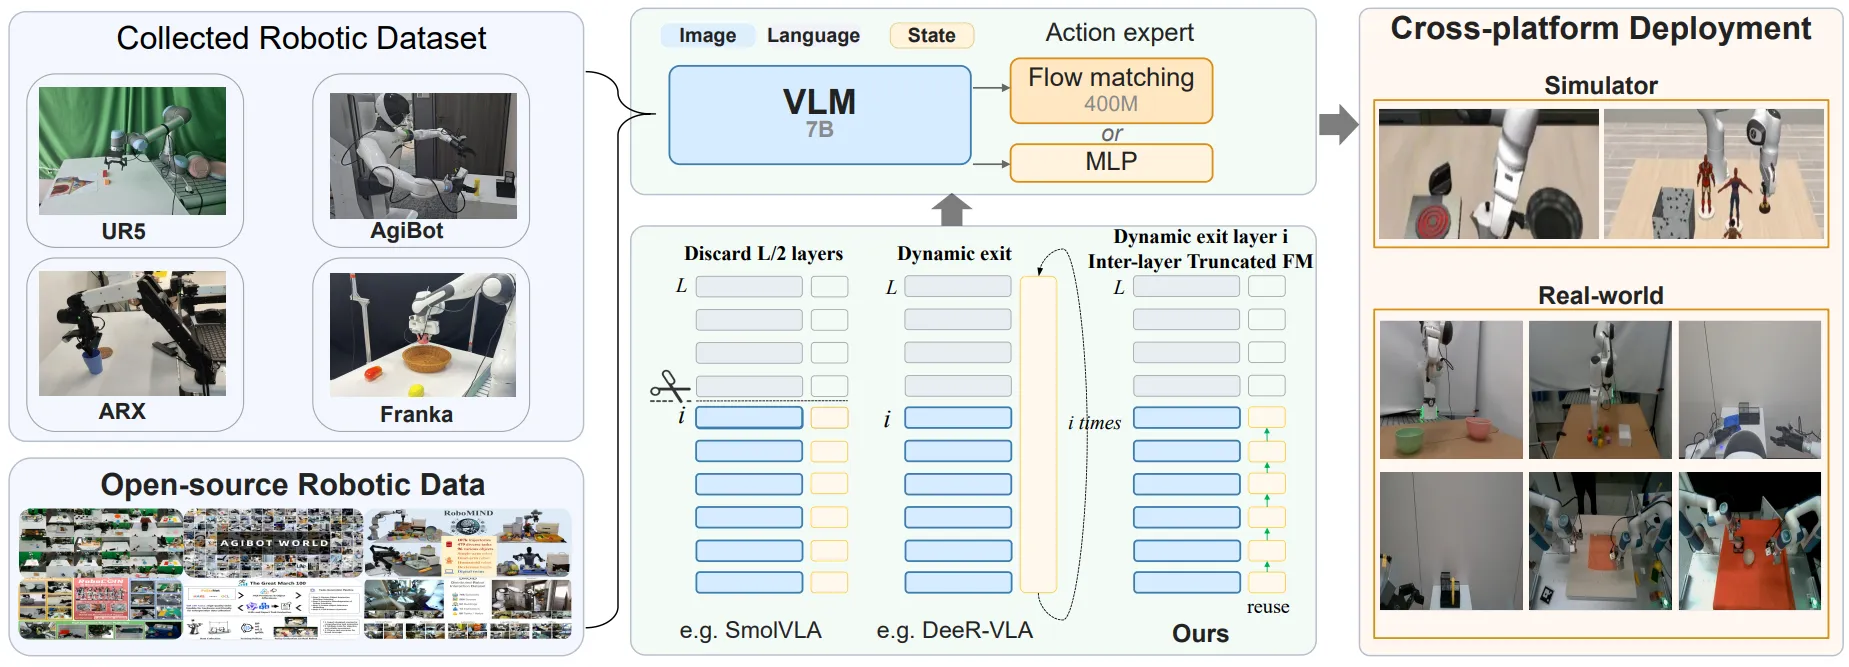
| 自适应的 VLM 和 Actor 早停以加速推理 | |
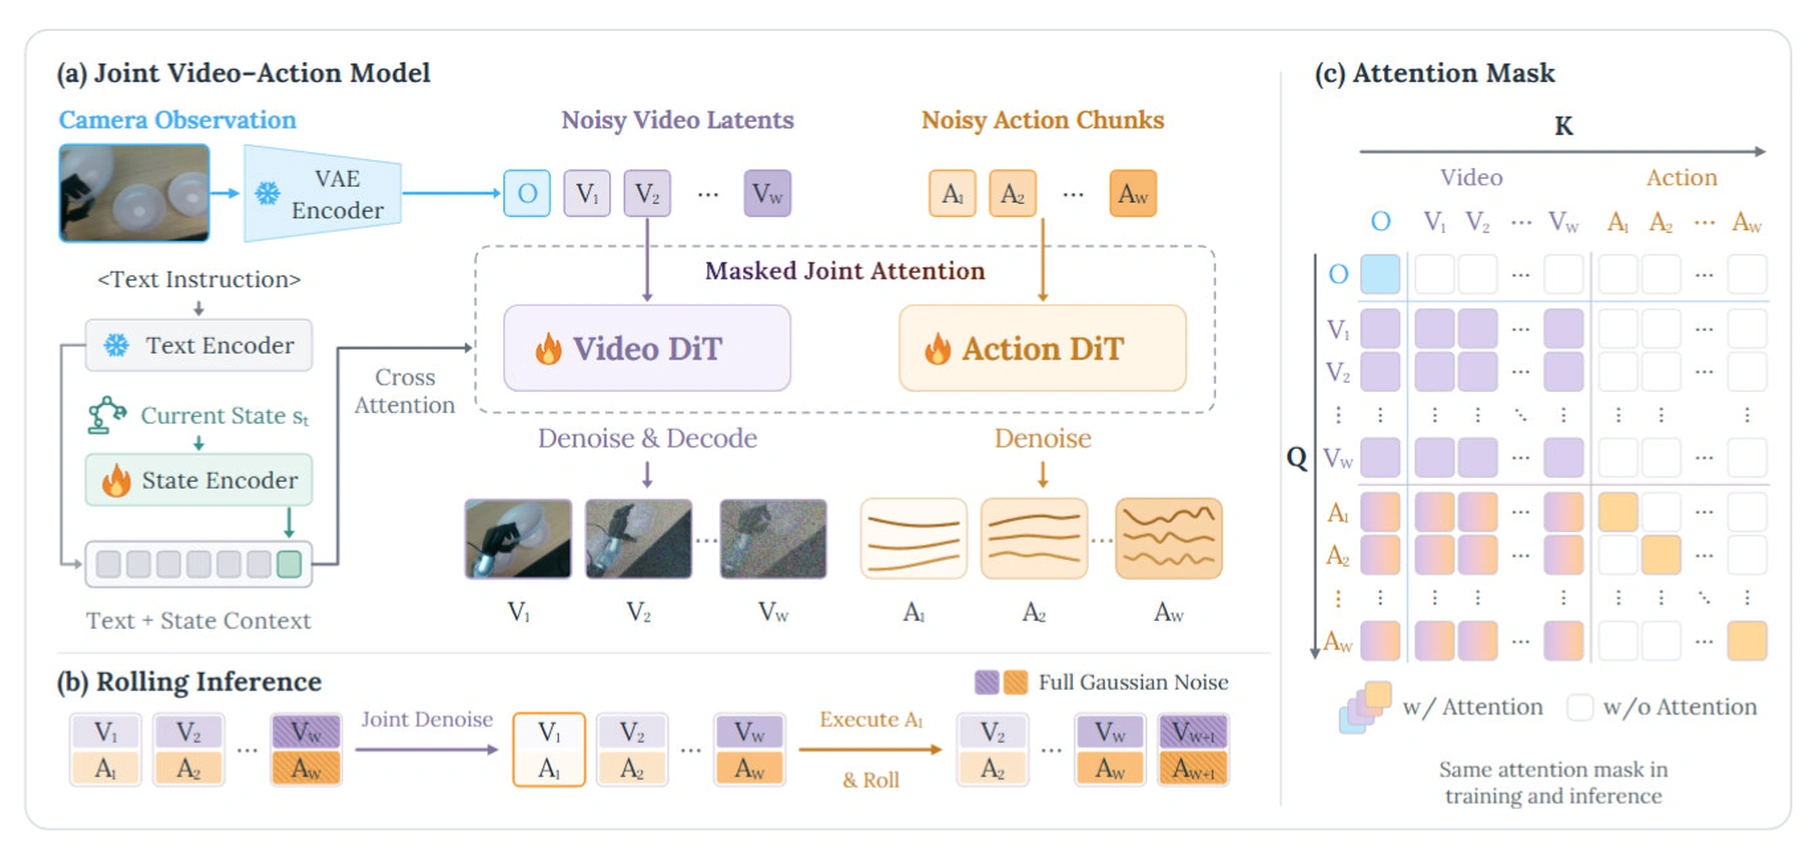
| Rolling-WAM | 滚动维护不同去噪阶段的未来片段,近端动作先完成去噪,远期片段随新观测更新,兼顾 WAM 的反馈与推理开销。 |
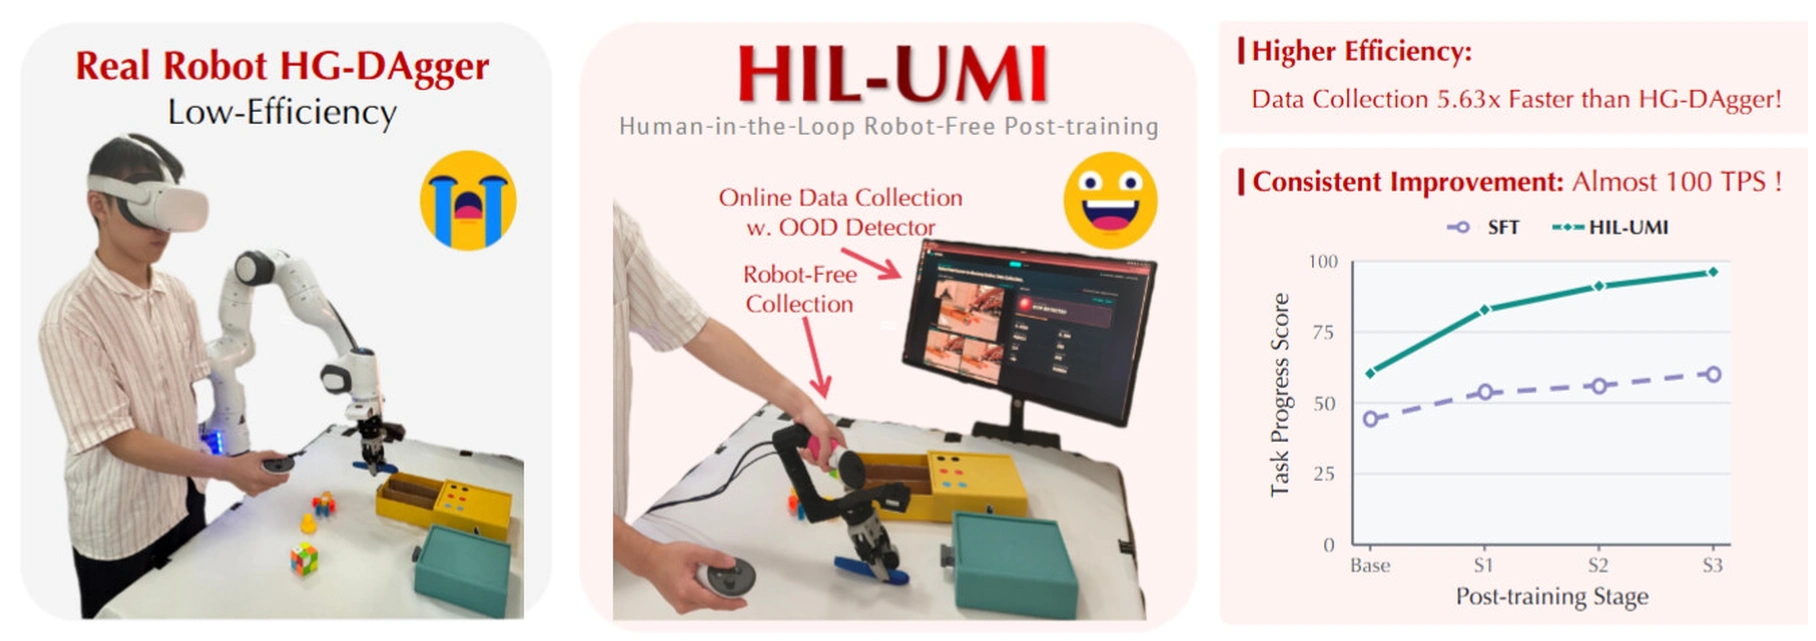
| HIL-UMI | 让人手持 UMI 操作时同步比较模型预测,用 OOD 检测筛选需补充的数据,替代等待机器人出错再接管;人类探索与模型轨迹仍有分布差异。 |
Policy 模型#
站在 VLA 模型的对立面,policy 则是我们对于另外一种模型的名称概括。通常来说,这些模型的参数量较小,具有着某种来自于计算机视觉领域较早时期的风格,它们往往基于一些 Transformer block 以及一定的 encoder 进行设计,并且论文的创新点或许也主要集中在对于模型结构内特征交互的改进。
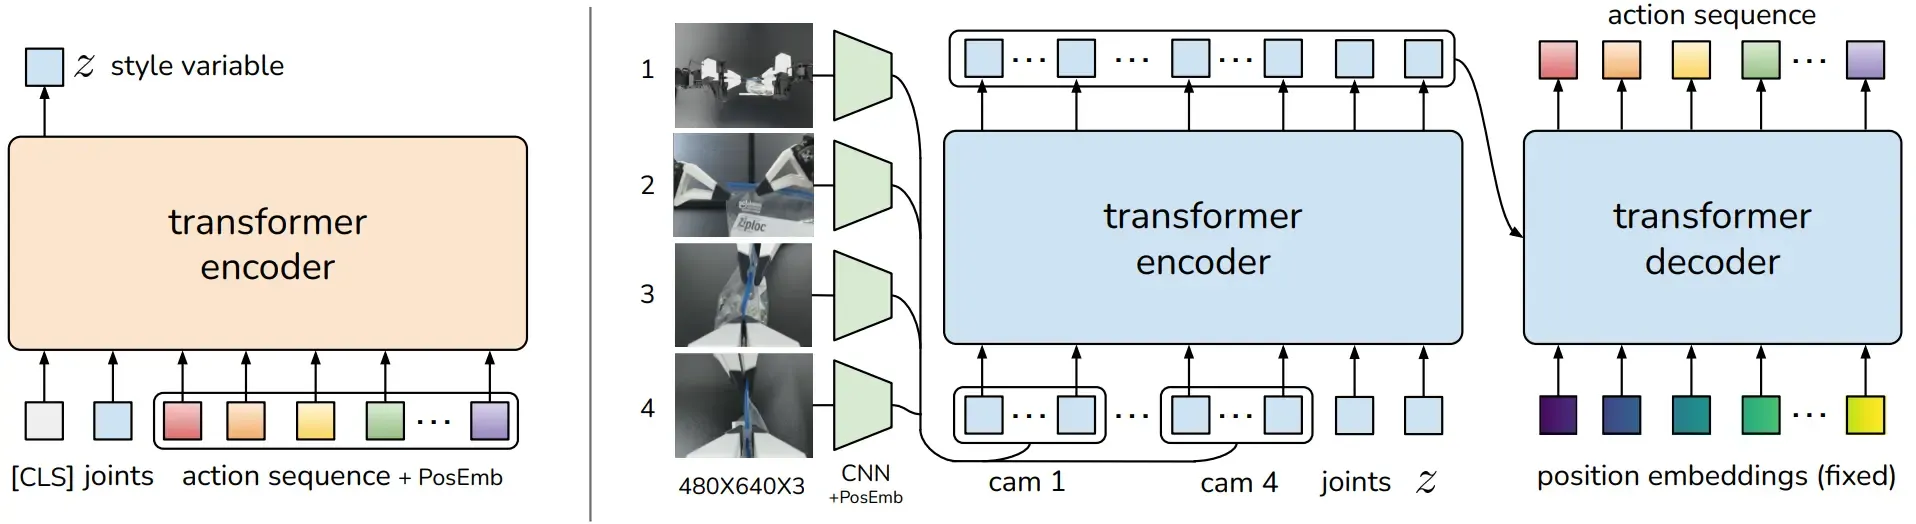
ACT 是最为经典的 Policy 模型,虽然在 23 年提出,但是在如今大量的机器人公司的 Demo 调试中依然被广泛使用,大多数时候因为 Demo 需要鲁棒的过拟合,ACT 的设计显然是非常适合的。本身 ACT 使用了 CVAE 来预测 Action,是一种直接且有效的方案。它一次预测一段动作,也就是 Action Chunking,这一设计之后被 等工作广泛沿用;同时还提出了 Temporal Ensemble,即将预测的 Action 进行 EMA 平滑。
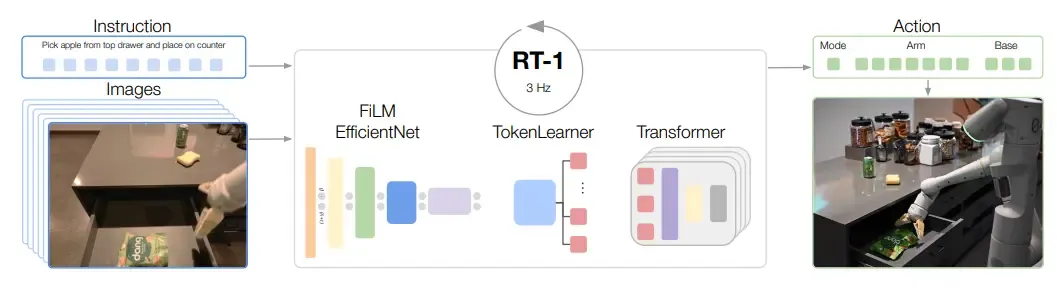
RT-1 是谷歌团队基于他们自己采集的数据集训练的 Policy 模型,即 Robot Transformer,虽然在此之后很快,RT-2 就成为了 VLA 的范式,但是本身这篇论文依然比较经典。
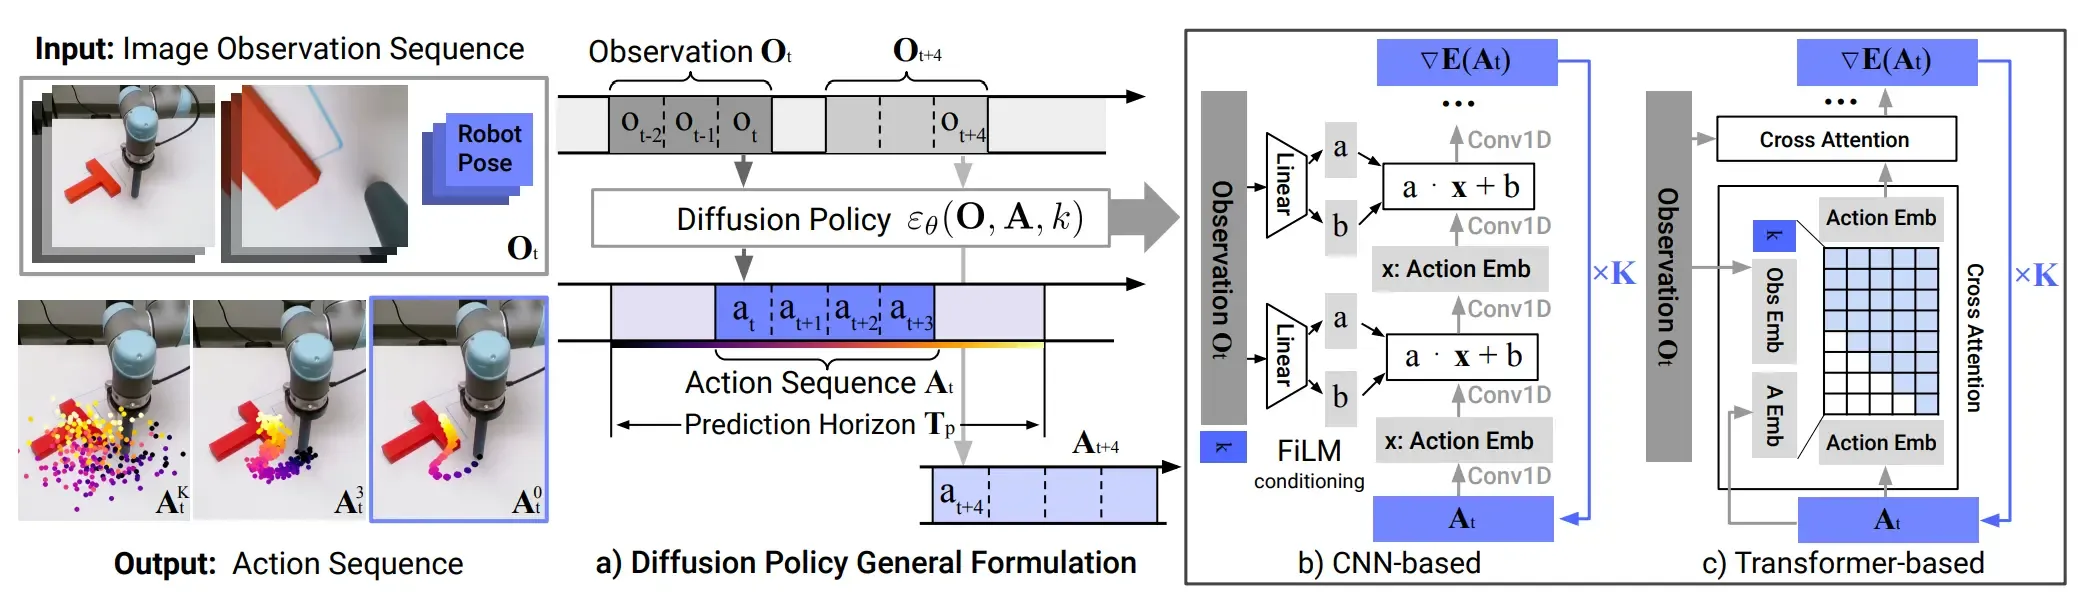
另外比较经典的就是 Diffusion Policy,也就是直接使用 Diffusion 来预测 Action,并且用 Obs 作为 Condition,这一方法在后续得到了大量 Policy 论文的 Follow-up,有必要注意的是 3D Diffusion Policy,其本身输入的内容变为点云,使得在其他工作的应用中,可以通过仿真或者其他无法生成可靠贴图,但是存在可靠点云的数据中进行训练。
另外 Octo 在 Open X-Embodiment 上从头训练了一个通用的 Policy,同样使用 Diffusion Head 输出动作,本身并不基于预训练的 VLM。
Humanoid#
长久以来人形机器人的发展也是一个主线,相较于 Manipulation 的任务,人形机器人的发展方向主要即 Locomotion,难点在于对于人形机器人,如何使用算法使得人形机器人在执行复杂的动作的同时可以保持身体的平衡等。这一领域一方面并非本文重点,一方面前后涉及范围过广,我们在这里仅列举近期的几个有代表性的工作。
其中 BeyondMimic 是最近非常不错的工作,用紧凑的 motion-tracking 先把一堆高动态技能学下来,再用 latent diffusion + classifier guidance 做技能组合和 unseen 任务泛化,支持 motion editing、teleop、避障,零样本部署到真机。
同时,System 0 这一概念也在 VLA 中兴起,即预训练一个可以用于运动控制的基础模型,使得上游 VLA 可以输出正常的机器人动作,由 System 0 来进行具体的运动控制,达到合理的状态。这一方面,NVIDIA 的 SONIC 是具有代表性的突破,通过统一 token space 支持 VR 遥操作、人类视频、VLA 等多种输入,使用了 42M 参数 + 100M 动捕帧进行训练。
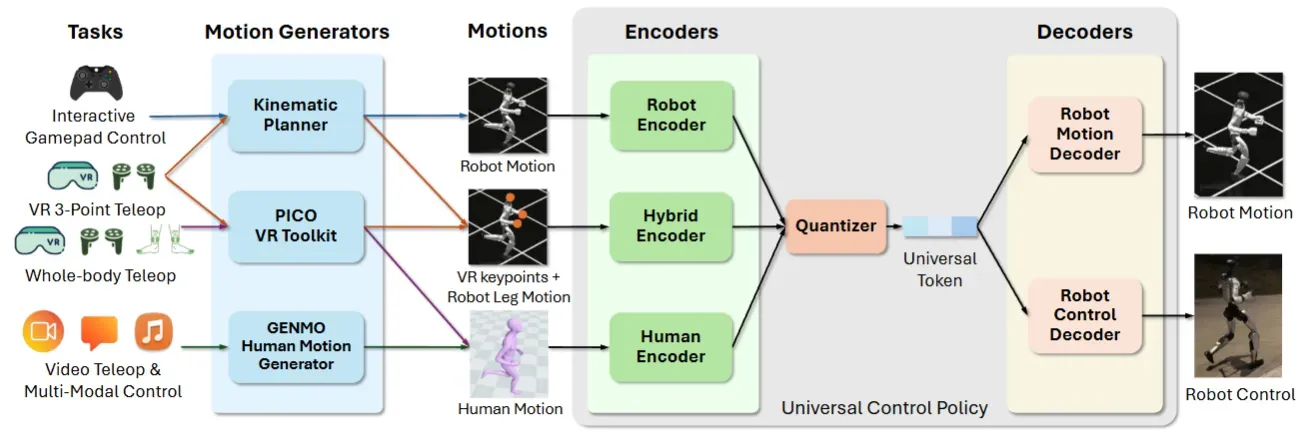
之后 BeyondMimic 一作的新工作 SuperMimic 在线拟合一个可微的 MLP 动力学,在想象的 rollout 上做 BPTT,单卡 H100 训 3 个小时 return 就超过了 128 张 L40 训了 7 天的 SONIC,在当下这个时代相当令人耳目一新。
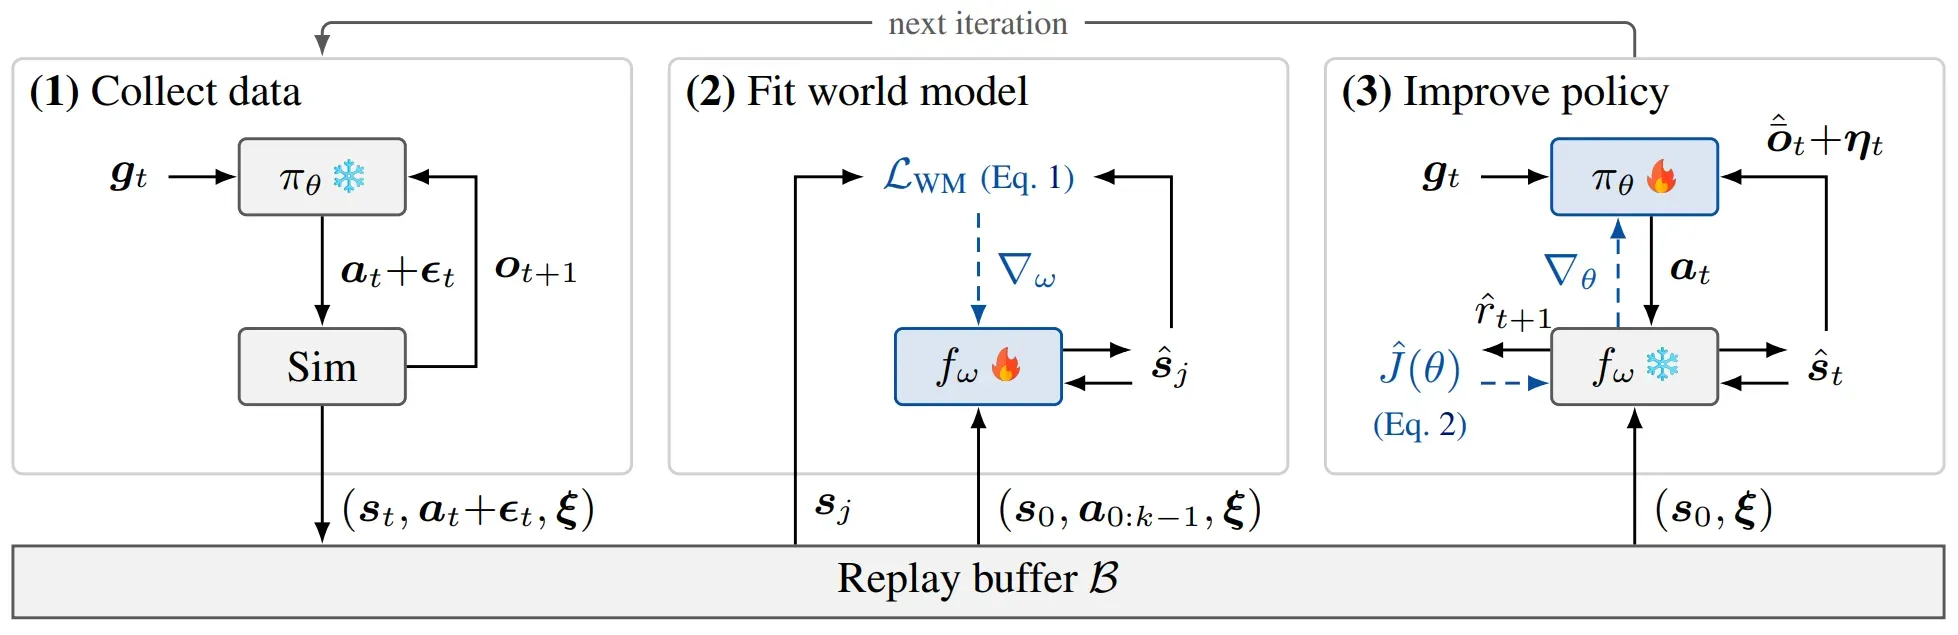
除此之外还有一些 Learning Based 或者间接的方案:
| 论文 | 主要贡献 |
|---|---|
| GigaBrain-WBC-0.5 | 用于全身运动跟踪的行为世界模型,将状态与动作建模结合,关注环境交互下的控制鲁棒性。 |
| Being-M0.7 | BeingBeyond 出品的以 Ego 数据训练,结合 WAM 与 SONIC 实现人形全身控制。 |
| DreamControl-v2 | 基于 retarget 之后的数据集训练 Diffusion 模型生成参考轨迹,之后从轨迹进行 RL sim-to-real |
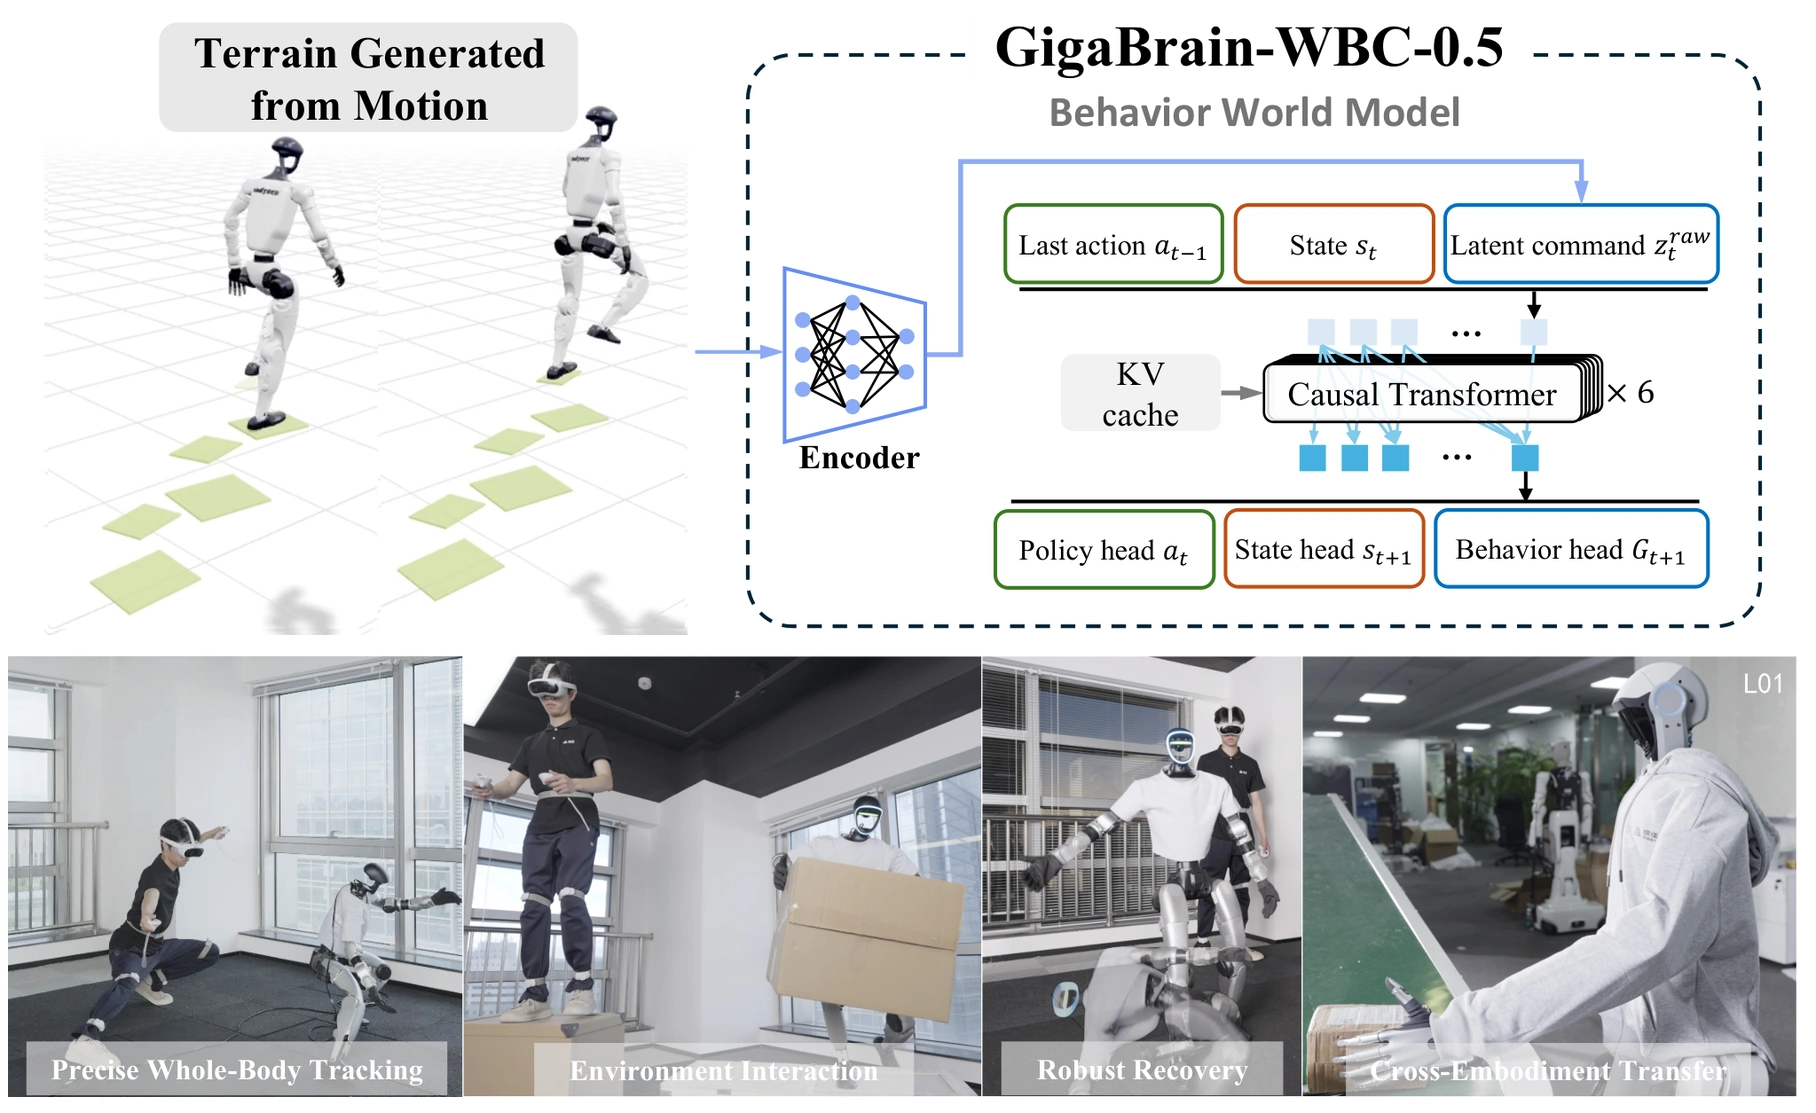
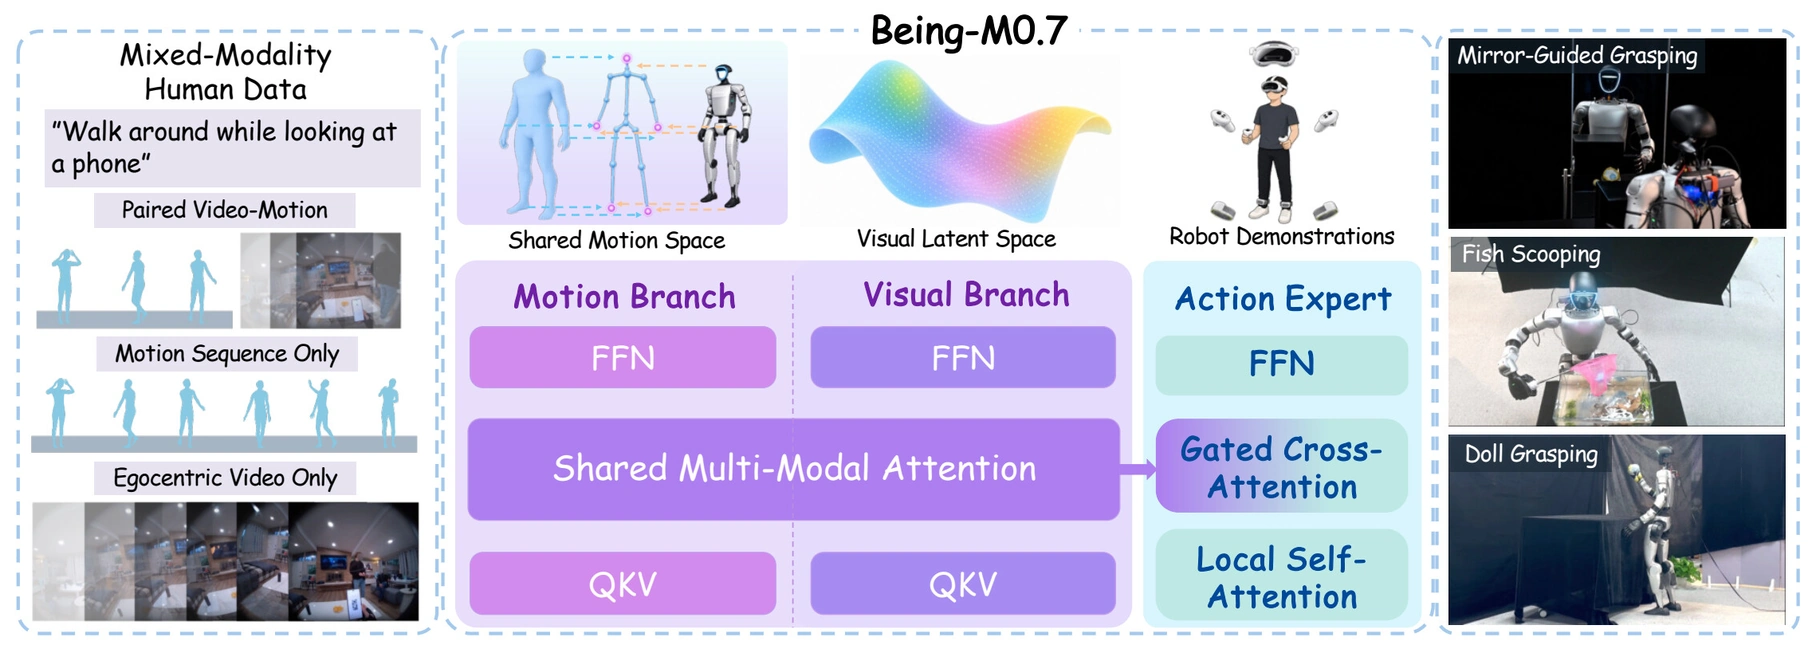
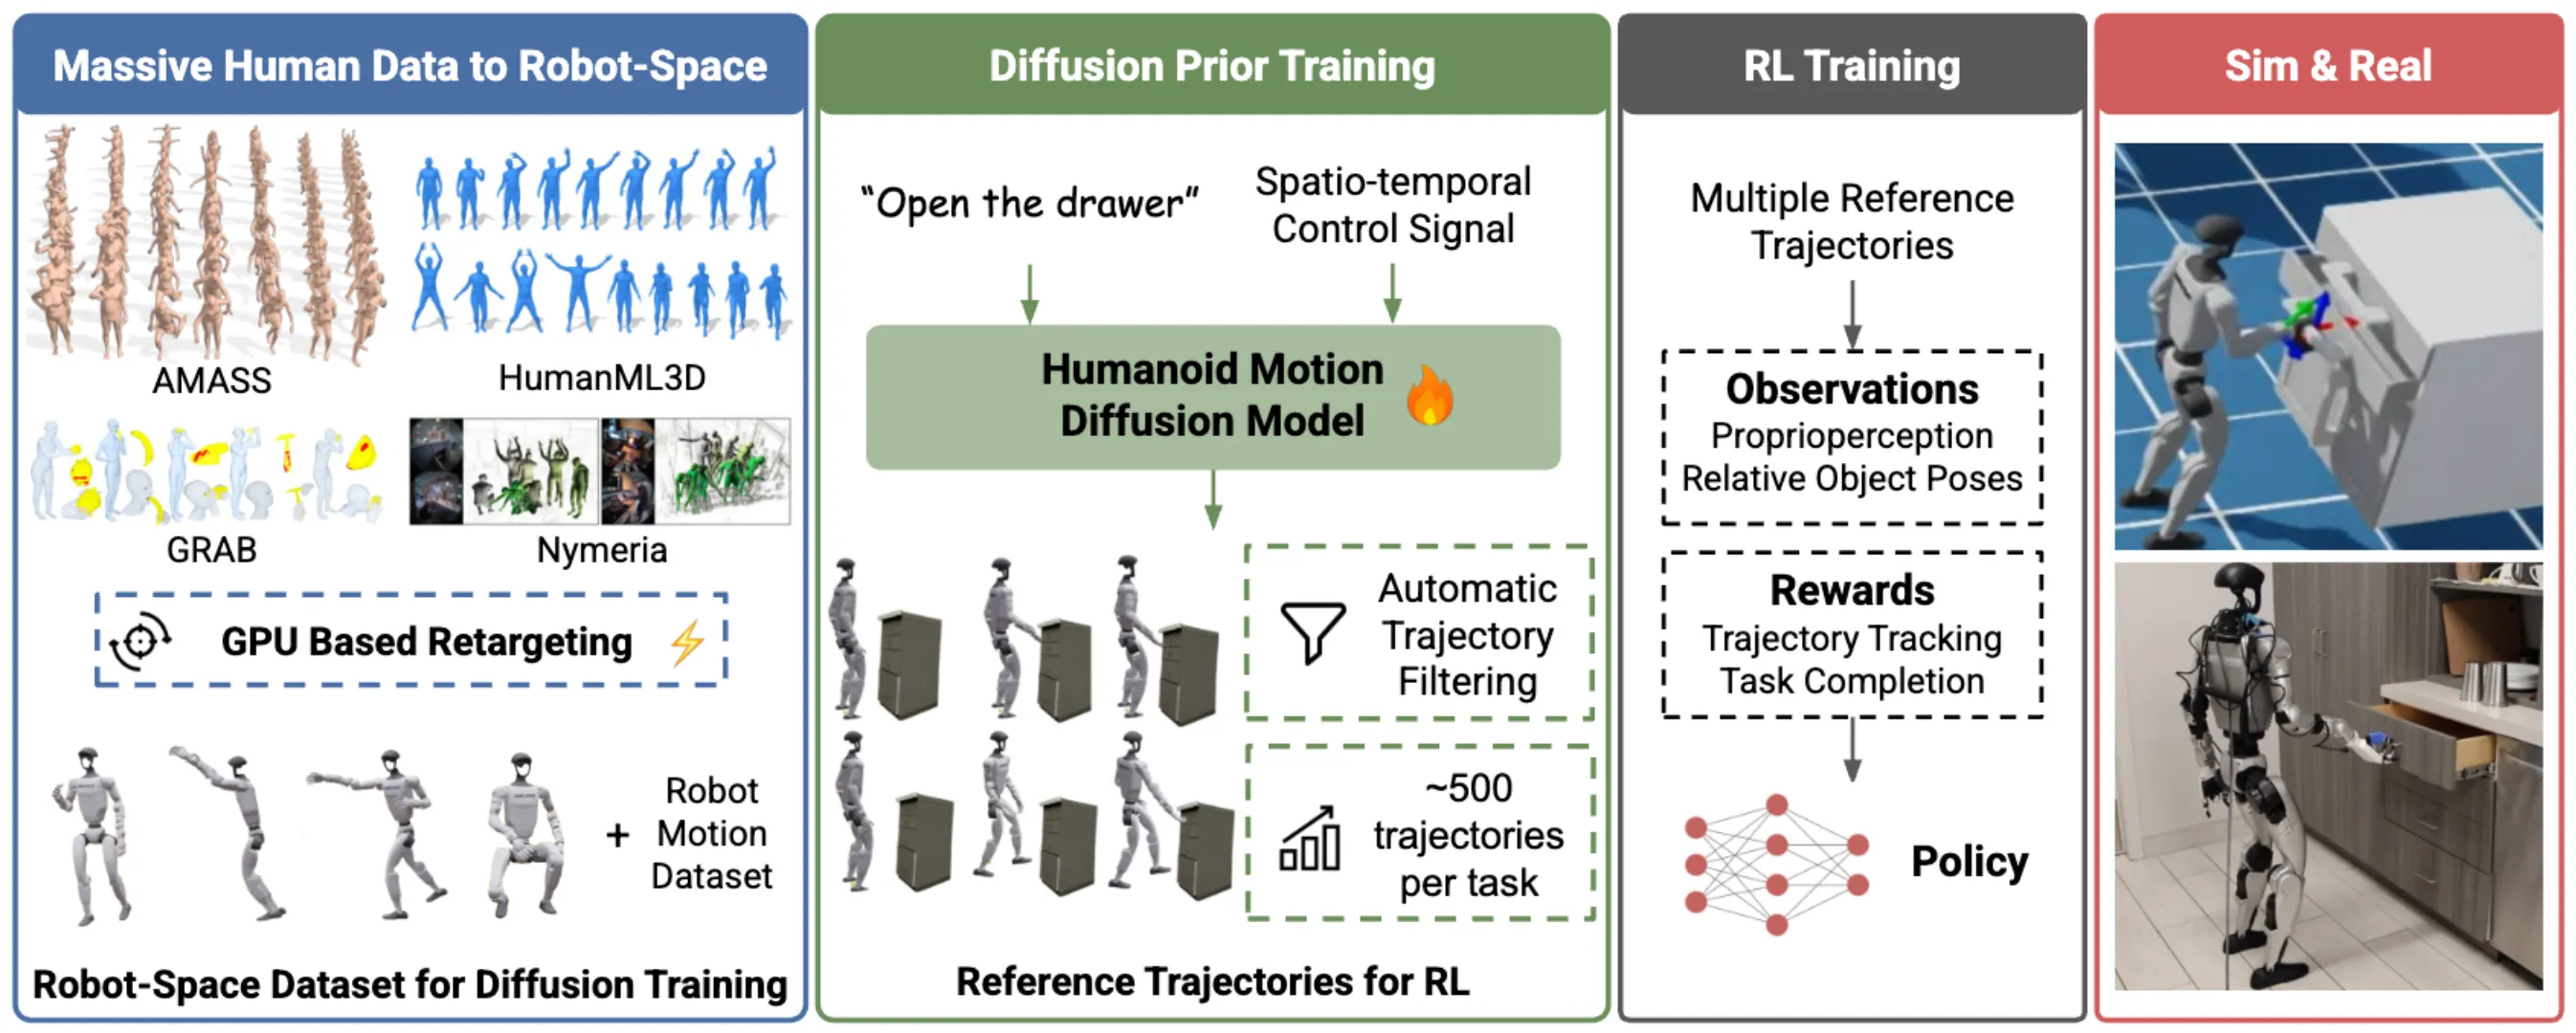
Benchmark#
了解 VLA 的常见测评,也是了解 VLA 发展以及学界和业界目前对于 VLA 期望的一个途径,在这里列举常见的 Benchmark 以及各自的侧重点:
| 论文 | 主要贡献 |
|---|---|
| LIBERO | 基于 Mujoco,因为数据集分布,难度有限,包含部分动作组合的任务 |
| Simpler-Env | 基于 Sapien,复刻 OXE 部分场景,数据集为 Real Data,良好的 Sim 调校并且大量实验验证 Sim-Real 一致性 |
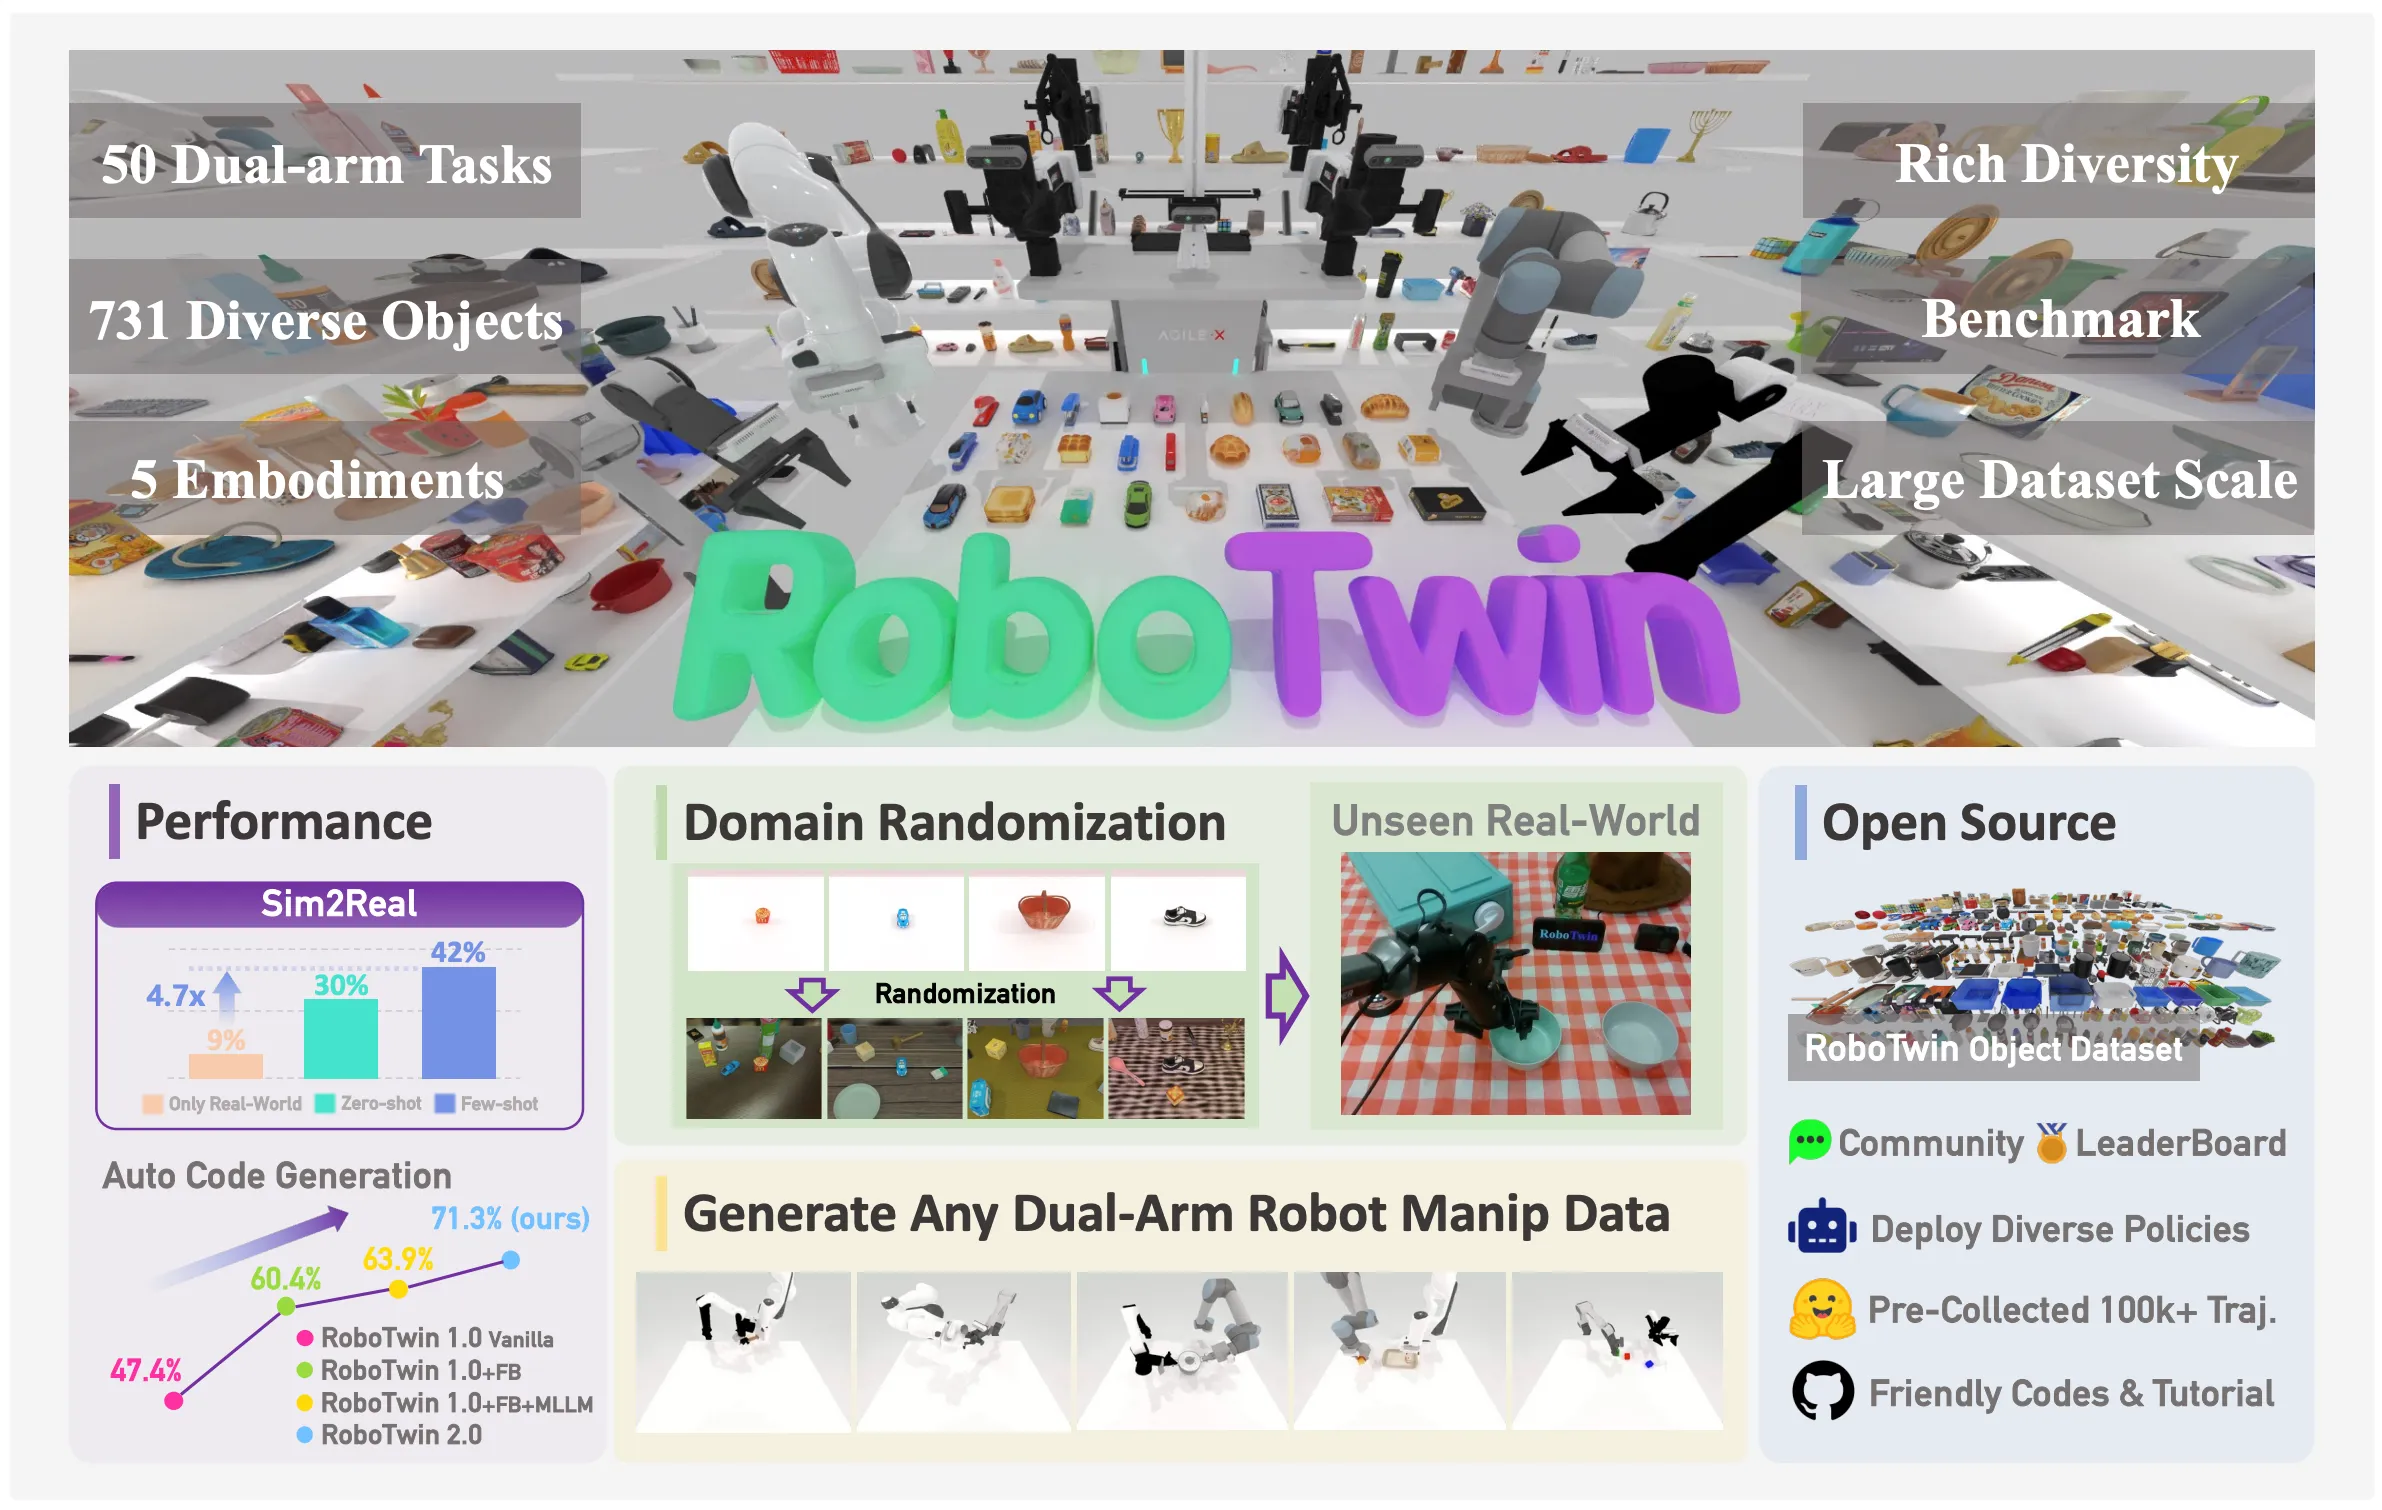
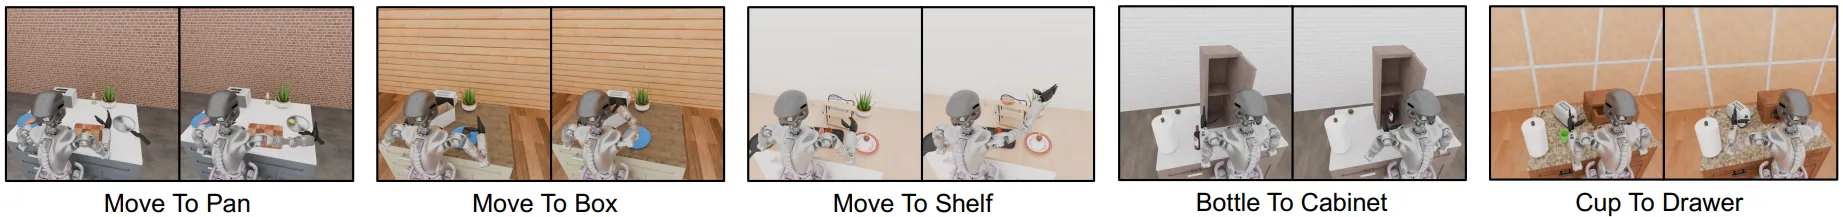
| RoboTwin 2.0 | 基于 Sapien 搭建的双臂操作测评,包括 In Domain 以及 Randomized 的 OOD,现在通常使用 All 或者 Clean2Rand 的两种测评方案 |
| LIBERO-Plus | 加入物体布局、相机视角、机器人初始状态、语言指令、光照条件、背景纹理以及传感器噪声等维度扰动的 LIBERO |
| RoboCasa-GR1 | 基于 RoboSuite 的人形上半身桌面操作 Benchmark,Nvidia 随 GR00t 一同出品 |
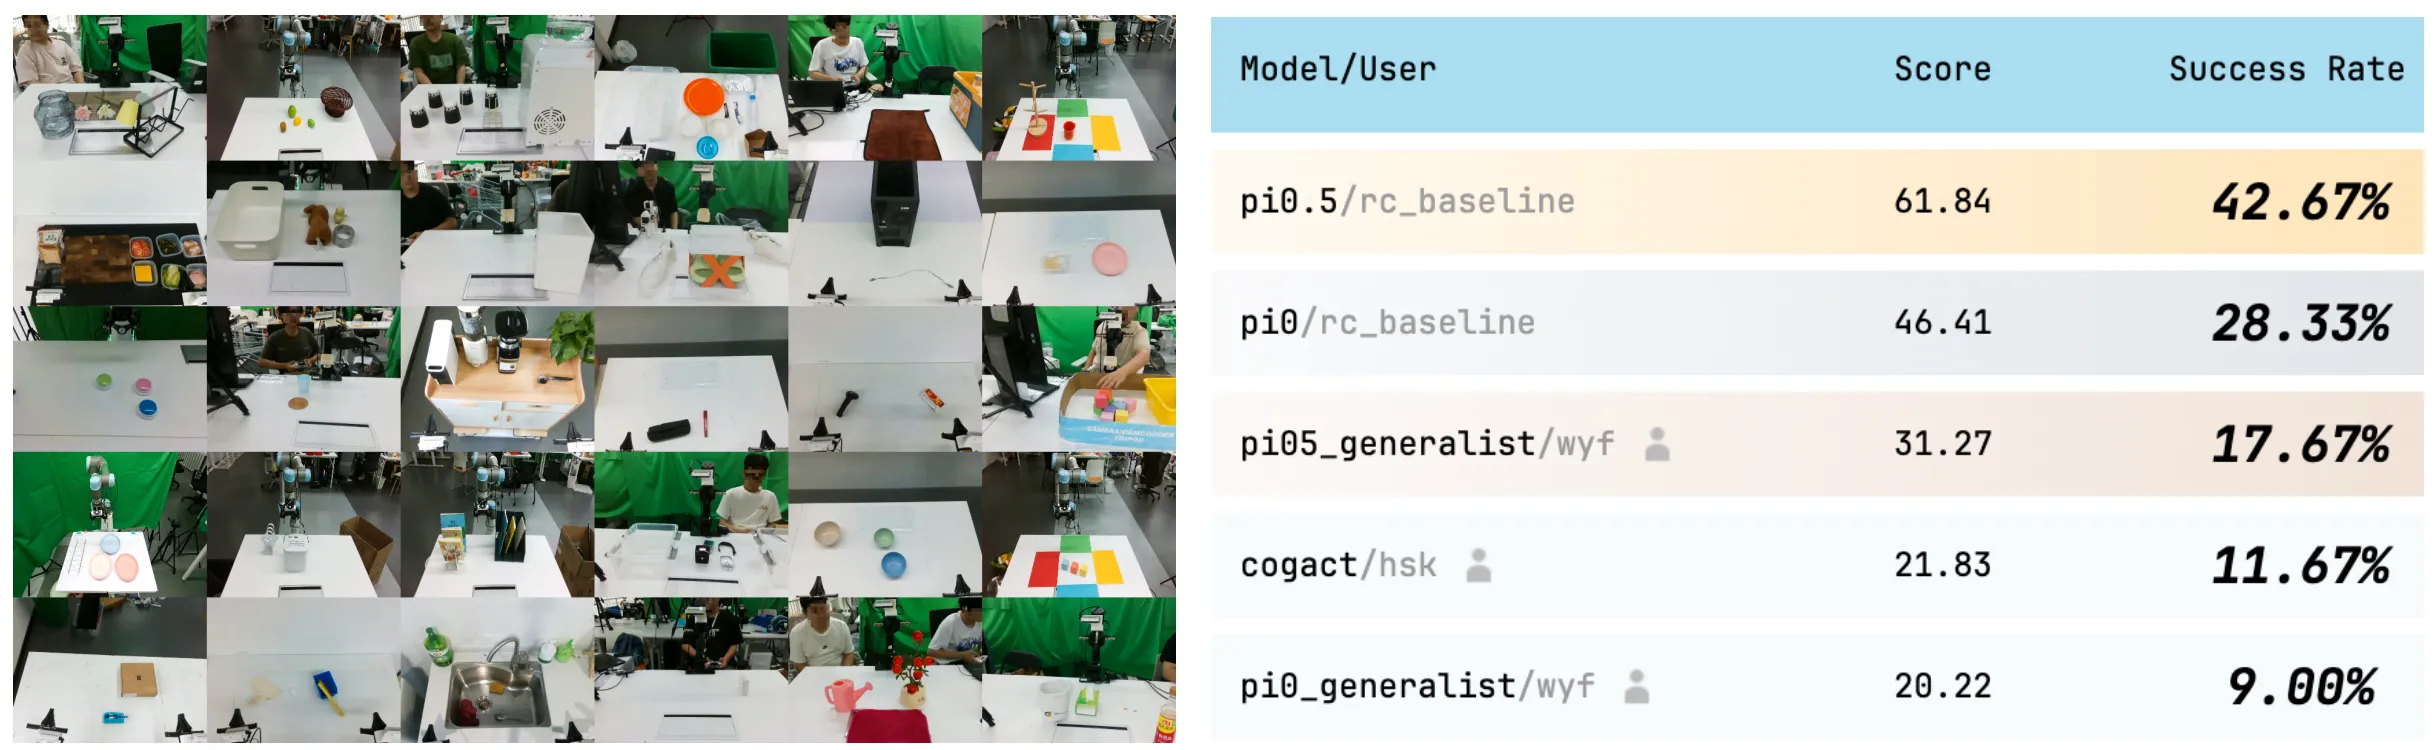
| RoboChallenge | Real World Benchmark,使用四种不同的本体,不同的任务,随机化有限 |
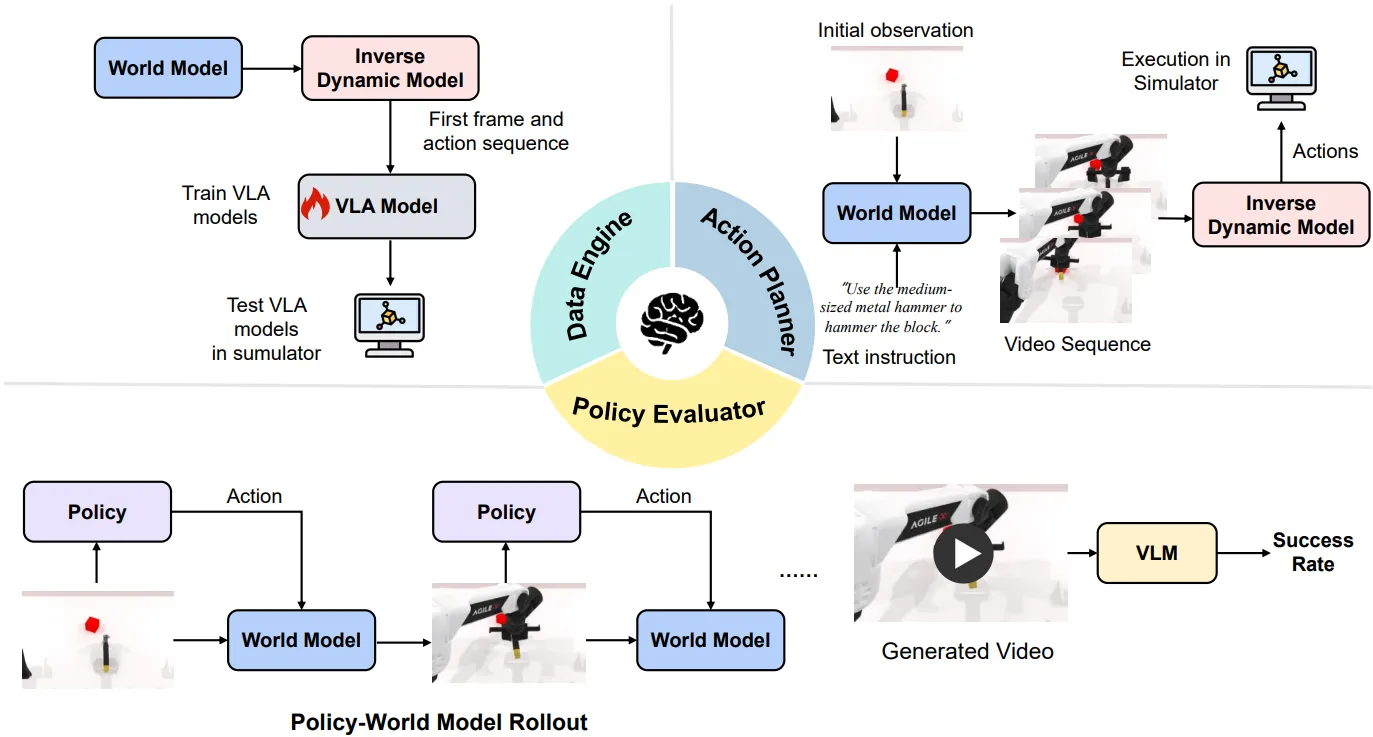
| WorldArena | 在具身场景下对于 World Model 的测试,以及包括作为 Data Engine 以及 Simulator 等能力的测试 |
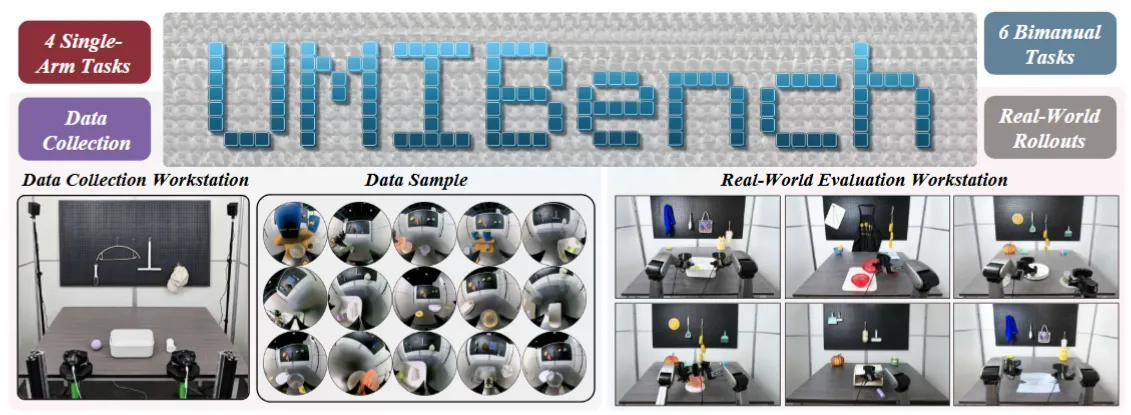
| UMI-Bench 1.0 | 在 UMI 数据上训练的真机 Benchmark |
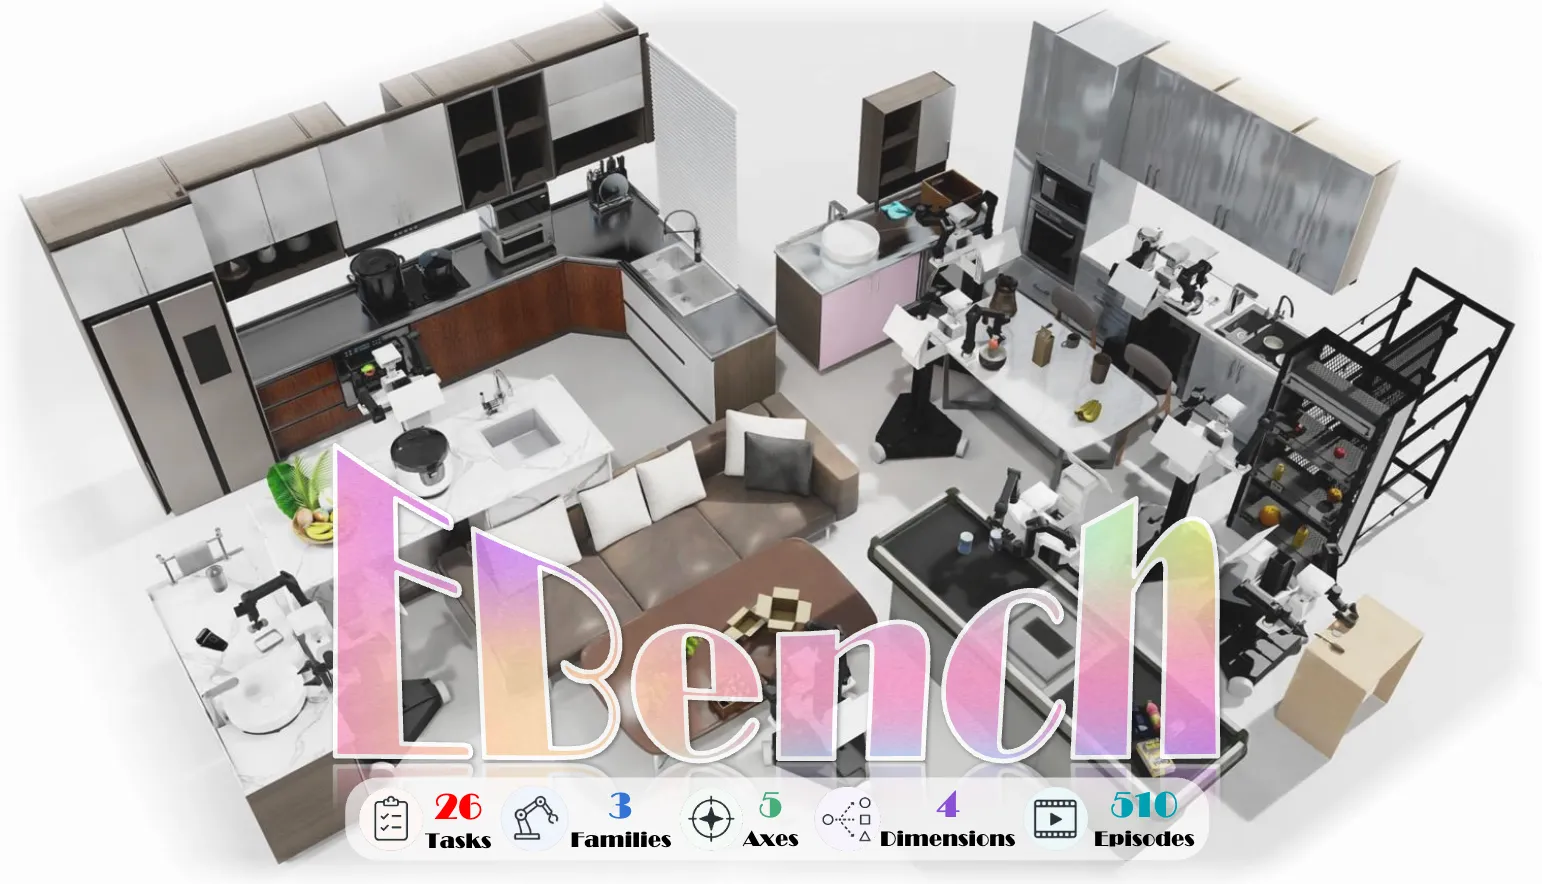
| EBench | 高保真度、支持 Long Horizon / Mobile Manipulation / dexterous 以及多维度分析的 Isaac Sim Benchmark |
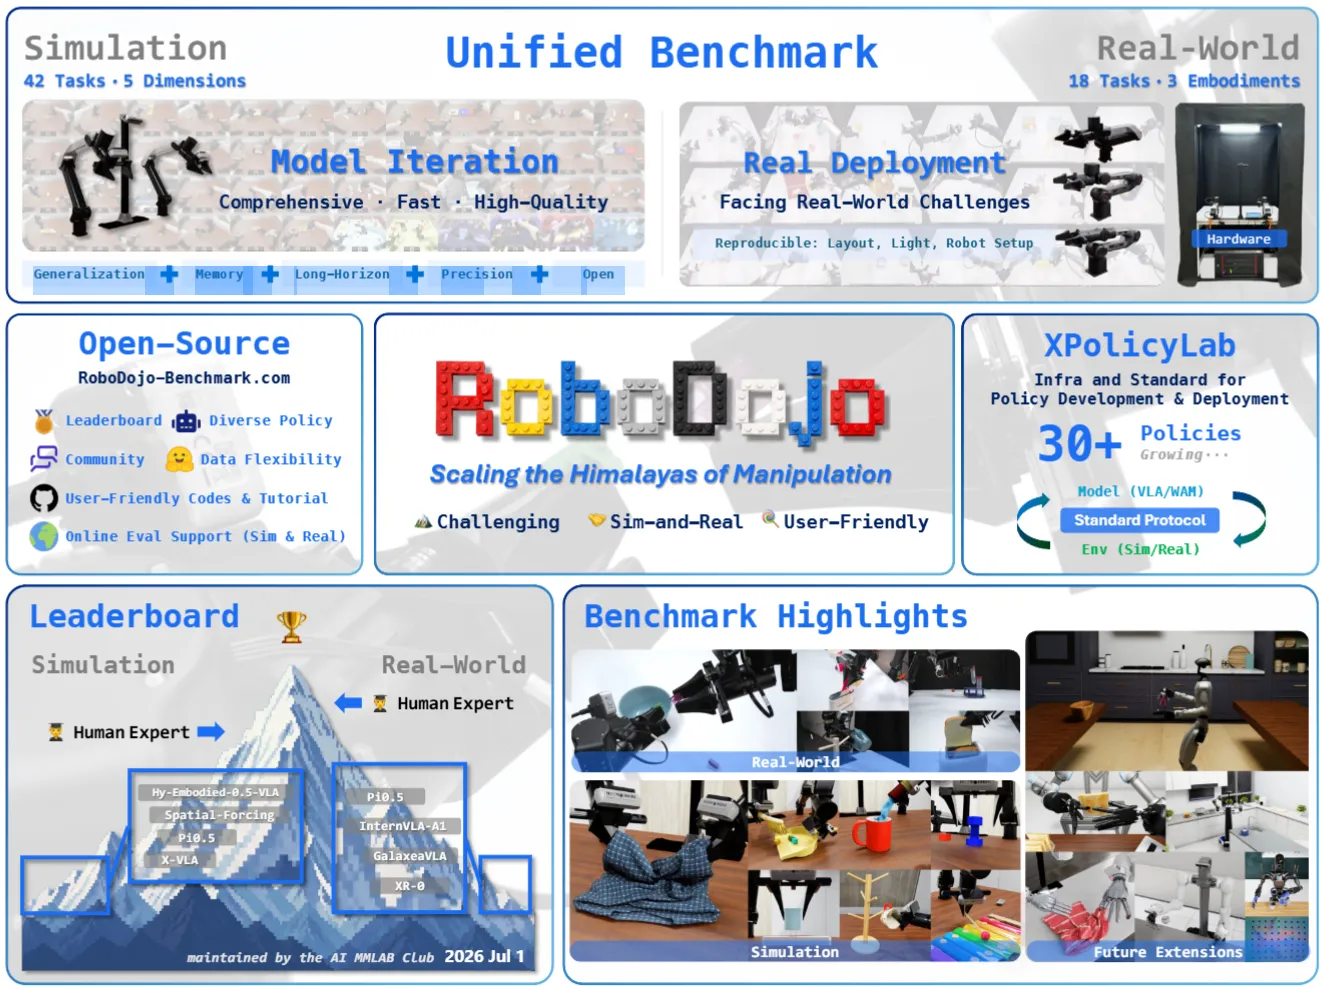
| RoboDojo | Generalization / Memory / Long-Horizon / Precision / 开放指令的 Isaac Sim Benchmark |
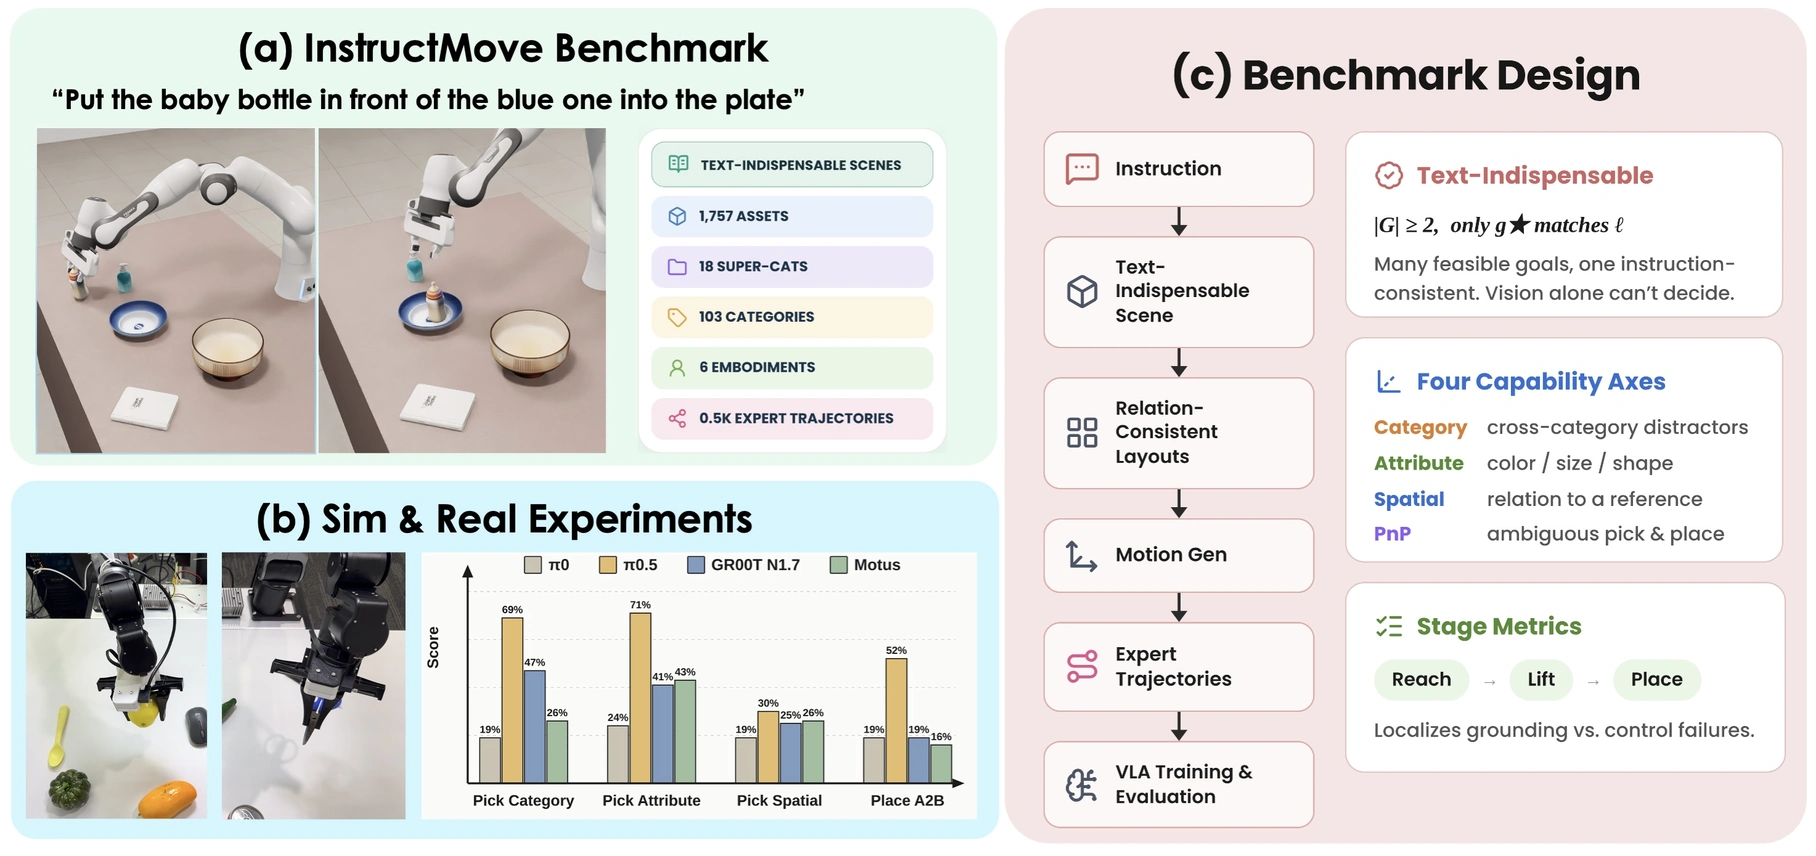
| InstructMove | 强调语言不可被视觉替代的指令跟随测评,围绕空间指代与操作要求测试模型是否真的使用了指令。 |
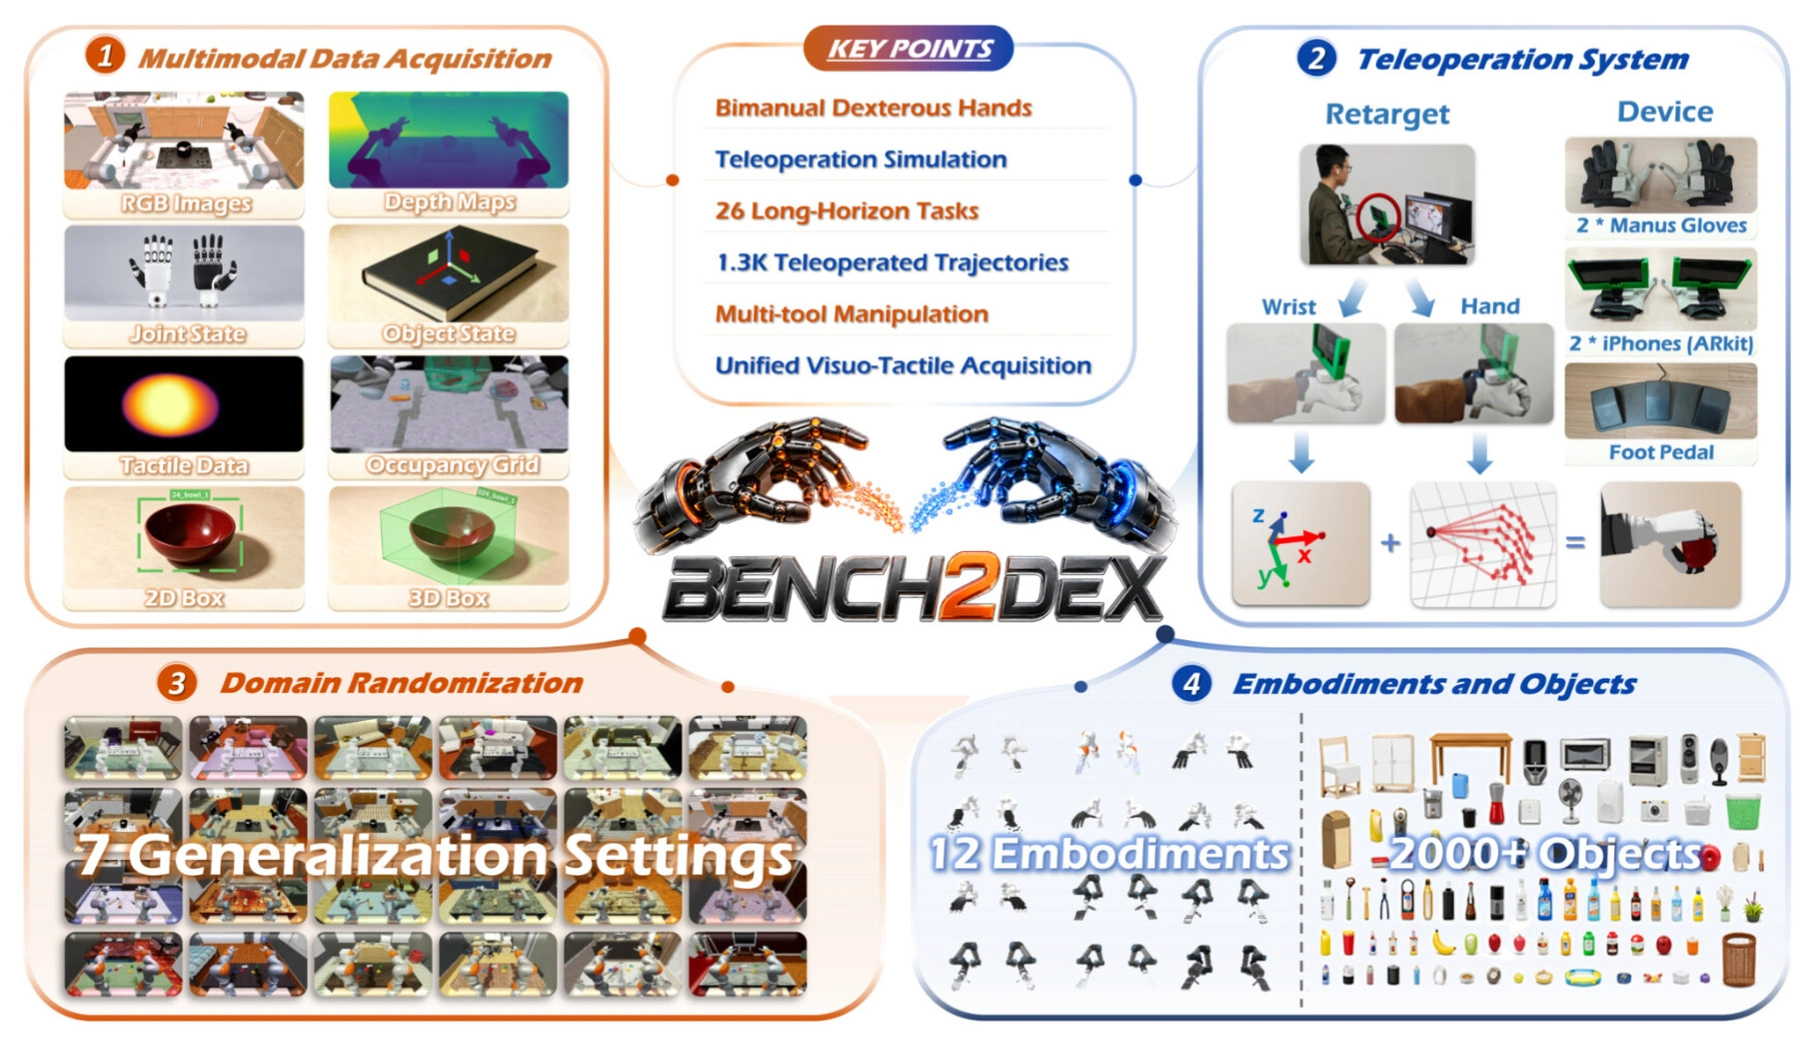
| Bench2Dex | 面向双臂灵巧手长程操作的多本体测评,覆盖不同机械臂与灵巧手组合,遥操作数据包含力与触觉输入。 |

数据采集#
伴随着 VLA 的发展以及对于 Scaling 的需求,业界以及学界开始探索如何更好地 Leverage 异构的数据,如 Ego / UMI Data 等,一些改进通过 Training recipe 的调整,如更加 well-design 的课程学习完成,另外一些则通过如修改数据清洗流程或数据采集硬件展开,即从源头和末端解决异构数据混合训练的问题。
机器人数据集#
在这里汇聚一些常见的机器人数据集。
| 数据集 | 主要内容 | 数据入口 |
|---|---|---|
| Open X-Embodiment | 多机构整合的跨本体机器人数据,提供统一的 RLDS 接口 | 官方仓库 |
| DROID | 76k 条、350 小时、564 个场景;多视角图像、语言及状态动作 | 数据 |
| BridgeData V2 | 约 60k 条 WidowX 轨迹、24 个环境,含语言标注与多技能示范 | 数据 |
| RH20T | 110k 余条多本体示范,含 RGB-D、力觉、音频及人类示范配对 | 数据 |
| ABC-130K | 约 13 万条、3,500 余小时 YAM 双臂数据,部分带子任务标注 | 数据 |
| AgiBot World Beta | 约 100 万条、2,976 小时双臂数据,覆盖多场景、夹爪与灵巧手 | 数据 |
| RoboMIND 2.0 | 六类本体的 31 万条真机轨迹,包含双臂、移动操作与触觉子集 | 数据 |
| RoboCOIN | 15 类机器人、421 项双臂任务、18 万余条示范,带分层语言标注 | 数据 |
| MolmoAct2-BimanualYAM | 合并训练集约 3.2 万条、704 小时,含三视角 RGB、状态动作与语言 | 数据 |
| Galaxea Open-World | 11 处真实场地的 500 余小时移动双臂数据,带中英子任务标注 | 数据 |
| SharpaDex v1.0 | 约 2.9 万条、300 小时双臂灵巧手数据,含指尖力触觉与分段语言 | 数据 |
| ActionNet | 傅利叶 GR1、GR2 的约 3 万条灵巧操作轨迹,含 RGB-D 与语言 | 数据 |
| OpenNeoData | N0-Foundation 的约 5k 小时视触觉开放子集,混合真机与 TacUMI | 申请访问 |
| EgoSteer-RealWorld | RealMan 双臂灵巧手的约 5.4 万条、192 小时数据,含 RGB-D 与控制目标 | 数据 |
| RoboSet | 约 10 万条真实轨迹,混合遥操作、拖动示教与自主采集 | 数据 |
| FMB | 约 22.6k 段抓取、重定位与插入示范,含 RGB-D 和末端力矩 | 数据 |
| Open-H-Embodiment | 公开训练集约 750 小时、12 万条医疗机器人视频与运动学轨迹 | 数据 |
UMI#
UMI,即 Universal Manipulation Interface,是指使用一种特殊夹爪,通过鱼眼相机以及 IMU 做 SLAM 得到末端位姿来决定动作,一方面可以替换不同本体,在跨本体时迁移,一方面可以使得人类手持 UMI 也可以参加数据,即进一步加快数据飞轮。
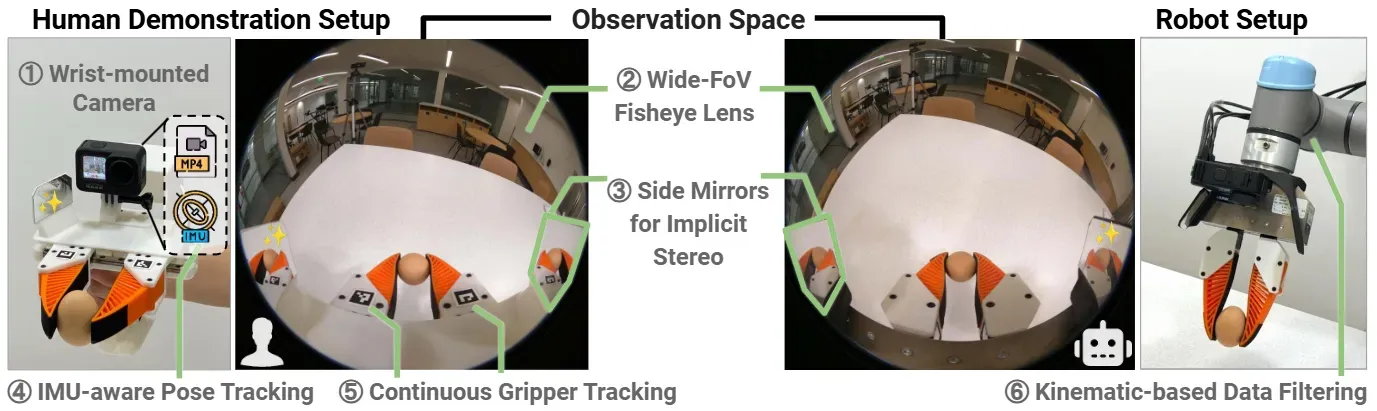
在 系列工作彻底将真机 Scaling Law 的故事发扬光大之后,后续 Generalist 的 Gen-0, Gen-1 以及 Gen-1.5 则将 UMI 发扬光大。通过 Scaling UMI 数据到数十万小时,构建分布式采集数据的管线并且持续供给预训练,使得模型可以在一定程度上泛化,并且涌现一些诸如 ICL 的能力,相关预训练的 Loss 本身也符合幂律。在此之后如 Sunday Robotics 等则也用其数采手套进行跟进。
| 数据集 | 主要内容 | 数据入口 |
|---|---|---|
| UMI | 原版手持示范数据,含腕部图像、SLAM 末端轨迹与夹爪开合 | 数据 |
| DexUMI | 约 1.8k 条外骨骼示范,适配 Inspire Hand、XHand,含手动作与力触觉 | 数据 |
| HiFi-UMI-2K | 开放 2,000 小时双手 UMI 数据,含六路视频、末端轨迹、夹爪与语言 | 数据 |
| FastUMI-100K | 含早期 FastUMI 数据的 10 万余条示范,覆盖 54 个单、双手任务 | 数据 |
| RealOmni | 官方公布 13k 余小时双手数据,含腕部图像、IMU、位姿与任务标注 | 数据 |
| Daimon-Infinity | 首批约千小时,以手持 UMI 为主,另含外骨骼与触觉采集 | 数据 |
| FreeTacMan | 万余条接触密集操作示范,含腕部与触觉视频、TCP 位姿及夹爪距离 | 数据 |
| Data Scaling Laws 数据 | 约 2.4 万条 UMI 示范,四个任务下系统变化环境与物体 | 数据 |
Ego Data#
Ego Data,即 Ego-centric Data,主要指人类采集的第一视角视频数据,一般作为 World Model 训练数据,或者在进行 retarget 以及标注之后作为 VLA 训练数据使用。其中比较大规模且具有声望的是 EgoScale,采集了大量的 Ego Data,并且使用类似 GR00t 的结构进行了预训练,具有还可以的效果。
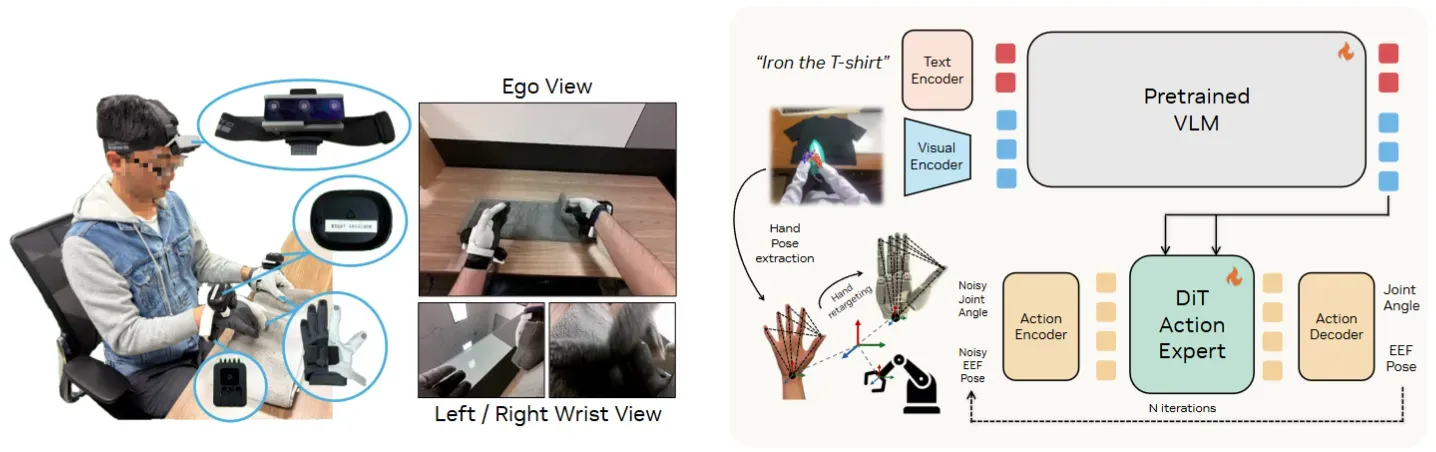
不过在动作没有对齐的时候,甚至在不少地方纯 Ego 数据都是负收益;WAM 用 Ego 的优势,则在于只进行视频预训练,而不利用可能标注比较粗糙的 Action 信息。
| 数据集 | 主要内容 | 数据入口 |
|---|---|---|
| Ego4D | 约 3,670 小时日常第一视角视频,含密集叙述与多种任务标注 | 申请与下载 |
| Ego-Exo4D | V2 含约 221 小时第一视角及同步第三视角,配有手姿态、眼动等标注 | 申请与下载 |
| EPIC-KITCHENS-100 | 45 个厨房、100 小时视频,含约 9 万动作片段的时间与语义标注 | 数据 |
| EgoDex | Apple 的 829 小时桌面操作,配有 ARKit 人手、上身位姿和语言 | 数据 |
| RekaDaily-10k | 10,865 小时原始视频,另有同源剪辑版附机器生成的描述与问答 | 原始视频 · 处理版 |
| Open-AoE | 开放约 2,000 小时手机视频,含原子动作文本、相机轨迹与 MANO 手重建 | 数据 |
| EgoVerse | 官网当前统计 4,003 小时,统一人类操作视频、手部与头部位姿及语言 | 获取说明 |
| EgoSteer-Egocentric | 八个来源的约 154 万段手部、相机与语言标注;原视频需另行获取 | 标注 |
| EgoTouch | 约 1.9k 段双手操作,提供三视角视频、掌面压力、人手姿态与定位 | 数据 |
| EgoInfinity (preview) | 106 段手物重建资产,104 段附机器人重定向轨迹,不含完整原视频 | 数据 |
| HD-EPIC | 41 小时厨房视频,含细粒度动作、操作原因、物体移动及场景位置 | 数据 |
| HOT3D | 833 分钟多视角手物视频,含动捕手物位姿与物体扫描模型 | 数据 |
| HoloAssist | 约 170 小时双人协作,含 RGB-D、手姿态、对话、错误与干预标注 | 数据 |
| HOI4D | 240 万帧 RGB-D 手物交互,含手物位姿、分割及场景点云 | 数据 |
仿真合成数据#
使用仿真器合成数据一直是具身领域中认为的可行 Scaling 方案,尽管伴随着 Sim to Real 的 gap,但是在图形学技术的发展过程中,无论是效率还是 photorealistic 程度都是在不断提升,依然是一个未来可期的方向。
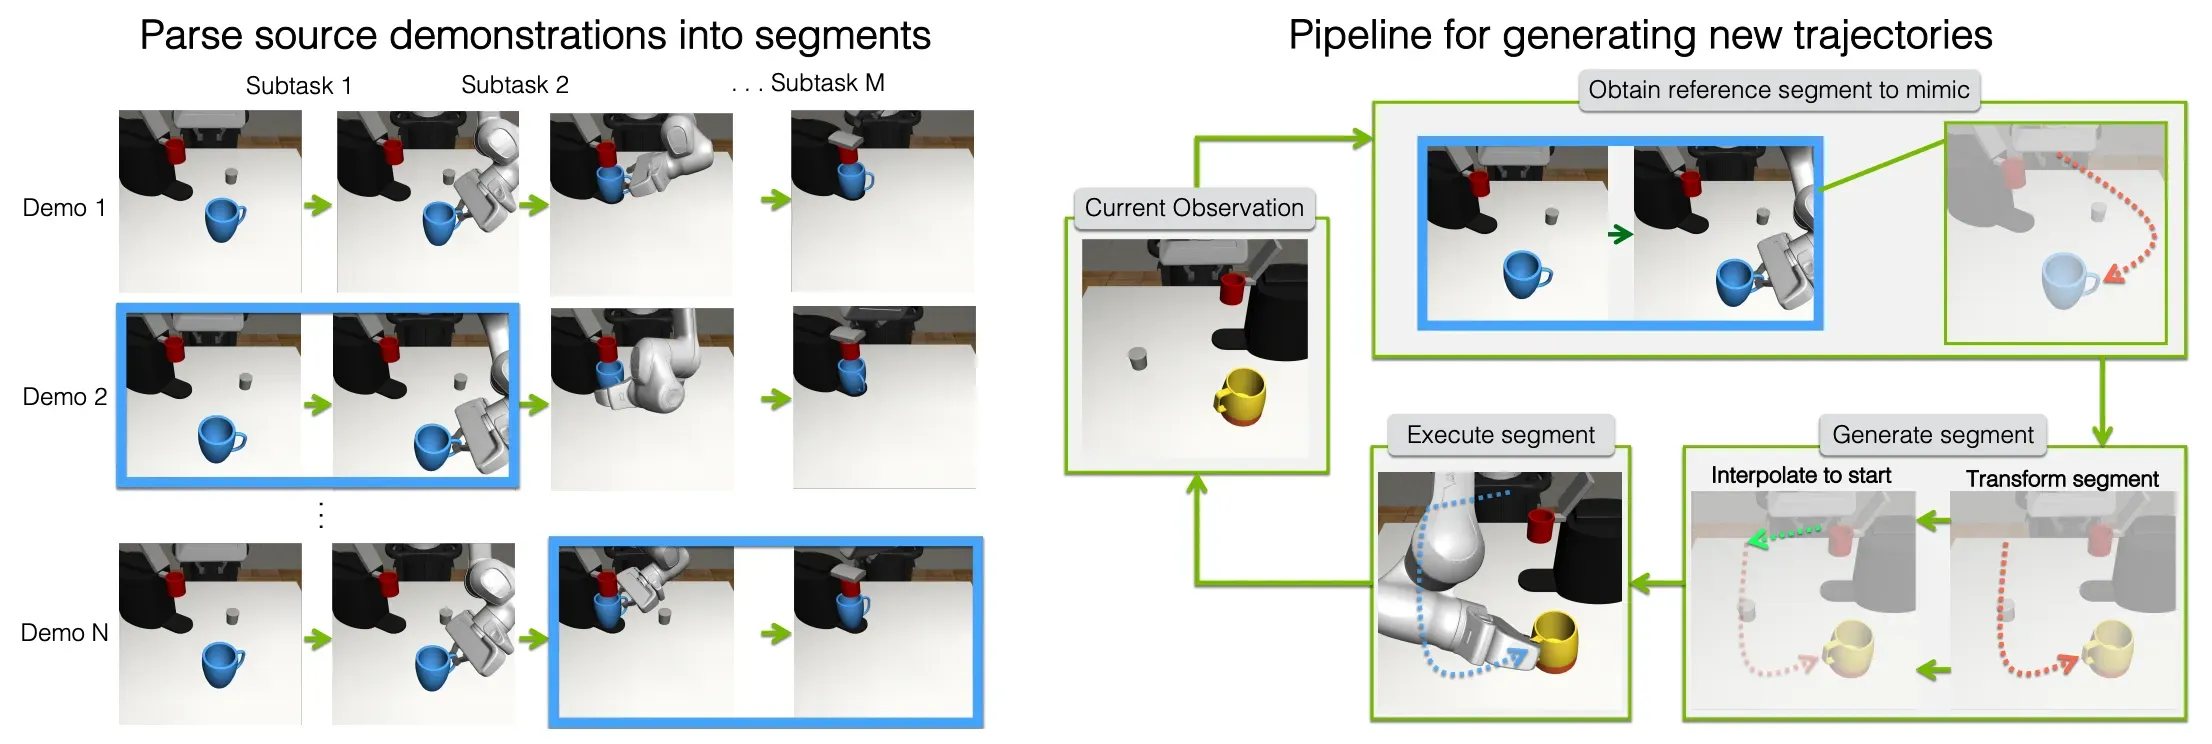
本身较早且具有代表性的工作当属 MimicGen,以及以其为基础搭建的 RoboCasa,通过人类遥操作数据,记录为 Object Centric 的轨迹数据,并且进行分割,这样在之后 randomize 物体位置之后,也可以通过拼接以及坐标变化,以及对于更长程任务可以由子动作进行排列组合,达到操作的效果,从而大量 Scaling 数据。
| 数据集 | 主要内容 | 数据入口 |
|---|---|---|
| InternData-A1 | 标注更新版约 589k 条仿真轨迹,含相机标定、末端位姿与状态动作 | 数据 |
| InternData-M1 | 约 244k 条 GenManip 合成示范,含物体框、轨迹、抓取点与语义 mask | 数据 |
| SIM1 数据 | 已开放双臂布料操作的真机与仿真子集,提供多视角视频和逐帧轨迹 | 数据 |
| MimicGen 数据 | 公开 48k 余条、12 个任务的合成示范,包含抓放与装配等操作 | 数据说明 |
| RoboCasa365 数据 | 3 万条仿真遥操作预训练示范,以及约 60 万条 MimicGen 厨房操作轨迹 | 数据 |
| GR00T-X-Embodiment-Sim | GR00T N1 后训练数据:9k 条双臂、240k 条 GR-1 和 72k 条 Panda 轨迹 | 数据 |
| MolmoBot-Data | 170 万条仿真专家轨迹,覆盖 FR3 与 RB-Y1 的 8 类任务 | 数据 |
| DexMimicGen 数据 | 公开 9 个双臂与灵巧操作任务的合成示范,覆盖双 Panda 和 GR-1 | 数据 |
| SynGrasp-1B | 合成抓取数据,论文规模约 10 亿帧,含动作、物体框与三维位姿 | 数据 |
| Google Scanned Objects | 1,030 个真实日用品的扫描网格、纹理与 SDF 资产 | 官方介绍 |
| Objaverse / Objaverse-XL | 80 万余 / 1,000 万余个三维物体资产,需逐物体确认许可与物理适配 | 数据与工具 |
脚注#
-
操作,即 Manipulation,是具身智能领域中主要内容之一,主要指使用机械臂以及配套的夹爪或者灵巧手进行操作的过程,对于包含底盘移动以及全身控制的涉及机械臂操作的内容,则特指为 Mobile Manipulation 以及 Loco Manipulation;其他的具身智能领域同时包括如,Navigation、Locomotion 等。 ↑
-
End-effector(EEF) Pose,即末端执行器位置,一般用一组平移与旋转表示;在实际的动作执行过程中,机械臂自带或程序实现的 IK 算法(逆运动学算法),可以将 EEF 转为逐关节角位姿(Joint Position),并交给电机驱动控制。 ↑